
ITシステムのバグ修正の事例は、火消し、ひとり情シスの委託、原因調査の仕組み化、保守契約の適正化の4つで見ると分かりやすくなります。
本記事は、ITシステムのバグ修正の導入事例・開発事例・活用事例・成功事例を、発注企業(情シス)の視点から掘り下げる事例特化の解説です。全体の進め方はITシステムバグ修正の完全ガイドで確認できます。
▼全体ガイドの記事
・ITシステムバグ修正の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
夜間の本番障害を短時間で復旧させた火消し事例
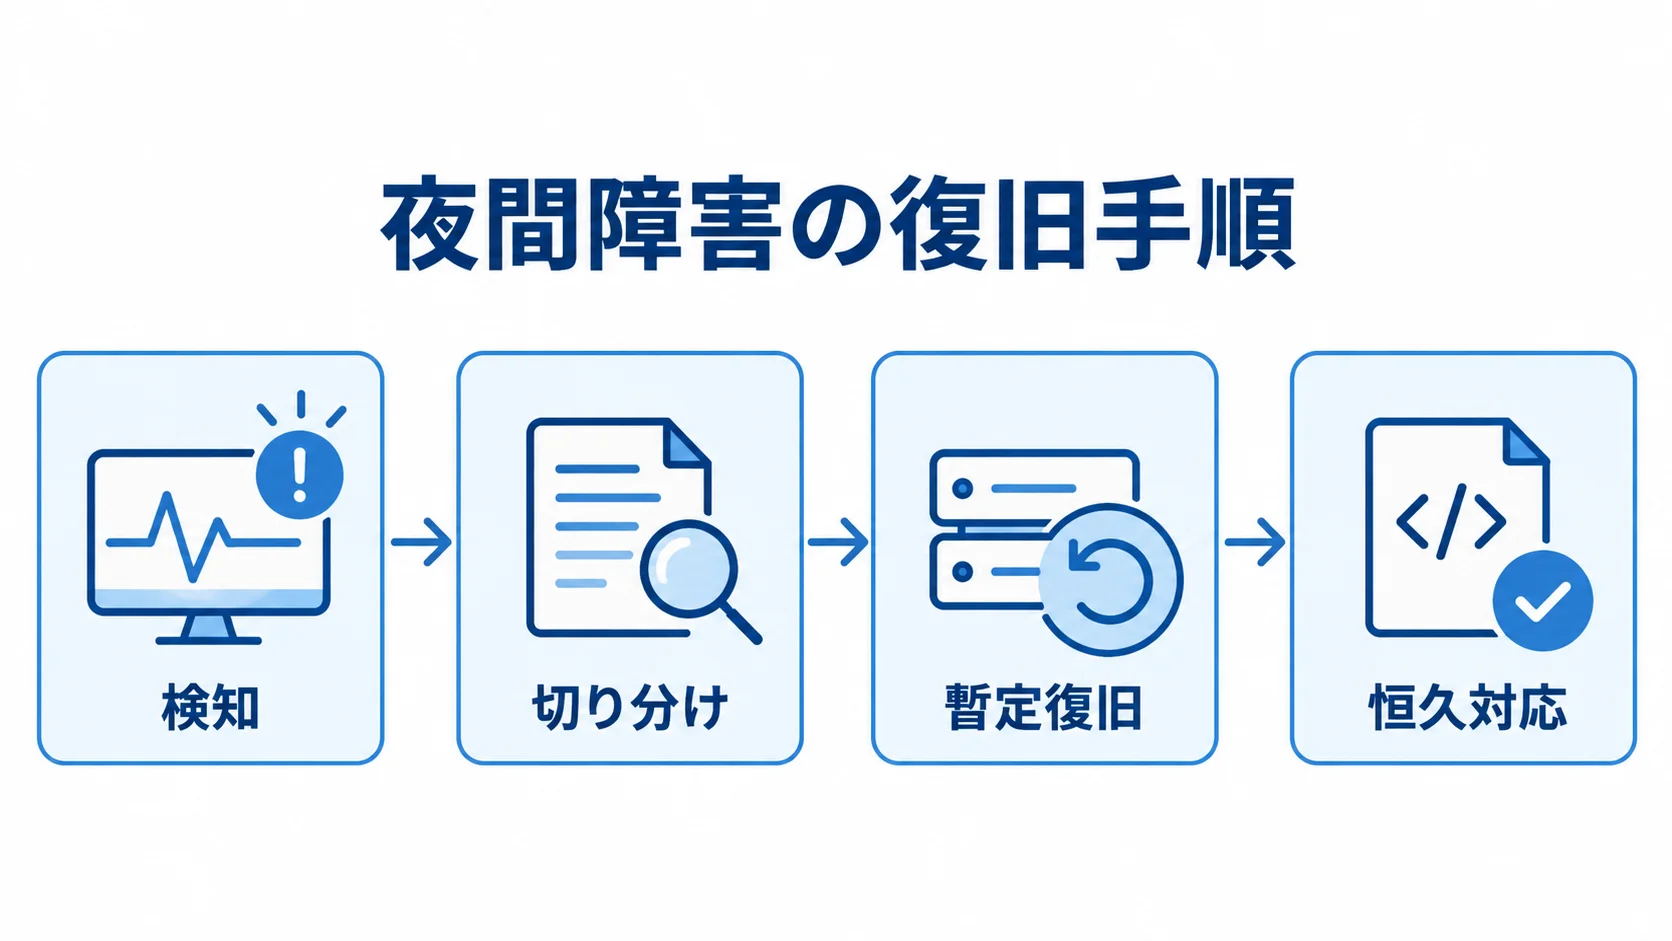
バグ修正の事例で、切迫感がもっとも大きく学びも多いのが、「本番稼働中のシステムで突然発生した障害を、いかに短時間で復旧させたか」という火消し事例です。
とくにECや決済、業務基幹のように、停止が直接損失につながるシステムでは、深夜であってもバグによる障害にすぐ対応しなければなりません。
総務省2025年版の統計では、金融・医療・EC系で5分以上の停止が1回あたり平均1,200万円の機会損失につながるとされています。このため、初動の速さがそのまま金額に直結します。
検知から60分以内の一次対応で被害を最小化した事例
ある中規模ECの事例では、夜間にカート画面でエラーが多発し、注文が通らない状態になりました。このとき決め手になったのは、保守契約で「検知から60分以内に一次対応・通知」というSLAを結んでいたことです。
監視ツールがエラー率の急増を検知してアラートを発報し、待機していた保守エンジニアがログから原因を切り分けました。さらに、直近のリリースで混入した在庫引き当てロジックのバグだと特定しています。
まずは該当機能を切り戻し(ロールバック)して受注機能を復旧させ、被害の拡大を止めています。そのうえで、この火消しが場当たり対応で終わらず、検知・切り分け・暫定復旧・恒久対応という決められた手順に沿って進んだ点が重要です。とりあえず再起動して様子を見るような対応とは違います。
一次対応で暫定復旧させたあと、翌営業日に原因となったコードを正しく修正し、テストを通してから本番に反映する恒久対応を行っています。
重大障害は2時間以内に対応を開始し、24時間以内の完全解決を目標とする。一般的なSLAの考え方どおりに進めたことで、深夜の障害が翌日の営業に尾を引かずに済みました。
この事例から学べるのは、火消しの速さは担当者の頑張りよりも、SLAと手順の設計で決まるということです。
- 監視の有無:エラー率の急増を知らせるアラートが、自社のシステムにあるかどうか。
- 対応の期限:検知から60分以内に一次対応と通知を行う取り決めを、保守契約に明記しておくこと。
経営層・業務部門への状況報告を仕組み化した事例
火消し事例でもう一つ見落とされがちなのが、発注者(情シス)側の立ち回りです。バグの修正そのものはベンダーが担えても、社内の経営層や業務部門への状況報告は丸投げできません。
前述のEC事例では、障害発生から30分以内に初報を入れる社内エスカレーションのルールを、事前に決めていました。これにより、現場が修正に集中する間に、情シスが営業部門やコールセンターへ正確な情報を流し、得意先への二次連絡まで滞りなく進められました。
この事例が示すのは、バグ修正は技術対応と社内への情報共有が両方そろって成り立つということです。原因がまだ分からない段階でも、「調査中であること」と「次の報告のタイミング」を伝えるだけで、社内の混乱は減ります。
逆に、報告が遅れると現場が憶測で動き、二次被害を招きかねません。
火消しに強い組織は、修正の技術力だけでなく、初報・中間報告・収束報告のフォーマットをあらかじめ用意し、誰がいつ何を報告するかを役割分担しています。この立ち回りを前もって設計しておくことが、夜間障害を短時間で収束させた成功事例につながります。
- 初報の中身:何が起きているか、どの機能が止まっているか、いつ復旧の見込みかを伝える。
- 報告の担当:経営層、営業部門、コールセンターのそれぞれに、誰がいつ伝えるかを決めておく。
切り戻しか前進修正かを切り分けて即断した事例
火消しの現場でもっとも判断を迫られるのが、「直近のリリースを切り戻すか、それとも前進してパッチを当てるか」という分岐です。
前述のEC事例では、障害の引き金が直近のデプロイにあると切り分けられた時点で、迷わず切り戻しを選びました。原因の完全な究明より先に、まず事業の損失を止める優先順位が徹底されていたのです。
切り戻しで在庫データに不整合が残らないことを確認したうえで、受注機能を平常運転に戻しています。
切り戻すと別の新機能まで巻き戻ってしまう場合や、データ移行を伴うリリースの場合は、安易な切り戻しが二次被害を招きます。
保守チームは、障害発生時に「切り戻して安全な機能か」「巻き戻しでデータ不整合が起きないか」を即座に判定するチェックリストを持っていました。
火消しのスピードは、こうした事前の判断基準があってこそ成り立ちます。原因究明と事業継続のどちらを優先するかを決め、まず止めるという判断と、それを支える準備が、短時間収束の決め手だったといえます。
- 切り戻しの可否:別の新機能まで巻き戻らないか、データ移行を伴っていないかを確かめる。
- 判断の準備:障害時に即座に判定できる基準を、平時のうちに用意しておくこと。
ひとり情シスがバグ対応を委託して本業に集中した事例
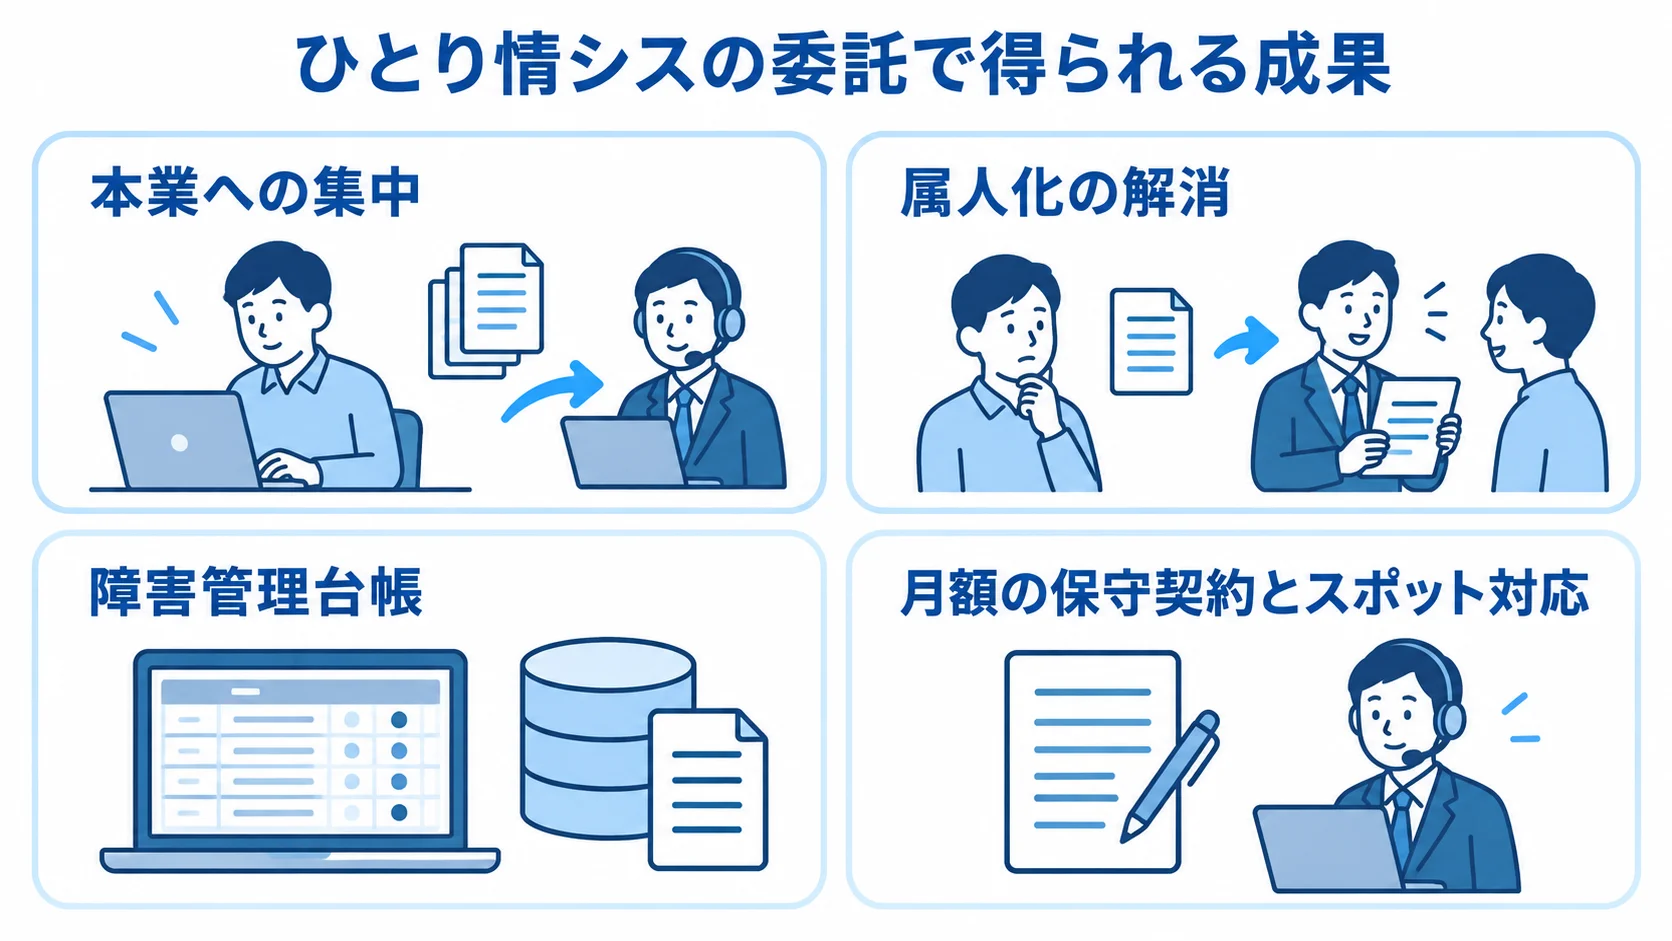
中小企業に多いのが、情報システム担当者が1人ないし数人しかいない「ひとり情シス」体制です。
この体制では、日々の問い合わせ対応や新規施策に加えて、突発的なバグ対応まで一人で引き受けることになります。そのため、担当者が疲弊し、属人化も進みます。
バグ対応を外部の保守ベンダーに委託し、担当者が本来注力すべき業務に集中できるようになった事例は、数多く存在します。
営業時間内対応の保守契約で月額を抑えた事例
ある業務システムを運用する中小企業の事例では、24時間365日の緊急対応までは不要だと判断し、営業時間内のバグ対応に絞った保守契約を結びました。
一次データによれば、障害・バグ対応の費用は、営業時間内であれば月3万〜8万円、24時間緊急対応では月10万〜20万円が相場です。また、スポット対応は1件あたり3万〜10万円です。
この企業は、自社システムの稼働が平日日中に集中していたため、あえて24時間対応を外しました。月額を抑えながら、必要な範囲をカバーする現実的な選択です。
この事例のポイントは、「自社にとって本当に必要なバグ対応の範囲」を見極めたうえで、契約形態を選んだことです。
年間保守費は初期開発費の15〜20%が一つの目安で、開発費3,000万円なら年450万〜600万円、月額換算で37万〜50万円に達します。
この中でバグ対応にどこまで予算を割くかは、システムが止まったときの事業影響度で決まります。ひとり情シスは、すべてを抱え込まず、影響度の高い時間帯と機能に絞って外部の力を借りることが大切です。
委託によって浮いた時間を、業務改善やデータ活用といった本来の付加価値業務に振り向けられた点が、この事例の最大の成果でした。
- 緊急体制の要否:夜間の緊急対応が本当に必要かを、システムの稼働パターンから確かめる。
- 費用の比較:営業時間内と24時間対応の月額を、事業影響度と並べて見比べる。
属人化していた修正ノウハウを引き継いだ事例
ひとり情シス体制には、もう一つ落とし穴があります。バグ修正のノウハウが担当者の頭の中だけに蓄積され、退職や異動で一気に失われるリスクです。
委託に成功した事例では、外部ベンダーへの引き継ぎを機に、過去のバグ事象・原因・修正内容を一覧化した障害管理台帳を整備しました。これにより、「前にも似た不具合があったが、どう直したか思い出せない」という属人化の弊害が解消され、再発時の対応時間が大幅に短縮されています。
この事例から学べるのは、バグ対応の委託が、人手を補うだけでなくノウハウを文書に残すきっかけにもなるということです。外部に任せるには、システムの仕様や過去の不具合履歴を文書で渡す必要があります。その過程で、社内に散らばっていた暗黙知も整理されます。
たとえ将来ベンダーを切り替えることになっても、台帳と修正履歴が残るため、引き継ぎがスムーズになります。
ひとり情シスがバグ対応を委託する価値は、目先の工数削減だけでなく、組織として不具合に強くなる仕組みを手に入れられる点にあります。
- 引き継ぎ資料:システムの仕様と過去の不具合履歴を、文書にして外部へ渡せているか。
- 記録の運用:修正のたびに、事象・原因・修正内容を書き足していく仕組みにしておく。
月額契約とスポット対応を併用してコストを最適化した事例
「ひとり情シスがバグ対応を委託して本業に集中した事例」の中で参考になるのが、月額の保守契約とスポット対応を組み合わせて費用を最適化したケースです。この企業は、日常的に発生する軽微なバグや問い合わせを月額の営業時間内対応でカバーし、大規模な改修を伴う重い不具合だけは、スポット契約で都度発注する二段構えにしました。
スポット対応は1件あたり3万〜10万円が相場です。そのため、頻度の低い重いバグにまで24時間体制の高い月額を払うより、トータルで安く収まったのです。
この使い分けが機能した背景には、過去の障害管理台帳から「自社のバグはどの程度の頻度・規模で起きるか」を把握していたことがあります。発生実績のデータがあれば、月額に含める範囲とスポットに回す範囲を、数字をもとに線引きできます。
ひとり情シスは予算も人手も限られるため、感覚ではなく実績データをもとに契約を設計することが、保守予算を最大限に活かす近道になります。
委託がうまくいくかどうかは、契約の中身を自社の実態に合わせて作り込めるかで決まります。
- 線引きの基準:軽微な不具合と問い合わせを、月額に含めるものとスポットに回すものに分けて決める。
- 実績の把握:過去の障害の記録から、バグの頻度と規模を数字で押さえておく。
原因調査の属人化を解消しMTTRを短縮した事例
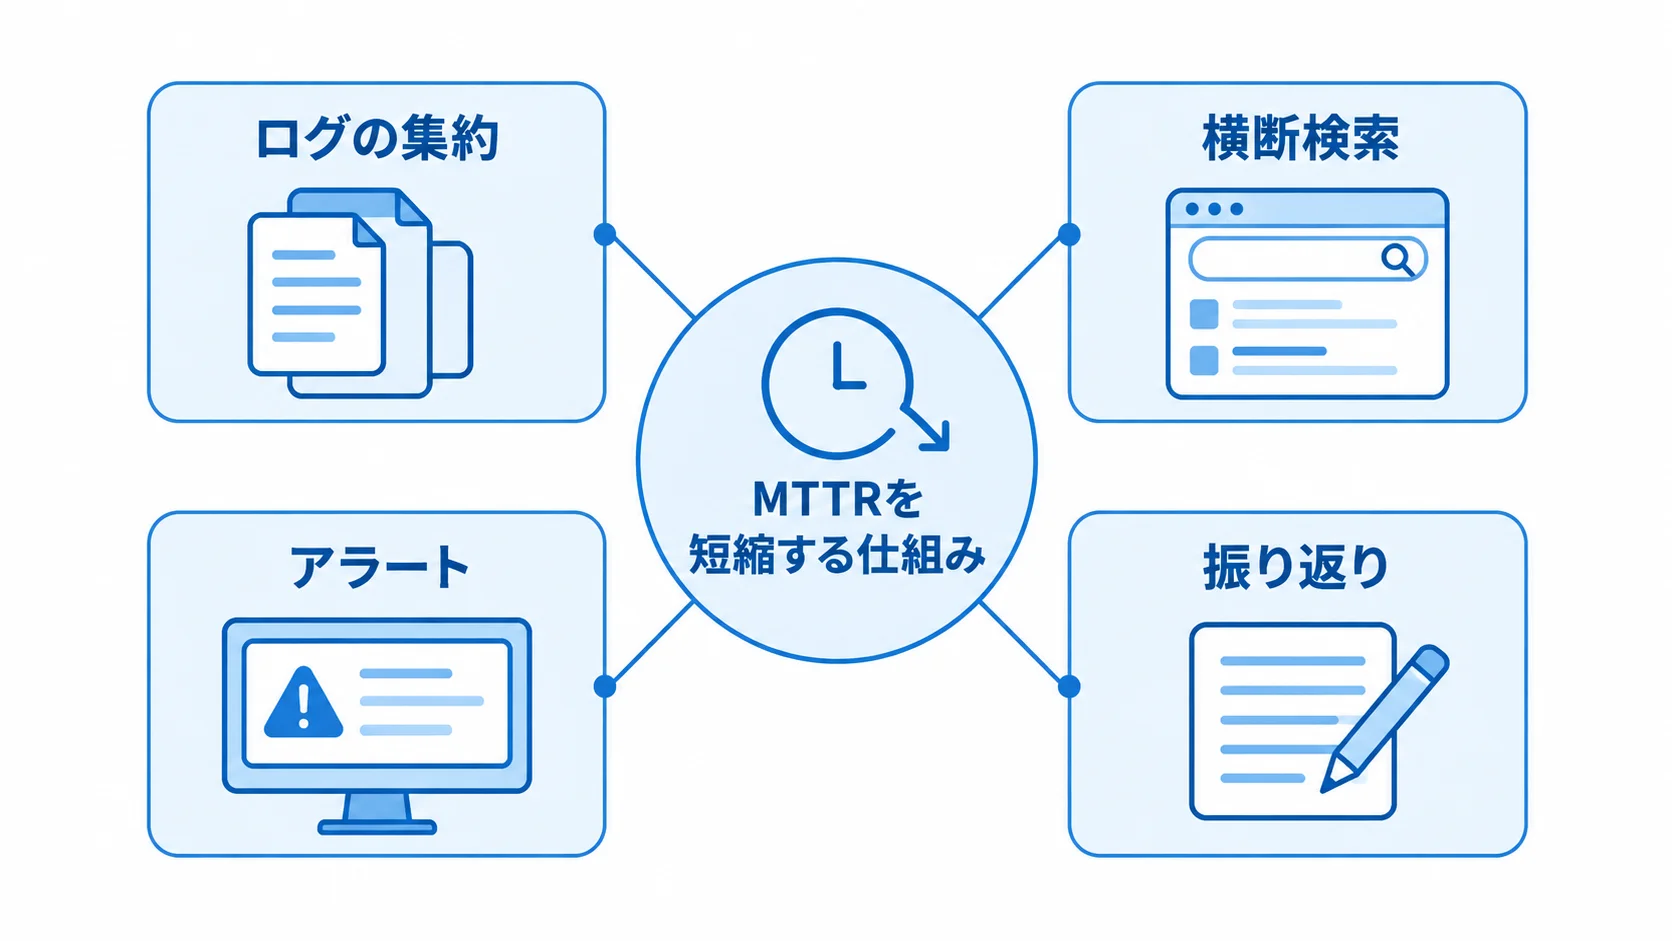
バグ修正の成否を分ける最大の要素は、原因調査(切り分け)のスピードと精度です。バグそのものの修正は、原因さえ特定できれば数行のコード変更で済むことも珍しくありません。
問題になるのは、「どこに原因があるか」を突き止めるまでの時間です。ここが長引くほど、ダウンタイムが延び、損失も膨らみます。この原因調査を仕組み化してMTTR(平均修復時間)を短縮した事例を、順に見ていきます。
ログ監視の整備で原因切り分けを高速化した事例
原因調査が長引く最大の理由は、ログが分散していて必要な情報がすぐ見つからないことです。ある事例では、これまでサーバーごとにバラバラだったログを集約し、エラーの発生時刻・該当処理・スタックトレースを横断検索できるようにしました。
この整備には、OSS監視ツールのZabbixや、クラウド型のDatadog・New Relicといったツールを活用しています。また、エラーログを一か所で見られるようにしたことで、これまで数時間かかっていた原因の切り分けが大幅に短縮されています。バグが発生した瞬間のログをすぐ追えるかどうかが、MTTRを左右します。
この事例で効果的だったのは、ツールを入れただけでなく、「どのログを、どの閾値で、誰に通知するか」を設計した点です。エラー率やレスポンス遅延が一定の閾値を超えたら自動でアラートを出し、その時点のログへすぐアクセスできる導線を整えました。
これにより、バグの兆候を早く捉え、利用者からの問い合わせが来る前に対応に着手できるようになっています。原因調査の高速化は、ログを集めて見やすくすることと、適切なアラートを設計することの積み重ねで実現します。
- ログの置き場所:サーバーごとに分かれたログを、一か所で横断して探せる状態になっているか。
- 通知の設計:どのログを、どの閾値で、誰に知らせるかを、あらかじめ決めておく。
再発防止の振り返りで同種バグをゼロにした事例
「原因調査の属人化を解消しMTTRを短縮した事例」に続くこの節では、優れたバグ修正の事例に共通するのは、直して終わりにせず、必ず振り返り(ポストモーテム)を行っている点です。
ある企業の事例では、重大なバグを修正するたびに関係者で振り返りました。さらに、その振り返りを、テストケースの追加やレビュー観点の更新に反映しています。
振り返りの結果、同じ原因によるバグの再発が大幅に減り、対応に追われる時間も短くなりました。
この振り返りの文化が根づくと、バグ対応は「火消し」から「予防」へと性質を変えていきます。再発防止策が蓄積されるほど突発的な障害が減り、エンジニアは新機能の開発や改善に時間を使えるようになります。
riplaはフルスクラッチ受託と国内運用保守の立場から、バグを直すだけでなく、原因の振り返りと再発防止までを保守の中に組み込む進め方を重視しています。
事例を読むときは、「どう速く直したか」だけでなく、「同じバグを二度と起こさないために何をしたか」という視点で見ることが、自社の対応力を底上げする近道です。
- 振り返りの問い:なぜ発生したか、なぜ検知が遅れたか、どうすれば再発を防げるか。
- 反映先:テストケースの追加やレビュー観点の更新に、振り返りの結果を組み込んでいく。
過剰SLAを適正化して保守コストを削減した事例
バグ対応の事例は、速く直す話だけではありません。多くの企業が見落としがちなのは、払いすぎている保守費を必要十分な水準まで適正化するという、逆方向の改善です。
過剰なSLAを契約したまま惰性で更新を続け、本来は不要な高コスト体制を抱えている企業は少なくありません。この改善によってコストを削減した事例から、学べることは多くあります。
事業影響度アセスメントでSLAを見直した事例
ある企業の事例では、社内バックオフィス系のシステムに対して、本番ECと同じ稼働率99.99%・24時間対応のSLAを契約していました。
しかし、このシステムは夜間に止まっても翌朝までに復旧すれば業務に支障がなく、過剰な保証にコストを払っている状態でした。
そこで、システムごとに「止まったときの事業影響度」をアセスメントし、影響の小さいシステムは稼働率99.9%・営業時間内対応のSLAへと引き下げました。稼働率99.99%の許容ダウンタイムは月4.38分、99.9%は月43.8分です。この差は許容できると判断しました。
この見直しによって、年間の保守費を相当額圧縮できました。稼働率の「9」が一つ増えるごとに運用コストは段階的に跳ね上がるため、水準を一つ下げるだけでコストは下がります。
闇雲に安くしたのではなく、事業影響度という客観的な根拠に基づいて適正化した点が、この事例の要です。
SLAは高ければよいわけではなく、システムの重要度に見合った水準に揃えてこそ、無駄のないコスト構造になるという原則を、この事例は示しています。
- 停止時の影響:システムが止まったとき、業務や売上にどれだけ響くかを一つずつ確かめる。
- 許容ダウンタイム:どこまでの停止なら業務に支障がないかを、稼働率の数字と照らし合わせる。
浮いた待機費を改善開発に振り替えた事例
SLA適正化で浮いた予算を、削減だけで終わらせず、システムの改善開発に振り替えた事例もあります。
契約を工夫すれば、待機費は新機能の開発や使い勝手の改善に充てられます。この企業は、適正化で生まれた余力を継続的な改善に回し、保守費を「壊れたら直すコスト」から「システムを良くし続ける投資」へと性質を変えました。
この事例が示すのは、バグ対応・保守を「コスト」と捉えるか「投資」と捉えるかで、同じ支出の意味が変わるということです。
障害がなかった月の待機費を無駄と感じるなら、その工数を改善に充てる契約へ切り替えるのも一つの方法です。
riplaはフルスクラッチ受託と国内運用保守の立場から、待機費を改善開発に振り替える「充填型保守」の考え方を重視しています。バグ対応の事例は、火消しの速さだけでなく、保守費をいかに前向きな投資に転換したかという視点でも読む価値があります。
- 待機費の性質:バグが起きない月にも発生する費用を、余剰工数として捉え直す。
- 余力の使いみち:浮いた工数を、新機能や使い勝手の改善に充てる計画を立てる。
まとめ
ITシステムのバグ修正事例を振り返ると、成功の共通項は、検知から復旧までの手順とSLAを事前に設計し、原因調査を仕組み化し、振り返りで再発を防ぐという一点に集約されます。
夜間の本番障害は、検知から60分以内の一次対応と社内エスカレーションの設計によって、短時間で収束させられます。ひとり情シスは、影響度に応じた範囲で対応を委託することで、本業に集中しながら属人化も解消できます。
さらに、ログをまとめて見られるようにすることや振り返りの文化が、MTTRを縮め、バグ対応を火消しから予防へと変えていきます。
金融・医療・EC系で5分以上の停止が1回あたり平均1,200万円の機会損失につながるという統計を踏まえれば、初動の速さへの投資は十分に正当化されます。
事例を読むときに大切なのは、「誰がどれだけ頑張ったか」ではなく「どんな仕組みで速く確実に直せたか」という視点です。
自社のシステムが止まったときの事業影響度を見極め、まずは原因調査を速くする土台づくりと、影響度の高い時間帯のバグ対応体制の整備から着手してください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、バグ修正を「コスト」ではなく「事業継続の保険」と捉えた継続的な伴走を支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。