
ITシステムのバグ修正を外部に委託するとき、最初の関門はRFP(提案依頼書)や要件定義書に何を書くかです。対応範囲、優先度区分、SLAの数値、クラウドの責任分担を具体的に書くと、妥当な見積もりと提案を引き出せます。要件に書かれていないと、想定外の追加費用や復旧遅れにも直面します。
全体像をまだ把握していない方は、まずITシステムバグ修正の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステムバグ修正の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
RFPでの対応範囲と優先度区分の定義
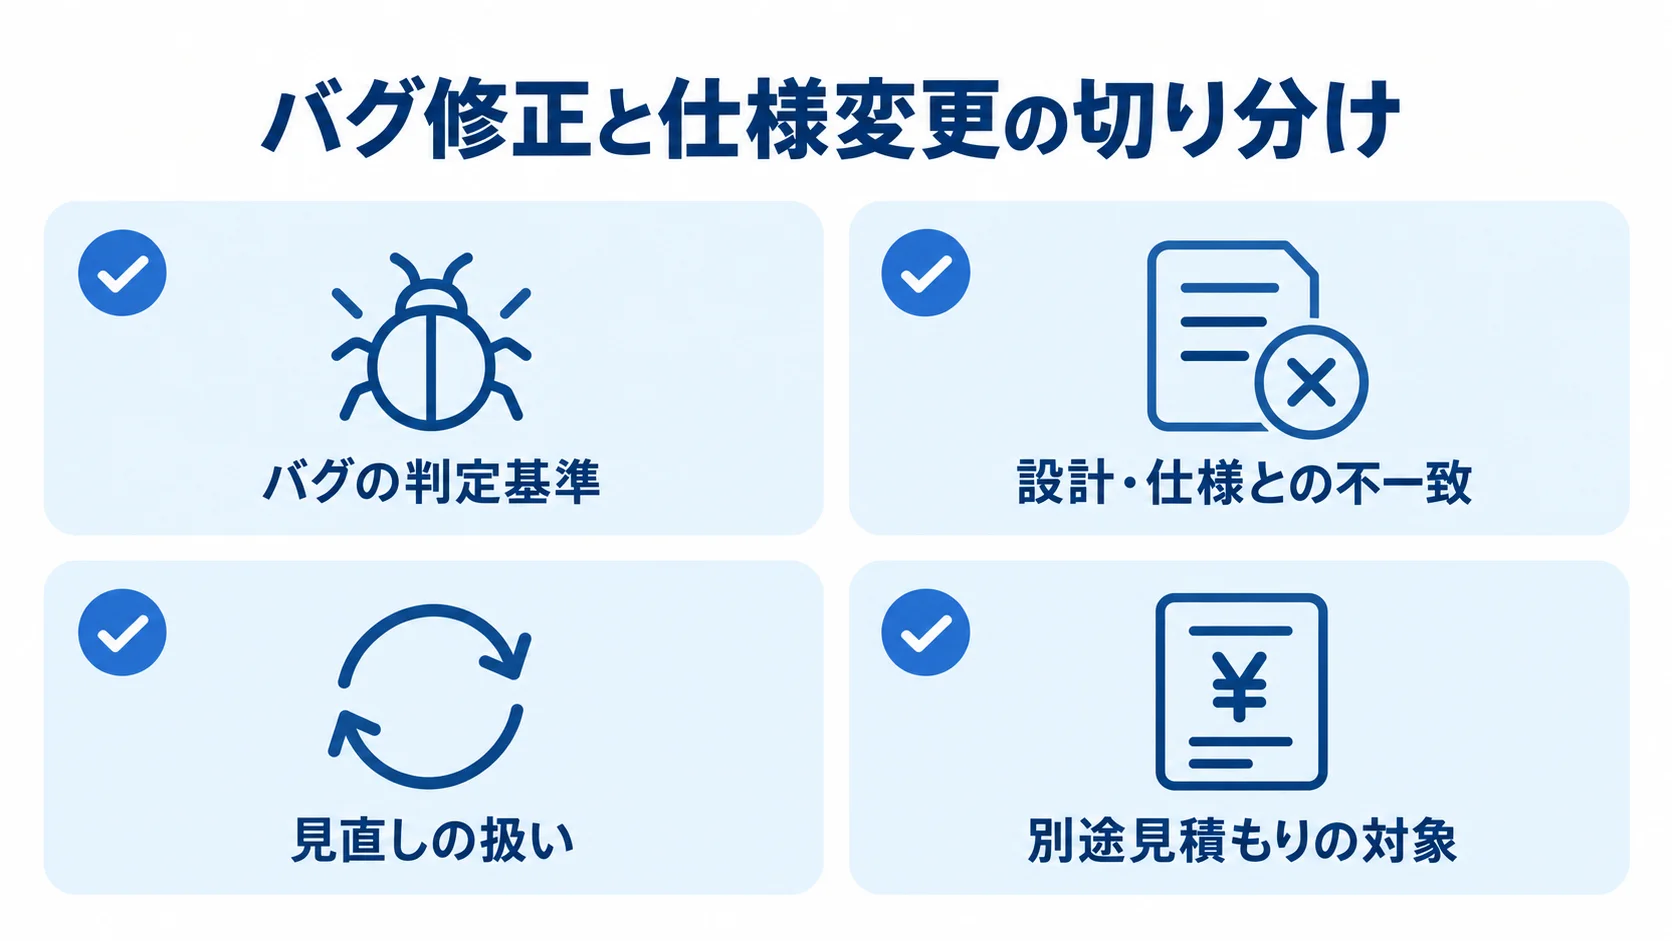
バグ修正のRFPで最初に明確にすべきなのは、何をバグ修正の対象とするかという対応範囲です。プログラムの不具合だけを指すのか、設定ミスやデータ不整合の修正まで含むのか、軽微な仕様変更にも対応するのかを決めます。
この線引きが曖昧だと、見積もりの前提がベンダーごとにばらばらになり、比較できません。そのため、対応範囲を明文化しておくことが、適正なバグ修正契約の出発点になります。
バグと仕様変更を切り分ける範囲定義
RFPで最も揉めやすいのは、バグと仕様変更の境界です。設計どおりに動いていないものはバグ修正の範囲ですが、「設計はその通りだが業務に合わないので変えてほしい」という要望は仕様変更にあたり、一般に別途見積もりの対象になります。
この区別を要件定義書に明記しておかないと、利用者は「これもバグだから無料で直して」と求め、ベンダーは「これは仕様変更です」と返す押し問答になって、対応が滞ります。
RFPでは、バグの定義を設計・仕様との不一致として明文化し、仕様変更との切り分け基準を示す必要があります。
保守費のうち、どこまでがバグ修正に含まれるかも定めておきます。
一次データでは、年間保守費は初期開発費の15〜20%が目安とされ、開発費3,000万円なら年450万〜600万円、月額換算で37万〜50万円です。
そのうえで、バグ修正の工数を月あたり何時間まで含むのか、その上限を超えた分をどう精算するのかを要件に書いておきます。そうすれば、月によってバグが多発しても費用が青天井にならず、予算管理が安定します。
範囲定義は、サービスの質と費用の両面で、後のトラブルを未然に防ぐ土台になります。
判断の材料を文書に揃えておくと、ベンダー各社の見積もりを同じ前提で比べられます。
- バグの判定基準:設計書や仕様との食い違いを、バグとみなす基準として示す
- 見直しの扱い:業務に合わない要望は、別見積もりとして切り分けておく
影響度に応じた優先度区分(重大度ランク)の定義
すべてのバグを同じ応答時間で対応するのは、現実的でも経済的でもありません。そこでRFPでは、バグの影響度に応じた優先度区分(重大度ランク)を定めます。
たとえば「重大:業務が完全に停止する/高:主要機能が一部使えない/中:回避策があり業務継続は可能/低:軽微な表示崩れ」といった区分を設け、それぞれに求める応答時間と復旧時間を紐づけます。
この区分があれば、ベンダーは優先度ごとに体制を組め、発注側も「重大なものだけ手厚く、軽微なものは計画対応」という合理的な費用配分ができます。
優先度区分は、自社の事業影響度から逆算して決めるのが基本です。どの機能が止まると、どれだけの損失が出るのかを洗い出します。
参考になる統計もあります。総務省2025年版では、金融・医療・EC系で5分以上の停止が1回1,200万円の機会損失になるとされ、Gartner 2024ではダウンタイム1分あたり5,600米ドルの損失が示されています。
これらは、どこまでを重大と位置づけるかの根拠になります。
事業影響度を踏まえて優先度区分を設計すれば、過剰な対応要求で費用が膨らむことも、過少な要求で損失を招くことも避けられます。RFPの優先度定義は、費用と事業継続性のバランスを取るうえで中心になる項目です。
優先度ごとの目標は、区分ごとに並べてベンダーに示すと比べやすくなります。
- 区分の基準:業務の停止、機能の一部停止、回避策の有無で分ける
- 区分ごとの目標:応答時間と復旧時間を、区分ごとに別々に決める
SLAの数値要件(応答・復旧・稼働率)の定義
バグ修正のRFPで提案の質を最も左右するのが、SLA(サービス品質保証)の数値要件です。「迅速に対応します」「速やかに復旧します」といった定性的な言葉では、いざというときに何の保証にもなりません。
応答時間・復旧時間・稼働率を具体的な数値で定め、未達時の扱いまで決めて初めて、SLAは機能します。ここを数値で示せるかが、RFPの成否を分けます。
初報応答時間と復旧時間の数値要件
SLAの数値要件の核になるのが、初報応答時間と復旧時間です。バグの報告や検知から一次応答(受付・状況連絡)を返すまでの時間と、復旧までの時間を、優先度区分ごとに定めます。目標は、区分ごとに別々の数値で定めるのが大切です。
実際のサービス例では、官公庁仕様で「1時間以内に現地到着・対処開始」「1時間以内に内容と予想作業時間を報告」「原則4時間以内に完全復旧」という水準が見られます。Cloud Naviの「重大issue 15分以内一次対応保証」や、シーズホスティングの「検知から60分以内通知・12時間で復旧」も示されています。RFPには、自社が求める時間を、こうした実値を参考にして数値で書き込みます。
数値を書くときは、応答時間と復旧時間を混同しないことが肝心です。応答時間は受け付けて連絡を返すまで、復旧時間は実際に直って業務が再開できるまでで、両者は別物です。応答が速くても復旧が遅ければ業務は止まったままです。逆に、応答だけ約束されても安心はできません。
RFPでは、「重大障害は15分以内に一次応答、2時間以内に復旧着手、24時間以内に完全解決」のように、応答と復旧を分けて書きます。優先度ごとに目標を定めておくと、ベンダーの提案を同じ尺度で比べられます。
応答と復旧の目標は、区分ごとに並べると、各社の提案の差が見えやすくなります。
- 初報応答:受付と状況連絡までの時間を、区分ごとの数値で示す
- 復旧:着手の時間と完全解決の時間を、別々の項目にする
稼働率と過剰SLAを避ける適正水準の定義
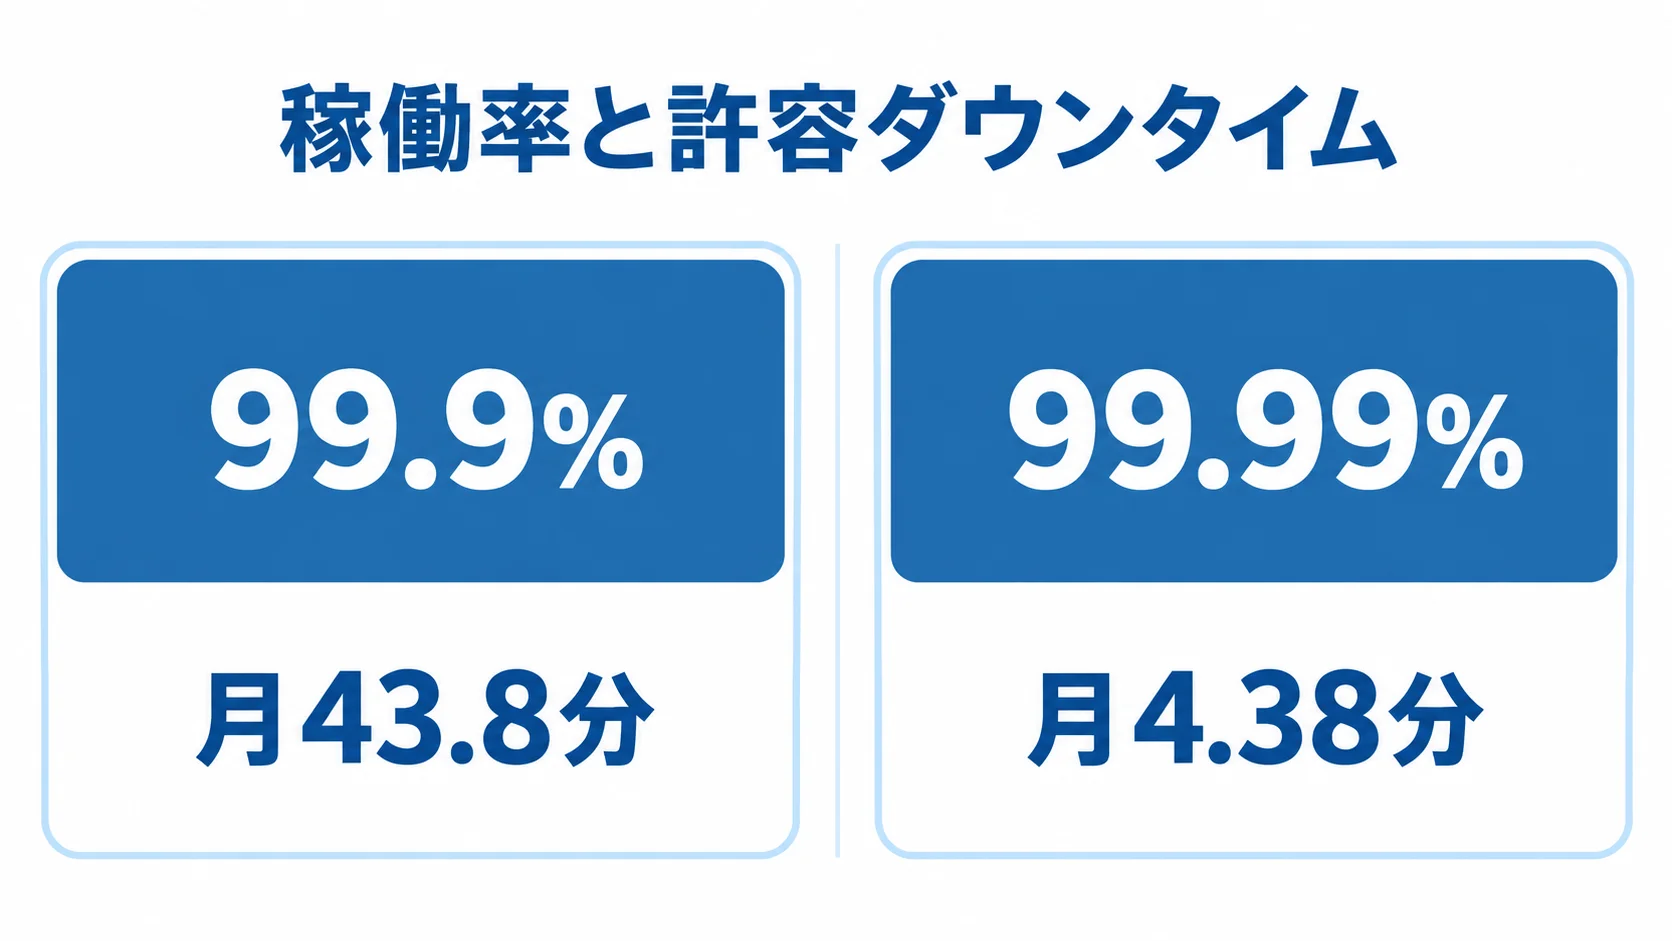
稼働率は、SLAのなかでも費用に直結する要件です。稼働率99.9%は年間で約8.76時間、月43.8分のダウンタイムを許容しますが、99.99%にすると許容は年52.6分、月4.38分まで縮まります。
「9」が一つ増えるごとに運用コストは段階的に跳ね上がるため、稼働率の要求は慎重に決める必要があります。RFPで安易に「99.99%以上」と書くと、本来は不要な高コストの体制を組まされ、保守費が膨らみます。
自社の業務にとって、月43分のダウンタイムが許容できるのか、それとも数分も許されないのかを冷静に見極めることが求められます。
過剰なSLAを避けるには、要件定義の前段で事業影響度のアセスメントを行い、稼働率の根拠を社内で合意しておくことが欠かせません。情シスが「念のため高い稼働率を」と求めると費用が跳ね上がり、ビジネス部門は「そこまで必要か」と疑問を持ちます。
この社内調整を経て、業務影響に見合った適正な稼働率を要件として定めることが、無駄のないSLA設計につながります。riplaはフルスクラッチ受託と国内運用保守の立場から、過剰なSLAを戒め、事業影響度に基づいた現実的な要件定義を支援しています。
RFPの稼働率は、業務に必要十分な水準を定めることが肝心です。
稼働率の議論では、業務への影響と費用の差を並べて比べると話が進みやすくなります。
- 業務への影響:月に何分止まると業務に響くかを、社内で合意する
- 費用の差:稼働率を一段上げるごとに増える運用コストを、見積もりで比べる
SLA未達時のペナルティと測定方法の要件
数値目標を定めても、未達時の扱いと達成度の測定方法を決めておかなければ、SLAは形だけの約束になります。RFPでは、目標を下回ったときにサービスクレジット(保守費の一部減額)を適用するのか、努力目標にとどめるのかを明確にします。
一般に、SLAは「保証型」と「努力目標型」に大別され、保証型はペナルティを伴う分だけ月額が高くなる傾向があります。そのため、自社の事業影響度に照らして、どの優先度区分までを保証型にするかを線引きすることが、費用と安心のバランスを取る中心になります。
あわせて、応答時間・復旧時間をどの時点から計測するかも、要件に含めます。障害の「検知時刻」を起点とするのか、利用者からの「報告受付時刻」を起点とするのかで、同じ目標値でも実質的な厳しさが変わります。
測定の基準が曖昧だと、SLA未達かどうかの判定で揉め、サービスクレジットの精算が実効性を失います。そこで、月次でSLA達成状況を報告させる運用まで、RFPに書き込んでおきます。契約後も品質を客観的に監視でき、ベンダーに継続的な緊張感を持たせられます。
数値目標は、測定とペナルティの設計まで含めて初めて意味を持ちます。
測定と未達時の扱いは、契約書に書く項目として一つずつ確かめておくとよいでしょう。
- 月次の報告:達成状況を毎月どの形で示させるか
- 精算の方法:未達時の減額を、どの月額の範囲で行うか
クラウド責任共有を前提とした切り分けの定義
現在、国内エンタープライズ・システムのクラウド比率は約5割(IDC Japan、2022年)に達し、多くのシステムがクラウド基盤の上で動いています。クラウド環境でのバグ修正には、自社・ベンダー・クラウド事業者の三者で責任が分かれる「責任共有モデル」という固有の論点があります。
この前提のもとで、どこまでが誰の責任範囲かをRFPで定義しておかないと、障害時に責任の押し付け合いが起き、復旧が遅れます。
クラウド基盤障害とアプリ不具合の切り分け要件
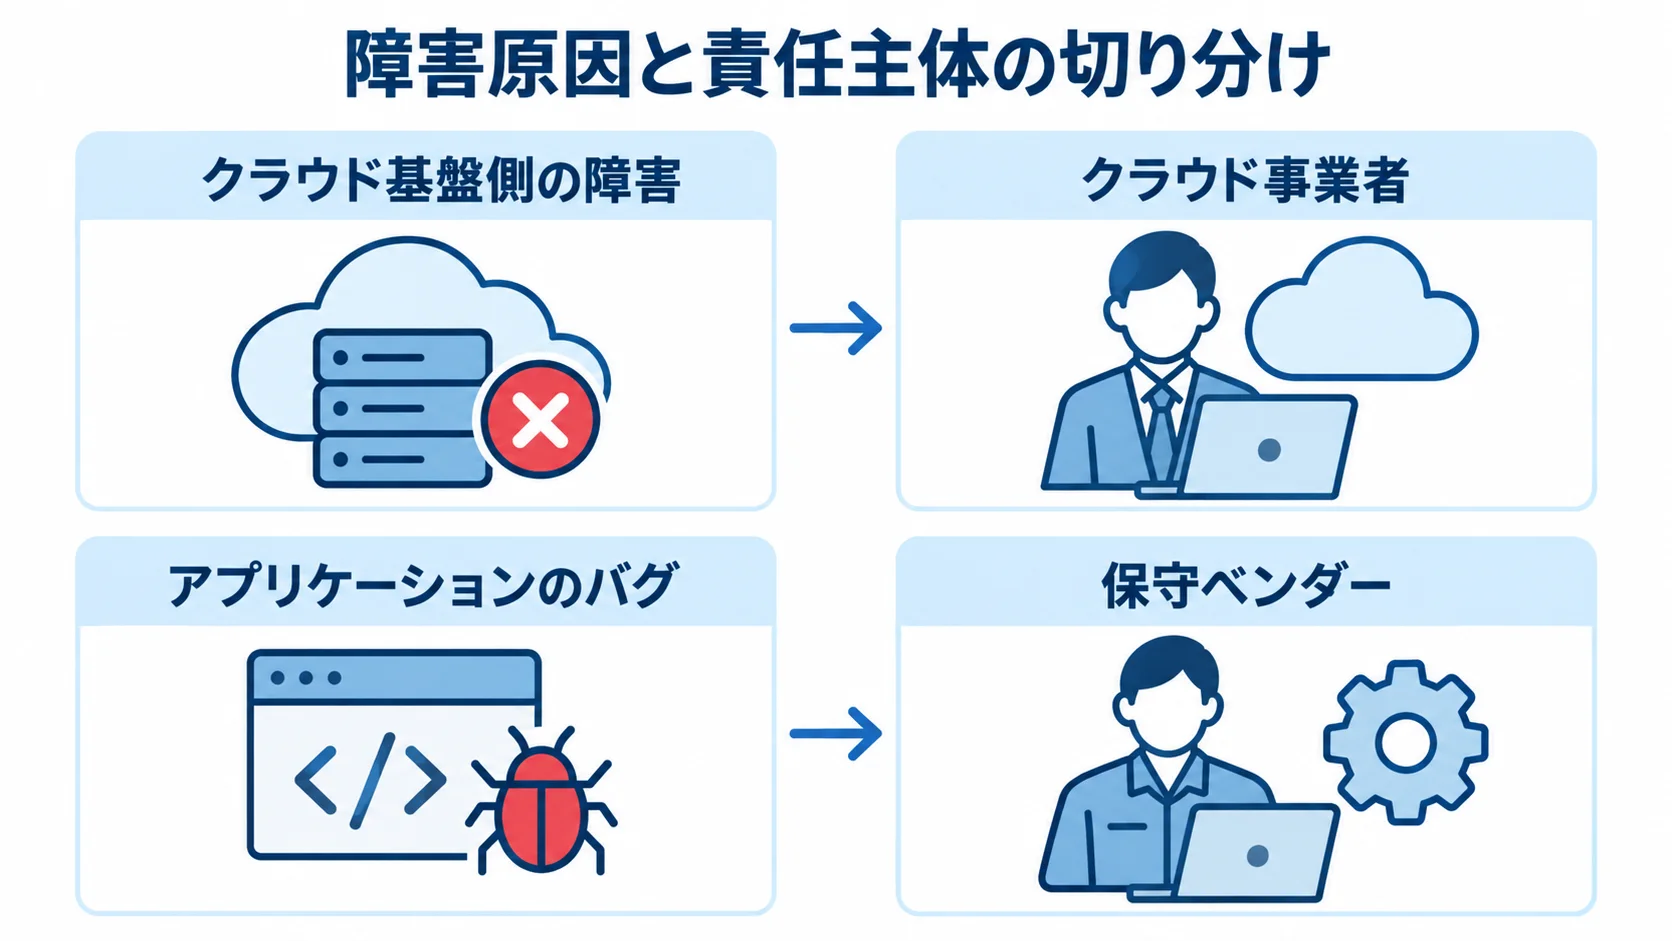
クラウド環境のバグは、原因がアプリケーションのコードにあるのか、クラウド基盤側の障害にあるのかを切り分けることから始まります。基盤の障害は利用者側では手出しができず、対応はクラウド事業者を待つしかありません。一方で、アプリケーションのバグは保守ベンダーが直す責任範囲です。
RFPでは、この切り分けの手順と、それぞれの責任主体を明確に定義します。基盤の障害だと判明した場合の連絡と暫定対応をどう進めるかまで要件に含めておくと、原因が基盤側だったときに発注側だけが取り残される事態を防げます。
切り分けでは、「基盤障害」「アプリ不具合」の判定にかかる時間を、あらかじめ決めておく必要があります。決めておかないと、切り分けの段階で時間を浪費し、判定者が定まらないまま障害対応が止まります。
クラウド前提のバグ修正では、修正そのものより切り分けの設計が復旧スピードを左右します。
切り分けの要件は、判定の担当と、判断に使う情報の出どころを並べて見ると整理しやすくなります。
- 判定の担当:基盤障害かアプリ不具合かを、誰が判定するか
- 判断に使う情報:監視情報やログを、ベンダーがどこまで確認できるか
サービスクレジットと賠償上限の取り扱い要件
クラウド基盤の障害時、クラウド事業者の補償は多くの場合「サービスクレジット(利用料の一部返金)」にとどまり、ダウンタイムによる事業損失そのものは補償されません。この現実を、RFPと契約に織り込んでおく必要があります。
保守契約のSLA未達時も、多くの契約ではサービスクレジットや賠償額の上限、間接損害の免責が定められています。これらの条件を要件として確認し、自社が負うリスクの大きさを把握しておくことが、意思決定の前提になります。
賠償上限と免責の条項は、見落とすと致命的になりかねません。IBM 2024の調査では、データ漏洩の被害額は平均445万米ドルにのぼり、重大なバグやインシデントが大きな損害につながり得ることが示されています。
賠償上限が月額保守費の数か月分に限られていれば、損失の大半は自社が負うことになります。そのため、RFPの段階で「SLA未達・重大障害時の補償はどこまでか」を明文化し、自社のリスク許容度と照らして契約条件を交渉することが、賢明な発注者の姿勢です。補償の上限は、SLAの応答時間と並んで、必ず確認すべき要件項目です。
補償まわりは、契約書の条項を社内のリスク許容度と照らし合わせて見ておくと分かりやすくなります。
- 補償の対象:サービスクレジットで済むか、事業損失まで含むか
- 賠償の上限と免責:上限の額と、免責となる損害の範囲
対象環境・体制・引き継ぎ条件のRFPでの定義
SLAと責任範囲を定義したら、残る要件は「誰が、何の環境を、どんな体制で対応し、将来どう引き継ぐか」です。これらは派手さこそありませんが、抜けると後で大きな手戻りを生みます。
対象環境、体制、引き継ぎ条件をRFPで明文化しておくと、長く安定したバグ修正契約の土台になります。
対象システム・環境・監視ツールの明記
RFPには、バグ修正の対象となるシステムと環境を具体的に列挙します。どのアプリケーション、サーバー、データベース、クラウドサービスが対象なのか、本番環境だけか検証環境も含むのかを示します。
これらが曖昧だと、対応対象の認識がベンダーごとに食い違い、見積もりの前提がそろいません。監視ツールも、OSSのZabbix、クラウド型のDatadogやNew Relic、サーバー監視のMackerelなどのうち、どれを使うかを明記すると提案の具体性が増します。
監視ツールは、ホスト数やメトリクス量に応じて中規模で月数万〜数十万円の従量課金となるため、費用の前提としても欠かせません。
対象環境の定義では、システムの規模感も伝えるべきです。一次データでは、運用役務コストはサーバー1台あたり年140万円(JUAS調査の中央値)という目安があり、対象サーバーの台数は費用に直結します。
RFPに対象システムの構成と規模を記すと、ベンダーは適切な体制と工数を見積もれます。逆に規模を伝えないまま見積もりを求めると、「想定より対象が多かった」として追加費用を請求される余地を残してしまいます。
対象を示すときは、範囲と監視の方法を分けて記すと、ベンダーが前提を読み違えにくくなります。
- 本番と検証:どちらの環境を対象に含めるかを明示する
- 監視ツール:ホスト数やメトリクス量を踏まえて、利用するツールを指定する
ベンダー切り替えを見据えた引き継ぎ要件
意外に見落とされがちなのが、将来ベンダーを切り替えるときの引き継ぎ条件です。バグ修正を委託すると、その過程でシステムの内部知識がベンダー側に蓄積されていきます。
もし契約終了時に、ソースコードや障害履歴、運用ドキュメントが引き渡されない取り決めになっていると、別のベンダーへ切り替えられず、特定のベンダーに依存し続けるロックインに陥ります。
RFPの段階で引き継ぎの条件を要件として定めておくことが、主導権を保つ鍵です。
引き継ぎ要件は、いわば出口の設計です。入口である発注の条件ばかりに目が行きがちですが、不満が生じたときにスムーズに別のベンダーへ移れるかどうかは、契約時にしか交渉できません。
引き継ぎに必要な作業量を洗い出し、引き渡しの段取りを要件に含めておくと、ベンダーは健全な緊張感を持って対応し、発注側は選択肢を確保できます。riplaはフルスクラッチ受託と国内運用保守の立場から、引き渡しを前提とした透明な要件定義を重視し、発注者が主導権を持てる契約設計を支援しています。
RFPの引き継ぎ要件は、長期的なリスク管理の観点で必ず盛り込むべき項目です。
引き継ぎの条件は、契約の終わり方から逆算して文書にまとめると分かりやすくなります。
- 引き渡し物:ソースコード、アカウント、ドキュメントの範囲
- 解約と移行:解約予告期間と、移行支援をどこまで受けられるか
対応体制と連絡経路・エスカレーションの要件
対象環境と並んで明文化すべきなのが、バグ発生時の対応体制と連絡経路です。報告に使うチャネルには、電話・メール・チケットシステムなどがあります。
体制の厚みは費用に直結するため、人月単価の目安も押さえておく必要があります。一次データでは、人月単価は監視オペレーターで60万〜80万円、運用設計・インシデント分析で80万〜120万円が目安とされています。求める体制を具体的に書くことで、妥当な見積もりを引き出せます。
発注側の体制も忘れてはいけません。バグ修正はベンダーに任せられても、社内の経営層や業務部門への報告、業務影響の判断は発注者の役割です。RFPには、発注側の窓口担当と、ベンダーからの報告を社内にどう展開するかの想定も記しておくと、いざというときの連携が滑らかになります。
体制と連絡経路の定義は、SLAの数値目標を現場で確実に実行するための運用面の裏づけです。ここを曖昧にしたまま数値だけ立派に書いても、緊急時に機能しなければ意味がありません。
連絡の体制は、受付から上位の技術者へつなぐまでの流れで見ておくと分かりやすくなります。
- 受付と待機:報告の経路と、夜間や休日の待機者を決める
- 上位へのつなぎ:一次対応で解決しないときの、エスカレーション先
まとめ
ITシステムのバグ修正のRFP・要件定義書で押さえるべき項目は、四つの柱にまとめられます。一つ目は対応範囲とバグ・仕様変更の切り分け、二つ目は影響度に応じた優先度区分です。三つ目は応答時間・復旧時間・稼働率の数値要件、四つ目はクラウド責任共有を前提とした切り分けと補償の取り扱いになります。
稼働率は、99.9%なら月43.8分、99.99%なら月4.38分の許容ダウンタイムを意味し、過剰なSLAは費用を跳ね上げます。
事業影響度のアセスメントを根拠に、業務に必要十分な水準を数値で定義することが、適正な見積もりと提案を引き出す鍵です。
要件定義の目的は、形のないバグ修正サービスを数値と文章で輪郭づけ、ベンダー各社を同じ尺度で比較し、後の認識齟齬と隠れコストを未然に防ぐことにあります。
まずは自社の事業影響度を洗い出し、優先度区分とSLAの目標値を社内で合意するところから始めてください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、過剰SLAを避けた現実的な要件定義から、クラウド前提の切り分け設計までを一貫して支援します。
全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。