
ITシステムのバグ修正は、うまく進めば短時間で業務が復旧しますが、対応を誤ると一つのバグが連鎖的な障害を招き、損失と信頼の毀損を広げます。
失敗の原因は、契約の不備や発注側の初動の遅れ、クラウド特有の見えにくさにあります。全体像はITシステムバグ修正の完全ガイドで先に確認できます。
▼全体ガイドの記事
・ITシステムバグ修正の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
安すぎる見積もりに潜む対応範囲の欠落リスク
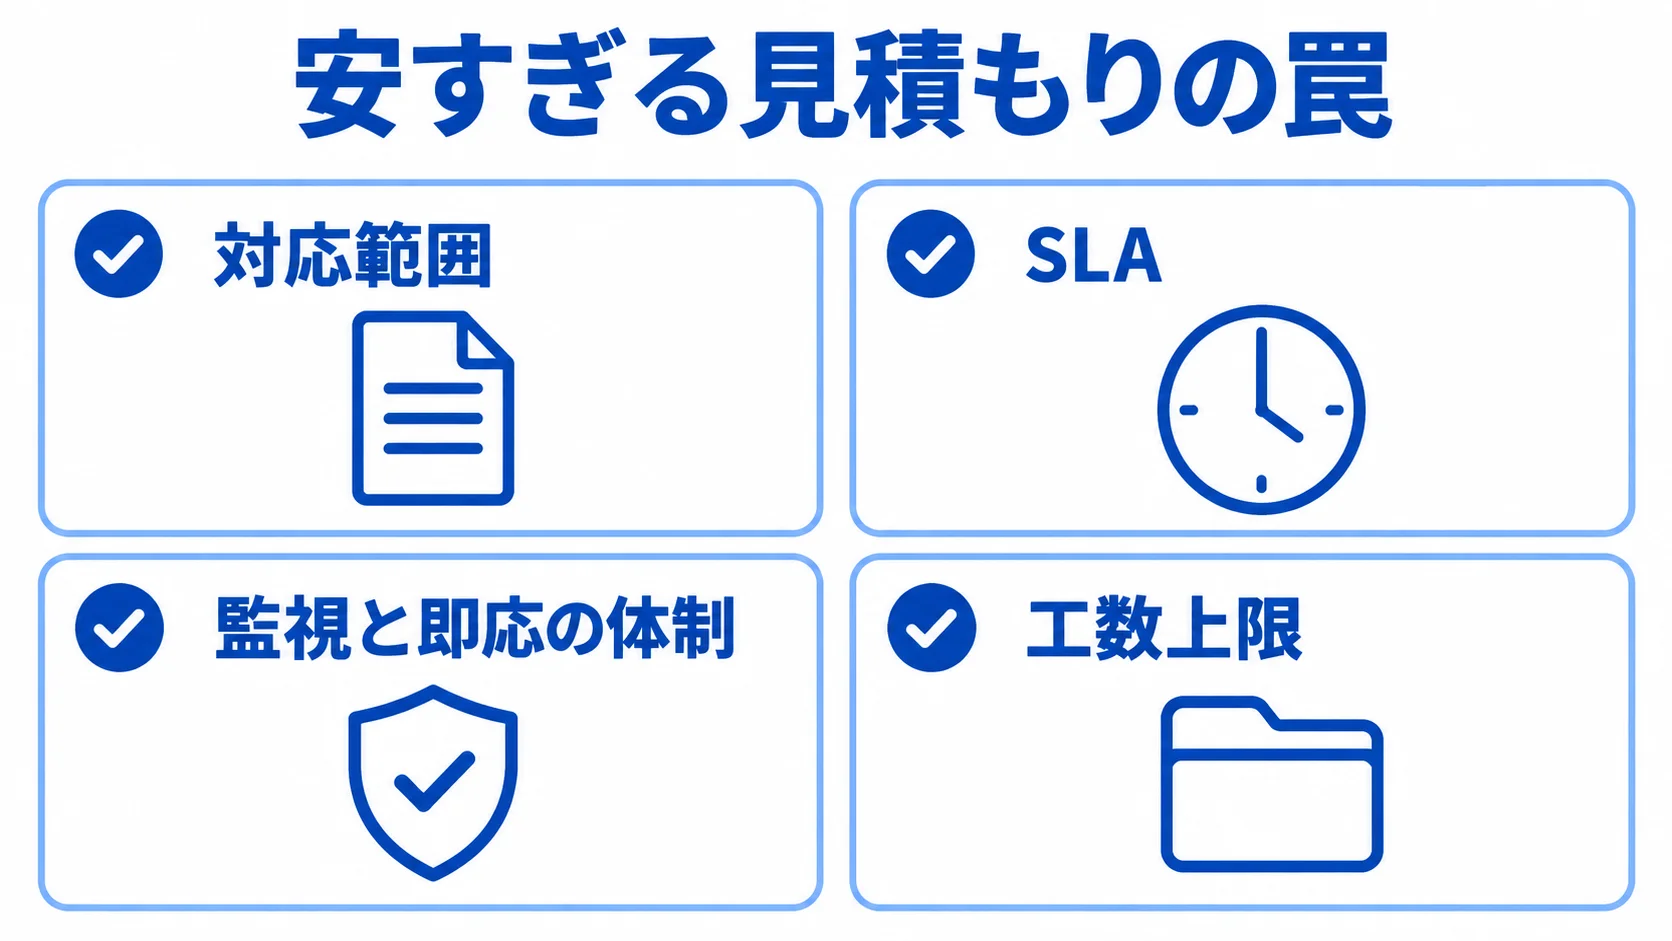
バグ修正・保守の見積もりで最初に注意したいのが、「安すぎる見積もり」の罠です。複数社から相見積もりを取ったとき、突出して安い金額は魅力的に見えます。ただし、その安さは多くの場合、対応範囲やSLAの欠落と引き換えに成り立っています。
価格だけで選ぶと、いざバグが起きたときに「それは契約の範囲外」「監視はしていません」と言われ、結局は高くつくことになります。
SLAと監視の欠落が招く隠れコスト
安い見積もりの典型的な落とし穴は、SLAと監視が含まれていないことです。月額が相場より大幅に安い保守契約は、バグが起きてから受け付けるだけの受け身型になっていることがあります。
一次データでは、運用・監視は月5万〜20万円、24時間緊急対応は月10万〜20万円が相場です。この水準を下回る金額には、監視や即応の体制が含まれていないと疑うべきです。
監視がなければ、バグの検知が遅れ、利用者からのクレームで初めて気づくという後手の対応になります。こうした欠落は、契約時には見えにくい「隠れコスト」として後から表面化します。
基本料金は安くても、バグ対応がすべてスポット扱い(1件3万〜10万円)で別途請求されれば、トータルでは月額固定型より高くつくこともあります。
さらに、検知の遅れによるダウンタイムの損失は、契約金額とは別に自社が被ります。総務省2025年版では、金融・医療・EC系で5分以上の停止が1回1,200万円の機会損失とされています。
監視の欠落による検知遅れの損失が、見積もりの数万円の差を一瞬で吹き飛ばしかねません。安さの裏で何が削られているかは、見積もりの明細から読み解くことが欠かせません。
安さの理由は、どの費用が見積もりに入っていて、どこが抜けているかを見ると分かります。
- SLAの応答・復旧時間:時間の保証が、明細や契約書に書かれているか
- 監視と即応の体制:能動的な監視や24時間緊急対応が、月額に含まれているか
工数上限と対応範囲外の追加請求リスク
安い保守契約のもう一つのリスクが、工数上限と対応範囲の制約です。月額に含まれるバグ対応の工数に上限が設けられ、それを超えた分がすべて追加請求になる契約だと、バグが多発した月に費用が膨らみます。
また、「プログラムの不具合のみ対応、データ修正や設定変更は範囲外」といった狭い対応範囲だと、実際に多いデータ不整合や設定起因のトラブルが軒並み追加費用扱いになります。契約書の対応範囲と工数上限を精読しておかないと、想定外の請求に直面します。
このリスクを避けるには、見積もりを金額だけでなく「対応範囲・SLA・工数上限」の三点セットで比較する必要があります。同じ月額でも、含まれる範囲が広い契約と狭い契約では、実質的な価値がまったく違います。
年間保守費は初期開発費の15〜20%が相場ですが、この水準を著しく下回る見積もりは、何かが削られていると考えて明細を確認すべきです。
riplaはフルスクラッチ受託と国内運用保守の立場から、対応範囲を曖昧にせず明文化し、隠れコストを潰した透明な見積もりを重視しています。安さに飛びつく前に、その価格で何がカバーされるのかを冷静に見極めることが、後悔しない選定の鍵です。
想定外の請求を避けるには、対応範囲と工数上限がどこから追加費用になるのかを見ておく必要があります。
- 対応範囲:どこまでを契約の対象とし、どこからを追加費用とするか
- 工数上限:上限を超えた分が、追加請求の対象になる条件
クラウド監視のブラックボックス化と自衛策
国内エンタープライズ・システムのクラウド比率が約5割(IDC Japan、2022年)に達した今、クラウド特有のリスクがバグ修正の現場で顕在化しています。それが「監視のブラックボックス化」です。
クラウド基盤の内部はユーザー側から見えず、基盤側で障害が起きても手出しができません。この見えなさが、原因調査の難航や復旧の遅れを招きます。
基盤障害は手出し不可・補償も限定的というリスク
クラウド基盤で障害が起きると、利用者側でできることは限られます。原因がアプリのバグなら自社やベンダーが直せます。一方で、クラウド事業者側の障害は、ユーザーがコードを見直しても解決できず、事業者の復旧を待つしかありません。
さらに深刻なのは、基盤障害による損失への補償が限定的なことです。クラウド事業者の補償の多くはサービスクレジット(利用料の一部返金)にとどまり、ダウンタイムで失った売上や信頼は補償されません。
「クラウドだから安心」という思い込みは、この補償の現実を知ると揺らぎます。
このリスクが厄介なのは、自社のシステムに何の問題もなくても、基盤障害の巻き添えで業務が止まる点です。Gartner 2024の試算では、ダウンタイム1分あたり5,600米ドルの損失とされ、長時間の基盤障害は無視できない金額になります。それでも補償は利用料返金止まりで、損失の大部分は自社が負います。
クラウドへの移行には多くのメリットがあります。ただし、「基盤障害時は手出しできず、補償も限定的」というリスクを前提に、どう自衛するかを設計しておくことが、賢明な発注者の備えです。
基盤障害の損失を抑えるには、補償がどこまで及ぶかと、復旧を待つあいだに業務をどう回すかを押さえる必要があります。
- 補償の範囲:利用料の返金のほかに、どこまでの損失が対象になるか
- 復旧を待つ間の業務:事業者の復旧を待つあいだ、手作業などで業務を回す段取り
マルチリージョン等のアーキ設計による自衛策
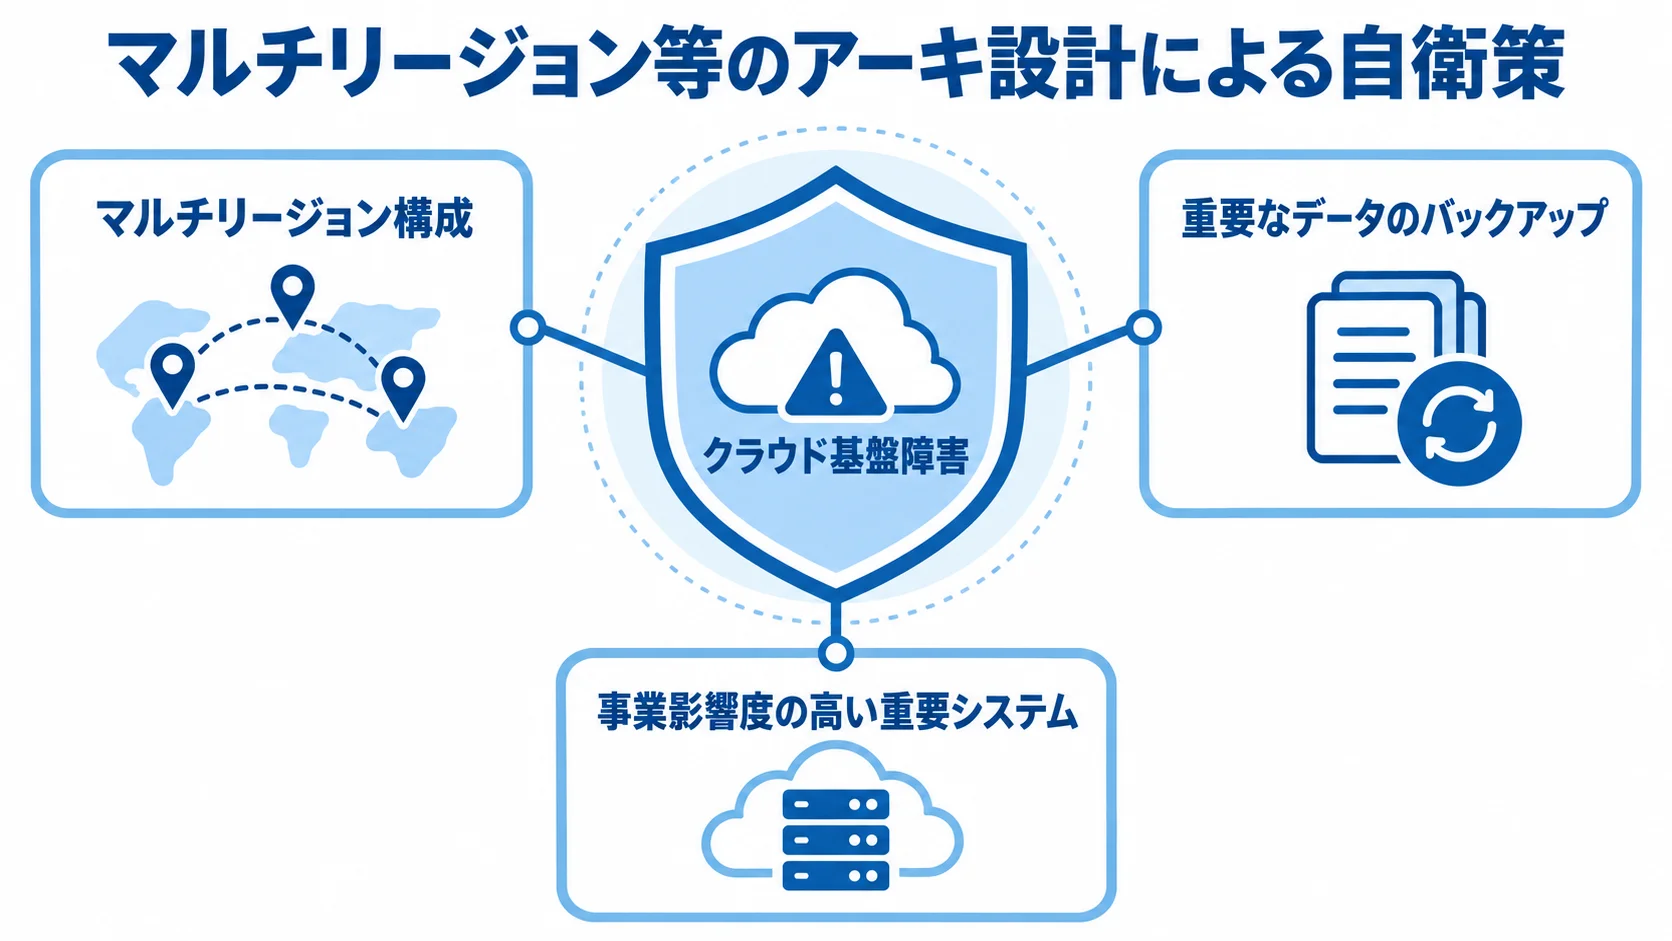
クラウドのブラックボックス化に対する自衛策は、アーキテクチャ設計にあります。代表的なのが、システムを複数のリージョン(地理的に分かれたデータセンター)に分散させるマルチリージョン構成です。
一つのリージョンで基盤障害が起きても、別のリージョンで業務を継続できれば、基盤障害の影響を局所化できます。同様に、重要なデータのバックアップを別系統に確保しておけば、基盤障害時のデータ消失リスクにも備えられます。
手出しできない基盤障害に対しては、「冗長化で被害を局所化する」設計が現実的な防御策です。ただし、こうしたアーキテクチャ設計には隠れコストが伴う点に注意が必要です。マルチリージョン化は構成が複雑になり、構築・運用の費用も上がります。
すべてのシステムに高度な冗長化を施すのは過剰投資であり、事業影響度の高い重要システムに絞って自衛策を講じるのが合理的です。
riplaはフルスクラッチ受託と国内運用保守の立場から、クラウドの「手出しできない領域」を見極め、必要な範囲に冗長化を施す費用対効果の高い自衛設計を支援しています。
クラウドのリスクは、見えないことを前提に、設計で被害を抑え込む発想で向き合うことが大切です。
分散先と冗長化の範囲は、設計の段階で決めておく必要があります。
- 分散先のリージョン:一つの地域が止まったときに、業務を続けられる別の地域
- 備えの対象:事業影響度の高い重要システムから順に、冗長化の範囲を絞り込む
発注者側の初動失敗とベンダー丸投げのリスク
バグ修正の失敗は、ベンダー側だけの問題ではありません。発注者(情シス)側の立ち回りが、被害の大きさを左右します。
とくに重大なバグが起きたときの初動と、ベンダーへの過度な丸投げは、見落とされがちなリスクです。技術対応はベンダーに任せられます。ただし、社内のコミュニケーションとBCP(事業継続計画)の責任は、発注側が負わなければなりません。
報告遅延とBCP不在が被害を拡大させるリスク
発注者側の初動でもっとも多い失敗が、社内への報告遅延です。報告のルールとフォーマットを事前に用意していないと、いざというときに誰も適切な一報を出せず、現場が原因究明に追われるあまり報告が後回しになって、社内が混乱します。さらに、得意先からの問い合わせが殺到して、二次被害が広がります。
BCP(事業継続計画)の不在も、構造的なリスクです。システムが長時間止まったとき、業務をどう代替し、手作業でどこまで凌ぐかを決めていないと、復旧を待つ間に業務が完全に止まってしまいます。
たとえば、IBM 2024の調査では、データ漏洩の検知まで平均204日、被害額は平均445万米ドルとされ、深刻なインシデントは長期化し得ます。
バグ修正をベンダーに任せる場合でも、復旧までの間の業務継続をどう確保するかは発注側の責任です。また、BCPと初動報告の体制を持たないことは、それ自体が大きなリスクです。
初動の混乱を防ぐには、一報の出し方と、システムが止まった間の代替手段を事前に用意しておく必要があります。
- 初回の一報:原因が分からなくても、現状と次の報告時刻を経営層や業務部門へ伝える
- 代替手段の計画:システムが止まった間の業務を、どう代替するかを決めておく
ベンダー丸投げと過剰・過少SLAの落とし穴
「保守はベンダーに任せているから大丈夫」という丸投げの姿勢も、見過ごせないリスクです。システムの仕様や過去のバグ履歴を発注側がまったく把握していないと、ベンダーを切り替えたいときに引き継ぎができません。
さらに、特定のベンダーに依存し続けるロックインに陥ります。解約を予告する時期や、作業量を洗い出す方法、ソースコードやアカウントを引き渡す方法といった切り替え手順を、契約の段階で確かめておかないと、いざ不満があっても動けません。丸投げは楽な反面、自社が主導権を失うリスクと表裏一体です。
また、SLAの水準を誤るリスクも見落とせません。過剰なSLAは、本来不要な高コスト体制を抱えて費用を浪費し、過少なSLAは、いざというときの対応が遅れて損失を招きます。
稼働率99.9%は月43.8分、99.99%は月4.38分の許容ダウンタイムを意味し、「9」が一つ増えるごとにコストは跳ね上がります。特に、発注側が念のためと高いSLAを求め続けると、コストだけがかさみます。
riplaはフルスクラッチ受託と国内運用保守の立場から、事業影響度に基づき過剰でも過少でもないSLAを設計し、発注側が主導権を保てる体制づくりを支援しています。バグ修正のリスクは、技術以上に契約と体制の設計に潜んでいることを忘れてはいけません。
丸投げによる失敗を防ぐには、SLAの水準と仕様・履歴の共有を、契約と体制の両面で押さえる必要があります。
- SLAの水準:事業影響度をビジネス部門と擦り合わせたうえで決めた数値か
- 仕様と履歴の共有:システムの仕様や過去のバグ履歴を、発注側も把握しているか
テスト軽視による「直して壊す」デグレードのリスク
発注側が見落としがちなもう一つのリスクが、修正そのものが新たなバグを生む「デグレード(先祖返り)」です。たとえば、急ぎの障害対応で、修正後のテストを十分に行わずに本番へ反映すると、直した箇所は動くものの、別の機能が壊れるという事態が起きます。
とくに「とにかく早く直してほしい」という発注側の圧力が強いと、ベンダーがテストを省いて応急対応に走り、結果として二次障害を招きます。速さを求めるあまり品質を犠牲にすると、一つのバグが複数のバグへ膨らみかねません。
このリスクを避けるには、発注側が「速さ」と「確実さ」のバランスを理解し、回帰テスト(既存機能が壊れていないかの確認)まで含めた修正を求めることが大切です。重大障害では、まず暫定の切り戻しで止血し、恒久修正はテストを通してから反映する二段構えが有効です。
発注側が「とにかく今すぐ直して」と急かすだけでなく、「止血と恒久対応を分けて、恒久対応は確実に」と伝えられるかどうかが、デグレードを防ぐ分かれ目になります。テストを軽視させない発注の姿勢も、立派なリスク管理の一部です。
デグレードを防ぐには、修正を依頼する時点で、止血の進め方と回帰テストの範囲を伝えておく必要があります。
- 止血の方法:暫定の切り戻しで、まず被害を止めてから恒久修正に進むこと
- 回帰テストの範囲:既存機能が壊れていないことを、修正のたびに確かめる
修正履歴を残さない属人化のリスク
バグ修正の履歴を記録せずに対応を続けることも、後で大きな代償を払うリスクです。誰が、いつ、どのバグを、どんな理由でどう直したのかが残っていないと、同種のバグが再発したときに一から調査をやり直すことになり、対応時間が無駄に延びます。
さらに、修正を担った担当者が退職・異動すると、その修正の意図が誰にも分からなくなり、迂闊に触ると別の不具合を誘発する「触れない領域」が増えていきます。属人化したまま記録を残さない運用は、時間とともにシステムを保守困難にしていきます。
このリスクを抑えるには、修正のたびに記録を更新する運用を契約に組み込むことです。記録が蓄積されるほど、似たバグへの対応は速くなります。また、ベンダーを切り替える際の引き継ぎも、スムーズになります。
riplaはフルスクラッチ受託と国内運用保守の立場から、直して終わりにせず、修正履歴と再発防止策を誰でも読める形で残す運用を重視しています。記録を残さない手軽さは目先の楽でしかなく、長期的にはシステムの寿命を縮める隠れたリスクであることを、発注側は理解しておくべきです。
属人化を防ぐには、修正の経緯を誰でも追える形で残しておく必要があります。
- 障害管理台帳:バグの事象、原因、修正内容、再発防止策を一覧にして残す
- 修正の意図:誰が何をどう直したかが、担当者が替わった後も分かる状態
賠償上限・免責条項の見落としリスク
バグ修正・保守の契約で、いざというときに最も後悔しやすいのが、賠償上限と免責条項の見落としです。多くの保守契約では、SLA未達や重大障害が起きても、ベンダーが負う賠償の額に上限が設けられ、間接的な損害は免責とされています。
契約時に価格やSLAの数値ばかりに目が行き、この条項を精読しないまま締結すると、大きな損失が出たときに「ほとんど補償されない」という現実に直面します。法務観点のリスクは、平時には見えにくいだけに危険です。
賠償は保守費数か月分が上限という現実
多くの保守契約では、バグによって生じた事業損失がどれほど大きくても、ベンダーから受け取れる補償は契約で定めた上限までです。
IBM 2024の調査では、データ漏洩の被害額は平均445万米ドルにのぼります。月額数十万円の保守契約で賠償上限が数か月分なら、補償は被害のごく一部にとどまります。そのため、損失の大半は、最終的に発注側が自社で負う構造だという現実を直視する必要があります。
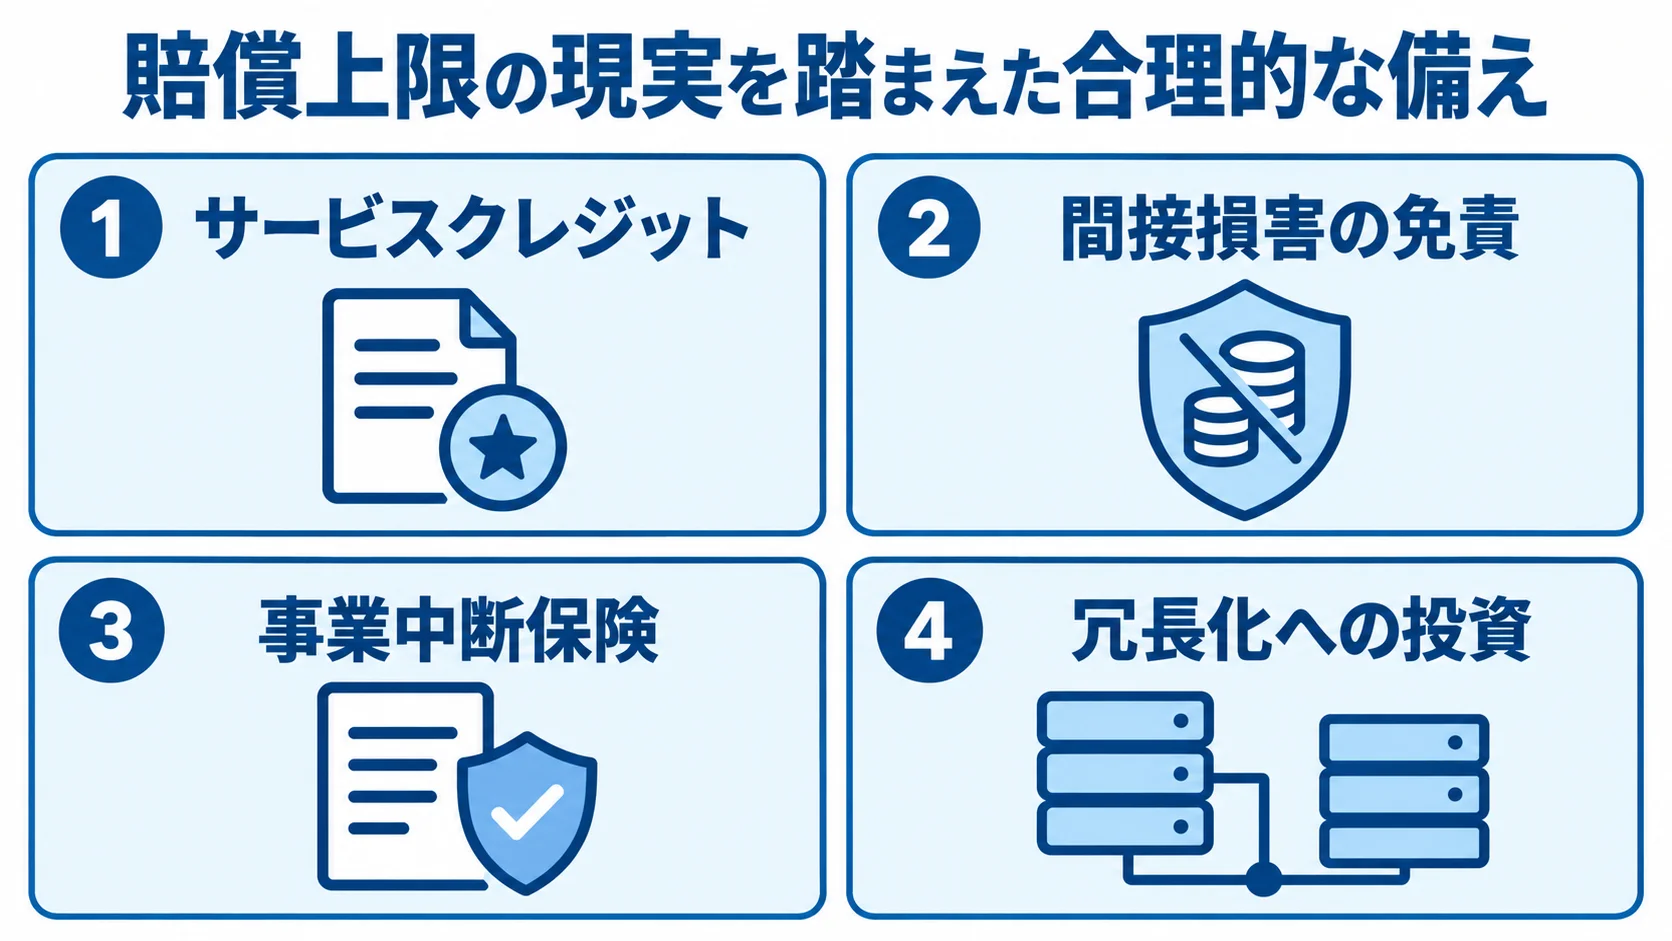
さらに、サービスクレジット(保守費の一部返金)が唯一の救済手段とされ、それ以上の賠償請求を認めない契約も少なくありません。たとえば、SLA未達のペナルティが「翌月の保守費を一部減額」止まりなら、停止による実損とは桁が合わないことになります。
重要なのは、この上限を知ったうえで、足りない分のリスクを自社でどう吸収するかを考えることです。具体的には、事業中断保険などの手当てや、そもそも停止を起こさない冗長化への投資が、賠償上限の現実を踏まえた合理的な備えになります。
賠償の上限と救済手段は、契約書の条項を読めば確かめられます。
- 賠償上限の金額:月額保守費の何か月分か、契約金額の総額のどちらか
- 救済手段:サービスクレジットのほかに、賠償請求を認める条項があるか
間接損害の免責と交渉余地のリスク
賠償上限と並んで見落とされやすいのが、間接損害の免責条項です。バグによる直接的な復旧費用は補償の対象になっても、それに起因する逸失利益や信用毀損、取引先への賠償といった間接損害は免責と定められているのが一般的です。
ところが、バグ障害で実際に痛いのは、この間接損害のほうであることが多いのです。
いざというとき「想定していた補償が一切受けられない」事態になりかねません。
これらの条項は定型文として提示されることが多いものの、すべてが交渉不能というわけではありません。事業影響度の高い重要システムについては、賠償上限の引き上げや、特定の重大障害に限った特約を交渉できる余地があります。
そのため、発注側が条項を理解し、リスクの大きい部分にだけ的を絞って交渉すれば、過大なコストをかけずに守りを固められます。riplaはフルスクラッチ受託と国内運用保守の立場から、契約条項のリスクを発注側に分かりやすく示し、どこを交渉し、どこを自社で吸収するかの判断を支援しています。
賠償上限と免責は、平時に読み込んでこそ意味を持つ、見えないリスクの核心です。
交渉に入る前に、免責の範囲と交渉の対象を整理しておくと、求めるべき点がはっきりします。
- 間接損害の範囲:免責の対象に、どこまでの損害が書かれているか
- 交渉の対象:賠償上限の引き上げや、重大障害に限った特約を求められるか
総務省2025年版の統計では、5分以上の停止が1回1,200万円の機会損失とされ、その多くは免責対象の逸失利益に当たります。
まとめ
ITシステムのバグ修正にまつわる失敗・リスクを振り返ると、その多くは技術力の不足ではなく、契約と体制の設計の甘さから生まれています。たとえば、安すぎる見積もりに潜む対応範囲の欠落、クラウド監視のブラックボックス化、報告遅延とBCP不在、ベンダー丸投げと過剰・過少SLAが挙げられます。
監視の欠落による検知遅れは1回1,200万円の機会損失を招きかねず、基盤障害の補償は利用料返金止まりです。SLAの水準を誤れば、コストか損失のどちらかが膨らみます。
これらはいずれも、事前の備えで防げるリスクです。リスクを避けるために大切なのは、見積もりを金額だけで判断せず、対応範囲・SLA・工数上限の三点で比較することです。
クラウドの手出しできない領域には冗長化で備えます。また、発注側として初動報告とBCP、ベンダー切り替え手順を整えておくことが大切です。まずは自社の保守契約と障害対応体制を点検し、どこに穴があるかを洗い出してください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、開発元として継続伴走しながら、隠れコストと体制の穴を潰した堅実なバグ修正の仕組みづくりを支援します。
全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。