
本記事は、ITシステムのリリース対応に関する導入事例・開発事例・活用事例・成功事例を、発注企業の視点から掘り下げる「事例特化」の解説です。取り上げる事例は、手順の自動化、当番体制の見直し、切り戻しの仕組み化、移行の立て直しの4つに分かれます。
各事例の問題点と、事故や作業時間をどれだけ減らせたかを見ていきます。全体像をまだ把握していない方は、まずITシステムリリース対応の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステムリリース対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
手動デプロイからCI/CDへ移行して事故を減らした事例
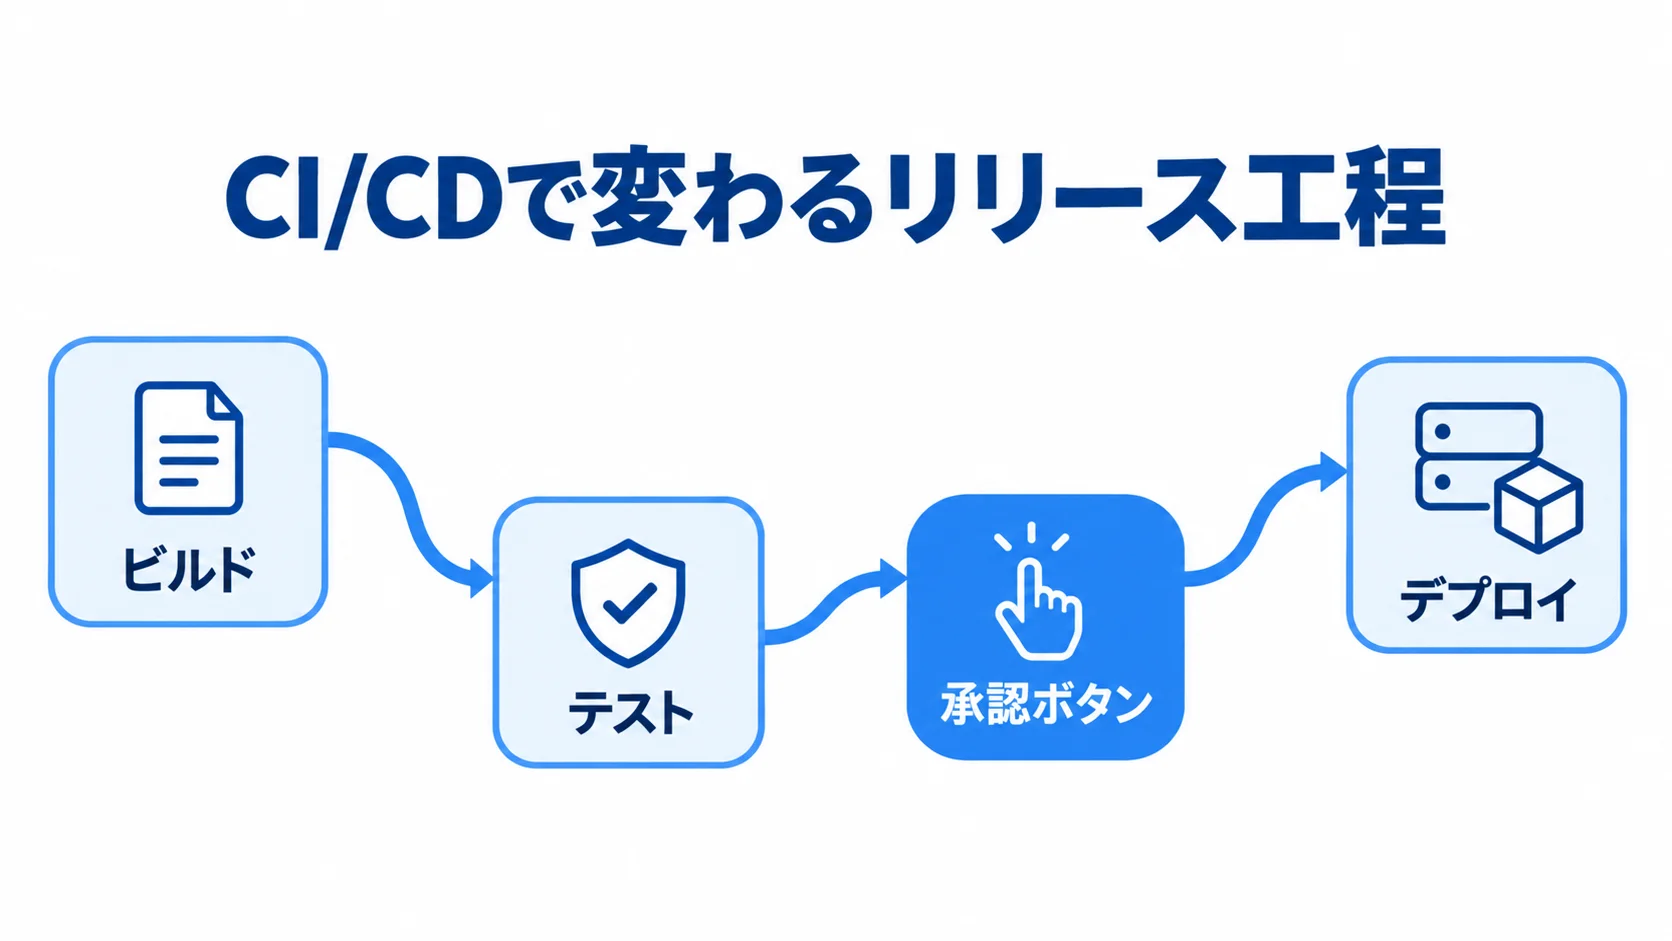
ITシステムのリリース対応で、最も分かりやすく成果が出やすいのが、手動デプロイからCI/CD(継続的インテグレーション/継続的デリバリー)への移行です。手作業でサーバーにファイルを配置し、設定を書き換え、サービスを再起動する従来のやり方は、手順の抜け漏れや作業者ごとのばらつきが障害につながります。
リリースのたびに緊張が走り、深夜帯にしか作業できない現場は少なくありません。
デプロイ自動化で人的ミス起因の障害を減らした事例
ある中規模の業務システムでは、リリース作業の大半を手順書に沿った手作業で行っていました。設定ファイルの差し替え漏れや、本番とステージングの環境差異に気づかないまま反映するミスが繰り返されていました。
また、リリース起因の障害が運用保守の障害対応工数を押し上げていました。一次データでは、保守費の内訳のうち障害対応が25〜35%を占めるとされています(出典:ripla)。
こうした障害の一定割合が、リリース時の人的ミスから生じているケースも珍しくありません。
この事例では、ビルド・テスト・デプロイを自動化するパイプラインを整備し、本番反映をワンクリックまたは承認ボタン経由に切り替えました。その結果、設定漏れや環境差異による事故が減り、リリース起因の障害対応工数も圧縮できます。
大切なのは、自動化を「速くするための仕組み」と捉えるだけでなく、「事故を減らし、誰がやっても同じ結果になる仕組み」と位置づけることです。リリース対応の改善は、まずこの再現性の確保から始まります。
導入後の変化は、自動化の範囲と承認の位置に分けて捉えると分かりやすくなります。
- 自動化の範囲:ビルド、テスト、デプロイのうち、どこまでを仕組みに任せるか
- 承認の位置:本番反映の前に、人が判断を入れる一点をどこに置くか
リリース頻度を上げ軽微改修を素早く反映した事例
CI/CD移行のもう一つの効果は、リリース頻度を上げられることです。手動リリースの時代は「リスクが高いから、まとめて月1回」という運用になりがちで、その結果、1回のリリースに大量の変更が詰め込まれていました。
さらに、何が原因で問題が起きたのかを切り分けにくくなります。変更の塊が大きいほど、事故の影響も切り戻しの難しさも増すという悪循環です。
自動化後の事例では、小さな変更を頻繁にリリースする方針へ切り替え、軽微改修や仕様変更対応を「ためずに素早く反映」できるようになりました。
一次データでは、保守費の内訳のうち軽微改修が10〜15%を占めています(出典:ripla)。この軽微改修を速やかにリリースへ乗せられるかどうかが、利用部門の満足度を左右します。
1回のリリースの変更量を小さく保つことで、万一問題が起きても原因の特定が容易になり、切り戻しの影響範囲も限定されます。リリース対応の事例を読むときは、「速さ」だけでなく「変更の粒度を小さくして事故を御しやすくした」という点に注目してください。
変更の粒度と切り戻しの関係を押さえると、この節の効果の見方が定まります。
- 変更の量:1回のリリースに含める変更を、どこまで小さく区切れるか
- 切り戻しの範囲:問題が起きたとき、戻す対象をどこまで限定できるか
深夜・休日のリリース当番を平準化した事例
リリース対応の痛みは、技術だけでなく体制・人の問題でもあります。多くの現場では「リリースは利用者が少ない深夜・休日に行う」という慣行があり、特定のエンジニアに当番が偏ったり、属人化したりしています。
この事例では、リリース体制そのものを設計し直すことで、深夜作業の負担を平準化し、属人化を解消しました。
手順書を整備し誰でもリリースできる体制にした事例
属人化したリリースの典型は、「あのエンジニアでないと本番反映できない」という状態です。担当者が不在だとリリースが止まり、その人が退職すると手順がブラックボックスになります。
この事例では、リリース手順をすべて文書化し、前提条件・実行コマンド・確認項目・切り戻し手順までをひとつのリリース手順書(ランブック)にまとめました。さらに、手順を自動化スクリプトに落とし込み、チェックリストと連動させたことで、特定の個人に依存しないリリースを実現しています。
この標準化によって、リリース当番を複数のメンバーで回せるようになり、深夜・休日の負担が分散しました。運用要員の人月単価は60万〜150万円が目安とされますが(出典:ripla)、属人化した状態では高単価のベテランをリリースのたびに拘束することになり、コスト効率も悪化します。
手順を誰でも実行できる形に整えることは、属人化を解消するだけでなく、リリース対応にかかる運用コストを見直すきっかけにもなります。事例から学べるのは、ツールの導入と手順の文書化・標準化を並行して進めることの大切さです。
体制の見直しは、手順と当番の二つの面から見ると整理できます。
- 手順の持ち方:前提条件から切り戻しまでを、誰が読んでも同じように実行できるか
- 当番の回し方:リリースの担い手を、特定の人ではなく複数のメンバーで分けられるか
ひとり情シスがリリース運用を外部委託した事例
中堅・中小企業でよく見られるのが、情報システム担当が実質1名という「ひとり情シス」の体制です。この担当者がリリースから障害対応まで一手に引き受けていると、休暇も取りにくく、本人が倒れればシステムの保守が止まるという深刻なリスクを抱えます。
事例では、リリースを含む運用保守を外部サービスへ委託し、社内担当を企画・調整の役割に集中させることで、この単一障害点を解消しました。
サービスとしての運用委託は、月20万〜50万円程度から始められる相場感があります(出典:ripla)。また、専任要員を1人採用するより安価かつ柔軟に体制を確保できる場合があります。
この事例で大切なのは、「どこまでをベンダーに任せ、どの判断を社内に残すか」を明確に分けた点です。リリースの実行や監視は委託しつつ、リリース可否の判断や利用部門との調整は社内に残しました。
こうした切り分けによって、外部委託でも現場感覚を失わない運用が成り立ちました。ひとり情シスの体制を見直したい企業にとっては、この進め方が参考になります。
役割分担を決める際は、社内の担当者がどこまで関わるかを、先に話し合っておく必要があります。
- 委託の範囲:運用保守の作業を、どこまで外部サービスに預けるか
- 社内に残す判断:リリース可否と利用部門との調整を、誰が受け持つか
本番障害からの切り戻しと再発防止を仕組み化した事例
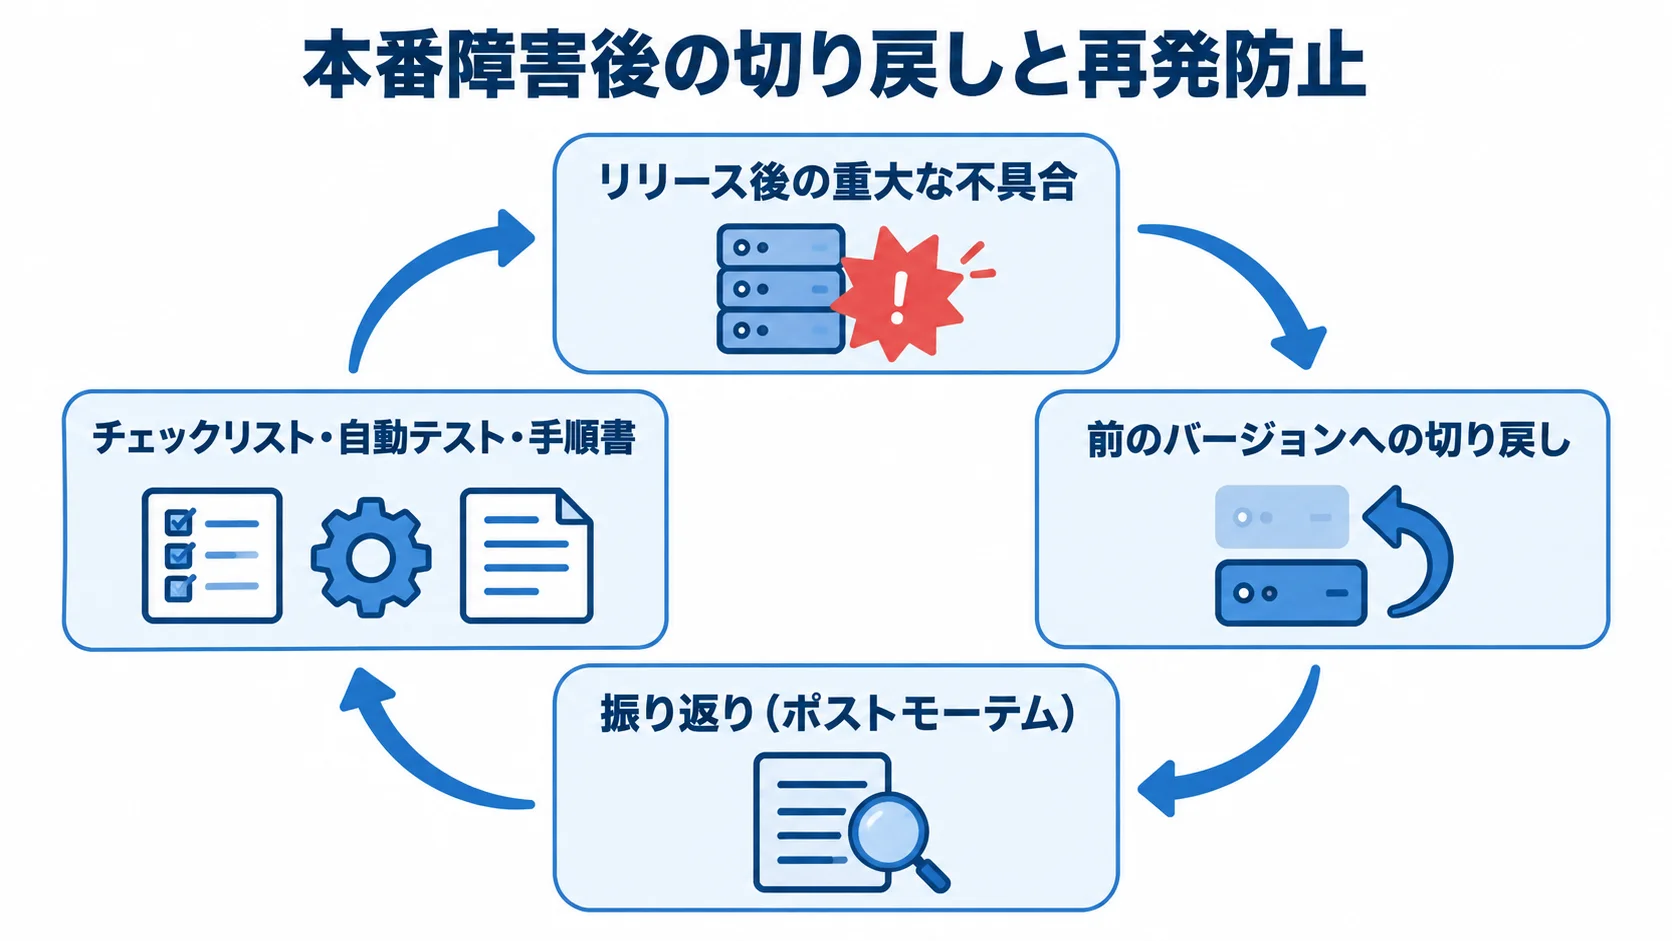
どれだけ準備しても、リリース後に想定外の不具合が出ることはゼロにはできません。事例の価値は「事故を起こさない方法」だけでなく、「事故が起きたときに被害を最小化する方法」を学べる点にあります。
この事例では、切り戻し(ロールバック)を確実に行える仕組みと、障害を次に活かす再発防止の仕組みを整えることで、リリースのリスクを管理可能な範囲に収めました。
即時切り戻しでサービス停止を短時間に抑えた事例
リリース後に重大な不具合が発覚したとき、最優先すべきは原因究明よりも「まず元に戻して利用者への影響を止める」ことです。
この事例は、本番障害からの切り戻しと再発防止を仕組み化した事例の一つで、新旧バージョンを切り替えられる仕組みを用意し、問題が出たら数分で前のバージョンに戻せる体制を整えていました。
SLAでは稼働率99.9%が一つの目安とされ、月に許される停止時間はおよそ43分と厳しい水準です(出典:ripla)。そのため、切り戻しに時間がかかるほど、この許容枠をあっという間に使い切ってしまいます。
重大インシデントでは、初報への応答を15分以内、復旧を4時間以内とするSLAも一般的です(出典:ripla)。この復旧目標を守るには、切り戻しを「いざというときすぐ実行できる」状態にしておく必要があります。
事例では、リリース前に必ず切り戻し手順を確認し、戻せない変更(不可逆なデータ移行など)を含むリリースは特別な扱いにする運用を徹底していました。リリース対応の成熟度は、新しい機能をどれだけ速く出せるかよりも、問題が起きたときどれだけ速く安全に戻せるかに表れます。
切り戻しの仕組みは、戻す単位と、戻すまでの時間の二つで見ると分かります。
- 切り替えの仕組み:新旧バージョンを、どの単位で切り替えられるか
- 戻すまでの時間:問題が発覚してから前のバージョンに戻るまで、どれくらいかかるか
振り返りを文化にして再発を防いだ事例
切り戻しで被害を止めた後に重要なのは、なぜ問題が起きたかを振り返り、再発を防ぐ仕組みに落とし込むことです。
この事例では、リリース起因の障害が起きるたびに、関係者で原因と背景を分析する振り返り(ポストモーテム)を実施しました。ポイントは、個人の責任追及ではなく「どの仕組みがあれば防げたか」に焦点を当てたことです。担当者を責める文化では、ミスが隠蔽され、同じ事故が繰り返されます。
振り返りで得られた教訓は、リリース前チェックリストの追加項目や、自動テストのケース、手順書の注意書きとして仕組みに反映されます。
こうして一つひとつの障害から学ぶことで、リリースのたびに事故率が下がっていきました。riplaはフルスクラッチ受託と国内運用保守の立場から、「作った後の継続的な改善」を重視しています。また、こうした振り返りの文化づくりこそが、リリース対応の品質を底上げすると考えています。
事例を読むときは、華々しい成功よりも「失敗をどう次に活かしたか」という地味な営みに注目してください。
振り返りを続けるには、教訓の残し方と問いの立て方を決めておくことが欠かせません。
- 教訓の残し先:チェックリスト、自動テスト、手順書のどこに反映するか
- 問いの立て方:原因を個人の判断ミスに閉じず、背景まで掘り下げられているか
移行・カットオーバーで失敗しかけて立て直した事例
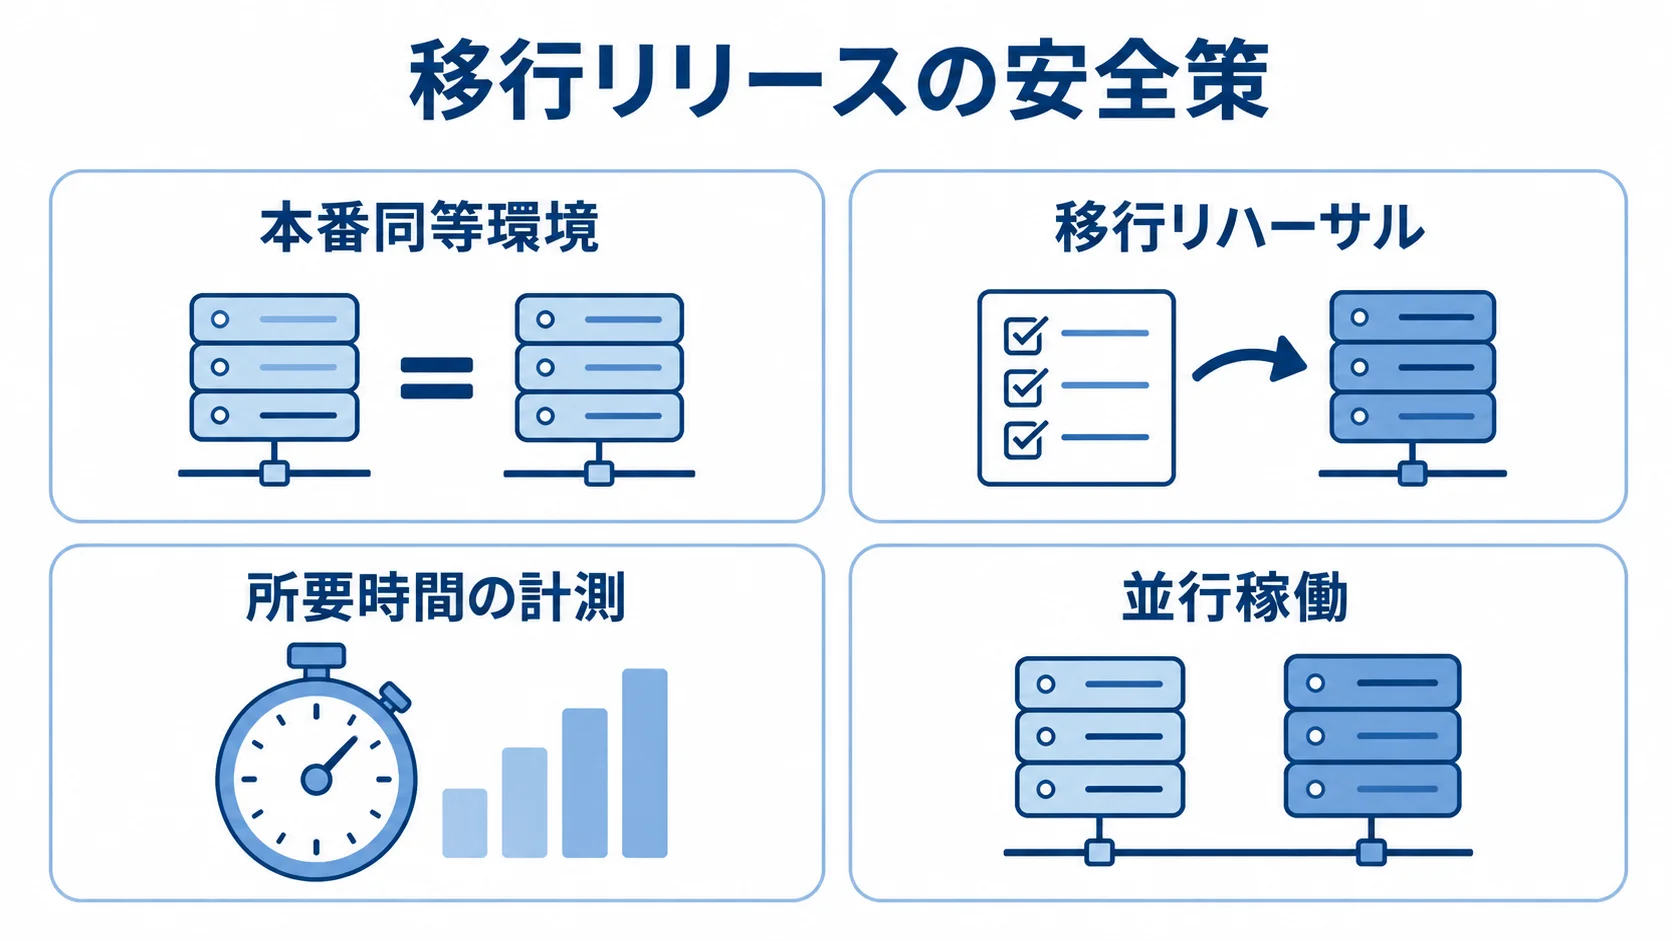
通常の機能リリースに比べて、はるかに難易度が高いのが、システム刷新やクラウド移行に伴う「カットオーバー(新システムへの本番切り替え)」です。これは一度きりの大規模リリースであり、失敗が許されません。
この事例は、移行リリースで一度つまずきかけたものの、計画を立て直して無事に切り替えを完了させたケースです。
本番同等環境でリハーサルを重ねた事例
最初の計画では、移行作業を一発勝負で本番に臨もうとしていましたが、テスト環境でのデータ移行に想定の倍以上の時間がかかることが判明しました。
本番の作業可能時間(メンテナンスウィンドウ)に収まらなければ、サービスを長時間止めることになります。そこでこの事例では、本番とほぼ同等の環境を用意し、移行リハーサルを複数回繰り返しました。
リハーサルのたびに所要時間を計測し、手順のボトルネックを一つずつ潰していきました。
リハーサルを重ねた結果、本番の移行作業は計画どおりの時間で完了し、利用者への影響を最小限に抑えられました。大規模システムの運用保守費は、規模により月50万〜200万円以上とされ、基幹システムでは年500万〜1,500万円という相場もあります(出典:ripla)。
また、移行リリースの失敗による損失や手戻りは、この保守費を上回ることがあります。リハーサルにかける時間と費用は、失敗の確率を下げるための投資として十分に見合うものです。事例が示すのは、「ぶっつけ本番を避け、本番同等環境で繰り返し検証する」という地道な準備が、大規模リリースを成功させる基本だということです。
移行リハーサルの効果は、所要時間と本番の作業可能時間を比べると見えてきます。
- 手順ごとの所要時間:リハーサルのたびに、どの手順が長いかを把握しているか
- 作業可能時間との差:本番のメンテナンスウィンドウに収まるかを、事前に確かめているか
並行稼働で安全に切り替えた事例
立て直しのもう一つの鍵が、新旧システムを一定期間並行して動かす「並行稼働」の採用でした。
当初は旧システムを一気に止めて新システムへ全面切り替えする計画でしたが、万一の不具合時に戻る先がなくなるリスクが大きいと判断し、段階的な切り替えに変更したのです。
一部の利用部門から先行して新システムへ移し、問題がないことを確認しながら順次拡大していきました。
並行稼働には二重の運用コストがかかります。それでもこの事例では、「全面停止で取り返しのつかない失敗をするより、コストを払ってでも安全に切り替える」という判断を優先しました。
結果として、移行中に見つかった細かな不具合を旧システムでカバーしながら修正でき、利用者にほとんど混乱を与えずに切り替えを完了させています。移行・カットオーバーという特殊なリリースでは、平時のスピード重視とは逆に、「戻れる安全策をどれだけ用意するか」が成否を分けます。
この点は、失敗やリスクの観点とも深く関わります。リスク面の解説もあわせて参考にしてください。前述のITシステムリリース対応の完全ガイドでは、こうした移行計画の全体像も整理しています。
並行稼働の進め方は、切り替える範囲と旧システムの受け皿の二点で見ると分かりやすくなります。
- 切り替えの範囲:先行させる利用部門を、どの順で広げていくか
- 旧システムの受け皿:移行中に見つかった不具合を、どこまで旧システムでカバーできるか
まとめ
ITシステムのリリース対応事例を振り返ると、成功も失敗からの回復も、結局は一点に集約されます。その一点とは、手順を標準化・自動化して再現性を高め、変更の粒度を小さく保ち、いざというとき安全に戻せる仕組みを用意することです。
手動デプロイからCI/CDへの移行は人的ミス起因の障害を減らし、手順書の整備と外部委託は深夜当番の偏りや属人化を解消しました。また、即時切り戻しと振り返りの文化は、事故の被害と再発を抑えます。
移行・カットオーバーのような一度きりの大規模リリースでは、本番同等環境でのリハーサルと並行稼働という安全策が成否を分けました。
事例を読むときに大切なのは、「どれだけ速くリリースできるか」ではなく「事故をどう御し、問題が起きたときどう立て直したか」という視点です。
自社のシステム規模とリリース頻度に照らし、まずは手順の文書化と切り戻し手順の整備という、着手しやすいところから一歩を踏み出してください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、作った後のリリース対応まで継続的に伴走し、事故を減らす仕組みづくりを一貫して支援します。
全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。