
ITシステムの保守は、開発後も監視や障害対応が続き、システムの寿命とビジネスの安定を左右します。本記事は、ITシステム保守構築の導入事例・開発事例・活用事例・成功事例を、発注企業の視点から掘り下げる「事例特化」の解説です。
事例は、ベンダー乗り換え、障害件数の改善、ひとり情シスの立て直し、塩漬けシステムの再生、クラウド・SaaS連携の保守に分けて、一次データとあわせて具体的に紹介します。全体像はITシステム保守構築の完全ガイドで確認できます。読み終えるころには、自社が「どこから着手し、どんな効果を狙うべきか」のイメージが描けるはずです。
▼全体ガイドの記事
・ITシステム保守構築の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ベンダー乗り換えで保守費とTCOを最適化した事例
ITシステム保守構築の事例で、もっとも切実なテーマの一つが「高止まりした保守費の見直し」です。年間保守費は開発費の15〜20%が一つの目安とされています(出典:ripla)。
長く同じベンダーに任せ続けるうちに、内訳が不透明なまま惰性で支払い続けているケースも少なくありません。
乗り換えを検討する企業は、まず保守費の内訳を可視化するところから立て直しを始めています。
保守費の内訳を可視化して無駄を削った事例
ある中規模のシステムを抱える企業では、月額の保守費が一括で請求され、その内訳がまったく見えない状態が続いていました。
乗り換えにあたって保守業務を棚卸ししたところ、保守費は定期保守20〜30%、監視15〜25%、障害対応25〜35%、問い合わせ対応10〜20%に分かれていました。軽微改修10〜15%、管理・報告5〜10%といった項目にも分解できることが分かりました(出典:ripla)。
内訳が見えたことで、「ほとんど発生していない障害対応に大きな枠を払い続けていた」「定型の監視は安価なツールで代替できた」といった無駄が浮かび上がったのです。
この事例が示すのは、保守費の交渉や乗り換えは、「総額をいくら下げるか」より「どの項目にいくら払っているか」を可視化するところから始まる、という点です。
内訳が分かれば、自社で巻き取れる作業、ツールで自動化できる作業、専門ベンダーに任せるべき作業を切り分けられます。
保守構築の最初の一歩は、この棚卸しによって支払いの構造を発注側が握り直すことだと言えます。
見直しの際は、業務ごとの費用と、その業務がどれくらい発生しているかを並べて見ると、判断の材料がそろいます。
- 棚卸しの対象:定期保守から管理・報告まで、保守業務を項目ごとに並べた一覧
- 作業の振り分け先:自社、自動化ツール、専門ベンダー
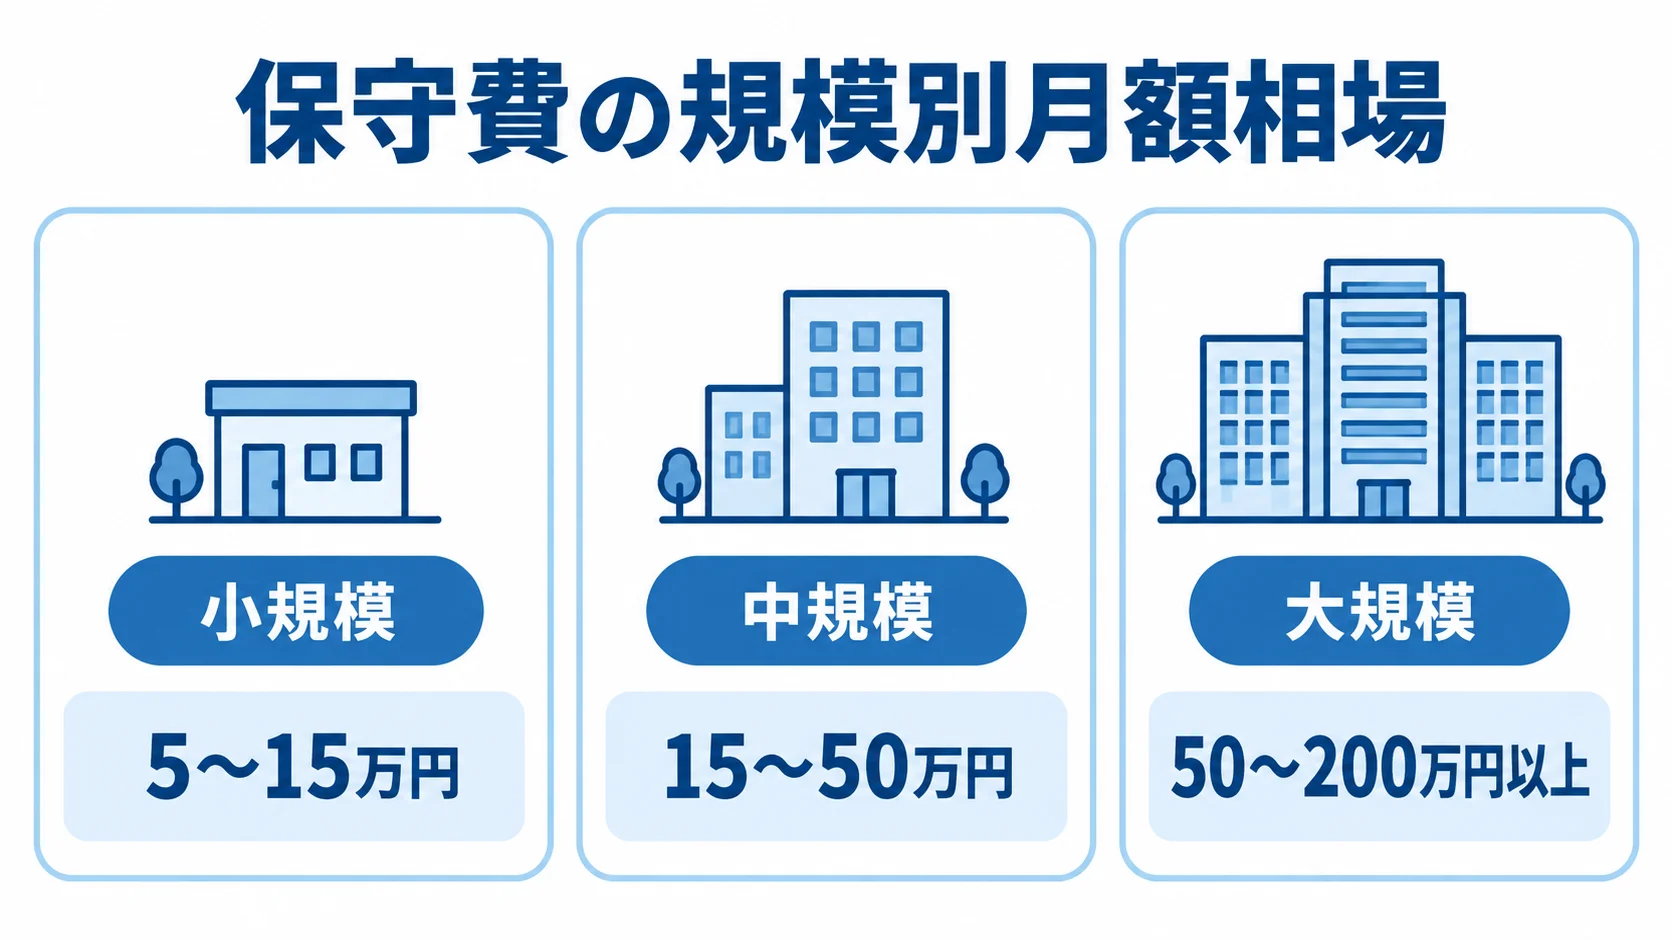
規模別の月額相場は、小規模で5〜15万円、中規模で15〜50万円、大規模で50〜200万円以上が一つの目安です(出典:ripla)。製造業の基幹システムでは年間500万〜1,500万円、EC・Web系では年間50〜200万円という水準もあります。
乗り換えを検討した企業は、自社の保守費がこの相場のどこに位置するかを照らし合わせ、内訳の不透明さと相場からの乖離を交渉材料にしました。こうした相場観が、惰性の支払いを見直す出発点になります。
二重コストを最小化して移管を完了した事例
保守ベンダーを乗り換える際に最大の障壁になるのが、引き継ぎ期間に旧ベンダーと新ベンダーへ両方支払う「二重コスト」です。
乗り換えに成功した事例では、移管の段取りを工程化して進めました。
並走期間がだらだらと延びると二重コストが膨らむため、「いつまでに何を引き継ぎ、いつ切り替えるか」をスケジュール化したのです。この企業はTCO(総保有コスト)の観点で保守費を圧縮しつつ、移管時のサービス停止リスクも抑えられました。
乗り換えは、「安いベンダーに変える」ことより、「数年スパンのTCOを最小化する」プロジェクトとして設計するのが成功の条件だと、この事例は示しています。
移管の段取りは、引き継ぐ対象と比較に含める費用を決めるところから組みます。
- 引き継ぎの対象:ドキュメント、ソースコード、運用手順、エスカレーション経路
- 比較に含める費用:移管の一時費用と、運用が安定するまでのコスト
障害発生時のエスカレーション経路の再設定も、あらかじめ期限を区切って行いました。
旧ベンダーが残していたドキュメントの存在も、この移管がうまくいった背景にありました。システム構成が文書にまとめられていたため、新ベンダーは短期間で全体像を把握でき、並走期間を最小限に抑えられたのです。
一方で、ドキュメントがない状態での移管は引き継ぎが難航し、二重コストが膨らみます。乗り換えの成否は、平常時からどれだけ引き継げる状態を保っていたかに左右される、という教訓もこの事例には含まれています。
障害件数をBefore/Afterで改善した保守構築事例
保守構築の成果は、最終的に「障害がどれだけ減ったか」「障害が起きてもどれだけ早く復旧できたか」という形で表れます。
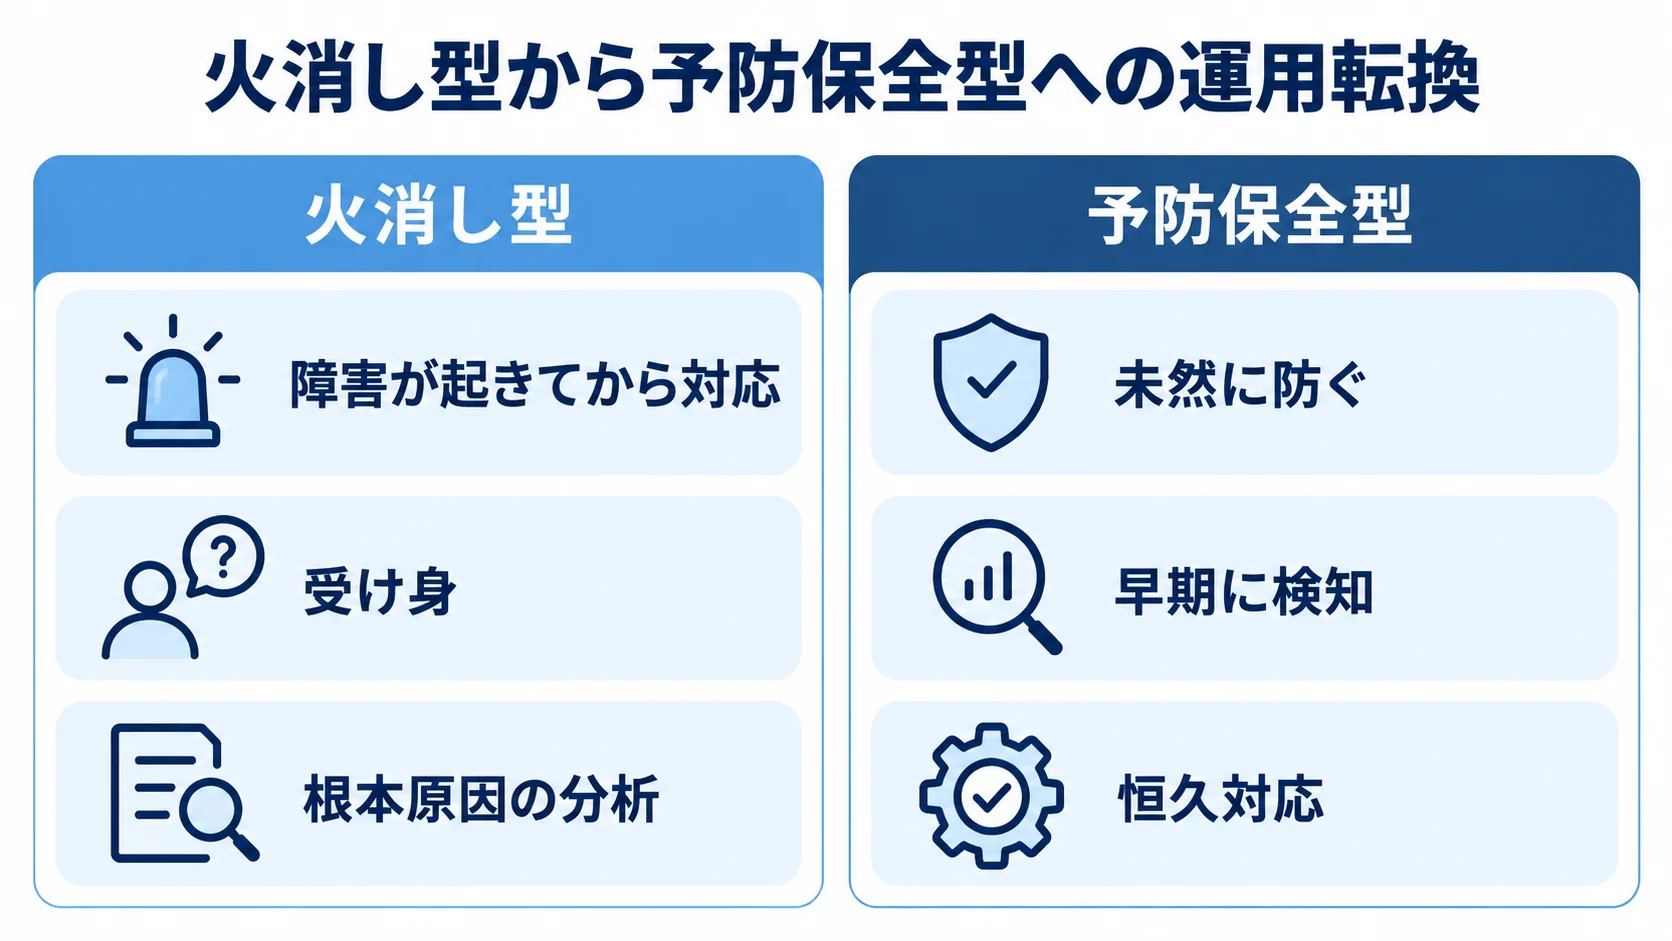
事後対応に追われる火消し型の運用から、未然に防ぐ予防保全型の運用へ転換し、障害件数と復旧時間の両方を改善した事例は、保守構築の投資効果を最も分かりやすく示します。
火消し型から予防保全型に転換した事例
障害が起きてから慌てて対応する火消し型の運用では、担当者は常に受け身で、根本原因の分析や再発防止に手が回りません。
改善に成功した事例では、まず監視の仕組みを整え、障害の前触れを早期に検知できるようにしました。頻発していた障害の原因を一件ずつ分析し、設定変更やプログラム修正による恒久対応を積み重ねていったのです。
この転換の効果は、障害件数のBefore/Afterに端的に表れます。たとえば、それまで毎月のように発生していた同種の障害は、原因を一つずつ潰すことで激減しました。運用チームは火消しに追われる時間を、改善や定期メンテナンスに振り向けられるようになりました。
保守構築の本質は、障害ゼロを目指す完璧主義ではなく、「同じ障害を二度起こさない」仕組みを地道に作ることにある、と事例は教えています。
改善の進め方は、兆候の検知と原因の分析に分けて見ると、全体の流れをつかめます。
- 早期に検知する兆候:サーバーのリソース逼迫、エラーログ
- 恒久対応の対象:頻発していた障害の原因
SLAを定義して復旧時間を短縮した事例
障害件数を減らすと、次に重要になるのが、起きてしまった障害への対応速度です。事例では、保守構築の中でSLA(サービス品質保証)を明文化し、数値で定義しました。
SLAを定義したことで、「障害が起きたらいつまでに何をするか」が運用チームと発注側で共有され、対応の遅れや責任の押し付け合いがなくなりました。さらに、数値目標があれば、障害対応の振り返りも定量的に行え、基準を満たせなかった応答や復旧の原因を改善に回せます。
SLAは単なる契約上の文言ではなく、復旧時間を実際に短縮するための運用の基準として機能します。こうした基準を最初に決めておくことが、安定運用への近道になります。
数値の決め方は、何を指標にし、何を振り返るかに分けて考えます。
- 定義した指標:稼働率、応答時間、復旧時間
- 振り返りの対象:基準を満たせなかった応答や復旧の原因
具体的には、稼働率99.9%(月間で約43分の停止を許容)と、重大障害の初報応答15分・通常障害2時間を定めました。そのほか、エスカレーションは30分、復旧は重大4時間・通常8時間としています。
恒久対応は5営業日という基準も示されています(出典:ripla)。
ひとり情シスを委託で立て直した保守事例
多くの中小企業では、社内のIT担当者がたった一人で全システムの保守を抱える「ひとり情シス」の状態に陥っています。この体制は、担当者の退職や急病で一気にブラックボックス化する危険をはらんでいます。
外部委託をうまく取り入れて、この属人化リスクを解消した事例は、同じ悩みを持つ企業にとって大きな示唆になります。
属人化を解消しドキュメントを整備した事例
ひとり情シスから委託へ切り替えた事例で最初に取り組んだのは、頭の中にしかなかった運用手順とシステム構成のドキュメント化でした。委託先と協働で文書として残すことで、誰が見ても保守を引き継げる状態を作ったのです。担当者一人に依存していたリスクが大幅に下がりました。
委託の費用感としては、サービス委託で月20万〜50万円、より専門的な運用要員を確保する場合は人月60万〜150万円が目安です(出典:ripla)。ひとり情シスの人件費や、担当者が辞めたときの損失と比べると、委託で体制を二重化し、属人化を解消する投資は十分に合理的だと、多くの企業が判断しています。
事例が示すのは、委託は「丸投げ」ではなく、社内に残す判断の機能と、外に出してよい実作業を切り分けて進めるものだ、という点です。
立て直しの中身は、文書にした項目と、委託の費用の単位に分けて見ると整理できます。
- 文書にした項目:サーバー構成、定期作業の手順、障害時の連絡網、過去のトラブル履歴
- 委託の費用の単位:月単位のサービス委託と、人月単位の運用要員
委託で時間を作り内製化に移行した事例
委託の活用事例の中には、外部委託を一時的な手段と位置づけ、最終的に内製化へ移行したケースもあります。まず日々の定型運用を委託に出して担当者の時間を確保し、その間に社内で運用ノウハウを学び直していく流れです。
社内チームが自走できるようになった段階で、委託範囲を縮小していったのです。
内製化への移行で重要なのは、ノウハウの移転を「自然に任せる」のではなく、ロードマップとして計画したことです。
どのスキルを社内で持ち、どの単価の人材を採用し、どの作業から内製に切り替えるかを、段階的に設計しました。
保守構築では、最初から完璧な体制を目指すより、委託で体制を支えながら自社の力をつけていく段階的な進め方が現実的です。委託と内製は状況に応じて比率を変えていくものだと、この事例は教えています。
内製化の進め方は、委託の段階と計画に含める事項に分けて見ると整理できます。
- 委託の段階:定型運用の委託、知見の移転、委託範囲の縮小
- 内製化の計画に含める事項:社内で持つスキル、採用する人材の単価、内製に切り替える作業
塩漬けシステムを立て直した保守構築事例
事例の価値は、成功談だけでなく、「なぜ保守が行き詰まったのか」「どう立て直したのか」というリアルな経験にあります。
改修されないまま古びてしまった塩漬けシステムを、保守構築によって再び動かせる状態に戻した事例は、これから同じ岐路に立つ企業にとって参考になります。
塩漬け化の原因を突き止めた事例
塩漬けシステムが生まれる原因は、技術的な古さよりも、保守構築の体制が組まれていなかったことにあります。誰も中身を把握できないまま「触ると壊れるから放置する」状態に陥っていました。OSやミドルウェアが対応期限を過ぎたまま残され、セキュリティリスクが静かに膨らんでいたのです。
立て直しの第一歩は、現状のシステムを丁寧に解析し、構成と依存関係を把握することでした。ソースコードや設定を読み解き、どのモジュールが何に依存しているかを洗い出したことで、安全に手を入れられる範囲を特定したのです。
塩漬けは一日でできたものではないため、立て直しも一気に進めるのではなく、影響範囲の小さいところから着実に手を入れていくのが鉄則だと、この事例は示しています。
原因を突き止める流れは、ドキュメントの有無を確かめることから始まりました。
- 塩漬けの要因:ドキュメントの不在、ベンダーとの関係の断絶、サポート切れの放置
- 調べる対象:構成、依存関係、ソースコードと設定
継続伴走で安定運用に乗せた事例
塩漬けからの立て直しに成功した事例に共通するのは、一度きりの改修で終わらせず、その後も継続的に伴走する保守構築の体制を作ったことです。
把握したシステムに対しては、保守の業務を計画的に回す仕組みを整えました。その流れに改修も乗せ、二度と塩漬けに戻らないようにしたのです。システムはビジネスの変化に合わせて少しずつ進化を続けられるようになりました。
riplaは、フルスクラッチ受託と国内運用保守の立場から、「作った後も継続して伴走する」保守構築を一貫して重視しています。
塩漬けの立て直し事例が教えるのは、保守は開発が終わってからの付け足しではなく、システムの寿命とビジネス価値を守り続ける投資だという原則です。事例を読むときは、「どんな機能を作ったか」ではなく「作った後をどう支え続けたか」という視点で見ることが、失敗を避ける近道になります。
継続伴走の体制は、回す業務と、その効果に分けて見ると整理できます。
- 定期的に回す業務:定期メンテナンス、アップデート対応、軽微改修、仕様変更対応
- 伴走の効果:ビジネスの変化に合わせて、システムが進化を続けられること
クラウド・SaaS連携時代の保守を立て直した事例
近年の保守構築の事例で増えているのが、クラウド基盤や外部SaaS、AI連携を前提にしたシステムの保守を、どう立て直したかというテーマです。
自社のプログラムだけが動いていた時代と違い、いまのシステムは、AWSなどのクラウド、決済や認証のSaaS、生成AIのAPIといった「自社のコントロール外」の部品と組み合わさって動いています。
前提の変化を踏まえずに従来型の保守契約を結んでいた企業が、障害のたびに混乱したという事例は、後を絶ちません。
責任分界を整理して障害対応の空白をなくした事例
ある企業では、連携していたSaaSのAPI仕様が予告どおりに変更され、自社システムの一部機能が突然エラーを返すようになりました。
しかし当時の保守契約には、「外部SaaS起因の不具合」への対応が定義されていませんでした。そのため、ベンダーは「うちのアプリの問題ではない」との立場を取り、自社は「保守を任せていたのに」と感じるなかで、対応が宙に浮いたのです。
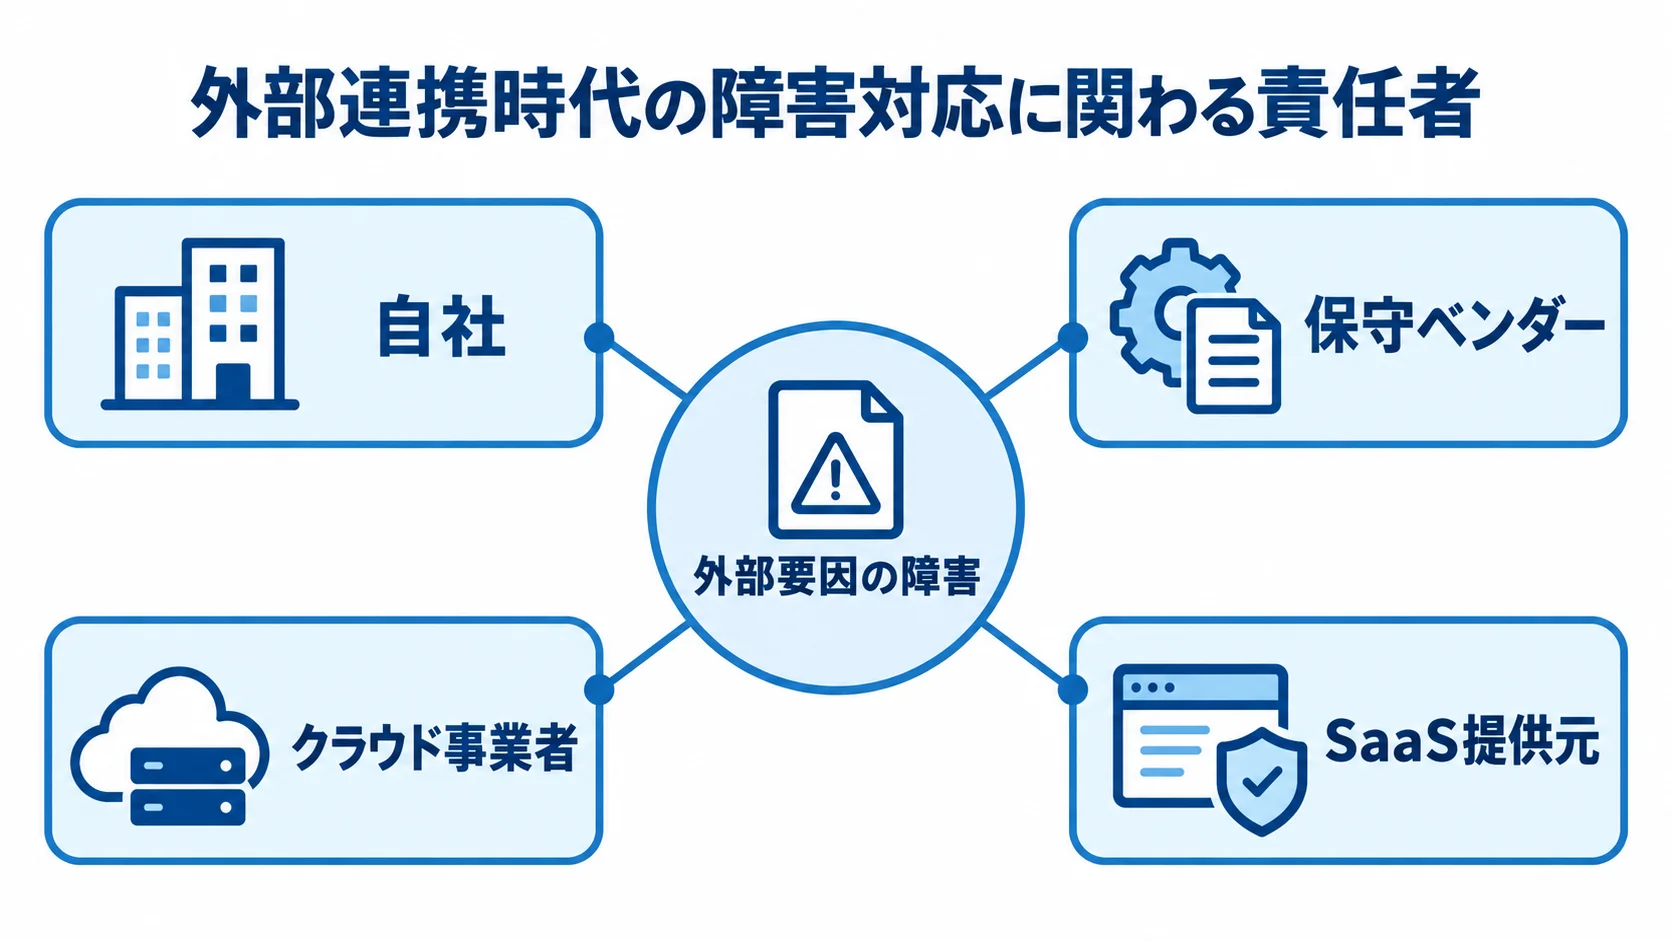
立て直しでは、まず関係者ごとに何に責任を持つかを、表として整理し直しました。
次に連携先の障害が起きたときに誰が動くかで迷う時間がなくなり、復旧までの混乱が減ったのです。事例から読み取れるのは、クラウド・SaaS時代の保守構築では、自社で直せる範囲だけでなく「コントロール外で起きた障害をどう支えてもらうか」まで設計しておくことが、安定運用の決め手になる、という点です。
保守契約の見直しは、責任の所在と、契約に書き込んだ役割の二つに分けて考えます。
- 責任の整理先:自社、保守ベンダー、クラウド事業者、SaaS提供元
- 契約に書き込んだ役割:切り分けと暫定対応の支援、復旧後の影響確認
外部要因の障害でも、保守ベンダーが担う範囲を契約に書き込みました。
監視自動化で運用工数を圧縮した事例
もう一つの事例は、人手による監視の限界を、自動検知の仕組みで乗り越えたケースです。
サーバーやアプリのログ、リソースの状況を担当者が目視で追っていた頃は、異常の発見が遅れたり、深夜の障害を朝まで気づけなかったりしていました。異常を機械的に見つけ、重大なアラートだけを担当者へ通知する仕組みを保守構築に組み込みました。
運用チームは大量のアラートに埋もれることなく、本当に対応が必要な事象に集中できるようになりました。自動検知によって生まれた時間を、障害の根本対応や定期メンテナンス、改善提案に振り向けられる点に価値があります。
AI連携やMLOpsを含む高度な保守では、月50万〜200万円といった水準になることもあります(出典:ripla)。
事例から読み取れるのは、保守構築の進化が「人を減らす」ことではなく、「人をより付加価値の高い仕事に振り向ける」ことにある、という点です。
自動検知を取り入れた監視は、検知の対象と通知の範囲に分けて設計すると全体がつかめます。
- 自動検知の対象:ログやリソースの、平常時のパターンから外れた挙動
- 通知の範囲:重大なアラートだけ
まとめ
ITシステム保守構築の事例を振り返ると、成功も立て直しも、結局は同じところに集約されます。その要点は、「保守費の内訳を可視化し、障害を未然に防ぐ仕組みとSLAという基準を持ち、属人化を解消しながら継続的に伴走する」ことです。
ベンダー乗り換えではTCOの観点で総額を比較し、障害件数はBefore/Afterで定量的に改善し、ひとり情シスは委託と内製化の組み合わせで立て直せます。塩漬けシステムも、現状を把握して継続伴走の体制に乗せれば、再びビジネスに貢献するシステムへ戻せます。
事例を読むときに大切なのは、「どれだけ立派なシステムを作ったか」より「作った後をどう支え続けたか」という視点です。自社のシステムの規模と状況に照らし、まずは保守費の棚卸しや障害の原因分析という、効果の見えやすいところから一歩を踏み出してください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、現状の把握から継続的な保守構築までを一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。