
ITシステムの保守構築で求められる機能は、大きく4つに分けて考えられます。必要な機能と水準を言語化し、契約範囲に沿って続けることで、安定した運用と適正なコストを両立させやすくなります。
- 監視・バックアップ:稼働状況の把握と、復旧に備えたデータの退避
- 障害対応・SLA:障害時の対応と、品質水準の設定
- 定期更新・改修:計画に沿った保守作業と、業務の変化への追従
- 自動検知・報告:異常の自動通知と、運用状況の報告
▼全体ガイドの記事
・ITシステム保守構築の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
監視・バックアップという保守の基盤機能
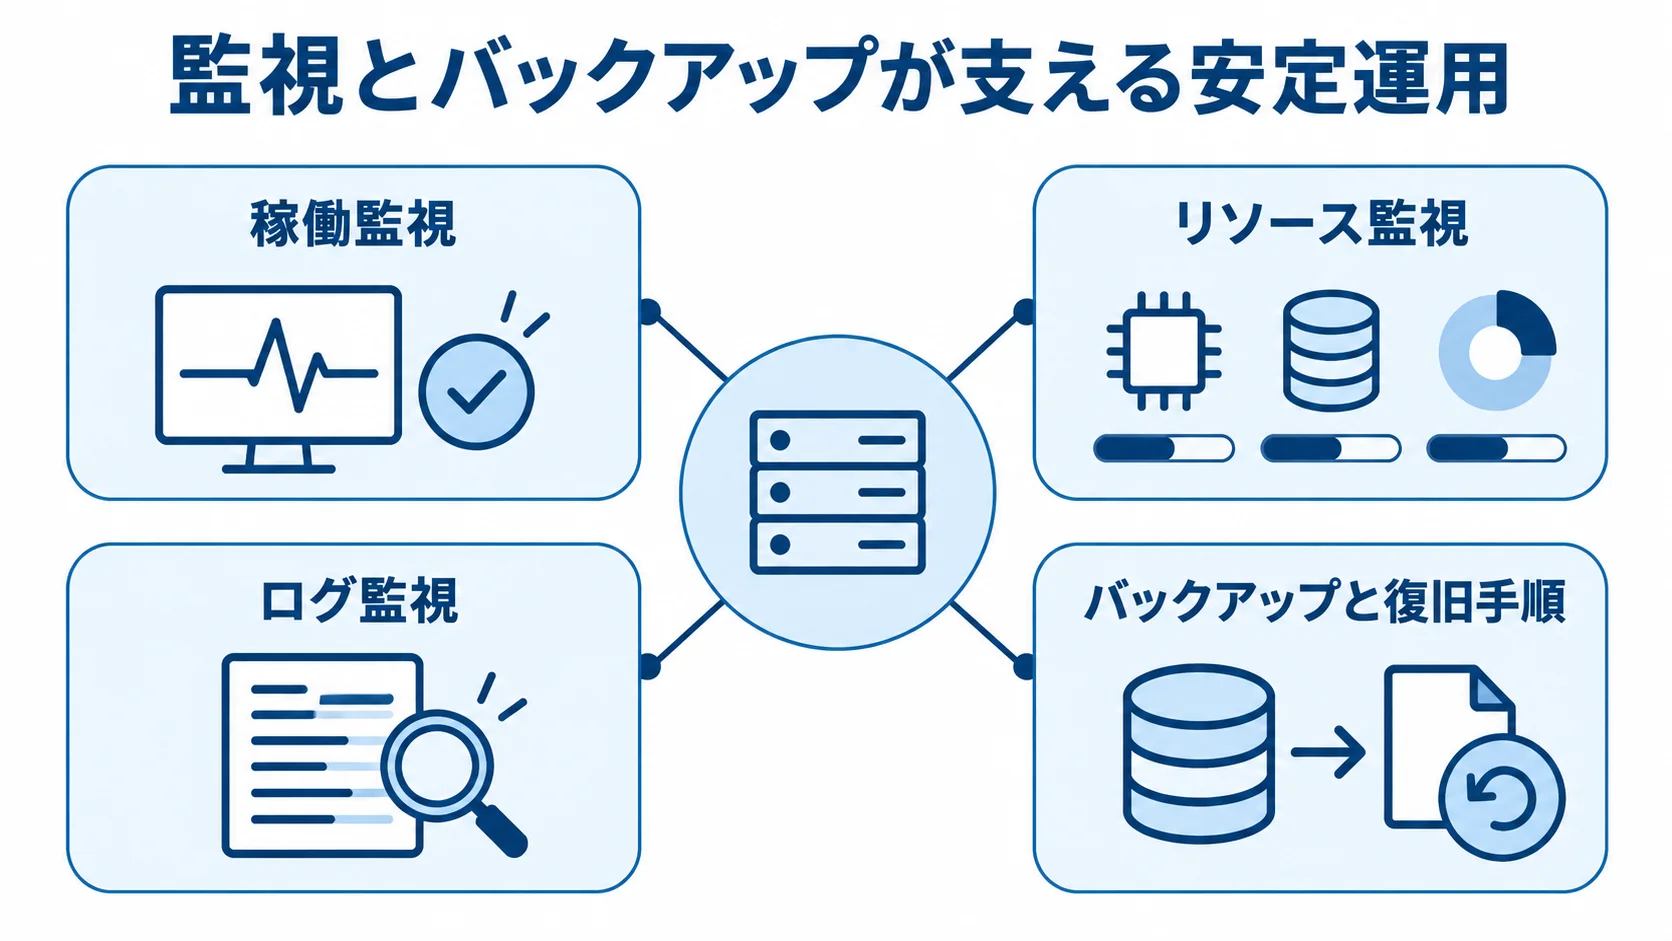
保守構築が提供する機能の基盤になるのが、システムの状態を常に見張る監視と、万一に備えるバックアップです。これらは派手さこそありませんが、保守費の内訳でも監視が15〜25%を占めるとされ(出典:ripla)、安定運用を支える中核機能です。
逆に、監視とバックアップが機能していないと、障害の発見が遅れ、データを消失しても復旧できないという致命的な事態を招きます。
稼働監視・リソース監視・ログ監視の役割
監視機能は、稼働監視・リソース監視・ログ監視に大きく分けられます。稼働監視はサービスの応答を常時チェックして停止を即座に検知し、リソース監視はCPU・メモリ・ディスクの使用状況を追って逼迫の兆候を捉えます。また、ログ監視はエラーログや異常なアクセスを拾い上げ、障害やセキュリティインシデントの予兆を見つけます。
これらが連携して初めて、「障害が起きてから気づく」のではなく「障害になる前に手を打つ」予防保全が可能になります。そのためには、保守構築で何を、どの間隔で、どの閾値で監視し、異常時に誰へどう通知するかを設計しておくことが、機能を実効性のあるものにします。監視は、導入時の設定ではなく、閾値や通知ルールを運用しながら磨き込んでいく積み重ねによって価値が決まります。
閾値は緩すぎても厳しすぎても機能せず、緩いと異常を見逃し、厳しすぎると無害なアラートが大量に発生して重要な兆候が埋もれます。これは「アラート疲れ」と呼ばれ、運用現場が形骸化する大きな原因になります。だからこそ、保守構築では運用しながら閾値を調整し、通知すべきアラートと記録だけでよいアラートを仕分ける継続的なチューニングが欠かせません。
バックアップと復旧手順の整備
バックアップ機能は、データとシステム構成を定期的に退避し、障害や誤操作、ランサムウェア被害からの復旧を可能にします。重要なのは、バックアップを取得していることよりも、そこから確実に戻せることです。取得していたはずのバックアップが壊れていた、復旧手順を誰も把握していなかった、という事態は珍しくありません。
確実に戻せる状態を保つには、取得の仕組みと復旧の手順を、次の点から具体的に決めておく必要があります。
- 取得頻度と保持期間:バックアップをどれだけの間隔で取り、どれだけ残すか
- 遡れる範囲:どの時点までデータを戻せるか
- 復旧にかかる時間:復旧作業にどれだけ時間がかかるか
- 別リージョン・別媒体への保管:災害やクラウド側の大規模障害も想定して検討する
- 定期的な復旧テスト:復旧手順を実際に試し、手順どおりに戻せるかを確かめる
この整備は、いわばシステムの最後の守りであり、保守構築で最初に固めるべき基盤機能です。
近年はランサムウェア被害が深刻化しており、攻撃者がバックアップごと暗号化すると、いくら取得していても復旧できません。そのため、書き換え不可の保管方式や、本番環境から隔離した保管先を備えることが、現代のバックアップ機能の要件になりつつあります。
バックアップは、取得しているかどうかではなく、どんな脅威からも確実に戻せるかという水準で評価すべき機能で、ここを軽視すると、いざというときに最後の備えが崩れます。
障害対応・インシデント管理とSLA管理機能
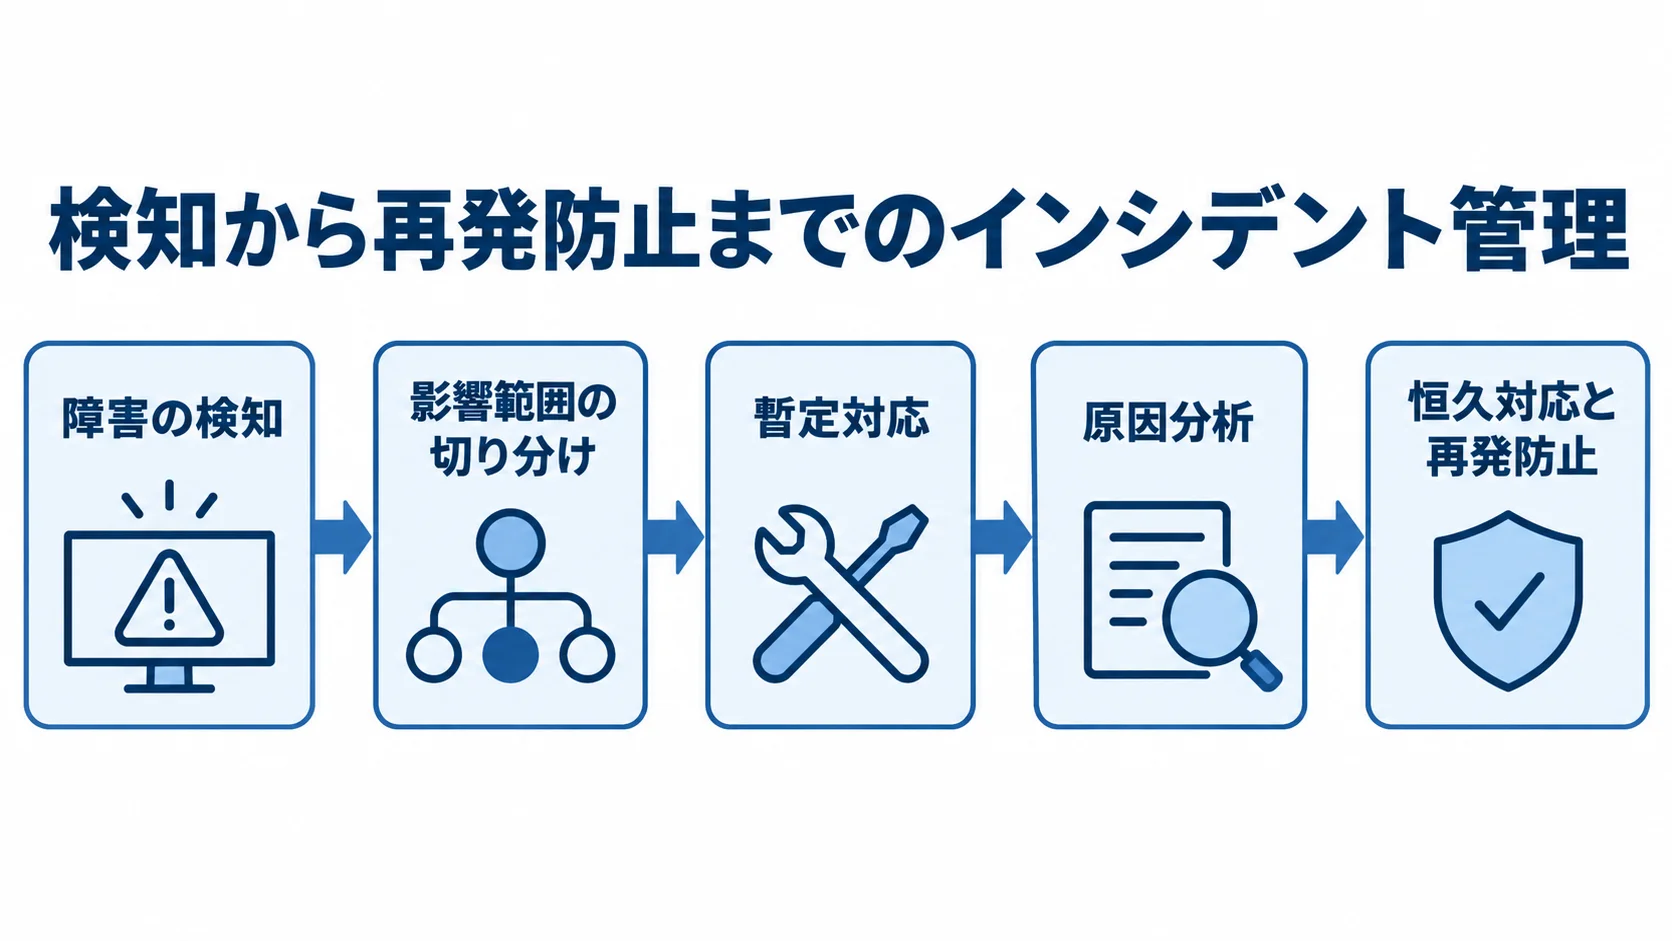
監視で異常を検知したあとに働くのが、障害対応とインシデント管理の機能です。保守費の内訳でも障害対応は25〜35%と最も大きな比率を占めるとされ(出典:ripla)、保守構築の中核機能と言えます。
また、その品質を測る仕組みがSLA管理です。これらがうまく噛み合うと、障害は「混乱」から「手順に沿った復旧プロセス」へと変わります。
検知から復旧・再発防止までのインシデント管理
インシデント管理の機能は、障害を検知して影響範囲を切り分け、暫定対応で復旧させてから、原因分析と恒久対応を経て再発防止までの一連の流れを管理します。特に大切なのは、サービスを復旧させる暫定対応と、根本原因を取り除く恒久対応を分けて考えることです。両者を分けずに根本対応へ慌てて走ると復旧が遅れ、暫定だけで終えると同じ障害を繰り返します。
保守構築では、障害の重大度に応じたエスカレーション経路、関係者への連絡網、対応記録の残し方をあらかじめ定義しておきます。一件ごとの対応を記録に残し、再発防止策まで追跡することで、インシデント管理は単なる火消しではなく、システムを継続的に堅牢化していく機能になります。逆に、記録を残さずその場限りの対応を繰り返すと、同じ調査をやり直すことになり、属人化も進みます。
発注側としては、「障害が起きたとき、どんな手順で誰が動くのか」を契約前に確認しておくことが大切です。蓄積された対応記録は貴重な資産で、過去の障害と原因、解決方法が残っていれば、似た事象の再発に迅速に対処でき、担当者が代わっても対応の質を保てます。インシデント管理は、目の前の障害を収めるだけでなく、組織の対応力を時間とともに高める仕組みとして捉えるべきです。
SLA管理で品質を数値で保証する機能
SLA管理は、保守の品質を数値で定義し、達成状況を継続的に測る機能です。代表的な指標には、稼働率99.9%(月間で約43分の停止許容)または99.5%があります。そのほか、初報応答は重大障害15分・通常障害2時間、エスカレーション30分、回答24時間といった基準が挙げられます。
また、復旧は重大4時間・通常8時間、恒久対応は5営業日という基準もあります(出典:ripla)。これらの数値があることで、保守の良し悪しを感覚ではなく事実で評価できます。そのため、SLA管理では毎月の達成状況をレポートにまとめ、未達があればその原因と改善策を共有します。
未達時のペナルティ(減額)を契約に組み込むケースもありますが、原因が曖昧だと適用されにくいため、計測の仕組みと記録が機能として欠かせません。SLA管理は、保守を「やってもらっている」状態から「品質を約束として握る」状態へ引き上げる、保守構築の要となる機能です。
定期メンテナンス・アップデート・改修対応機能
システムを健全に保ち、ビジネスの変化に追従させるのが、定期メンテナンス、アップデート・リリース管理、軽微改修・仕様変更対応の機能です。
これらは、「動いているから触らない」という塩漬けを防ぎ、システムを少しずつ進化させ続けるための機能群です。保守構築でこの継続的な手入れをどこまで含めるかによって、システムの寿命は大きく変わります。
定期メンテナンスとアップデート・リリース管理
定期メンテナンスは、保守費の内訳でも20〜30%を占める基本機能です(出典:ripla)。具体的には、放置すると徐々にシステムを蝕む作業として、ログの整理やデータベースの調整、不要データの削除、証明書の更新を計画的に行います。アップデート・リリース管理は、OS・ミドルウェア・ライブラリのセキュリティパッチや機能追加のリリースを、検証環境でのテストを経て安全に本番へ反映する機能です。
とくにアップデート対応は、セキュリティの観点で軽視できず、サポート切れのソフトウェアを放置すると、既知の脆弱性が攻撃の入り口になります。リリース管理では、いつ・何を・どの手順で反映し、問題が起きたらどう切り戻すかを定義して、業務への影響を最小限に抑えます。定期メンテナンスとアップデート・リリース管理は、システムを劣化させないための継続機能で、保守構築で必ず備えるべき領域です。
アップデートは、小さく頻繁に当てるほど安全で、先送りを続けると一度に大量のバージョンを飛び越えて適用することになり、検証の負荷も不具合のリスクも跳ね上がります。リリース管理が継続的に回っていれば、変更の幅が小さく保たれ、問題が起きても原因を特定しやすくなります。この継続性こそが、塩漬けを防ぎ、システムを長く健全に使い続けるための土台になります。
軽微改修・仕様変更対応で業務に追従する機能
軽微改修・仕様変更対応は、保守費の内訳で10〜15%程度を占め(出典:ripla)、業務やルールの変化にシステムを追従させる機能です。具体的には、帳票の項目追加や入力チェックの変更、画面の文言修正、税率や制度改正への対応といった小さな修正を続けることで、システムは現場の実態からずれずに使い続けられます。
この機能で大切なのは、軽微改修と本格的な機能開発の境界を契約上はっきりさせておくことです。境界が曖昧だと、「これは保守の範囲か、別費用か」で毎回もめる原因になります。
そこで、保守構築では、月あたりの改修工数の枠や、追加開発の単価をあらかじめ取り決めておくと、運用がスムーズになります。軽微改修・仕様変更対応は、システムを「作りっぱなし」にせず、ビジネスとともに育てていくための機能だと言えます。
AIOps・自動検知で進化する運用機能
近年の保守構築では、監視や障害対応の機能に、AIを活用したAIOps(AIによる運用)や自動検知の仕組みが加わりつつあります。人手だけで膨大なログやメトリクスを監視するのには限界があり、機械による異常検知が運用の質と効率を底上げします。
AIを使うことで新たに生じる、どこまでを誰が受け持つかという論点もあるため、理解しておくことが重要です。
異常検知と予兆把握を自動化する機能
AIOpsの中心機能は、平常時のパターンを学習し、そこからの逸脱を異常として自動検知することです。たとえば、固定の閾値では拾いきれない緩やかな性能劣化や普段と違うアクセス傾向を捉え、障害になる前に予兆を知らせます。
さらに、大量のアラートをまとめて重要なものだけを浮かび上がらせる相関分析も、運用チームの負荷を下げる機能です。こうしたAI連携やMLOpsの保守は専門性が高く、保守費も月50万〜200万円といった水準になることがあります(出典:ripla)。
投資に見合うかは、システムの規模や障害が事業へ与える影響の大きさで判断します。自動検知は、人の監視を置き換えるものではなく、人がより高度な分析や改善に集中できるよう支える機能として位置づけるのが現実的です。
クラウド・SaaS連携時代の責任分界という機能課題
現代のシステムは、クラウド基盤や外部SaaSと連携して動いています。こうした連携があるため、保守構築では、どこまでを自社ベンダーが受け持ち、どこからをクラウドやSaaS提供元が受け持つかを整理しておくことが欠かせません。
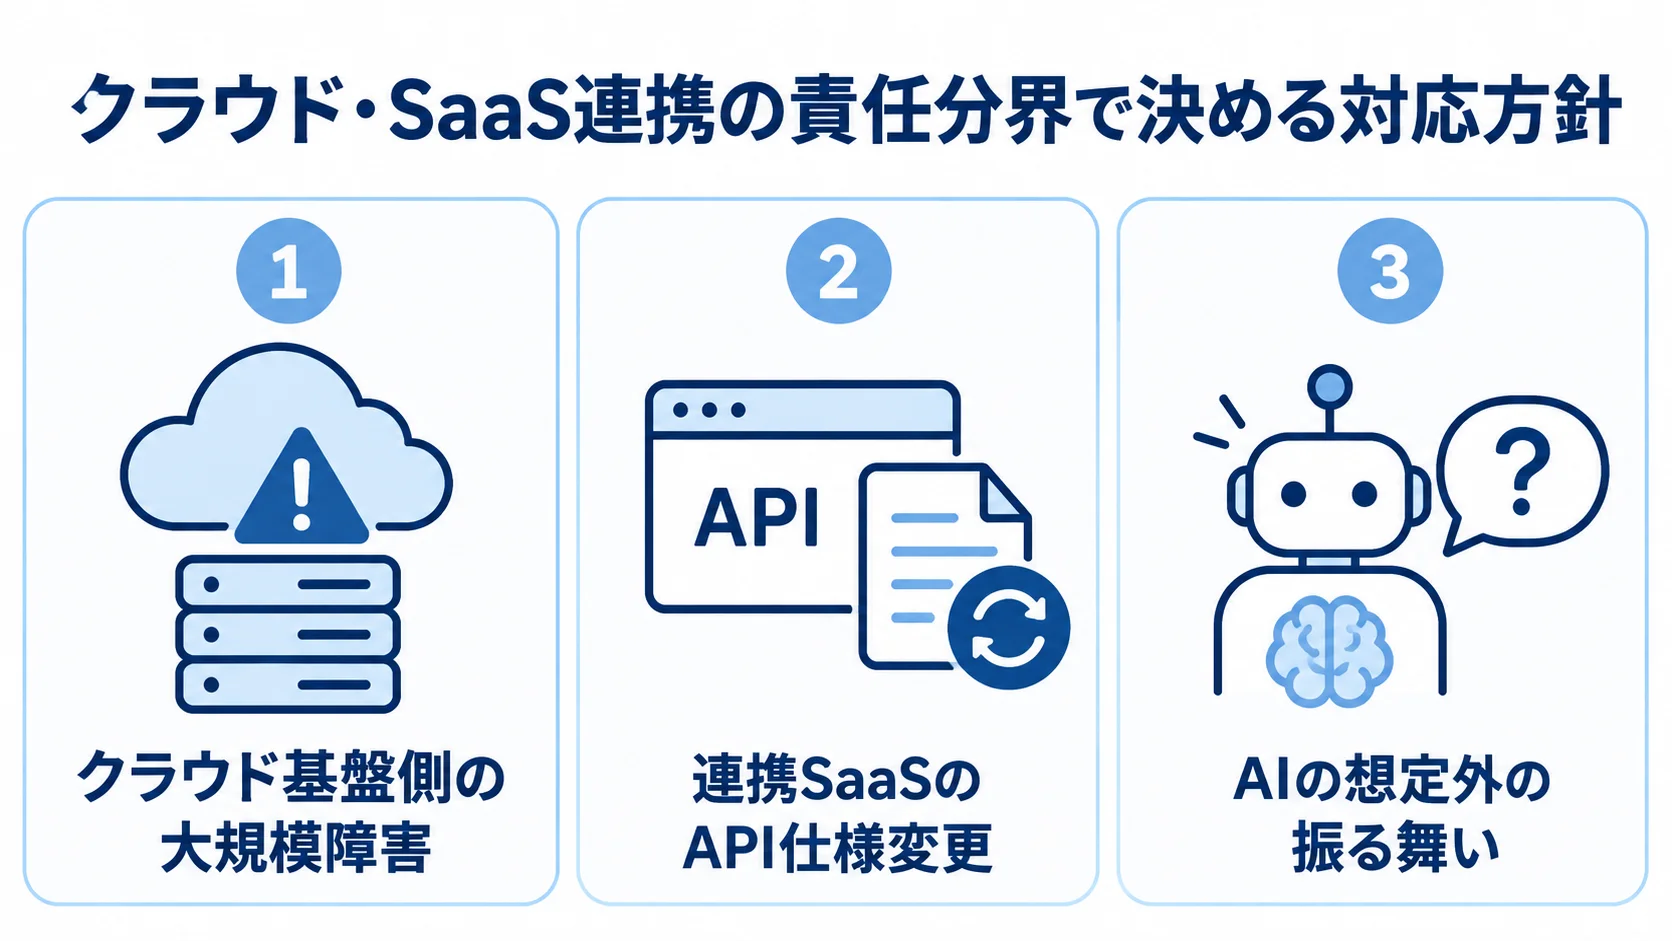
ベンダーのコントロール外で起きる問題についても、対応方針を決めておく必要があります。たとえば、次のような問題です。
- クラウド基盤側の大規模障害:自社の管理外で起きる障害への対応方針
- 連携SaaSのAPI仕様変更:連携先の変更が自社の機能に及ぶ場合の扱い
- AIの想定外の振る舞い:AIが予期しない動きをしたときの対応方針
この線引きを曖昧にしたまま運用すると、いざ障害が起きたときに「うちの担当ではない」という押し付け合いが生じ、復旧が遅れます。そのため、連携先ごとの責任範囲と、外部要因による障害時の対応手順や費用の扱いを文書化しておくことが、トラブルを未然に防ぎます。
riplaはフルスクラッチ受託と国内運用保守の立場から、クラウドやAI連携を含む現代的なシステムで、どこまでを誰が受け持つかを見据えた保守構築を重視しています。機能を選ぶときは、平常時の便利さだけでなく、外部要因の障害時にどう守られるかまで含めて評価することが大切です。
問い合わせ対応・管理報告という運用を支える機能
監視や障害対応のような目立つ機能の陰で、日々の運用を静かに支えているのが、問い合わせ対応と管理報告の機能です。保守費の内訳でも問い合わせ対応は10〜20%、管理・報告は5〜10%を占めるとされ(出典:ripla)、決して小さくない比率です。
これらは派手さこそありませんが、現場が安心して使い続けられることと、保守の品質を発注側が把握できる透明性を担保する、欠かせない機能群です。
問い合わせ窓口とヘルプデスクの機能
問い合わせ対応の機能は、現場の利用者が「操作が分からない」「思った動きと違う」といった疑問に直面したとき、その受け皿になります。具体的には、窓口を一本化し、問い合わせを記録・分類して、回答までの時間を管理することで、利用者は迷子にならずに済みます。
保守構築では、受付の手段(メール・チャット・電話)、対応する時間帯、回答までの目標時間を定義し、問い合わせ機能を実効性のあるものにします。重要なのは、問い合わせを単に捌くだけでなく、その内容を分析して改善につなげることです。たとえば、同じ問い合わせが繰り返し来るなら、それは画面の分かりにくさやマニュアル不足のサインであり、軽微改修やドキュメント整備で根本から減らせます。
問い合わせは、現場のつまずきを拾い上げ、システムと運用を磨き込むための情報源にもなります。そこで、発注側としては、問い合わせの傾向を定期的に共有してもらえるかを確認しておくとよいでしょう。
定例報告で保守を見える化する機能
管理報告の機能は、保守の活動を発注側に見える化する役割を担います。具体的には、毎月の稼働状況や障害とその対応、SLAの達成状況、定期メンテナンスや改修の内容を定例レポートにまとめ、発注側と共有します。
これがあることで、保守は「ブラックボックスに任せきり」ではなく、「内容を把握したうえで委ねる」状態になります。さらに、定例報告の場は、単なる実績の報告にとどまらず、システムの中長期的なリスクや改善提案を議論する機会にもなります。
たとえば、放置すれば将来の大きな問題になりかねない、サポート切れが近いソフトウェアや増え続けるデータ量、頻発する特定の障害などは、報告を通じて早めに共有できます。そのため、こうした報告は、保守を受け身の維持から、先を見据えた能動的な運用へ引き上げる役割を担います。報告が形骸化せず、意味のある対話の場になっているかは、保守構築の質を映すものだと言えます。
まとめ
ITシステム保守構築の機能を整理すると、監視・バックアップが基盤にあり、その上に障害対応・インシデント管理とSLA管理が重なる構造が見えてきます。定期メンテナンス・アップデート・軽微改修はシステムを劣化させず進化させ、AIOpsと、どこまでを誰が受け持つかの整理が、クラウド時代の運用を底上げします。
保守費の内訳を見ると、定期保守は20〜30%、監視は15〜25%、障害対応は25〜35%を占めます。問い合わせは10〜20%、軽微改修は10〜15%、管理・報告は5〜10%で、これらの機能に費用が配分されています。
機能を選ぶときに大切なのは、「全部入りで安心するか、最小限で安くするか」の二択ではなく、自社のシステムが止まったときのビジネスへの影響に応じて、各機能の水準を設計することです。
SLAの数値と、どこまでを誰が受け持つかは契約前に決め、外部要因の障害時にどう守られるかまで確かめてください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、必要な機能を過不足なく組み立てる保守構築を支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。