
ITシステムの保守監視で成果を出した企業は、ダウンタイムを金額で示し、監視範囲と保守費を事業実態に合わせて組み直していました。
費用相場や契約形態をまだ把握していない場合は、先にITシステム保守監視の完全ガイドを読むと、この先の事例の位置づけがつかみやすくなります。
▼全体ガイドの記事
・ITシステム保守監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ダウンタイムとMTTRを削減した監視改善事例
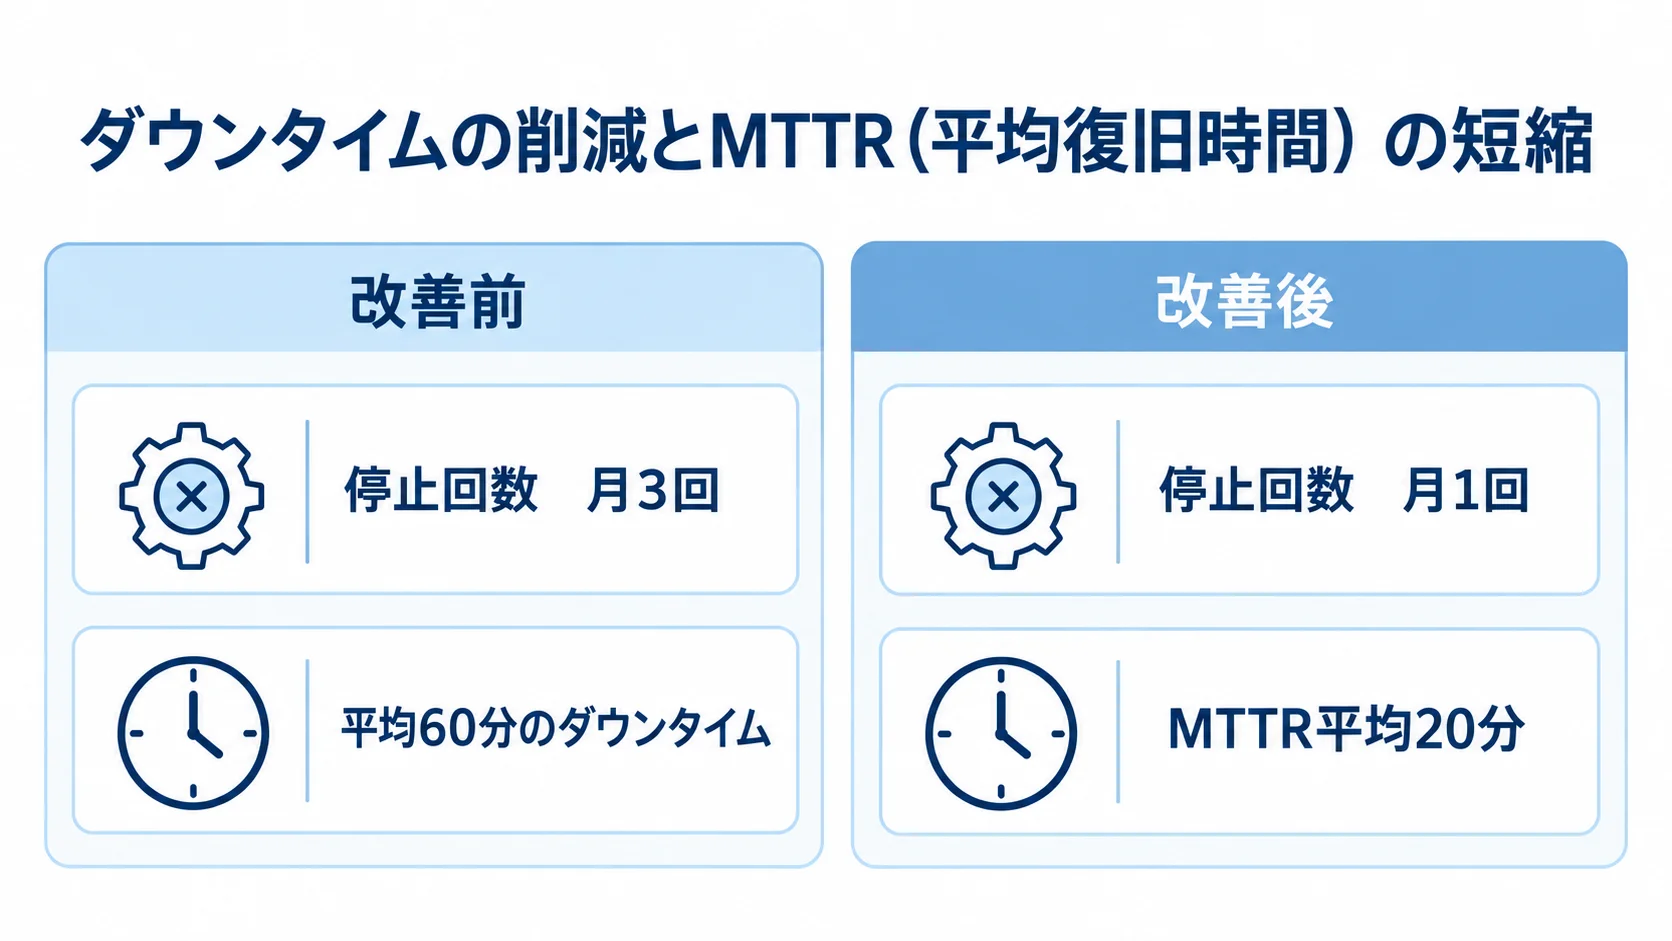
保守監視の改善で、もっとも分かりやすい成果が出るのは「ダウンタイムの削減」と「MTTR(平均復旧時間)の短縮」です。
監視が手薄な現場では、利用者からの「動かない」という連絡で初めて障害に気づき、原因の切り分けに時間を取られて復旧が後手に回ります。そこで、死活監視・性能監視・ログ監視で先回りできる体制に変えると、停止回数と1回あたりの停止時間の両方を減らせます。
停止1回1,200万円の損失を起点に効果を定量化した事例
監視改善の効果を稟議で説明するには、ダウンタイムを金額に換算するのが近道です。換算の参考になるのは、総務省の2025年版の統計です。金融・医療・EC系のシステムでは、5分以上の停止が1回発生すると、平均1,200万円の機会損失につながるとされています。
海外の指標でも、Gartnerの2024年の調査では、ダウンタイム1分あたり約5,600米ドルの損失という数字が示されています。停止の長さが、そのままコストに直結するということです。
たとえば、これまで月3回の障害が発生し、1回あたり平均60分のダウンタイムが出ていた現場を考えます。死活監視と性能監視のアラートを先回り型に組み替え、一次対応の手順書を整備した結果、停止回数が月1回、MTTRが平均20分に短縮できたとします。
事例を読むときは、この数字を自社の損失額に置き換えてみてください。そうすると、監視投資が「コスト」ではなく「損失回避の保険」であることを、数字で示せます。
稟議に載せる数字は、換算の前提と改善後の見込みに分けて示すと、根拠が伝わりやすくなります。
- 換算の方法:合意した単価に、月あたりの停止回数を掛けて見積もる
- 改善後の見込み:停止回数とMTTRの減少分を、損失額に置き換えた数字
換算の出発点には、年間の停止回数とMTTRの実績を置いています。1回1,200万円の損失を当てはめると、削減効果は月あたり数千万円規模に達します。
夜間障害の「火消し」を24/365体制で立て直した事例
もう一つ典型的なのが、夜間や休日の障害対応が属人化し、特定の担当者の携帯電話に連絡が集中していた現場の立て直しです。この状態は、担当者の心理的負担が大きいだけでなく、その人が不在のときに復旧が止まるという属人化リスクを抱えています。
改善事例では、24時間365日の死活監視とリソース監視を外部のMSP(マネージドサービスプロバイダ)に委託しました。一定の閾値を超えると自動でアラートが上がり、さらに一次対応まで肩代わりしてもらう体制に切り替えています。
費用感としては、24時間の緊急障害対応は月10万〜20万円、運用・監視(24/365の死活・リソース監視)は月5万〜20万円が一つの相場です。
立て直しに成功した現場は、「平時の待機費」を担当者の安心と事業継続のための保険として位置づけ、経営層に説明しています。
監視の自動化により、検知から一次対応開始までのリードタイムが大幅に短縮されました。その結果、重大障害でも2時間以内の対応開始が実現し、24時間以内の完全解決という目標値も安定して達成できるようになっています。
待機費は、固定費として見るか、夜間障害に備える保険として見るかで、判断が大きく変わります。
- 固定費の見方:24時間対応の月額と、夜間障害1回の損失額の比較
- 人への依存:特定の担当者が不在でも復旧が止まらない状態
一見すると固定費の増加ですが、属人化していた担当者の離職リスクを考えれば、十分に正当化できる水準です。
ひとり情シスが監視・一次対応を委託した事例
中小企業で多いのが、情シスが一人または兼任で、本来の企画業務に加えて障害対応や監視まで抱え込んでいるケースです。保守監視を24時間365日内製しようとすると、最低でも複数人のシフト体制が必要になり、監視オペレーターの人月単価60万〜80万円を何人分も抱えることになります。
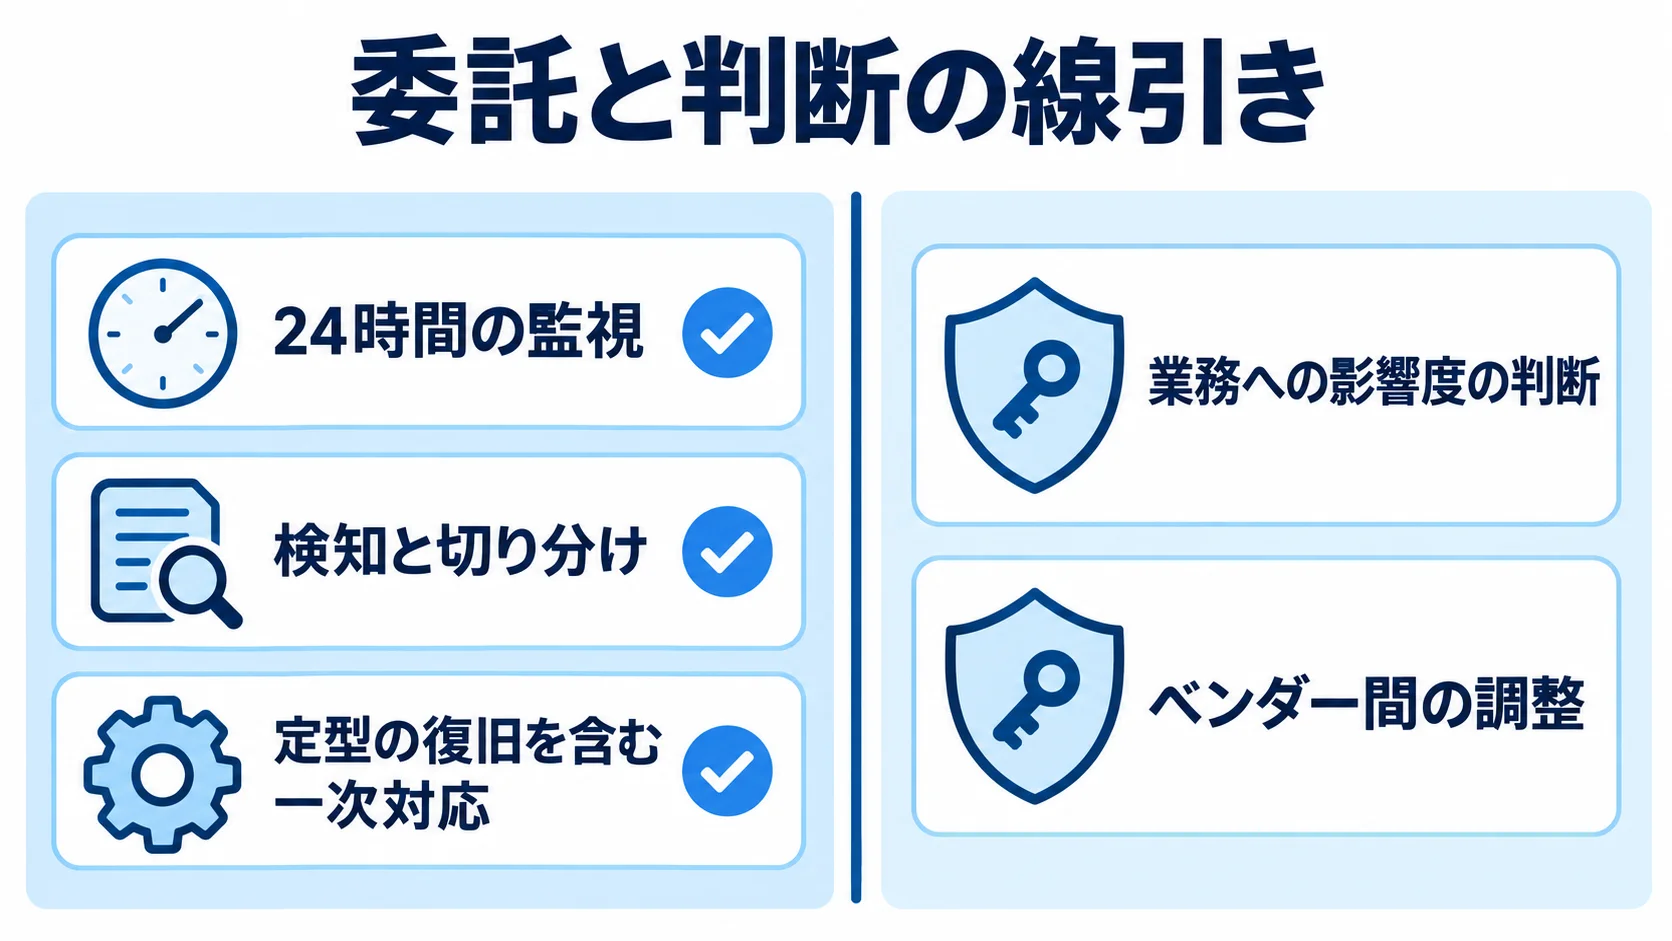
ひとり情シスの現場では、内製で人員を抱えるのは現実的ではありません。そのため、事例から学べるのは「何を委託し、何を手元に残すか」の線引きです。
監視・一次対応は委託し、判断は手元に残した事例
成功している事例では、委託する範囲と手元に残す範囲を分けています。
たとえば、サーバー監視を月3万円、月次メンテナンスを4時間で2万円といった形で、必要な範囲だけを切り出して契約します。この方法なら、内製でフルタイムの人員を抱えるより圧倒的に安く、夜間も穴を空けずに済みます。
マネージド型のサービスでは、監視のみが月5,000円/台、障害対応込みが月10,000円/台です。さらに、フルマネージドは月20,000円/台という料金体系が一例として示されており、規模に応じて段階的に範囲を広げられます。
大事なのは、委託しても情シスが「丸投げ」にならないことです。事例で定着しているのは、障害発生時に委託先が一次対応を進めつつ、業務への影響度や経営層への報告の要否は情シスが判断するという役割分担です。
委託先に任せきりにすると、いざ重大障害が起きたときに業務部門への状況説明ができず、社内で孤立してしまいます。だからこそ、「手を動かす作業は委託、判断と社内調整は自社」という線引きが、ひとり情シスが保守監視を続けていくための鍵になります。
委託と判断の線引きは、作業と判断のそれぞれで見ると整理しやすくなります。
- 任せる作業:24時間の監視と、定型の復旧を含む一次対応
- 自社に残す判断:業務への影響度の判断、ベンダー間の調整、経営層への報告の要否
委託する一次対応には、検知と切り分けも含まれます。
必要十分なSLAで初期費用を抑えてスタートした事例
ひとり情シスの事例でもう一つ参考になるのが、最初から最高水準のSLAを求めず、自社の事業実態に合った水準でスモールスタートした点です。
この事例の企業は、まず営業時間内の障害対応(月3万〜8万円が相場)と平日日中の監視から始めました。そのうえで、運用が回り始めてから夜間・休日の範囲を追加する段階的な拡張を選んでいます。
最初から24時間の最高水準を契約して持て余すより、自社にとって本当に必要な範囲を見極めてから広げるほうが、限られた予算を有効に使えます。スモールスタートで運用ノウハウと社内の納得感を蓄積してから本格的な体制に進むのは、後述する過剰SLAの失敗と対照的な、堅実な進め方です。
SLAは、目標を上げるほど費用が重くなるため、事業への影響に合わせて決めることになります。
- 稼働率の目標:99.9%と99.99%で変わる、許容できる停止時間の差
- 対応時間の広げ方:営業時間内から始め、夜間・休日は後から追加する段階的な進め方
稼働率を99.99%にすると、許容できるダウンタイムは年52.6分・月4.38分まで縮まります。その分だけ冗長構成や即応体制が必要になり、運用コストも段階的に跳ね上がります。
事業への影響が限定的な社内システムであれば、稼働率99.9%(年8.76時間・月43.8分の停止を許容)でも十分なケースが多くあります。そのため、無理に高いSLAを選んでコストを膨らませる必要はありません。
過剰SLAを適正化して保守費を削減した事例
保守費が高止まりしている現場を調べると、実は業務実態に対してSLA(サービスレベル合意)が過剰になっているケースが少なくありません。「念のため」「契約当初の名残で」といった理由で、ほとんど停止が許されない高い稼働率や24時間の即応体制を維持し続け、その待機費だけがかさんでいる状態です。
事例から学べるのは、SLAを下げる調整が業務部門との合意形成の問題だという点です。
事業影響度アセスメントでSLAを段階的に下げた事例
適正化に成功した事例では、まずシステムごとに、停止したときの事業への影響度を洗い出すアセスメントを実施しています。
受発注や決済に直結する基幹システムは、高いSLAを維持しています。一方で、社内向けの情報共有ツールや夜間に使われないシステムは、稼働率を99.99%から99.9%へ、あるいは24時間監視から営業時間内監視へと段階的に引き下げました。稼働率の「9」が一つ増えるごとに運用コストが跳ね上がるため、不要な「9」を外すことが保守費の圧縮につながりました。
このとき決め手になるのが、業務部門への説明です。情シスが一方的にSLAを下げると、「サービス低下だ」と反発を招きますが、影響度の根拠を示せば、合意を取りつけられます。たとえば「このシステムは夜間に止まっても翌朝の復旧で業務に支障がない。その分の待機費を年間で他の投資に回せる」といった根拠です。
事例の企業は、影響度アセスメントの結果を一覧にして経営会議で共有し、SLAの引き下げを正式な意思決定として位置づけました。この社内調整の手順こそ、外部の記事では語られにくい実務の肝です。
業務部門との話し合いは、システムごとの影響度を材料にして進めます。
- 影響度の洗い出し:停止時の事業影響を、システムごとに並べた一覧
- 社内の合意:経営会議での共有と、SLA引き下げの正式な位置づけ
監視ツールの統合でアラート過多を解消した事例
SLAの適正化と並んで効果が大きいのが、監視ツールの整理です。複数のシステムを別々のツールで監視していると、似たようなアラートが大量に飛び、本当に重要な障害の予兆が埋もれてしまう「アラート過多」が起きます。
事例では、OSSのZabbixやクラウド型のDatadog・Mackerelなどに監視を集約しました。そのうえで、閾値とアラートの優先度を設計し直し、対応すべきアラートを大幅に絞り込んでいます。Zabbixはライセンス無料で導入できる一方、構築と維持に工数がかかるため、規模に応じてSaaS型と使い分けるのが現実的です。
アラートを絞り込んだ結果、オペレーターが対応に追われる無駄な工数が減り、その分の人月を本来注力すべき改善業務に回せるようになりました。これは単なる効率化にとどまらず、保守費の中身を「火消し」から「予防と改善」へとシフトさせる第一歩になります。
監視は、アラートの設計を定期的に見直し続けて、はじめてコストに見合う価値を生みます。事例が示すのは、監視の量より設計の質が、保守費の使い方を左右するという点です。
アラートの整理は、ツールを減らす作業と、アラートの中身を見直す作業に分けて考えると進めやすくなります。
- ツールの集約:複数の監視を一つの基盤にまとめることで生まれる、重複アラートの減少
- アラートの設計:閾値と優先度の見直し、対応すべき通知の絞り込み
充填型保守で待機費を投資に変えた事例
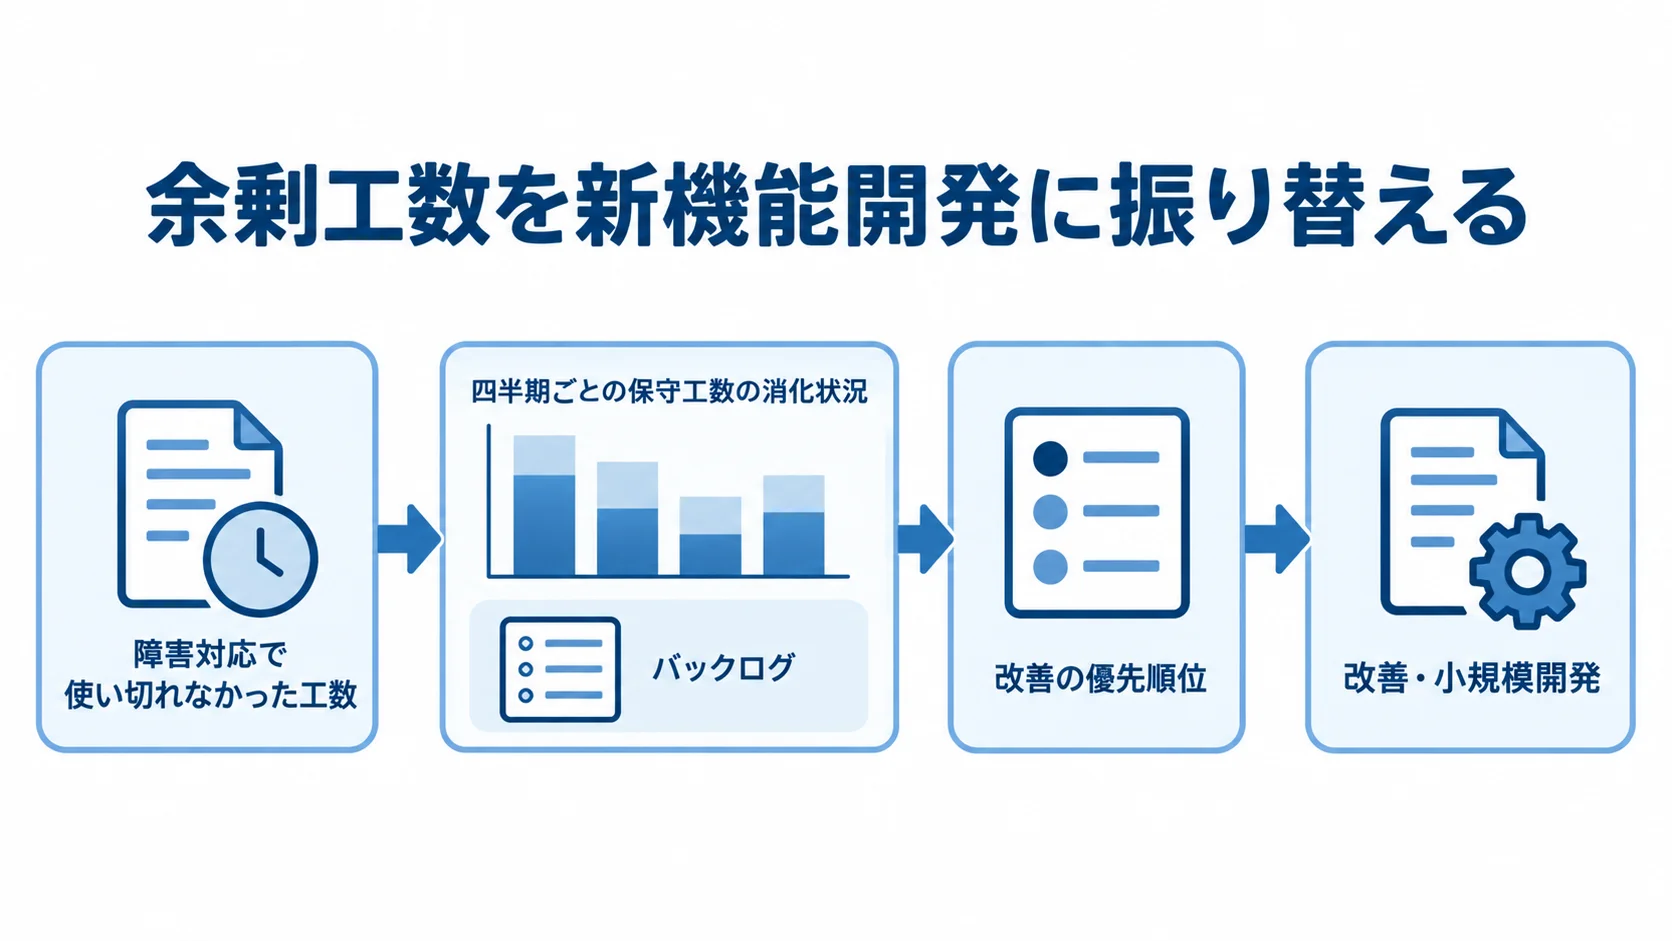
保守監視の契約でよくある不満が、「障害ゼロの月でも固定の待機費を払い続けるのは無駄ではないか」というものです。これに対する一つの答えが、待機費の中で使われなかった余剰工数を、新機能の開発や改善作業に振り替える「充填型保守」という契約モデルです。
事例の企業は、この仕組みで保守費を単なるコストから「継続的な改善投資」へと再定義しました。
余剰工数を新機能開発に振り替える契約に移行した事例
充填型保守では、月々の保守工数のうち障害対応で使い切らなかった分を、改善・小規模開発に充てると契約で定めます。年間保守費の相場は初期開発費の15〜20%とされ、開発費3,000万円のシステムなら年450万〜600万円、月額換算で37万〜50万円が一つの目安になります。
この一定額は、障害が少ない月は機能改善に、障害が多い月は対応に充てる柔軟な運用に切り替えます。そうすると、待機費の「払い損」感がなくなります。
この移行を実現するには、ベンダーとの契約交渉で、工数の扱いと改善の進め方を明文化することが欠かせません。事例の企業は、四半期ごとに保守工数の消化状況とバックログ(やりたい改善のリスト)をベンダーと共有しています。さらに、余った工数で何を優先して開発するかを一緒に決める運用を確立しました。
riplaはフルスクラッチ受託と国内運用保守の立場から、こうした「作った後も継続して伴走し、保守を改善投資に変える」進め方を一貫して重視しています。
契約で決めておく事項は、工数の扱いと改善の進め方に分けて考えると分かりやすくなります。
- 工数の繰り越し:障害対応で使い切れなかった工数の持ち越し方
- 改善の優先順位:バックログをもとに、余った工数の使い道を決める取り決め
AIOpsをスモールスタートで部分導入した事例
充填型保守で生まれた工数を使い、監視の自動化(AIOps)を小さく始めた事例も参考になります。JUASの調査では、AI活用について約78%の企業が検討中か未検討という段階です。そのため、いきなり大規模なAIOps基盤を導入できる中小企業は多くありません。
事例の企業は、まずアラートの自動分類や、過去のログから障害の予兆を検知する仕組みを一部のシステムに限定して導入しました。そのうえで、効果を検証してから対象を広げるロードマップを描いています。
このスモールスタートでは、レガシーな監視体制を維持しながら、効果の見込める領域から段階的にAIを差し込みます。全面的な置き換えを目指すと投資もリスクも大きくなりますが、「夜間のアラート対応だけAIに一次判定させる」といった部分導入なら、低コストで効果を確かめられます。
事例が教えるのは、最新技術であっても「自社の現状から逆算し、効果の大きい一部から始める」段階主義が有効だという点です。充填型保守で生まれた余剰工数は、こうしたAIOpsのような新しい投資の原資にもなります。
AIOpsの導入は、範囲と段階を分けて考えます。
- 導入の範囲:アラートの自動分類と予兆検知、対象は一部のシステムだけ
- 判断の材料:効果の検証結果と、対象を広げるかどうかの見極め
まとめ
ITシステム保守監視の事例を振り返ると、成功した企業に共通するのは、ダウンタイムを金額で定量化し、自社の事業実態に合った範囲とSLAで体制を組んだことです。さらに、保守費を火消しから予防・改善投資へとシフトさせていました。
停止1回1,200万円・1分5,600米ドルという損失統計を起点に効果を定量化し、ひとり情シスは監視と一次対応を委託しつつ、判断は手元に残しています。過剰SLAは事業影響度アセスメントで適正化し、充填型保守で待機費を新機能開発やAIOpsのスモールスタートに振り替えています。
これらが、保守監視を「コスト」から「事業継続の保険+投資」へと変える道筋です。
事例を読むときに大切なのは、「いくら払っているか」ではなく「その費用が事業継続と改善にどうつながっているか」という視点です。
自社のシステムの停止損失と影響度に照らし、まずは効果の大きい監視の改善とSLAの見直しから、一歩を踏み出してください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、作った後も継続して伴走し、保守監視を投資に変える体制づくりを支援します。
費用相場や契約形態の全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。