
ITシステムの保守監視は、死活や性能を見る監視系、異常に対応する対応系、障害を減らす保全系で成り立っています。全体像をつかまずに契約すると、「監視はしているのに対応してもらえない」といった想定外が起きがちです。本記事は、その標準機能と必要機能を発注企業の視点から一覧で整理した、機能特化の解説です。
費用相場や契約形態も知りたい方は、まずITシステム保守監視の完全ガイドを読むとよいでしょう。
▼全体ガイドの記事
・ITシステム保守監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
監視系の標準機能(死活・性能・ログ・サーバー)
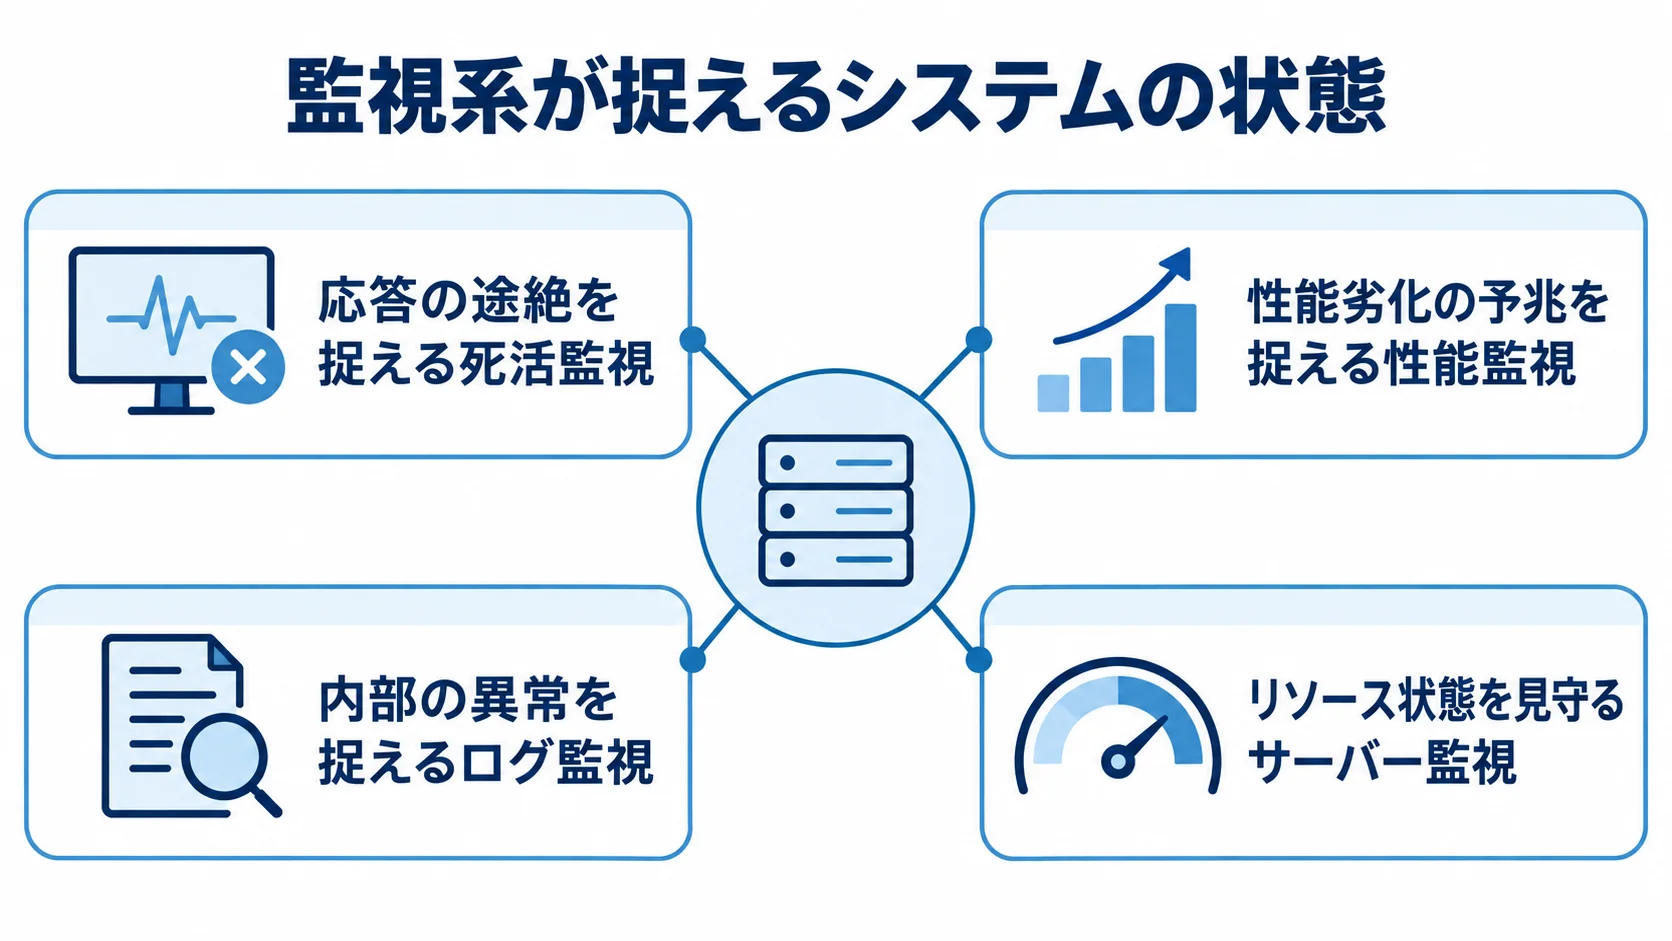
保守監視の中核になるのは、システムの状態を常時観測する「監視系」の機能群です。これらは「何を・どの粒度で見るか」によって役割が分かれており、組み合わせて初めて障害の予兆を早期に捉えられます。
多くのサービスでは、こうした監視を24時間365日の体制で提供しています。設定した閾値を超えると、自動的にアラートを発する仕組みになっています。
死活監視と性能監視が担う役割
監視系の機能は、停止の検知と性能劣化の予兆把握を分けて見ると、必要な範囲を整理しやすくなります。
- 死活監視:サーバーやサービスの応答を一定間隔で確かめる機能です。ping、ポート応答、HTTPの正常レスポンスを調べ、応答が途絶えたらアラートを上げます。
- 性能監視:リソース(CPU使用率・メモリ・ディスクI/O)と応答性(レスポンスタイム・スループット)を測り、閾値超過や停止前の予兆を捉えます。
ログ監視とサーバー監視がカバーする範囲
ログ監視は、システム内部で起きた異常を拾う機能です。サーバー監視は、死活・性能・ログの各監視を「サーバーという対象」にまとめて適用し、サーバーの状態を一括して見守ります。2つの違いは、見る対象がシステム内部のログか、サーバーという単位かにあります。
- ログ監視:アプリケーションログ、システムログ、アクセスログを集め、エラーや異常を示すメッセージを検知します。
- サーバー監視:物理・仮想サーバーやクラウドインスタンスのリソース状態、プロセスの稼働、ディスク容量などを一括で見守ります。
ログ監視は、特定のエラーパターンや異常なアクセスを検出したらアラートを上げます。死活・性能監視が「外形的な状態」を見るのに対し、ログ監視は「内部で何が起きているか」を捉えるため、障害の根本原因に近い情報を早く得られます。さらに、セキュリティ面では、不正アクセスの兆候をログから拾う役割も担います。
料金の一例として、サーバー監視は月5,000円/台、月次メンテナンスを含めても数万円規模から提供され、規模に応じて契約できます。OSSのZabbixはライセンス無料で広く使われる一方、構築と維持に工数がかかるため、DatadogやNew Relic、サーバー監視に強いMackerelなどのSaaSと使い分けるのが一般的です。
SaaS型はホスト数やメトリクス量に応じた従量課金で、中規模なら月数万〜数十万円が目安です。
対応系の機能(アラート対応・一次対応・原因調査・復旧)
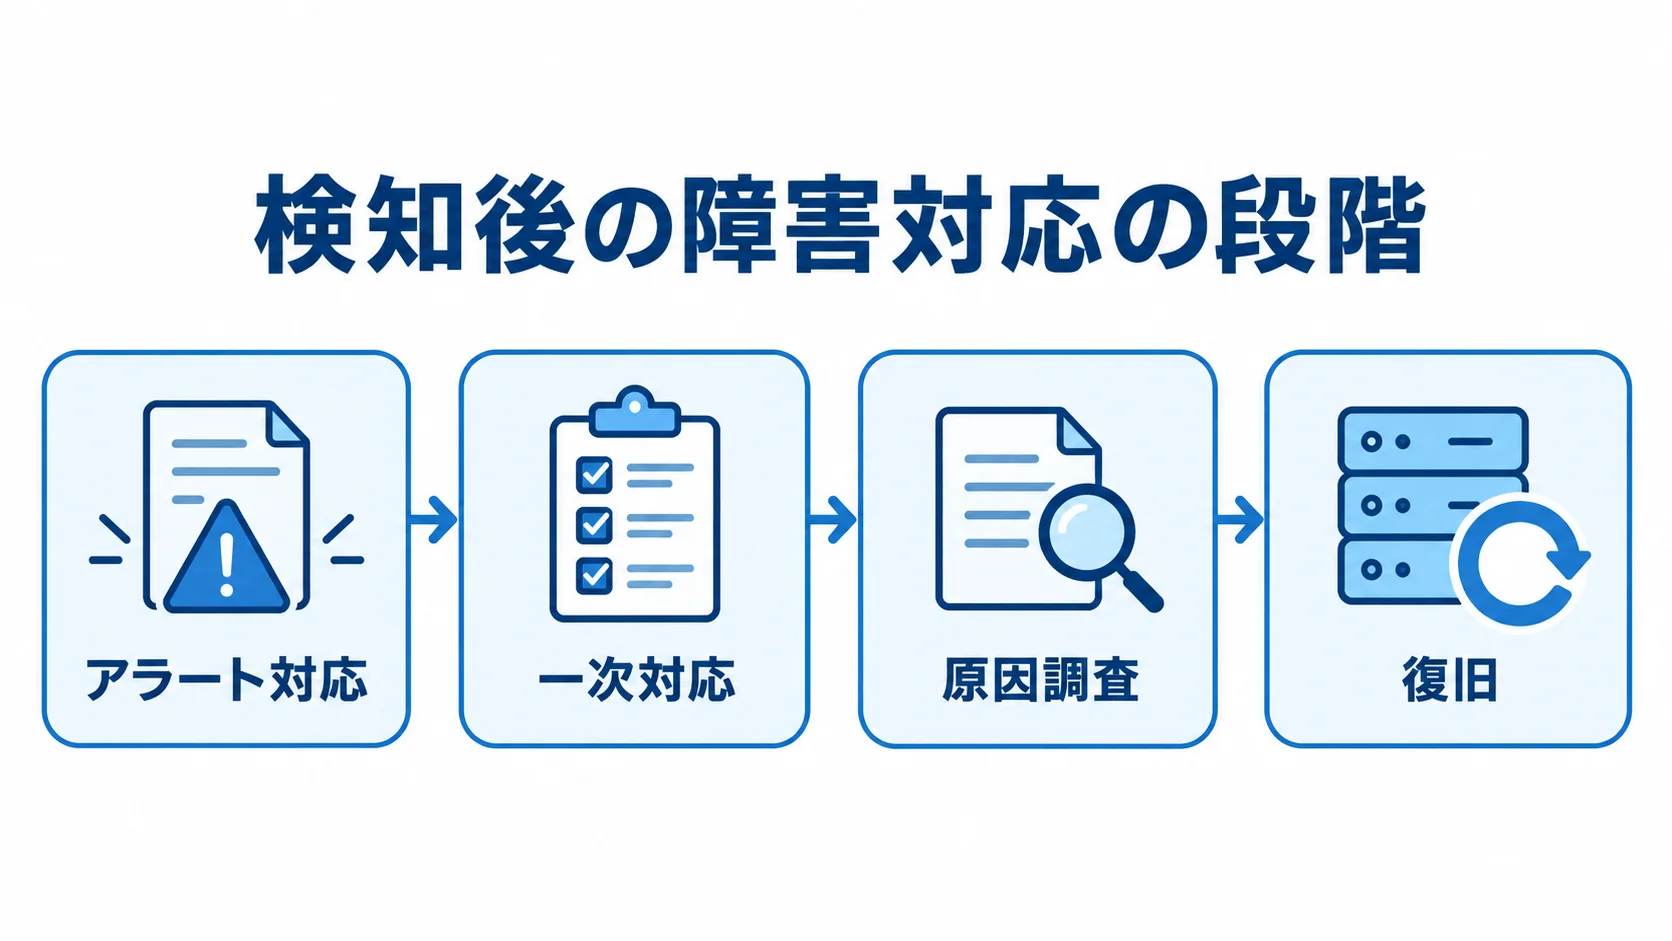
監視で異常を検知しても、それに対応する機能がなければ、警告が鳴り続けるだけです。そこで、検知した異常を収束させる「対応系」の機能群が、保守監視のもう一つの要素になります。
対応系は監視系と違って、人が判断し手を動かす場面が多く、「どこまでを委託先が受け持つか」の線引きが費用と直結します。そのため、基本料金に含まれる範囲を契約時に明確にしておくと、後のトラブルを防げます。
アラート対応と一次対応の機能
アラート対応は、監視の警告を受け取り、重要度を判定して必要な相手にエスカレーションする機能です。すべてのアラートが緊急対応を要するわけではないため、まず「様子見か、即対応か」を切り分けることが欠かせません。ここが甘いと、深夜に些細なアラートで起こされたり、重大な予兆を見逃したりするため、閾値とエスカレーションルールの設計が質を左右します。
一次対応は、検知した障害に対して最初に手を打つ機能です。再起動やプロセスの復旧、定型的な切り戻しなど、あらかじめ手順書(ランブック)で定められた範囲の対処を行います。サービスによっては、重大なインシデントに対して15分以内の一次対応を保証する例や、検知から60分以内に通知し12時間以内の復旧を目指す例があります。
さらに、官公庁向けの仕様では、1時間以内に現地到着・対処を開始し、原則4時間以内に完全復旧する、といった水準が示されることもあります。特に夜間や休日は、一次対応がどこまでカバーされるかで、安心感が大きく変わります。
原因調査と復旧、再発防止の機能
原因調査は、障害の根本原因を特定する機能で、ログやメトリクス、構成情報から「なぜ止まったのか」「どこが引き金だったのか」を突き止めます。一次対応で応急処置をしても、原因が分からなければ同じ障害が再発します。原因の特定は専門性を要するため、人月単価では運用設計やインシデント分析が80万〜120万円、SLM(サービスレベル管理)を統括する運用管理者では120万円以上と、より高度な人材の領域です。
復旧は、原因を踏まえてシステムを正常な状態に戻す機能で、データの修復や設定の戻し、修正版の適用を行い、完全復旧まで導きます。さらに、復旧後の再発防止策の立案や、恒久対応のためのパッチ適用・バグ修正まで含むかどうかは、契約によって分かれます。基本料金には監視と一次対応までを含み、原因調査の深掘りや恒久対応は別途見積もりとする構成も多くあります。
そのため、「どこまでが基本料金で、どこからが追加費用か」を契約時に必ず確認してください。また、スポットの障害対応は1件3万〜10万円が相場で、頻発する場合は月額契約に切り替えた方が割安になることもあります。
保全・自動化を支える機能(パッチ・バックアップ・AIOps)
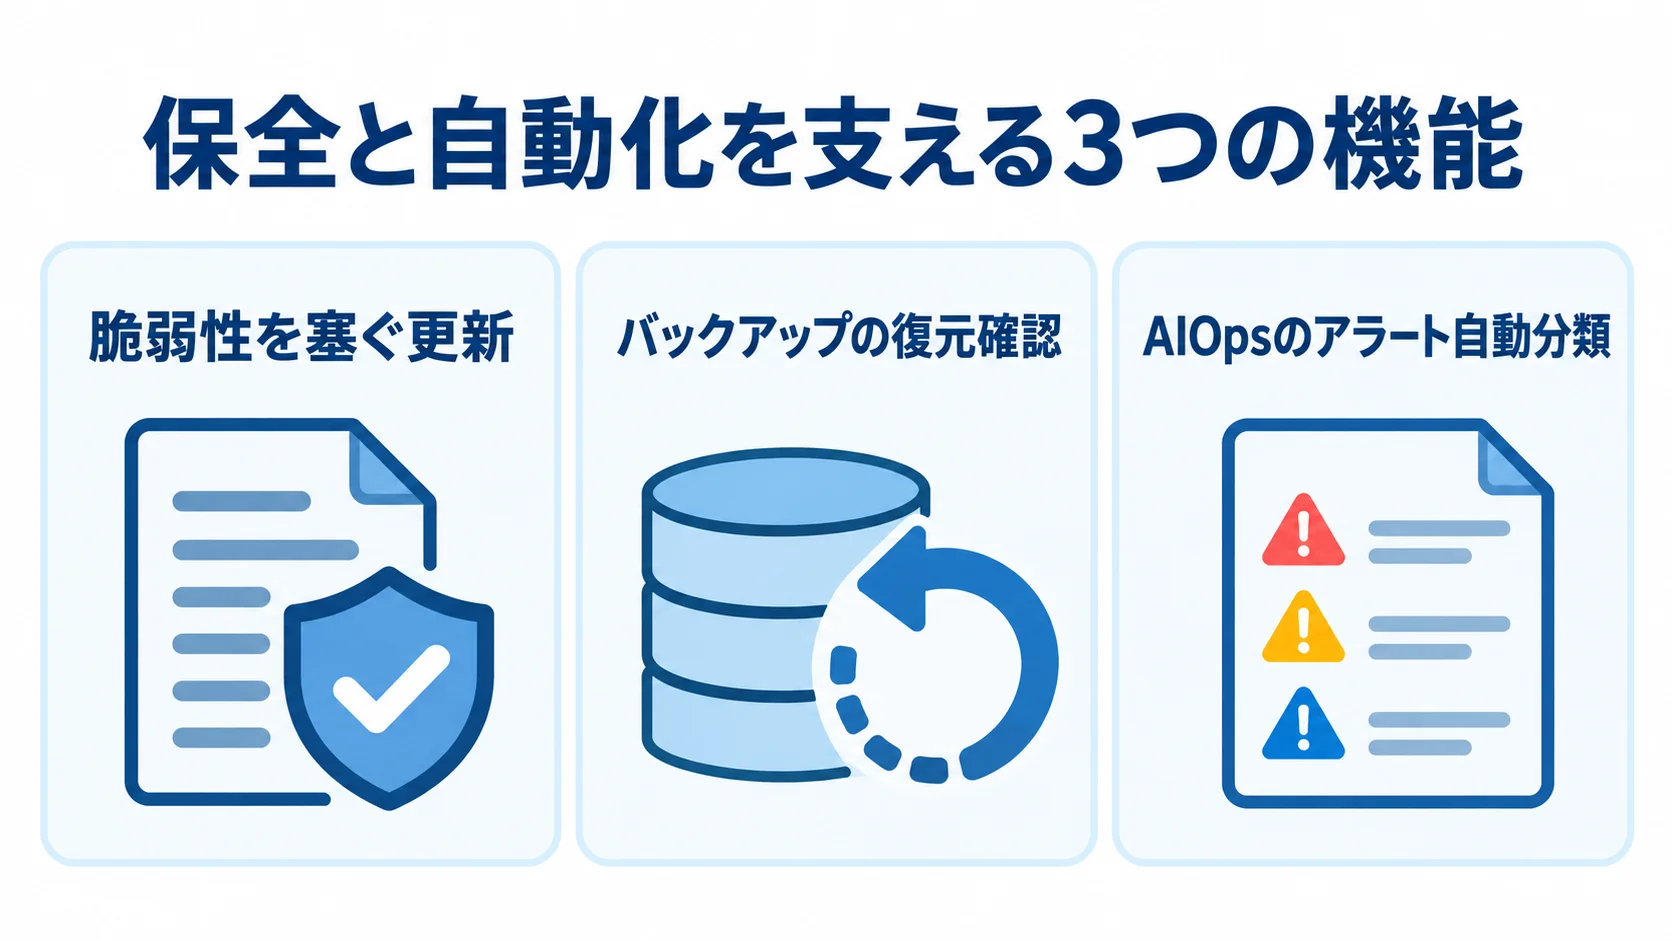
監視と対応に加えて、システムを健全に保ち続けるための「保全系」の機能も、保守監視を構成する欠かせない要素です。
保全系の機能は、障害が起きる前に手を打ち、障害を起こりにくくする予防的な役割を担います。その充実度は、長期的な運用コストと安定性を左右します。さらに、近年はその一部を自動化するAIOpsの活用も広がっています。
パッチ適用とバックアップの機能
パッチ適用は、OSやミドルウェア、アプリケーションの脆弱性を塞ぐための更新を計画的に当てる機能です。脆弱性を放置すると、不正アクセスやマルウェア感染のリスクが高まります。IBMの2024年の調査では、データ漏洩を検知するまでに平均204日を要し、平均被害額は445万米ドルに達するとされており、予防的なパッチ適用の重要性がうかがえます。
ただし、パッチは無計画に当てると別の不具合を誘発するため、検証環境での確認と適用スケジュールの設計がセットで求められます。バックアップは、障害やデータ消失に備えて、システムやデータの複製を定期的に取得する機能です。さらに、取得したバックアップから実際に復元できるかを検証する「リストアテスト」までを含むかどうかが、いざというときの明暗を分けます。
実際、バックアップを取っているつもりが、復元に失敗して結局データを失う事故は珍しくありません。そのため、保守監視の機能としてバックアップの取得に加え、定期的な復元確認まで契約に含まれるかを確かめておくことが欠かせません。これらの保全機能は、障害対応のコストを長期的に抑える投資にあたります。
AIOpsによる自動検知・自動対応の機能
AIOps(AIを活用した運用)は、監視で集めた大量のデータをAIで分析し、障害の予兆検知やアラートの自動分類、相関分析を行う機能です。複数のアラートの中から重要なものを自動で絞り込んだり、過去のパターンから「この兆候はこの障害につながる」と予測したりして、人手による監視の負荷を軽減します。
特に、アラート過多に悩む現場ほど、この自動分類の機能は効果を発揮します。ただし、JUASの調査ではAI活用について約78%の企業がまだ検討中・未検討の段階にあり、AIOpsは全社一括導入よりも、効果の見込める一部の領域から始めるのが現実的です。
たとえば、夜間のアラートの一次判定だけをAIに任せる、ログの異常検知にAIを使う、といった部分導入から効果を確かめ、徐々に範囲を広げていくアプローチが向いています。また、AIOpsは、人の判断を置き換える仕組みというより、人が本当に判断すべき事案に集中できるよう支える機能として捉えると、導入の効果を見極めやすくなります。
基本料金に含まれる機能と追加費用の線引き
ここまで挙げた機能は、契約によって基本料金に含まれるものと、そうでないものに分かれます。保守監視の契約で、もっともトラブルになりやすいのは、「監視はしてくれると思っていたが、障害対応は別料金だった」というように、基本料金の範囲と追加費用の境界が曖昧なケースです。そのため、機能の一覧を理解したうえで、「どこまでが定額で、どこからが従量・スポットか」を契約時に確定させることが欠かせません。
定額に含まれる機能とスポット課金の機能
一般に、定額の基本料金に含まれやすいのは、死活・性能・ログ・サーバー監視といった監視系と、アラート対応・定型的な一次対応までです。一方、原因調査の深掘りや恒久対応のためのバグ修正・パッチ開発、大規模な復旧作業などは、工数に応じた追加費用やスポット契約になることが多くなります。
料金の段階の一例として、監視のみが月5,000円/台、障害対応込みが月10,000円/台、フルマネージドが月20,000円/台と示されており、求める機能の範囲が広がるほど月額も上がる仕組みです。また、障害対応の費用も、営業時間内の対応なら月3万〜8万円、24時間の緊急対応なら月10万〜20万円、スポットでの1件対応なら3万〜10万円と幅があります。
費用に幅があるため、「夜間に止まると致命的か」「障害は頻発するのか」を見極め、定額の範囲を設計することが過不足のない契約につながります。頻繁に障害が起きるシステムなら、スポット課金を積み上げるより、対応を含む月額固定型の方が割安です。逆に安定したシステムなら、監視は定額・対応はスポットという組み合わせが合理的です。
自社に必要な機能を取捨選択する考え方
機能を一覧で把握できたら、次は自社にとっての優先順位を決める段階です。すべての機能を最高水準で揃えれば安心ですが、その分だけ費用は膨らみます。判断の基準になるのは、やはり「そのシステムが止まったときの事業影響度」です。
停止が直接売上や信用に響く基幹システムなら、監視から原因調査・復旧・再発防止までフルに揃える価値があります。一方、影響の小さい社内システムなら、死活監視とアラート対応の最低限から始めるのが合理的です。機能のカタログから「全部入り」を選ぶより、自社の事業に必要な機能を見極めて過不足なく組み合わせることが大切です。
riplaはフルスクラッチ受託と国内運用保守の立場から、システムを作った後も継続して伴走し、機能の取捨選択を一緒に設計することを重視しています。ここまで整理した監視系・対応系・保全系の機能の役割を手がかりに、自社の優先順位に照らして契約範囲を組み立ててください。
まとめ
ITシステム保守監視の機能は、監視系(死活・性能・ログ・サーバー)、対応系(アラート対応・一次対応・原因調査・復旧)、保全系(パッチ・バックアップ・AIOps)という三つの機能群で成り立っています。
監視系は障害を早期に捉え、対応系は被害を最小化し、保全系は障害そのものを減らす役割を担います。これらが組み合わさって初めて保守監視は機能します。
料金は監視のみ月5,000円/台からフルマネージド月20,000円/台まで段階があり、求める機能の範囲で月額が変わります。機能を選ぶときに大切なのは、カタログの網羅性ではなく、自社システムの事業影響度に応じた取捨選択です。
基本料金に含まれる範囲と追加費用の線引きを契約時に明確にし、過不足のない構成を組むことが、想定外の費用やカバー漏れを防ぎます。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、作った後も継続して伴走し、自社に必要な機能を一緒に設計する体制づくりを支援します。費用相場や契約形態を含む全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。