
ITシステムの保守監視を外部に委託するとき、見積もりの妥当性や対応範囲のズレで悩むことの多くは、RFP(提案依頼書)や要件定義書の作り込みが甘いことに起因します。本記事は、ITシステム保守監視のRFP・要件定義書・提案依頼書を、発注企業の視点で作り込むための「要件定義特化」の解説です。
RFPや要件定義書では、監視項目と閾値、SLAの数値、対応範囲を書き切ることが要になります。数値で定めた要件があれば、提案を比べやすく、安すぎる見積もりも見抜けます。全体像はITシステム保守監視の完全ガイドで先に確認してください。
▼全体ガイドの記事
・ITシステム保守監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
監視項目と閾値の数値要件
RFPの土台になるのは、何を、どの閾値で監視するかという監視項目の数値要件です。「サーバーを監視すること」といった曖昧な表現にとどめると、ベンダーごとに監視の粒度がばらつき、提案を比べられなくなります。また、監視項目を指標と閾値で具体的に定義しておくことが、後の対応範囲を明確にすることにもつながります。
監視項目リストと閾値の書き方
監視項目は、サーバーやデータベースなど対象ごとに、監視する指標と閾値、監視間隔を一覧にして定めます。たとえば「CPU使用率:警告80%・危険90%、5分間隔」「ディスク使用率:警告85%・危険95%」「HTTP応答:3秒以内、1分間隔」「プロセス死活:30秒間隔」といった形です。各監視も同じ粒度で書いておくと、ベンダーは何を実装すればよいかを正確に把握でき、そのぶん見積もりの精度が上がります。
閾値を定めるときは、アラートが上がったら誰が、いつまでに、どう動くかをセットで考えておきます。閾値を低く設定しすぎると、些細な変動でもアラートが頻発する「アラート過多」を招き、本当に重要な予兆が埋もれてしまいます。逆に高すぎると、障害が表面化してからでないと気づけません。
RFPの段階で、「警告レベルは記録のみ、危険レベルは即時通知と一次対応」のように、対応レベルと閾値を結びつけて定義しておきます。そうすると、運用の前提を踏まえた提案がベンダーから出てきます。
通知・エスカレーションのフローの要件化
監視項目と閾値を決めたら、検知したアラートを誰に、どの手段で、どの順番で通知するかの流れも要件に含めます。たとえば、一次受けはベンダーの監視オペレーター、重大障害は自社の情シス責任者へ電話、業務影響が大きい場合は経営層と業務部門へも報告、といった連絡経路を明文化します。このエスカレーションの設計が曖昧だと、障害発生時に「誰が判断するのか」で時間を浪費し、復旧が遅れます。
特に発注者(情シス)は、ベンダーに任せきりにせず、自社内のエスカレーションも要件として整理しておく必要があります。重大障害のときに経営層や業務部門へどう状況を報告するか、BCP(事業継続計画)とどう連動させるかは、RFPの段階で社内の運用ルールとして決めておきます。そうすると、いざというときの初動が安定します。
ベンダーが担う範囲と自社が担う範囲の境界をはっきりさせることが、要件定義の質を左右します。
SLAの数値要件(稼働率・初報応答・復旧時間)
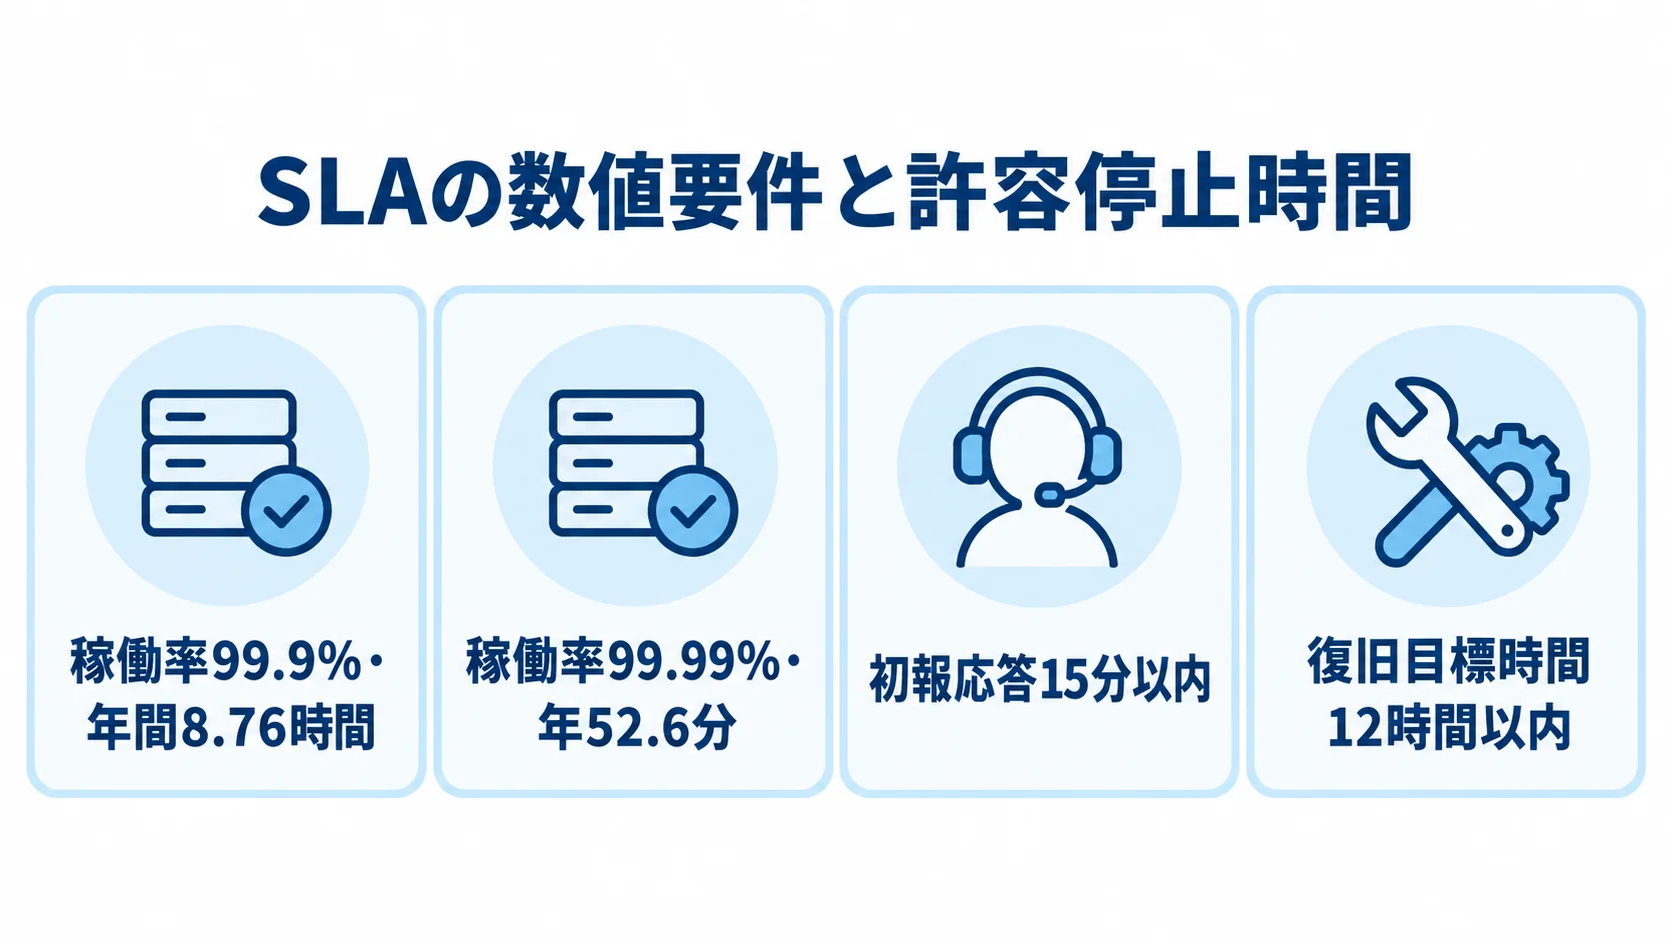
RFPで費用をもっとも左右するのが、SLA(サービスレベル合意)の数値要件です。稼働率や初報の応答時間、復旧目標時間をどの水準で求めるかによって、運用体制とコストが直接変わります。
ただし、SLAは高ければ高いほど良いわけではありません。自社の事業実態に見合った水準を数値で定めることが、過剰な費用を避ける鍵になります。
稼働率の数値と許容ダウンタイムの関係
稼働率は、許容できるダウンタイムから逆算して決めます。99.9%と99.99%では、許される停止時間が次のように変わります。
- 稼働率99.9%:年間8.76時間、月43.8分、日7.3分
- 稼働率99.99%:年52.6分、月4.38分、日4.4秒
「9」が一つ増えるだけで、許される停止時間は約10分の1になります。そのため、冗長構成や即応体制が必要になり、運用コストは段階的に跳ね上がります。RFPでは、「年間で何分までの停止なら事業に支障がないか」を業務部門と合意したうえで、稼働率を数値で指定します。
根拠となる損失額の例として、総務省の2025年版の統計では、金融・医療・EC系で5分以上の停止1回あたり平均1,200万円の機会損失とされています。また、Gartnerの2024年の指標では、ダウンタイム1分あたり約5,600米ドルの損失とされています。
こうした損失額を添えると、停止が事業にどれだけの金額の影響を与えるかが示せ、「この稼働率が必要だ」あるいは「ここまでの稼働率は不要だ」という判断を、根拠を持ってRFPに書き込めます。
初報応答・復旧目標時間とペナルティの要件
稼働率と並んで重要なのは、障害発生時の応答と復旧の時間要件です。具体的には、障害を検知してから何分以内に第一報を入れるか(初報応答)と、何時間以内に復旧させるか(復旧目標時間)を数値で定めます。その水準は、サービスや仕様によって次のように異なります。
- 重大インシデントに15分以内の一次対応を保証するサービス
- 検知から60分以内に通知して、12時間以内に復旧するサービス
- 官公庁の仕様では、1時間以内に内容と予想作業時間を報告し、原則4時間以内に完全復旧といった水準が示されることもあります
SLAを要件化するときは、未達だった場合の扱いも決めておくとよいでしょう。サービスクレジット(料金の一部返金)の有無、損害賠償の上限、間接損害の免責条項などは、契約上・法的なリスク管理に直結します。ただし、ベンダーが保証型のSLAを提示できない場合は、努力目標型にとどまることもあります。
RFPでは、「保証型を求めるのか、努力目標型でよいのか」を明示し、保証型を求めるなら未達時のペナルティ条項までセットで要件に含めます。そのため、責任の所在が明確になり、障害時の「言った・言わない」のトラブルも未然に防げます。
クラウド責任共有と監視ツールの選定要件
近年は多くのシステムがクラウド上で動いているため、RFPにもクラウド特有の前提を織り込む必要があります。国内エンタープライズ・システム市場のクラウド比率は、IDC Japanの調査で2022年時点で約5割に達しています。
そのため、オンプレミス前提の要件定義のままでは実態に合いません。抜け漏れのないRFPにするには、クラウドの責任共有モデルと、それを前提とした監視ツールの選定基準を要件に含めることが条件になります。
責任共有モデルを前提にした監視範囲の線引き
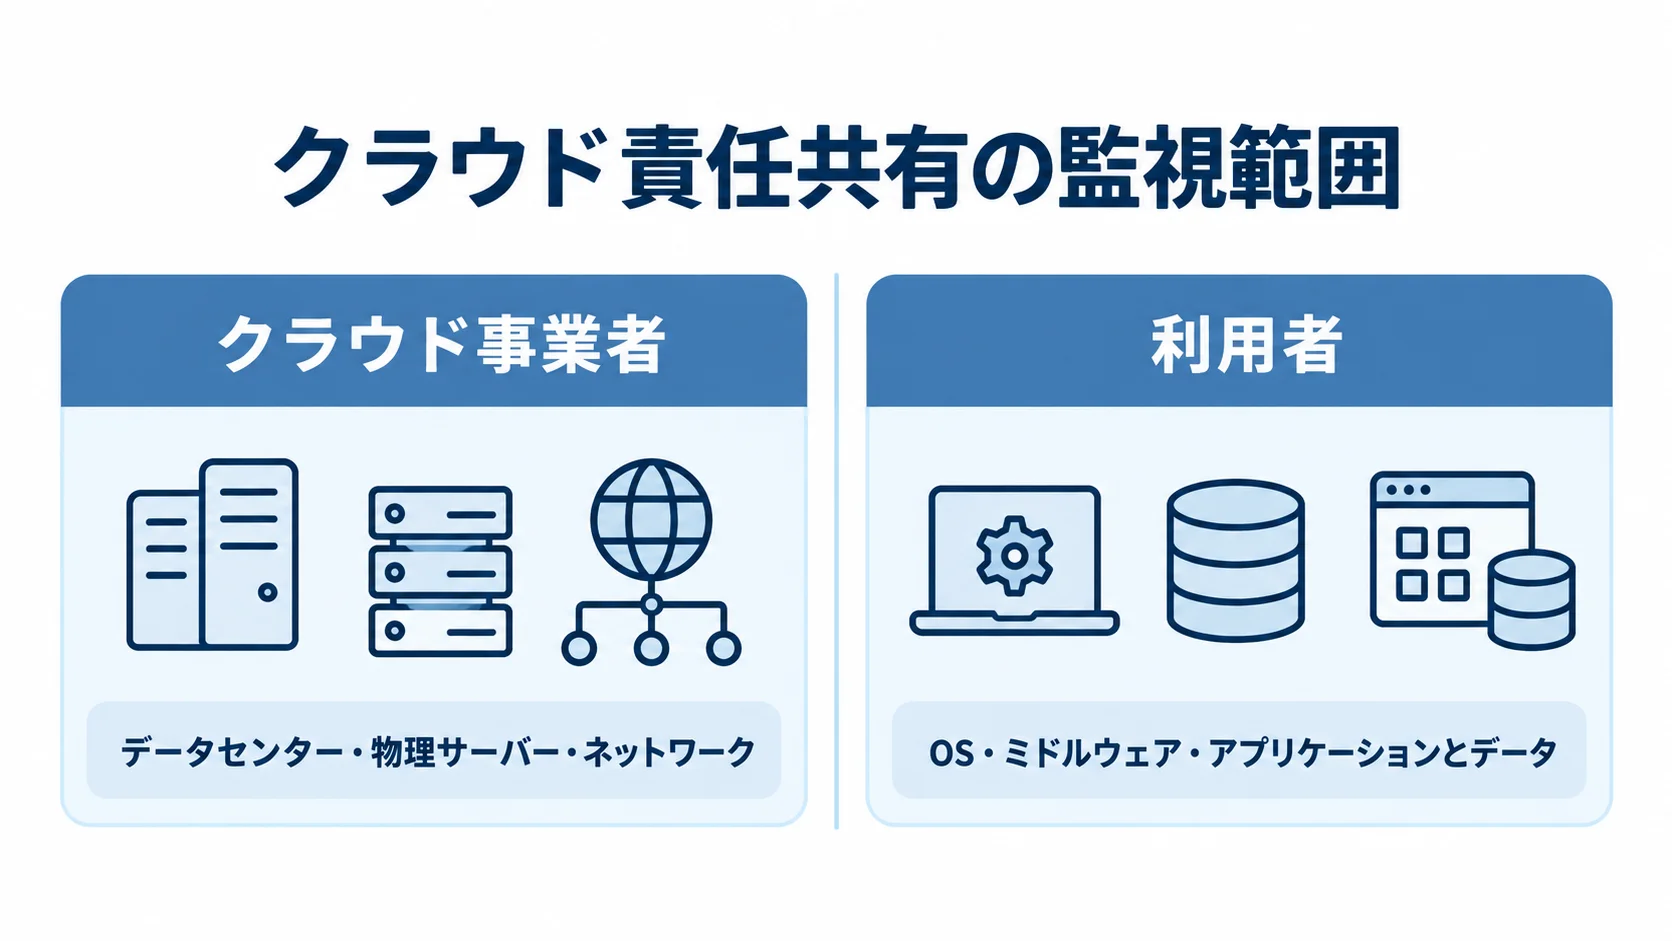
クラウドの責任共有モデルでは、責任の境界が次のように分かれます。
- クラウド事業者:データセンター、物理サーバー、ネットワークなどの基盤
- 利用者:その上で動くOS、ミドルウェア、アプリケーションとデータ
そのため、クラウド基盤の障害は利用者側では手出しができず、補償もサービスクレジットの範囲にとどまるのが一般的です。RFPでは、「どこまでが監視対象で、どこからがクラウド事業者の責任か」を明確に線引きしたうえで、利用者責任の範囲をどう監視し、どう対応するかを要件に書き込みます。
あわせて、クラウド基盤の障害に備えた自衛策も検討しておきます。マルチリージョン化や冗長構成を要件に含めるかどうかは、事業影響度とコストのバランスで決めます。クラウドだから安心と考えて監視を手薄にすると、「クラウド基盤の障害でサービスが止まったが、自社では検知すらできなかった」という事態を招きます。
責任共有の前提を理解したうえで、利用者責任の範囲をしっかり監視し、基盤障害時にも被害を最小限に抑えるアーキテクチャを要件に盛り込むことが、クラウド時代のRFPには欠かせません。
監視ツールの選定基準の明記
監視ツールをベンダー任せにせず、選定基準を要件に書いておくと、コストの内訳が明確になります。費用のかかり方は、ツールの種類によって次のように異なります。
- OSS(Zabbixなど):ライセンスは無料ですが、構築と維持に工数がかかるため、その工数を誰が負担するかを明確にする必要があります
- クラウド型(DatadogやNew Relicなど):ホスト数やメトリクス量に応じた従量課金で、中規模なら月数万〜数十万円が目安です
サーバー監視に強いMackerelのような選択肢もあります。これらの特性を踏まえ、「ライセンス費は誰が持つか」「ツールの所有権はどちらか」を要件に含めます。ツールがベンダーロックインの要因になるのを防ぐには、要件を定める段階で出口戦略も考えておく必要があります。
セキュリティ監視まで求めるなら、SOC(セキュリティ監視)の運用対象として、SIEM(Splunk Cloudなど)への対応可否を選定基準に加えます。EDR(CrowdStrike、Microsoft Defender for Endpoint、ApexOneなど)への対応可否も、あわせて確認対象にします。
ツールを要件で縛りすぎると提案の幅が狭まりますが、最低限「自社が既に使っているツールに対応できるか」と「ベンダー独自ツールを使う場合、契約終了後も監視を引き継げるか」は確認しておくべきです。
対応範囲の定義と隠れコストの回避
RFPの仕上げとして欠かせないのが、対応範囲を細かく定義することです。保守監視の見積もりトラブルの多くは、「基本料金に含まれると思っていた作業が、実は追加費用だった」という認識のズレから生まれます。そのため、要件定義の段階で範囲を決めておくと、後から出てくる隠れコストを未然に防げます。
含む作業・含まない作業の明示
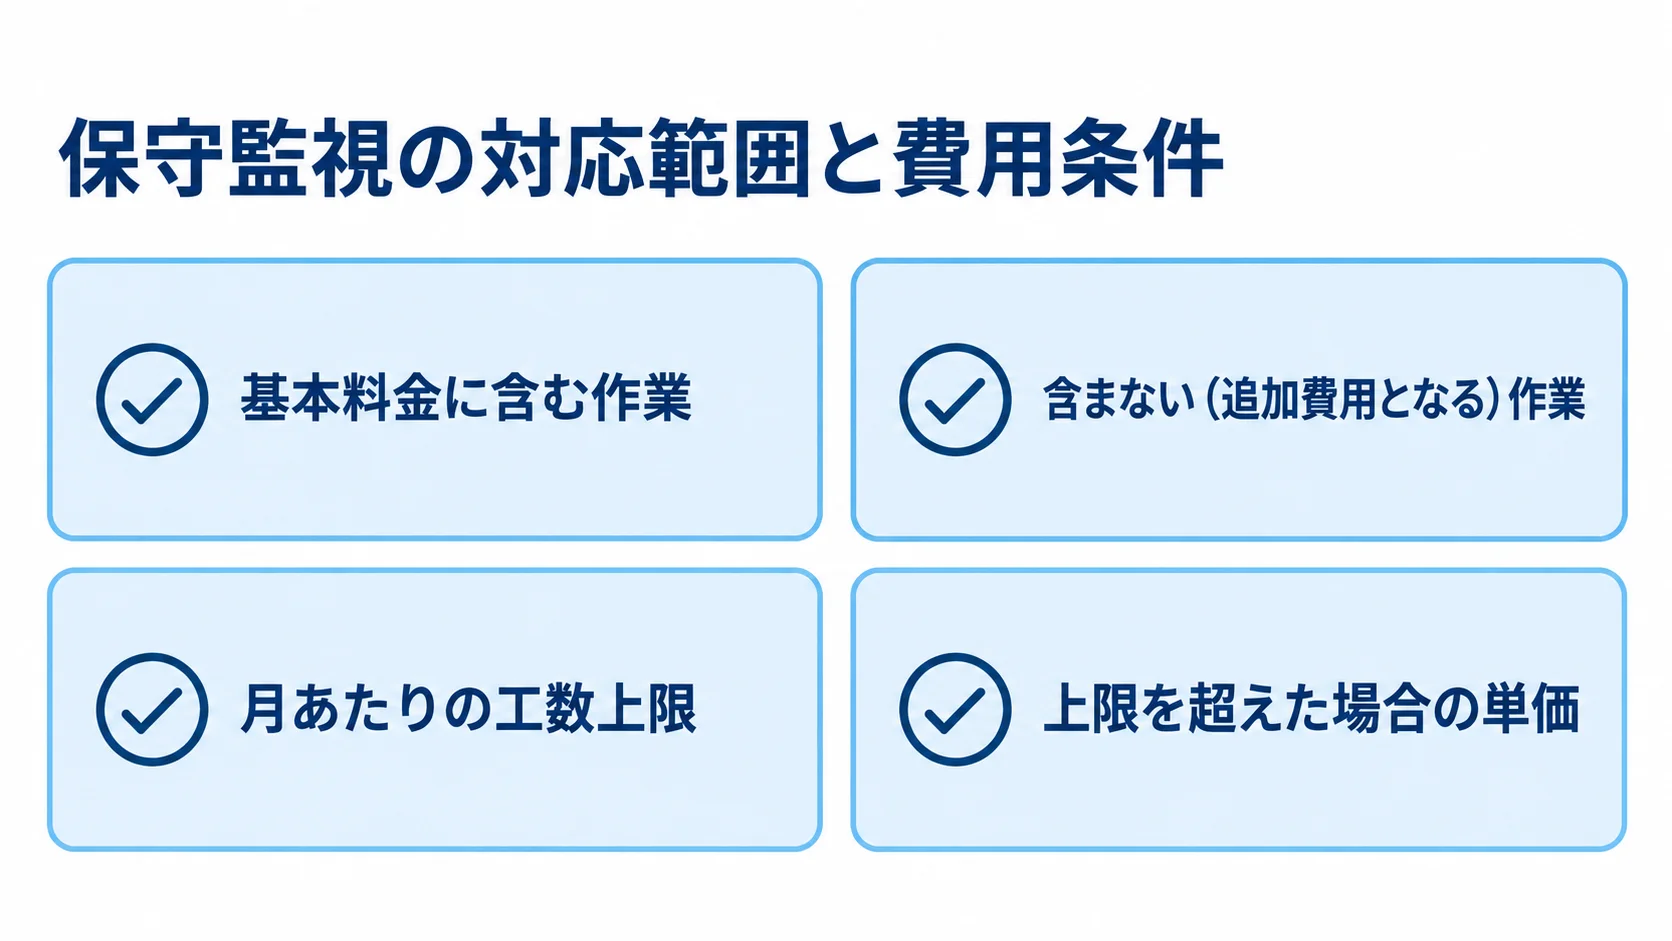
対応範囲は、「基本料金に含む作業」と「含まない(追加費用となる)作業」に分けて書きます。たとえば、監視と定型的な一次対応は基本料金に含み、原因調査の深掘りや恒久対応のバグ修正、大規模な復旧作業は別途見積もりとする、といった具合です。費用の目安としては、運用・監視が月5万〜20万円、営業時間内の障害対応が月3万〜8万円です。
さらに、24時間の緊急対応は月10万〜20万円、スポットの障害対応は1件3万〜10万円という相場があります。これらのどこまでを定額に含めるかは、RFPで明示します。あわせて、月あたりの工数上限や対応回数の上限があるかどうかも確認しておきたい点です。
「月◯時間まで」「月◯件まで」といった上限を超えた分が追加費用になる契約は多く、ここを見落とすと、障害が頻発した月に想定外の請求が届きます。RFPで「上限を超えた場合の単価」まで提示を求めておくと、ベンダー間の比較がしやすくなります。また、運用が始まってからの費用の見通しも立てやすくなります。
安すぎる見積もりの見抜き方と出口戦略
RFPで複数のベンダーから提案を集めると、極端に安い見積もりが混じることがあります。その安さの裏に「対応範囲が狭い」「SLAが定められていない」「工数上限が低い」といった落とし穴が隠れていないかを確認する必要があります。監視はするが障害対応は含まない見積もりや、SLAの保証がなく未達でもペナルティがない見積もりは、いざ障害が起きたときに役に立ちません。
要件を数値で揃えておけば、安すぎる見積もりが何を削って安くなっているのかを見抜けます。最後に、契約終了時の出口戦略も要件に含めておきます。解約予告の期間、運用ドキュメントや監視設定の引き渡し、ソースコードやアカウントの返却手順を明文化しておけば、将来ベンダーを切り替えるときにスムーズに移行できます。
riplaはフルスクラッチ受託と国内運用保守の立場から、こうした要件定義の段階で、作った後の運用と、いざというときの引き継ぎまで見据えた設計を重視しています。要件を数値と範囲で固めることが、妥当な見積もりと健全な運用を引き出す出発点になります。
まとめ
ITシステム保守監視のRFPや要件定義書で核心になるのは、監視項目を指標・閾値・監視間隔で定め、SLAを数値で示し、含む作業と含まない作業まで明示することです。SLAは、稼働率(99.9%なら年8.76時間の停止を許容)、初報応答(15分や60分以内)、復旧目標時間(4時間や12時間以内)を、未達時のペナルティとセットで示します。
クラウドの責任共有を前提に監視範囲を線引きし、監視ツールの選定基準と出口戦略まで要件に含めることで、安すぎる見積もりの落とし穴を見抜けます。
要件定義で大切なのは、ベンダーに丸投げせず、自社のエスカレーションやBCP連動まで含めて発注者側が主導することです。そのうえで数値と範囲で要件を固めれば、比較可能な提案を引き出し、隠れコストを未然に防げます。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、作った後の運用と引き継ぎまで見据えた要件定義を一緒に設計する体制づくりを支援します。費用相場や契約形態を含む全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。