
保守監視は、平時には成果が見えにくく、障害時に初めて体制の穴が表れます。主な失敗は、クラウド・SaaS化による監視のブラックボックス化と、過剰・過少なSLAの罠です。ほかにも、安すぎる見積もりに潜む落とし穴や、発注者側の初動失敗とベンダー丸投げがあります。
本記事は、ITシステム保守監視で起こりがちな失敗・課題・リスクを、発注企業(情シス)の視点で整理する、失敗・リスク特化の解説です。全体像は、ITシステム保守監視の完全ガイドで確認できます。
▼全体ガイドの記事
・ITシステム保守監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
クラウド・SaaS化による監視のブラックボックス化
近年もっとも増えている失敗が、クラウドやSaaSへの移行に伴う「監視のブラックボックス化」です。IDC Japanの調査では、国内エンタープライズ・システム市場のクラウド比率は2022年時点で約5割に達しており、多くのシステムがクラウド上で動いています。
クラウドは便利な反面、基盤の内部は利用者から見えず、障害時に手出しできないという新たなリスクを抱えることになります。
クラウド基盤障害での手出しの難しさと補償の限定性
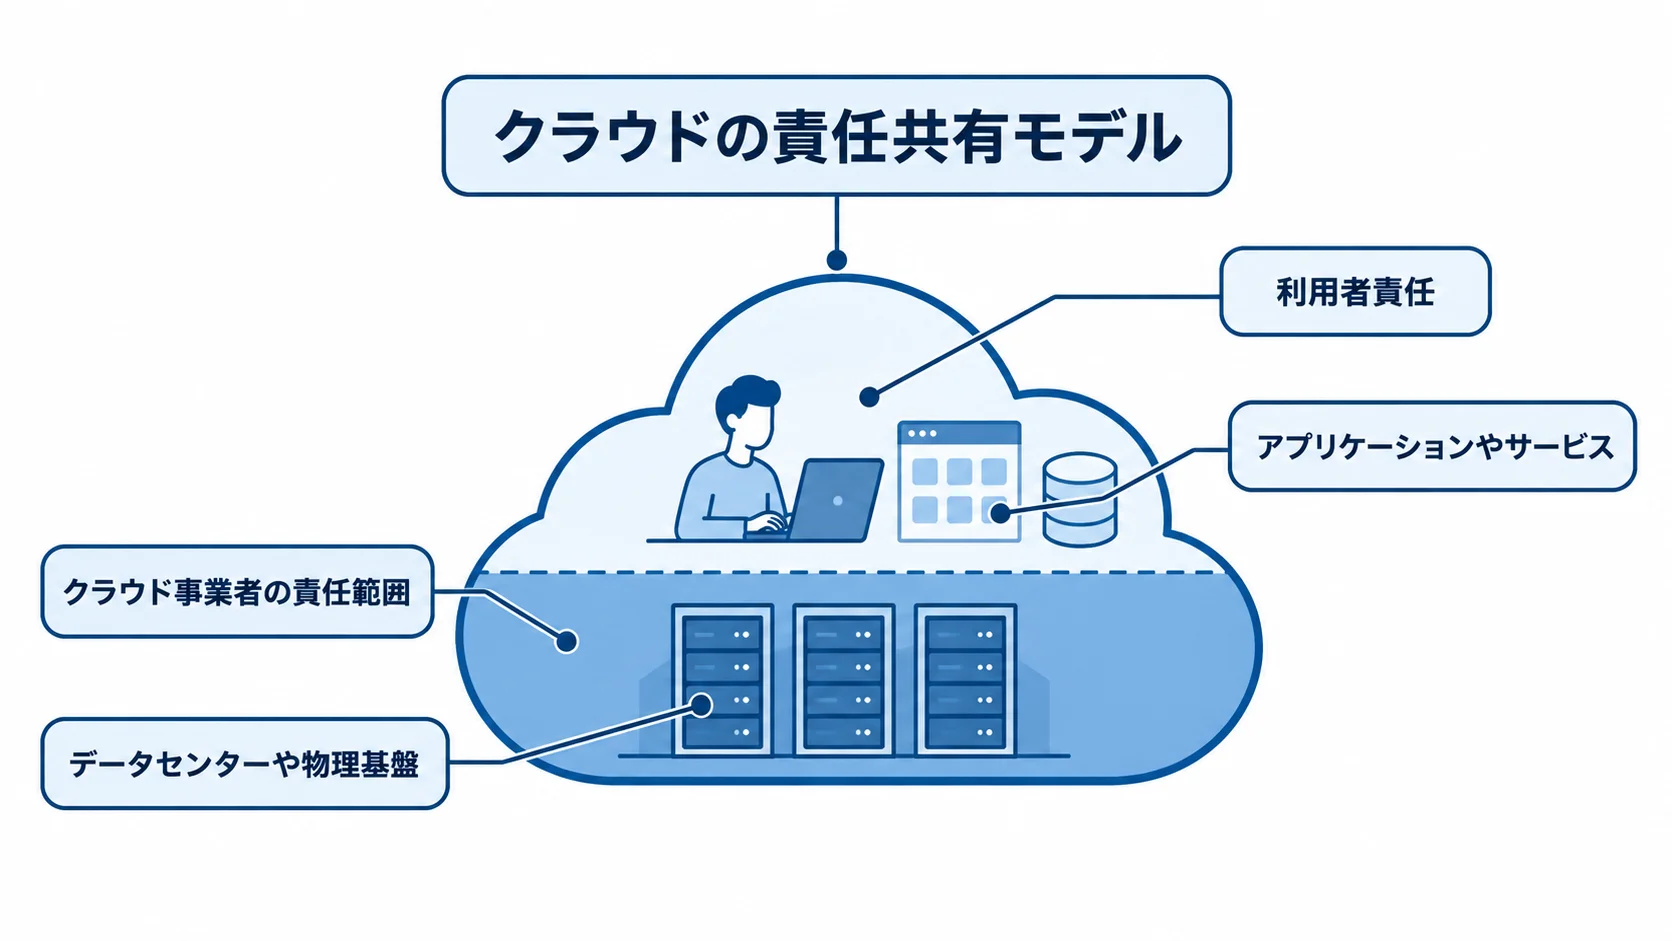
クラウドの責任共有モデルでは、データセンターや物理基盤の障害はクラウド事業者の責任範囲です。裏を返せば、基盤で障害が起きても利用者は復旧を待つしかなく、自社では何もできないということです。さらに、基盤障害による損害の補償は、契約上サービスクレジット(料金の一部返金)の範囲にとどまるのが一般的で、実際に被ったビジネス上の損失額には到底見合いません。
「クラウドだから安心」と監視を手薄にしていた企業が、基盤障害で長時間サービスが止まり、しかも自社では検知すらできなかった、という失敗が後を絶ちません。
この失敗の本質は、クラウド化によって「自社が監視・対応すべき範囲」と「クラウド事業者に委ねる範囲」の線引きが曖昧になることにあります。基盤の監視はクラウド事業者に委ねられても、その上で動く自社のアプリケーションやサービスの稼働状態は、利用者責任として自前で監視する必要があります。
特に、クラウド移行を機に監視そのものを縮小すると、障害の発覚が遅れてダウンタイムが長期化します。クラウドは監視を不要にするものではなく、「対象と責任の境界」を再設計すべきものです。
線引きは、契約と社内の役割の両面で書き出しておくと実務で使えます。
- 責任範囲の一覧:基盤側とアプリケーション側それぞれで、障害時に誰が何を担うかを書き出す。
- 補償内容の確認:サービスクレジットの範囲と、実際の損失額との差を契約書で押さえる。
自衛策としてのアーキ設計と監視の二重化
このリスクへの回避策が、アーキテクチャレベルでの自衛です。事業影響度の高いシステムでは、マルチリージョン化や冗長構成を取り入れ、一つの基盤が落ちても別の基盤で稼働を続けられるようにします。
コストは上がりますが、停止1回あたりの損失額が大きいシステムなら、十分に見合う投資です。総務省の2025年版の統計では、金融・医療・EC系で5分以上の停止1回あたり平均1,200万円の機会損失とされています。
あわせて、クラウド事業者の提供する監視だけに頼らず、自前の監視(外形監視やアプリケーション監視)を二重に持つことも有効です。クラウド事業者のステータスページは障害の認知が遅れることがあるため、利用者側で「ユーザー目線でサービスが使えているか」を独立して監視していれば、より早く異常に気づけます。
クラウドの隠れコストや手出しできないリスクを前提に、アーキテクチャと監視の両面で自衛策を講じることが、ブラックボックス化の失敗を避ける鍵です。
自衛策は、アーキテクチャと監視のそれぞれで、対象を絞って進めます。
- 冗長化の対象:停止1回あたりの損失額と冗長化コストを比べ、冗長化するシステムを絞り込む。
- 外形監視の追加:クラウド事業者の監視とは別に、利用者目線で動作を確かめる監視を置く。
過剰・過少なSLAの罠
SLA(サービスレベル合意)の設定ミスも、保守監視の典型的な失敗です。SLAは高すぎても低すぎても問題を生み、過剰なSLAは無駄なコストを垂れ流し、過少なSLAは障害時に事業を守れません。
事業影響度に見合わないSLAを契約すると、コスト面でも事業継続面でも大きなダメージにつながります。
過剰SLAが待機費を垂れ流す失敗
過剰SLAの失敗は、業務実態に対して不必要に高い稼働率や即応体制を維持し、その待機費だけがかさむパターンです。稼働率の「9」が一つ増えるごとに、運用コストは段階的に跳ね上がります。
99.9%(許容ダウンタイム年8.76時間)で十分なシステムに99.99%(許容ダウンタイム年52.6分)を適用すると、冗長構成や24時間の即応体制のコストが上乗せされ、必要のない費用を払い続けることになります。「念のため」「契約当初の名残で」高いSLAを維持し続けているシステムは、過剰SLAの温床です。
この失敗の厄介な点は、社内で「SLAを下げる」という提案がしにくいことにあります。情シスが一方的にSLAを下げると、「サービス低下だ」と業務部門から反発を招きがちです。
回避策は、システムごとに停止したときの事業影響度を洗い出すアセスメントを行い、その結果を根拠に業務部門と合意することです。たとえば、「このシステムは夜間に止まっても翌朝の復旧で支障がなく、その分の待機費を他に回せる」と影響度の根拠を示せば、SLAの適正化は前に進みます。
過剰SLAの是正は技術ではなく、社内調整の問題だと理解しておくことが重要です。
過剰かどうかは、契約上の数字を業務の実態と並べて確かめます。
- 稼働率の水準:停止時の損失額に対して、契約上の稼働率が必要以上に高くないか。
- 即応体制:夜間や休日の待機が、業務の重要度に見合っているか。
過少SLAで事業を守れなかった失敗
逆方向の失敗が、コスト削減を優先しすぎて事業に必要な水準を割り込む過少SLAです。基幹システムや顧客向けサービスのように停止が直接損害を生むシステムで、SLAを低く設定したり、そもそもSLAを定めなかったりすると、いざ障害が起きたときに復旧が間に合わず、事業に深刻なダメージを与えます。
過少SLAの失敗を避けるには、過剰SLAと同様に事業影響度アセスメントが起点になります。停止1回あたりの損失額を見積もり、それに見合うSLAを設定します。
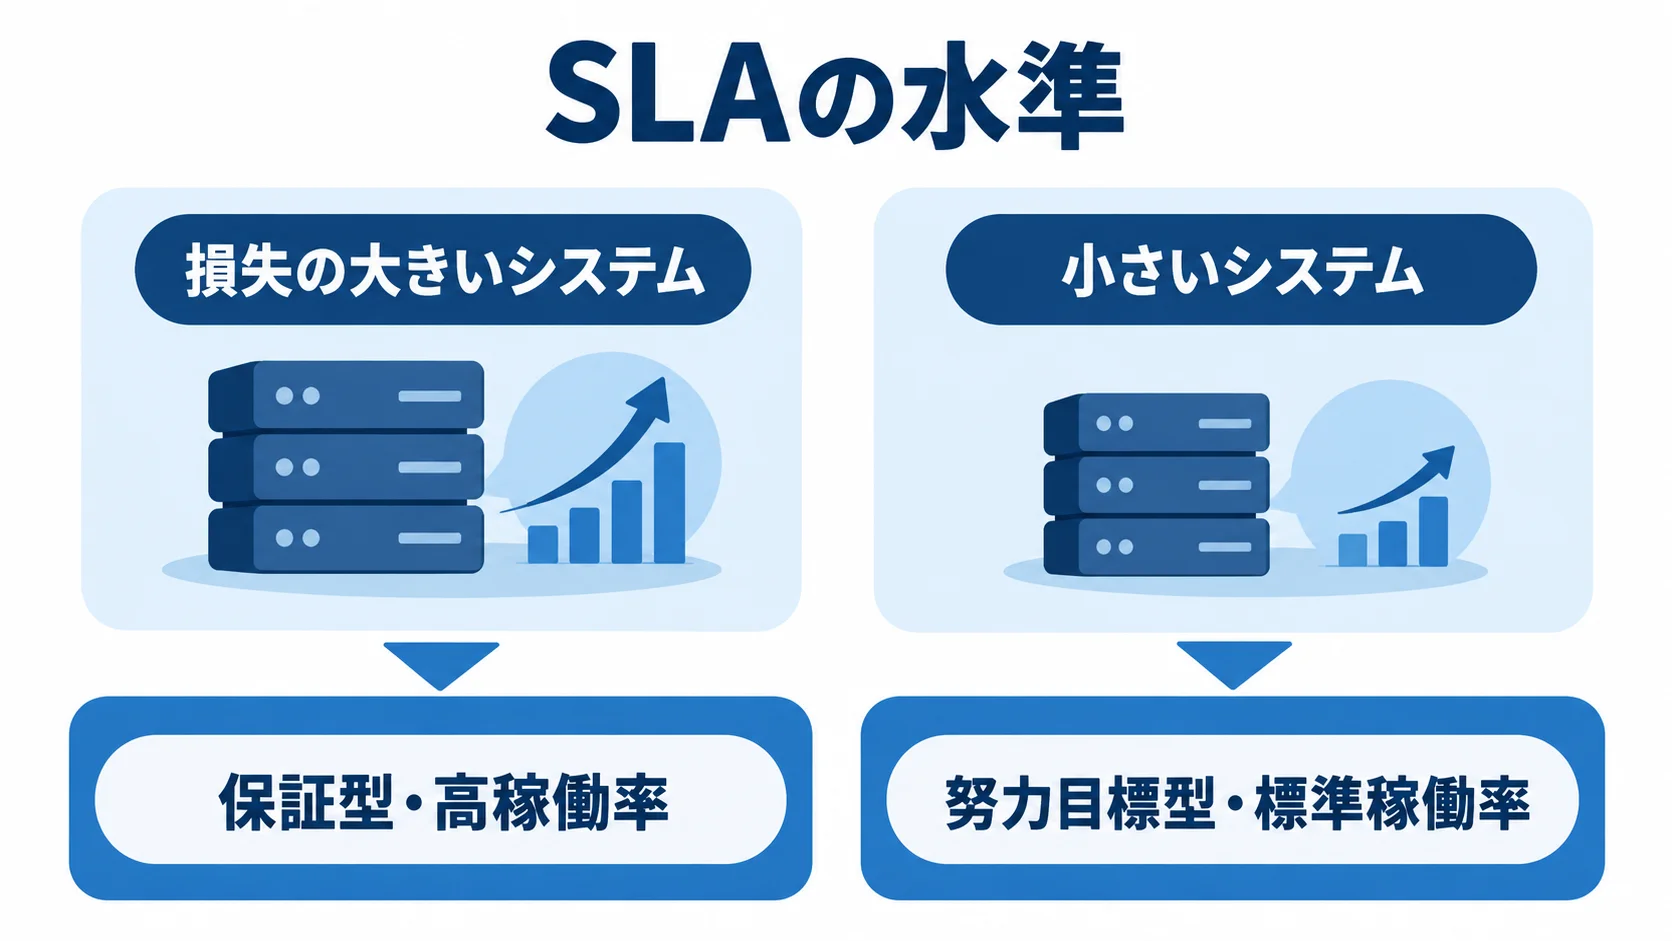
損失の大きいシステムには保証型・高稼働率を、小さいシステムには努力目標型・標準稼働率を当て、メリハリをつけることが肝心です。
すべてを一律のSLAで運用すると、重要システムは過少に、些末なシステムは過剰になりがちです。だからこそ、「事業影響度に応じて差をつける」という原則を守ることが、過剰・過少の両方の罠を避ける道筋になります。
過少かどうかは、停止したときの損失額とSLAを並べて確かめます。
- 損失額との対応:1分あたりの損失が大きいシステムが、努力目標型のまま残っていないか。
- SLAの未設定:停止が直接損害を生むシステムに、SLAがそもそも定められていないか。
損失額の目安として、Gartnerの2024年の指標では、ダウンタイム1分あたり約5,600米ドルの損失が出るとされています。
SLAを契約後に見直さない放置の失敗
過剰・過少SLAの根っこには、「契約時に決めたSLAを、その後一度も見直さない」という放置の問題があります。事業の成長やシステムの役割の変化に伴って、必要なSLAの水準は変わっていきます。
たとえば、立ち上げ当初は影響が小さかったシステムが、利用拡大で基幹級の重要度になっているのに、SLAは当初のまま低く据え置かれている、といったズレが生じます。一方で、役割を終えて使われなくなったシステムに高いSLAを払い続けている、という反対向きのズレも起こります。
この放置を防ぐには、SLAを定期的に見直す仕組みを運用に組み込むことです。年に一度、システムごとの事業影響度と現行SLAを照らし合わせ、過不足を点検する場を設けると、両方向のズレを早期に是正できます。
SLAは契約時に一度決めれば終わりではなく、事業の変化に合わせて見直し続けるべき「生きた約束」です。この定期点検を怠ると、過剰・過少SLAの失敗が長期化する隠れた原因になります。
放置に気づく機会は、主に契約更新と事業の節目の二つです。
- 契約更新の時期:現行のSLAと事業影響度を並べ、更新の前に水準を見直す。
- 事業の節目:利用が広がったときや役割を終えたときに、対象システムのSLAを改めて確認する。
安すぎる見積もりに潜む落とし穴
ベンダーを選ぶとき、極端に安い見積もりに飛びついて失敗するケースも多く見られます。保守監視の費用には相場があり、それを下回る見積もりには、たいてい何かが削られています。
安さの理由を見抜けないまま契約すると、いざ障害が起きたときに「思っていた対応が受けられない」という事態に陥ります。
対応範囲・SLAの欠如という隠れた削減
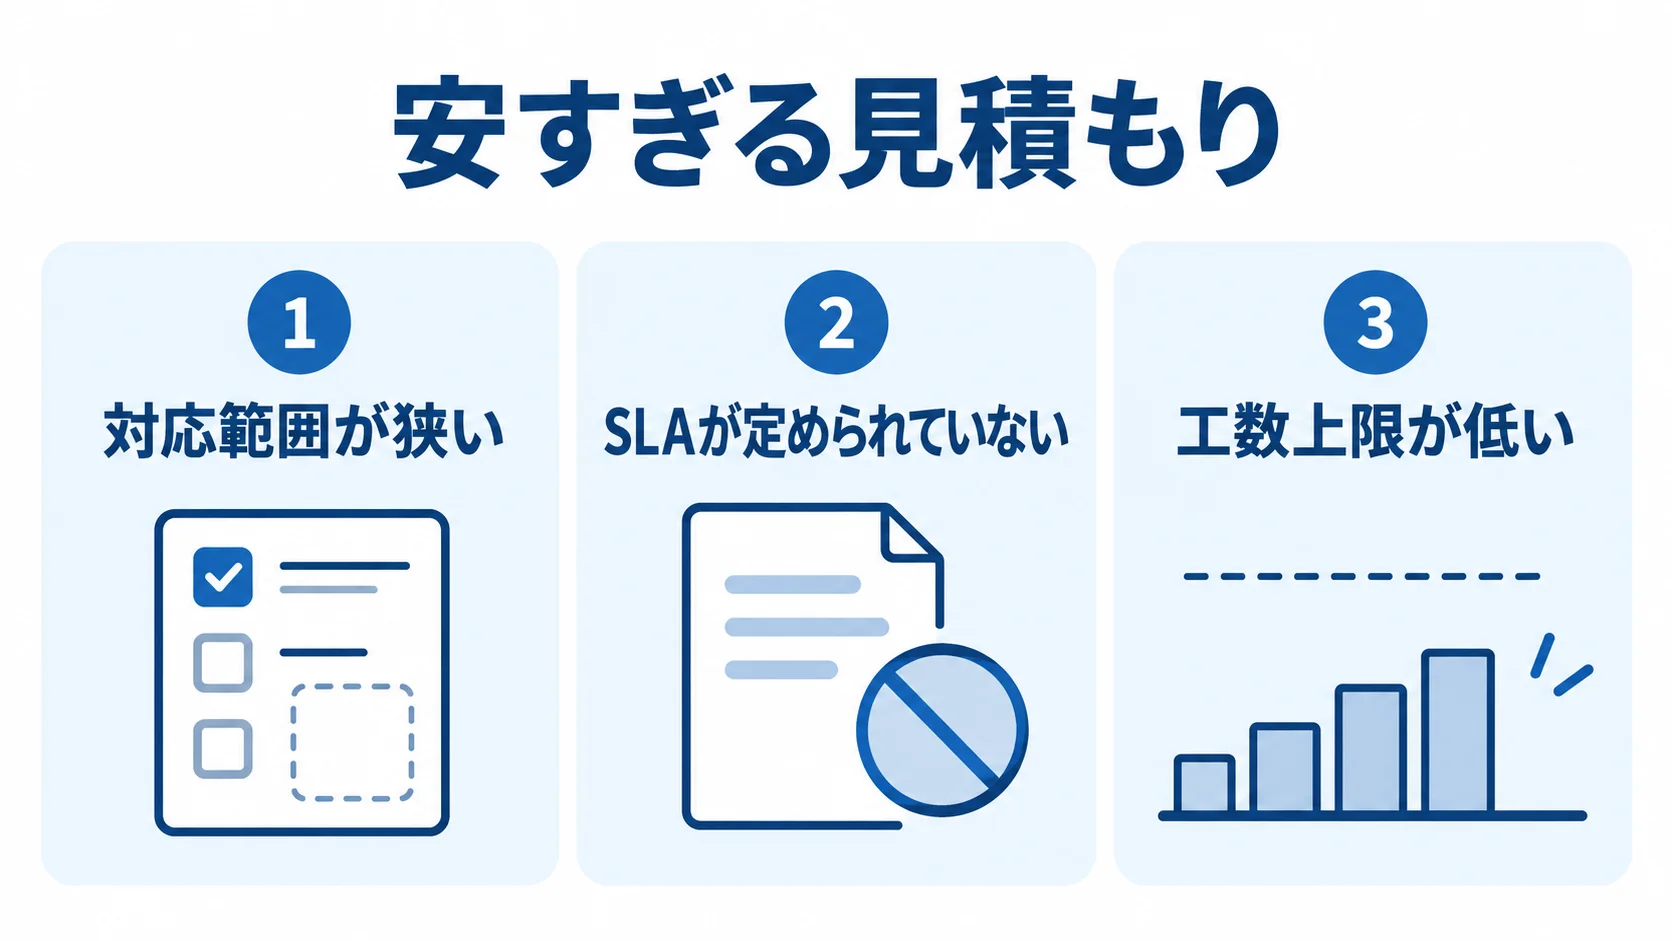
安すぎる見積もりが安い理由は、多くの場合「対応範囲が狭い」「SLAが定められていない」「工数上限が低い」のいずれかです。監視はするが障害対応は含まない、SLAの保証がなく未達でもペナルティがない、月の対応工数に厳しい上限がある、といった具合に、肝心の部分が削られています。
相場としては、運用・監視は月5万〜20万円、24時間の緊急対応は月10万〜20万円、スポットの障害対応は1件3万〜10万円といった水準があります。そのため、これを大幅に下回る見積もりは、対応範囲を疑う必要があります。
この失敗を避けるには、見積もりを金額だけで比較せず、「何が含まれ、何が含まれないか」を必ず確認することです。要件を数値と範囲で揃えてベンダーに提示すれば、安すぎる見積もりが何を削って安くなっているのかが見えてきます。
安さに惹かれて対応範囲の狭い契約を結ぶと、障害頻発時にスポット対応の追加費用が積み上がり、結果的に高くつくことも珍しくありません。目先の月額の安さよりも、いざというときに事業を守れる対応範囲かどうかを見ることが肝心です。
見積もりの中身は、金額の横に並べて確かめると見えやすくなります。
- 対応範囲:監視だけか、障害対応まで含むのかが、見積書の上で明示されているか。
- SLAと未達時の扱い:保証する水準と、未達だったときの扱いが契約に書かれているか。
ベンダーロックインと出口戦略の欠如
安さに関連する失敗として、出口戦略を考えずに契約し、ベンダーロックインに陥るリスクもあります。ベンダー独自のツールや属人的な運用に依存すると、別のベンダーに切り替えたいときに、監視設定や運用ノウハウを引き継げず、移行に高いコストがかかります。
安い見積もりの裏で契約終了時の引き渡し条件が曖昧なまま進めると、後から「動くに動けない」状態に陥ります。
回避策は、契約の段階で出口戦略を明文化しておくことです。解約予告の期間、監視設定や運用ドキュメントの引き渡し、ソースコードやアカウントの返却手順を、あらかじめ契約に盛り込みます。
riplaはフルスクラッチ受託と国内運用保守の立場から、こうした「いざというときの引き継ぎ」まで見据えた契約設計を一貫して重視しています。安さだけで選ばず、長期的な運用の自由度を確保しておくことが、将来の選択肢を狭めないための備えになります。
ロックインを避ける備えは、契約と運用の両面で用意します。
- 運用の属人化:監視の設定や手順が特定の担当者だけに閉じていないか、社内で確かめておく。
- 返却手順の確認:ソースコードやアカウントを返す流れを、契約終了の前に決めておく。
発注者側の初動失敗とベンダー丸投げのリスク
最後に取り上げるのが、もっとも見落とされがちな「発注者(情シス)側の失敗」です。保守監視を委託していても、障害発生時の発注者側の立ち回りが拙いと、被害は拡大します。
ベンダーに丸投げできない部分があると理解せず、自社の初動を準備していないと、社内で孤立してしまいます。
状況報告の遅れとBCP不在の失敗
障害が起きたとき、ベンダーは技術的な復旧を進めます。一方で、発注者側には「経営層や業務部門への状況報告」「ユーザーへの告知」「BCP(事業継続計画)に基づく代替手段の発動」といった、自社にしかできない初動があります。発注者側の重要な役割は、技術的な復旧と並行して社内のコミュニケーションを統制することです。
ここを準備していないと、復旧作業は進んでいても社内が混乱し、「いつ復旧するのか」「業務をどうすればいいのか」という問い合わせが情シスに殺到して、対応が破綻します。
この失敗を避けるには、障害発生時のエスカレーションフローと報告ルールを、平時のうちに整備しておくことです。障害の最中に報告先や伝達の順番を決めようとすると、初動が遅れてしまいます。
初動の準備は、社内への報告と業務の代替という二つの面で整えておきます。
- 社内への報告:経営層と業務部門に、誰が何をいつ伝えるかを決めておく。
- 代替業務の手順:システムが止まっている間の業務を、手作業などでどう回すかを文書にする。
重大障害では、2時間以内の対応開始と24時間以内の完全解決が一般的な目標とされています。ただし、その間の社内統制は発注者の責任であり、この認識が欠かせません。報告と代替業務をBCPとして訓練しておけば、実際の障害でも落ち着いて初動を踏めます。
丸投げ回避と判断・調整の自社保持
ベンダー丸投げの最大のリスクは、自社システムへの理解とノウハウが社内に一切残らないことです。すべてをベンダーに任せきりにすると、ベンダーを切り替えるときや、ベンダーの対応に問題が生じたときに、自社では何も判断できなくなります。
障害時に「どこに問題があるのか」「業務にどう影響するのか」を自社で理解できないと、ベンダーの言いなりになるしかありません。これは、安すぎる見積もりやベンダーロックインのリスクとも地続きの問題です。
回避策は、「手を動かす作業は委託、業務影響の判断と社内調整は自社」という線引きを明確に持つことです。監視や一次対応の実務はベンダーに任せても、ベンダー間の調整やシステム全体の方針決定は、自社の手元に残しておく必要があります。
riplaはフルスクラッチ受託と国内運用保守の立場から、システムを作った後も継続して伴走し、発注者が丸投げにならず主体的に運用を統制できる体制づくりを重視しています。失敗の多くは、発注者側が「判断と調整は自社の仕事」という意識を持つだけで、減らせるのです。
丸投げを避けるには、自社が手元に残す役割を先に決めておきます。
- 業務影響の判断:障害時にどの業務がどの程度止まるかを、判断する担当者を決めておく。
- 経営層との調整窓口:経営層への報告とベンダー間の調整を、どこが受け持つかを明確にする。
まとめ
ITシステム保守監視の失敗は、四つに集約されます。クラウド・SaaS化による監視のブラックボックス化と過剰・過少なSLAの罠、安すぎる見積もりに潜む落とし穴、そして発注者側の初動失敗とベンダー丸投げです。クラウド基盤障害は手出しできず補償も限定的なため、自衛のアーキ設計と監視の二重化が欠かせません。SLAは事業影響度に応じて差をつけ、過剰も過少も避けます。
見積もりは金額だけでなく、対応範囲とSLA・出口戦略で判断します。また、障害時は発注者が判断・報告・BCPに基づく初動を担います。これらの構造を知っておくだけで、多くの失敗は先回りして防げます。
失敗事例から学べる共通の教訓は、保守監視を「ベンダーに任せれば安心なコスト」と捉えず、「発注者が主体的に統制すべき事業継続の備え」と位置づけることです。停止1回1,200万円という損失額を念頭に、自社の事業影響度に応じて、監視とSLA、契約範囲、初動体制を設計してください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、作った後も継続して伴走し、これらの失敗を避ける体制づくりを支援します。費用相場や契約形態を含む全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。