
保守運営の成功事例では、保守費の内訳を可視化して払い過ぎを正した企業や、障害件数をBefore/Afterで改善した企業が成果を出しています。
保守運営は成果が見えにくく、稟議も通しにくいため、自社に近い事例が投資判断や社内説明の精度を高めます。全体像をまだ押さえていない方は、まずITシステム保守運営の完全ガイドからお読みください。
▼全体ガイドの記事
・ITシステム保守運営の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ベンダー乗り換えでTCOを削減した保守運営事例
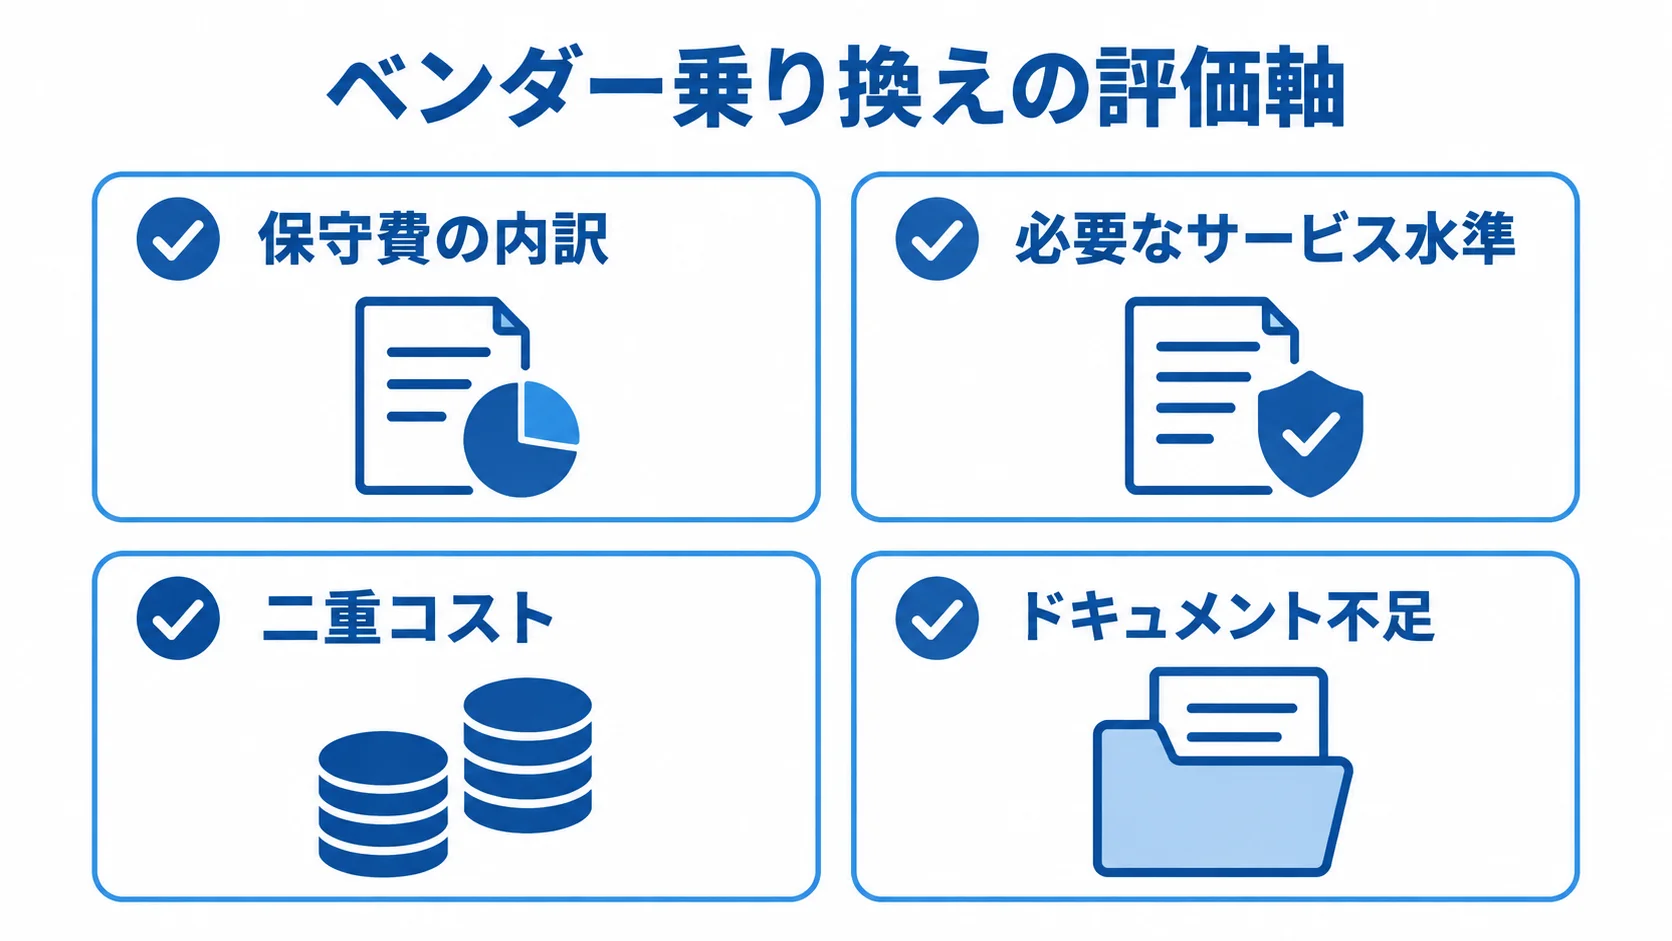
ITシステム保守運営の事例で、もっとも経営インパクトが大きいのが「ベンダー乗り換えによる保守費の最適化」です。長年同じ開発ベンダーに保守を任せ続けると、明細の根拠が曖昧なまま保守費が高止まりしがちで、これは多くの企業に共通する悩みです。乗り換え事例は、この高止まりをどう解消したかという点で示唆に富みます。
保守費の内訳を可視化して20%以上圧縮した事例
ITシステムの年間保守費は、一般に開発費の15〜20%が目安とされ、一部では10〜15%程度に収まるケースもあります(出典:ripla)。一般的な内訳の目安は、定期保守が20〜30%、監視が15〜25%、障害対応が25〜35%です。問い合わせ対応は10〜20%、軽微改修は10〜15%、管理・報告は5〜10%です(出典:ripla)。
乗り換えの進め方は、次の2段階でした。
- 内訳の取り寄せ:現行ベンダーに、保守費を項目ごとの金額に分けて出してもらう
- 突き合わせ:新ベンダー候補の提案と内訳を並べ、自社の障害頻度に合わない項目を探す
その結果、自社では月数件しか発生しない障害対応に過大な待機費が乗っていた、といった「払い過ぎ」が見えてきます。事例企業は、実際の障害発生頻度に見合った体制へ契約を組み直し、保守費を20%以上圧縮しました。
事例で大切だったのは、内訳を可視化して「自社が本当に必要なサービス水準」に合わせ直したことです。単に値を切ったわけではありません。保守費の妥当性は、総額ではなく内訳を見てはじめて判断できます。
内訳の可視化が効くのは、ベンダーとの交渉の土台が「感覚」から「事実」に変わるからです。交渉では、「なんとなく高い気がする」と伝えるより、具体的に指摘するほうが効きます。
たとえば「障害対応費が全体の3割を占めているが、当社の障害は四半期に1件程度で、この待機費は実態に合っていない」と言えれば、相手も応じざるを得ません。
事例企業は、過去2年分の障害ログと対応履歴を整理し、項目ごとの妥当性を一つずつ検証しました。この準備が、根拠のある減額交渉を可能にしたのです。サービス水準を実態に合わせ直すという発想が、値引きよりも持続可能なコスト最適化につながります。
二重コストとドキュメント不足を乗り越えた移管事例
乗り換え事例から学べるもう一つの教訓は、移管には固有のリスクとコストが伴うという現実です。保守移管期間中は、旧ベンダーと新ベンダーの両方に費用が発生する「二重コスト」が一時的に生じます。さらに、設計書や運用手順書といったドキュメントが整備されていないと、新ベンダーがシステムを理解するまでに想定以上の時間がかかり、引き継ぎが難航します。
成功した移管事例では、契約段階で旧ベンダーに対しドキュメントの提供範囲と協力義務を明文化し、移管期間を「並行運用期間」として設計しました。新ベンダーが本番障害を一度経験して初めて知見が定着するため、いきなり全面切り替えするのではなく、一定期間は旧ベンダーをバックアップに残す段階移管を選んだのです。
この丁寧な進め方が、移管直後の重大障害という最悪のシナリオを回避しました。事例に共通するのは、乗り換えを「安くなる」かどうかだけで決めず、移管リスクとTCO全体で評価した点です。
乗り換えの評価では、次の2つを並べて見ます。
- 移管リスク:二重コストと、ドキュメント不足による引き継ぎの遅れ
- TCO全体:保守費の差額に、移管期間の費用まで含めて比べる
障害件数をBefore/Afterで改善した運用事例
保守運営の成果を社内に伝えるには、障害件数や稼働率の改善を、Before/Afterの数字で示すのが効果的です。事例企業は、保守体制を見直す前後で「月次の障害発生件数」「障害あたりの平均復旧時間」「稼働率」を計測し、改善の度合いを経営層に報告しました。
稟議で効くのは、「安定しました」という漠然とした説明ではなく、比較できる数字です。数字があれば、保守投資の正当性が伝わります。
稼働率99.9%とSLA実値で安定を可視化した事例
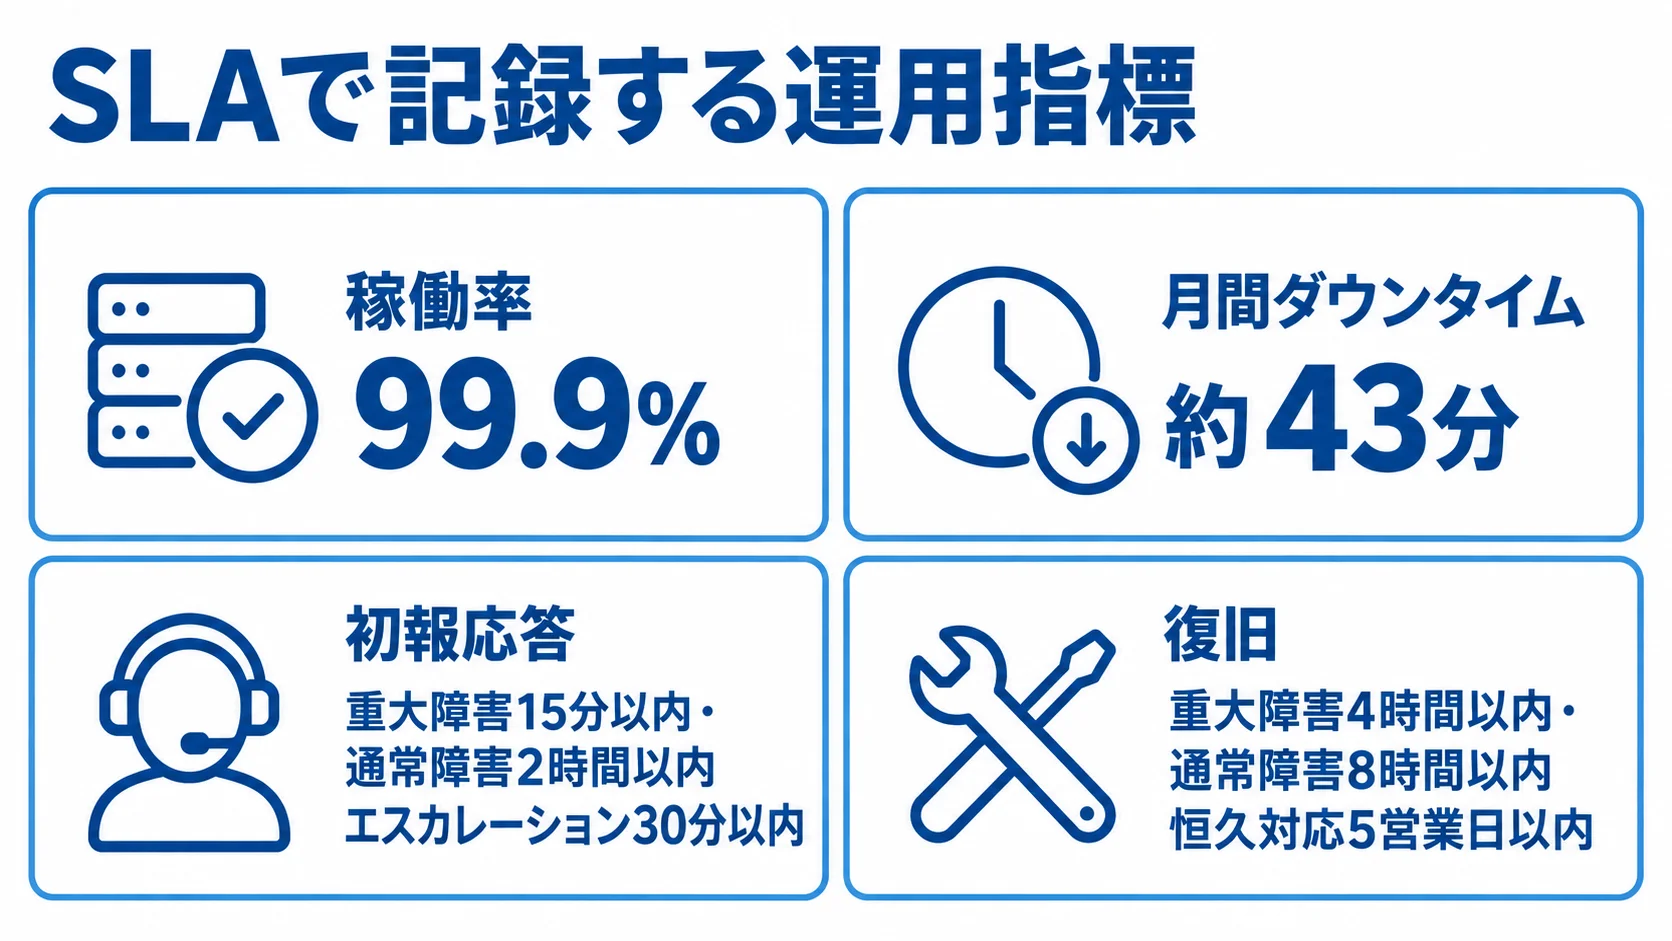
事例企業がSLAの指標として採用したのは、稼働率99.9%という水準です。これは月間で許容されるダウンタイムが約43分という厳しさを意味します(出典:ripla)。
数値目標は、初報応答が重大障害で15分以内・通常障害で2時間以内です。エスカレーションは30分以内、復旧は重大障害で4時間以内・通常障害で8時間以内とし、恒久対応は5営業日以内としました(出典:ripla)。
これらの数値をBefore/Afterで追跡したところ、体制見直し後は初報応答の遅延がほぼなくなり、復旧時間の平均が短縮されました。特に、SLAを努力目標ではなく計測可能な指標として運用したことが、改善を可視化できた理由です。
稼働率や応答時間を数字で押さえておくと、ベンダーとの定例会でも事実ベースの議論ができ、感情論を避けられます。SLAの実値を記録しておけば、保守運営の改善を関係者どうしで同じ数字をもとに語れます。
SLAの実値は、次の2つを記録しておくと、改善の説明に使えます。
- 稼働率:目標の99.9%に対する実際の値
- 応答と復旧:障害ごとに、初報までの時間と復旧までの時間
場当たり対応から根本原因対策へ転換した事例
障害件数のBefore/Afterで顕著な改善を出した事例の共通点は、場当たり的な対症療法から、根本原因対策(恒久対応)への転換です。改善前は同じ種類の障害が毎月のように再発し、その都度ベンダーが応急処置を繰り返していました。これでは障害件数は減りません。
具体的には、軽微改修の枠(保守費の10〜15%が目安)を再発防止のための作り込みに充て、応急処置で消耗していた障害対応費(同25〜35%)を構造的に削減しました(出典:ripla)。
応急処置は安く見えても、再発のたびに発生し続けるため、累計では割高になります。一方で、根本対策に一度投資すれば、以降の障害件数と対応コストが恒常的に下がっていきます。この「対症療法から根本対策へ」という発想の転換が、Before/Afterの数字を動かした決定打でした。
恒久対応への転換は、次の2つの手順で進みました。
- 記録:発生した障害をすべてチケットに起票する
- 予算の配分:再発の多い原因から順に、恒久対応へ予算を振り向ける
この転換を実現するには、障害を記録して分類する仕組みが前提になります。事例企業は、起票したチケットに原因区分と影響範囲を残し、対応内容と再発の有無も蓄積しました。
データが溜まると、「特定の処理で月初に必ず高負荷障害が起きる」「あるバッチが失敗すると連鎖的に問い合わせが増える」といったパターンが浮かび上がります。
優先順位がはっきりしたことで、限られた改修枠を最大効率で使えました。障害対応を「その都度の消火」ではなく「データに基づく改善活動」として運用したことが、Before/Afterの差を生んだ本質です。
ひとり情シスが外部委託で本業に集中した事例
中堅・中小企業では、情報システム担当が1人だけという「ひとり情シス」の体制が珍しくありません。社内システムの運用保守をすべて1人で抱えると、日々の問い合わせ対応や障害対応に追われ、本来取り組むべきDXや業務改善に手が回らなくなります。この状態を外部委託で解消した事例は、同じ悩みを抱える企業に直接的な示唆を与えます。
定型運用を月20万〜50万で委託し本業に回帰した事例
事例企業は、自社で抱えていた運用業務のうち、定型業務を外部に切り出しました。サービス委託の費用相場は月20万〜50万円程度とされています(出典:ripla)。これは、運用要員を1人雇う人件費よりも変動費としてコントロールしやすい水準です。
結果として、ひとり情シスの担当者は問い合わせ対応の一次受けから解放され、業務改善やシステム企画という本来の付加価値業務に時間を割けるようになりました。
大切なのは「丸投げ」ではなく「切り分け委託」だという点です。委託範囲を定型業務に限り、システムの方向性を決める判断業務は社内に残したことで、コストを変動費化しつつ、自社の判断力を維持でき、ブラックボックス化も避けられました。リソースが限られる組織ほど、この切り分けの設計が成否を左右します。
切り分けの中身は、次の2つに分けて見ると分かりやすくなります。
- 委託側:監視、バックアップ、一次問い合わせ対応などの日常的な運用
- 社内側:システムの方向性を決める判断業務
この事例には、見落とされがちな副次効果もありました。委託先に業務を引き継ぐ過程で、担当者の頭の中にしかなかった運用手順やシステム構成、アカウント情報を文書化せざるを得なくなり、結果として属人化が解消されたのです。
それまでは担当者が休暇を取るだけでシステム運用が止まりかねない状態でしたが、ドキュメントが整い委託先が動けるようになったことで、事業継続性そのものが向上しました。
外部委託は、人手を補う手段であると同時に、属人的な運用を仕組みへ置き換える契機にもなります。一人に依存した状態は、コスト以前に事業リスクであることを、この事例は示しています。
火消しから定常運用へ立て直した伴走事例
保守運営の事例には、平時の改善だけでなく「炎上したシステムの火消し」という切迫した状況からの立て直しもあります。前任ベンダーが撤退し、ドキュメントもないまま障害が頻発するシステムを引き継いだケースでは、まず現状のソースコードと設定を調査します。そのうえで、頻発する障害を止める応急対応と並行して、運用手順書を整備するところから始めます。
riplaは、フルスクラッチ受託と国内運用保守の立場から、こうした引き継ぎ案件でも、作った後の継続伴走を前提にコードとドキュメントを整えます。定常運用へ移行させる進め方も重視しています。
火消しに成功した事例では、次の2段階で立て直しました。
- 第1段階:最初の数週間は、障害を止めることに集中する
- 第2段階:再発を防ぎ、定常運用に乗せる
火消し事例が教えるのは、緊急時こそ段階的に立て直すことが、最短の安定化につながるという原則です。火消し案件で見落とされがちなのが、立て直しの過程で「運用設計そのものをやり直す」必要がある点です。
前任ベンダーが場当たり的に運用していた場合、監視のしきい値が適切でなかったり、バックアップの世代管理が曖昧だったりと、土台が崩れていることが珍しくありません。
事例では、障害を止めた後の安定期に「基礎の作り直し」を行い、監視項目を洗い直し、アラートの優先度を決め直し、バックアップ・リストアを実地に検証しました。この地味な再設計こそが、再発を構造的に防ぐ土台になります。
クラウド・SaaS連携の責任分界を整理した事例
近年の保守運営事例で存在感を増しているのが、クラウドやSaaSと連携した環境特有の「責任分界点」を整理して立て直したケースです。システムがAWSやAzureといったクラウド基盤の上で動き、複数のSaaSとAPIで連携する構成が当たり前になった今、障害の原因がベンダーのコントロール内にあるとは限りません。
この責任の境目を放置していた企業が、契約を見直して安定化させた事例は、現代の保守運営でもっとも示唆に富みます。
クラウド障害時の対応範囲を契約で線引きした事例
事例企業は、当初「障害が起きたら運用ベンダーがすべて何とかしてくれる」と漠然と考えていました。ところが、実際にクラウド側の広域障害でシステムが停止した際、ベンダーから「クラウド事業者の問題なので当社では復旧できない」と告げられました。誰も動かないまま、長時間の停止を経験しました。
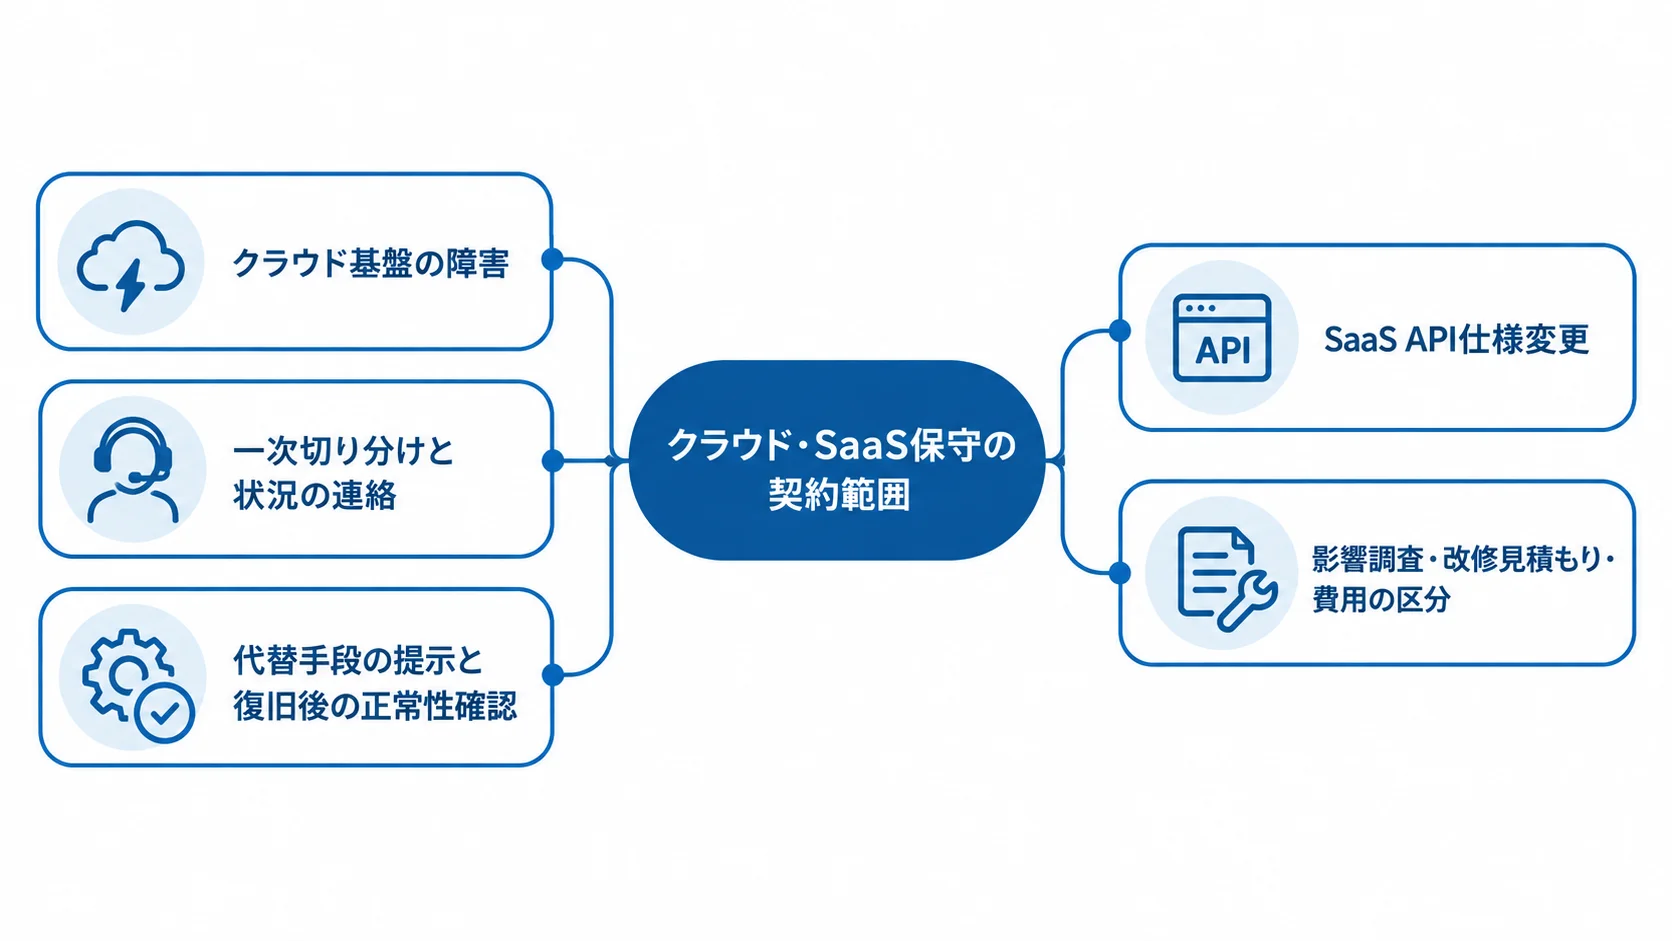
この苦い経験を機に、コントロール外の障害でもベンダーが何をどこまで行うかを契約で具体化したのです。見直し後の契約では、クラウド基盤の障害時でも、ベンダーが一次切り分けと状況の連絡を担うと明記しました。さらに、代替手段の提示から復旧後の正常性確認までも担う内容にしました。
障害時の連絡は、次の2点を決めて整えました。
- 情報の入手先:クラウド事業者のステータスページや障害通知
- 社内への共有:どのチャネルで、どの影響を伝えるか
クラウド障害は自社の監視ツールだけでは原因が見えにくいため、運用ベンダーが事業者の情報を監視し、影響範囲を即座に判断して報告する流れを定めました。その結果、停止の事実だけでなく「いつ復旧見込みか」「自社システムへの影響はどの機能か」まで早期に把握できるようになり、現場の混乱が減りました。
「コントロール外でも何をするか」を線引きしたことで、障害のたびに「それは契約外です」と押し問答になる事態が消えました。こうした障害でも、情報の流れを設計しておけば、利用者への説明責任は果たせます。
SaaSのAPI仕様変更を別枠費用で整理した事例
もう一つの典型が、連携先SaaSのAPI仕様が予告なく変わり、連携機能が突然動かなくなるケースです。事例企業では、SaaS側の仕様変更が原因の不具合を「保守の範囲内か範囲外か」で毎回もめていました。
SaaS事業者の都合による変更は、運用ベンダーから見ればコントロール外であり、本体システムの障害とは性質が異なります。それでも放置すれば業務は止まるため、誰がどう対応するかを決める必要がありました。
立て直しでは、次の2つのルールを決めました。
- 対応の流れ:通知があったら、影響調査と改修見積もりを一定の営業日以内に提示する
- 費用の区分:改修を軽微改修枠(保守費の10〜15%が目安)か、別枠の追加費用として扱う(出典:ripla)
これにより、仕様変更が起きても対応の順番が定まり、宙ぶらりんの状態が解消されました。クラウド・SaaS時代の保守では、コントロール外の事象を「想定外」にせず、あらかじめ決めておくことが安定運用の要になります。
まとめ
ITシステム保守運営の事例を振り返ると、成果を出した企業に共通するのは、保守費の内訳を可視化し、障害や稼働率をBefore/Afterで定量化したうえで、委託範囲を切り分けて段階的に体制を整えたことです。
ベンダー乗り換えでは、内訳の分解で保守費を20%以上圧縮しつつ、二重コストとドキュメント不足という移管リスクに備えました。運用改善では、稼働率99.9%やSLA実値を記録して対症療法から根本対策へ転換し、ひとり情シスは定型運用を月20万〜50万円で切り分け委託して本業に回帰しました。
さらに、クラウド障害やSaaSのAPI仕様変更といったコントロール外の事象まで、対応範囲と費用区分を契約で線引きしておく必要があります。現在のIT環境で保守運営を実効性あるものにするには、この線引きが前提になります。
事例を読むときは、「どれだけ手厚い保守か」ではなく、「自社の障害頻度と業務に見合った水準か」という視点で見ることが大切です。まずは現行の保守費内訳と障害件数を可視化し、自社に最適なサービス水準へ組み直すところから着手してください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、作った後の継続伴走と、数字で説明できる保守運営づくりを一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。