
ITシステムの定期メンテナンスは、監視や障害対応、アップデート管理などの役割が組み合わさって初めて機能します。
- 監視と予防保守:異常の兆候を早期に把握する
- バックアップと復旧:事業継続性を守る
- 障害対応とSLA管理:対応品質を管理する
- アップデートとリリース:計画的に適用する
- AIOps:異常検知の精度と効率を高める
この全体像を押さえずに契約すると、必要な作業が抜けたり、逆に過剰な工数を払ったりする原因になります。なお、費用相場や契約形態を含む全体像は、まずITシステム定期メンテナンスの完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステム定期メンテナンスの完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
監視と予防保守の機能
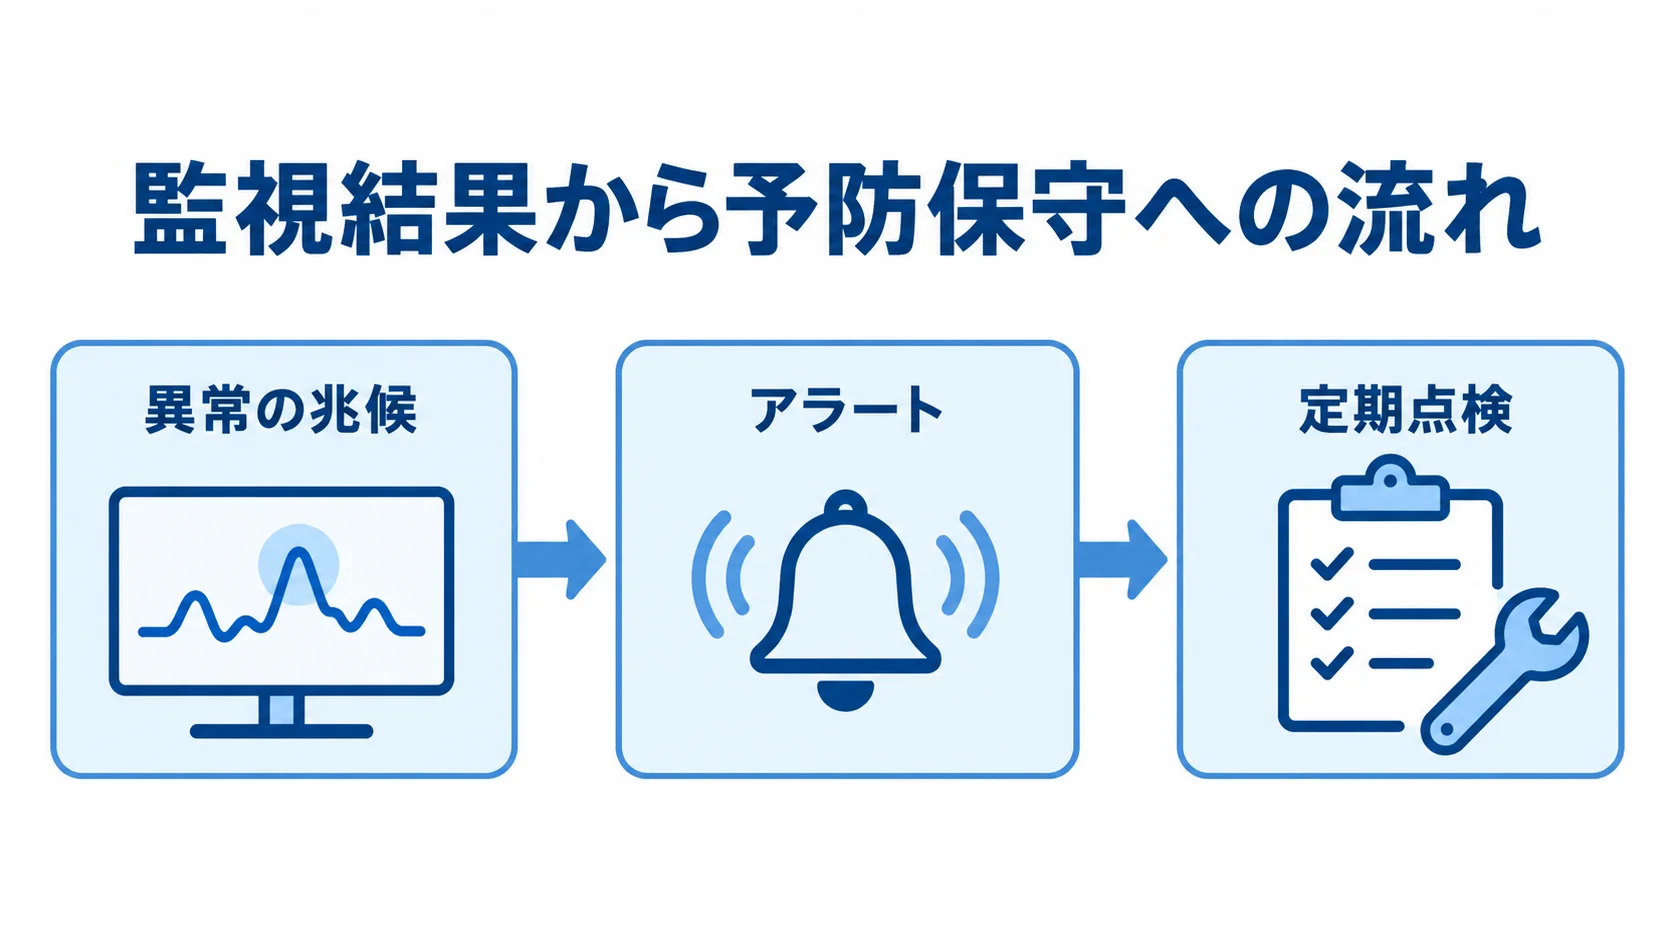
定期メンテナンスの土台になるのが、監視と予防保守の機能です。監視は、サーバーやネットワーク、アプリケーションの状態を常時把握し、異常の兆候を早期に検知します。
予防保守は、監視の結果や経験則をもとに、障害が起きる前に手を打つ役割です。この二つがそろって機能すると、定期メンテナンスは「壊れてから直す」事後対応から、「壊れる前に防ぐ」予防型へ変わります。
リソース監視・性能監視の役割
監視機能の中核は、CPU・メモリ・ディスク使用率といったリソース監視と、応答時間やスループットといった性能監視です。これらの指標をしきい値とともに常時計測し、超過したらアラートを発報します。たとえば、ディスク使用率が80%を超えたら警告、90%を超えたら緊急というように段階を設けると、ディスク枯渇によるシステム停止を未然に防げます。
性能監視では、レスポンスが徐々に遅くなる劣化の兆候を捉え、本格的な障害になる前に対処できます。また、性能の基準は要件として数値で定めておくと、運用がぶれません。RFPの例では、全画面の応答を3秒以内とする処理速度要件が挙げられることがあります(出典:ripla)。
定量目標をしきい値に組み込めば、「なんとなく重い」といった感覚論を離れ、合意した基準に達しているかを客観的に判断できます。さらに、監視機能はアラートを出すだけでなく、合意した品質を維持できているかを測る物差しとしても機能します。
定期点検とログ分析による予防保守
予防保守は、監視で得たデータをもとに、計画的な点検と先手の対処を行う機能です。定期点検では、ログのエラー傾向、ディスクやメモリの増加ペース、証明書やライセンスの有効期限を周期的にチェックし、将来の障害リスクを洗い出します。
ログ分析では、まだ障害にはなっていないものの頻発し始めた軽微なエラーを捉えられます。それを早い段階で見つければ、本格的なトラブルへ発展する前に手を打てます。
予防保守は保守費の内訳でも大きな比重を占め、定期保守は全体の20〜30%、監視は15〜25%とされます(出典:ripla)。この比率は、「壊れる前の作業」が重視されていることを示しています。予防保守を厚くするほど、後述する障害対応の比率を下げられる関係にあるため、監視と予防保守は費用対効果を左右する中核機能だと言えます。
バックアップと復旧の機能
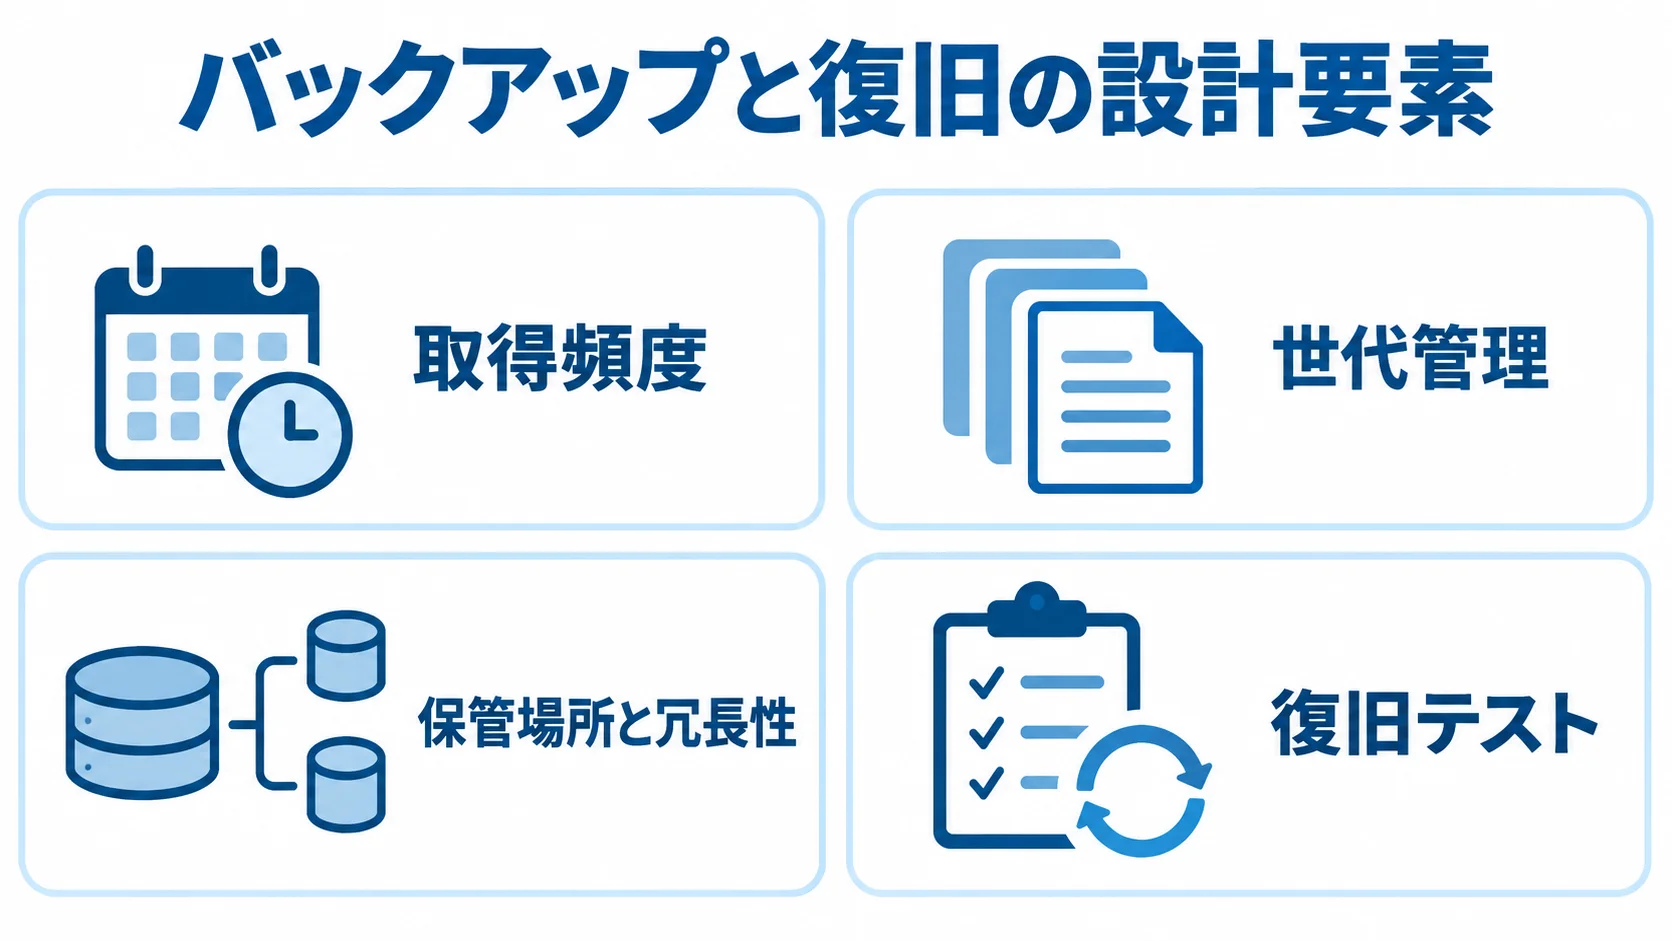
定期メンテナンスのなかで、事業継続性を直接守るのがバックアップと復旧の機能です。バックアップは、データやシステム構成を定期的に取得・保管し、復旧は、障害やデータ破損が起きたときに保管したデータから元の状態へ戻します。
この二つは表裏一体で、取得だけして復旧できないバックアップは意味を持ちません。このため、両方が機能して初めて、いざというときの保険になります。
世代管理と取得頻度の設計
バックアップ機能の設計では、取得頻度と世代管理が要になります。フルバックアップを週次、差分バックアップを日次で取得し、何世代分を保管するかを決めます。これは、「どの時点まで戻せる必要があるか(目標復旧時点)」と「どれだけの時間で戻せる必要があるか(目標復旧時間)」という業務要件から逆算します。
重要な基幹システムほど、戻せる粒度と速さの要求が高くなり、それに応じて設計と保管コストも変わります。特に注意すべきは保管場所と冗長性です。同じ拠点や同じストレージにだけ保管していると、その拠点が被災したりストレージが故障したりした瞬間に、バックアップごと失われます。
定期メンテナンスの一環として、別拠点やクラウドへの遠隔保管を組み込めば、災害時の事業継続性が高まります。さらに、バックアップ機能は「取る」だけでなく、「どこに、どれだけ、どう守って保管するか」までを含めて設計することが肝心です。
復旧テストと復旧手順の整備
復旧機能の実効性を担保するのが、定期的な復旧テストです。バックアップから実際に戻せるか、想定した時間内に復旧できるかを、平時のうちに検証しておきます。テストを行っていないと、いざ障害が起きたときに「バックアップが壊れていた」「復旧手順を誰も知らなかった」という事態に陥り、最悪の場合はデータを取り戻せません。
復旧手順書を整備し、四半期に一度はテストを行うことは、定期メンテナンスのなかで見落とされがちな重要機能です。また、復旧の速さは、SLAの形でも定義されます。重大障害時の復旧目標を4時間、通常障害を8時間、恒久対応を5営業日以内とする例があります(出典:ripla)。
これらの目標を達成するには、バックアップの取得設計、復旧手順、復旧テストの三点が揃っている必要があります。バックアップと復旧の機能は、データを守るだけでなく、合意した復旧時間を守れる体制そのものとして捉えることが大切です。
障害対応とSLA管理の機能
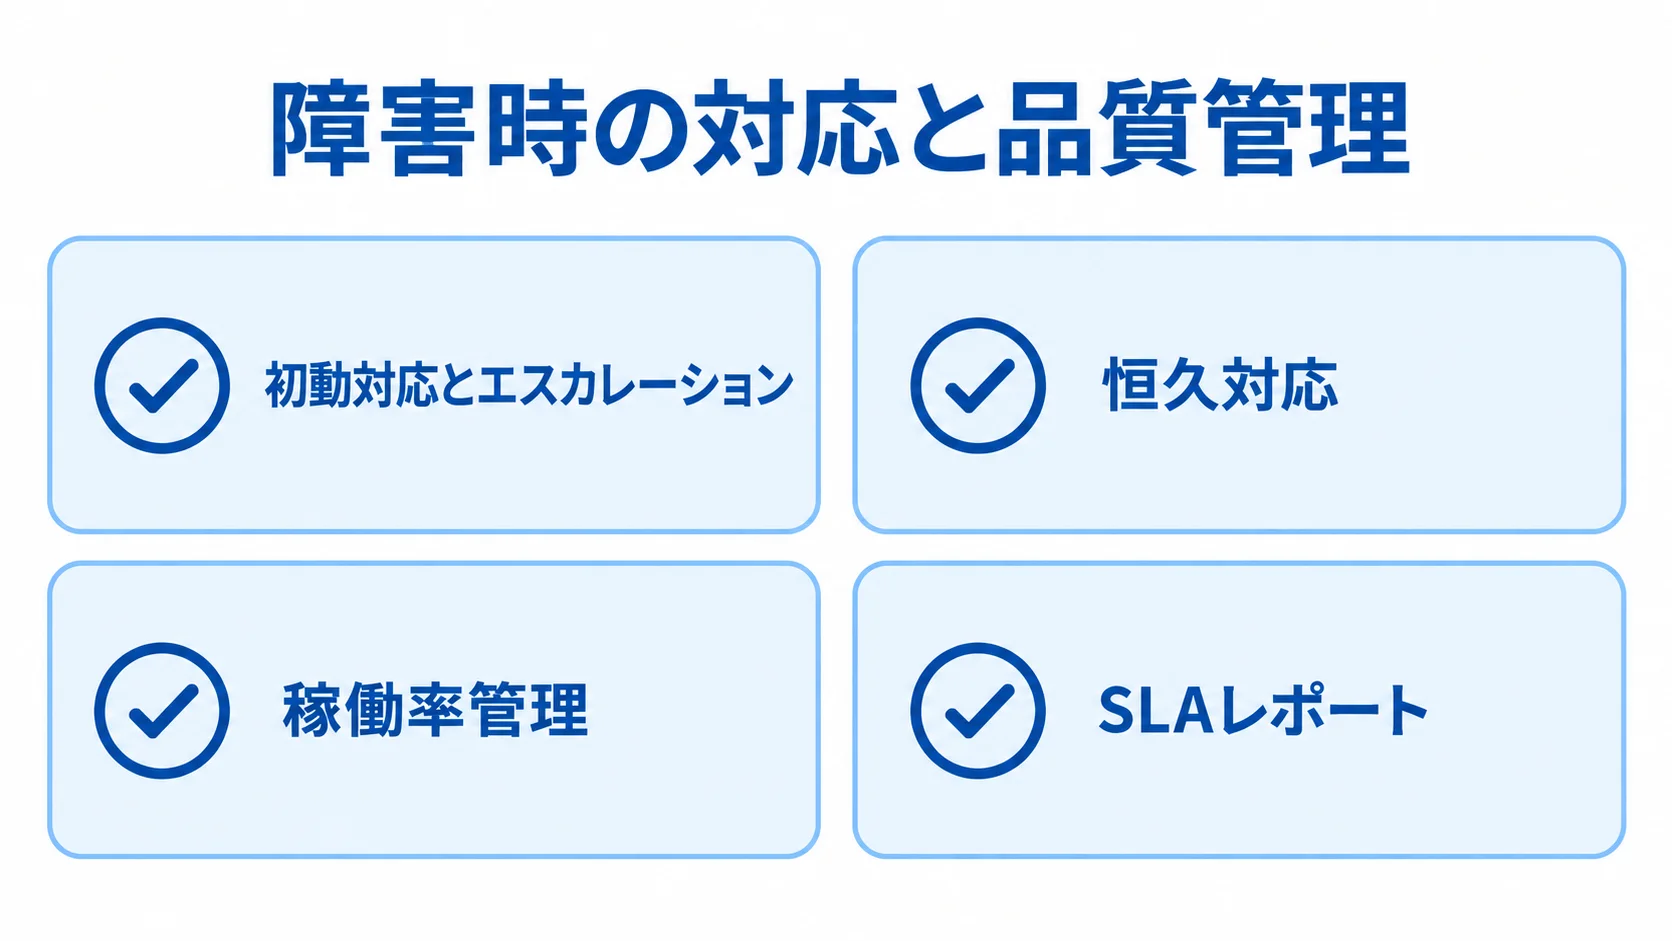
予防に努めても、障害をゼロにはできません。だからこそ、障害時に迅速に検知・初動・復旧する障害対応と、その品質を数値で約束・管理するSLA管理が必要になります。
障害対応は保守費の内訳でも25〜35%と最大の比重を占めることが多く(出典:ripla)、定期メンテナンスの中でもっともコストと品質が問われる役割です。
初動対応とエスカレーションの仕組み
障害対応の質は、初動の速さと、適切なエスカレーションの設計で決まります。アラートを受けてから誰がどの順で対応し、自分の手に負えないときは誰にいつ引き継ぐかを、あらかじめ手順として定めておく必要があります。また、SLAの実値では、初報応答を重大障害15分・通常障害2時間、エスカレーションを30分、回答を24時間以内とする例があります(出典:ripla)。
こうした時間軸が明確であるほど、混乱時でも落ち着いて対応を進められます。障害対応では、復旧という「止血」だけでなく、再発防止という「治療」までを含めることが重要です。応急処置でサービスを戻したあとは、そのうえで根本原因を分析して恒久対応を行い、同じ障害が繰り返さないようにします。
この恒久対応を5営業日以内に行うといった基準を設けると、障害対応が場当たりで終わらず、システムの信頼性向上につながります。障害対応機能は、初動、エスカレーション、恒久対応の三段構えで設計するのが定石です。
稼働率管理とSLAレポートの役割
SLA管理機能は、約束した品質を測り、守り、報告する役割を担います。代表的な指標が稼働率で、99.9%(月あたり許容ダウンタイム約43分)や99.5%といった水準が設定されます(出典:ripla)。SLA管理では、実際の稼働率や応答時間、復旧時間を集計し、目標に達しているかを定期的にレポートします。
この報告があると、発注側は「品質が約束どおりか」を確認でき、ベンダー側は改善の優先順位を判断できます。また、SLAには未達時のペナルティ(減額)を組み込むこともあります。ただし、原因がベンダーのコントロール外、たとえばクラウド事業者側の障害などにある場合は適用されないことも多く、どこまでをSLAの対象とするかの線引きが実務上の論点になります。
SLA管理機能は、数値を約束するだけでなく、何を対象とし、未達のときどうするかまで設計してこそ意味を持ちます。稼働率管理とSLAレポートは、定期メンテナンスの品質を契約として担保する要の機能です。
アップデート管理とAIOps自動検知の機能
定期メンテナンスを将来にわたって機能させ続けるのが、アップデート管理と、AIOps(AIを活用した運用)による自動検知の機能です。
アップデート管理は、OS・ミドルウェア・ライブラリのパッチやバージョンアップを計画的に適用する役割です。AIOpsは、大量の監視データから異常をAIが自動で見つけ出す役割を担います。前者がシステムを安全な状態に保ち、後者が監視の精度と効率を引き上げます。
パッチ適用とリリース管理の役割
アップデート管理機能の中核は、パッチ適用とリリース管理です。セキュリティパッチは、既知の脆弱性を放置しないために、計画的に適用する必要があります。ただし、本番にいきなり当てると不具合を招くおそれがあるため、検証環境で影響を確認してから本番に展開する手順が欠かせません。
リリース管理は、軽微な改修や仕様変更を本番へ反映する際に、いつ・何を・どう戻せる形で適用するかを管理する役割を担います。アップデートやリリースの作業は、定期メンテナンスのなかでも障害を誘発しやすい局面です。だからこそ、保守を担う側が、変更前のバックアップ取得、適用手順の文書化、切り戻し(ロールバック)手順の三つを、セットで用意しておく必要があります。
クラウドやSaaSと連携している場合は、外部サービス側のAPI仕様変更にも追従する必要があります。これは、広い意味でのアップデート管理に含まれます。パッチ適用とリリース管理は、システムを安全に進化させ続けるための継続機能です。
AIOpsによる異常自動検知の役割
近年、定期メンテナンスに加わりつつある機能が、AIOpsによる異常の自動検知です。従来の監視はしきい値を人が設定するため、平常時の変動が大きいシステムでは誤報や見逃しが起きやすいという課題がありました。AIOpsは、過去のデータからシステムの「いつもの状態」を学習し、そこから外れた異常を自動で検知します。
これにより、人が気づきにくい複合的な兆候や、徐々に進む劣化を早期に捉えられるようになります。一方で、AIを組み込んだシステムの保守には専門性が求められ、MLOps(機械学習の運用)の保守は月50万〜200万円が目安とされます(出典:ripla)。AIOpsは、AIモデルの精度監視や再学習といった新たな保守作業も生み出します。
国内ITインフラサービス市場は、2024年の2兆2,685億円から2029年に3兆674億円へ、年率6.2%で成長すると見込まれています(出典:ripla/IDC系統計)。AIOpsを含む高度な運用保守機能への需要も、今後は伸びていく見通しです。アップデート管理とAIOpsは、定期メンテナンスを未来に対応させ続ける機能だと言えます。
まとめ
ITシステム定期メンテナンスの機能を整理すると、役割の集合体であることが見えてきます。監視と予防保守でリスクを先回りして抑え、バックアップと復旧で事業継続性を守ります。障害対応とSLA管理で品質を数値で約束・管理し、アップデート管理とAIOpsでシステムを安全に進化させ続けます。
保守費の内訳では、定期保守が20〜30%、監視が15〜25%、障害対応が25〜35%という配分になっています。この配分が示すように、予防と対応のバランスが、定期メンテナンスの費用対効果を左右します。
稼働率99.9%や復旧4時間といったSLA実値は、これらの機能が揃って初めて達成できるものです。
機能を理解する目的は、「自社のシステムにどの役割を、どこまで持たせるべきか」を見極めることです。
すべてを最高水準で揃えるより、業務の重要度に応じて、監視・バックアップ・障害対応・アップデートの厚みを設計することが大切です。
riplaは、フルスクラッチ受託と国内開発・運用保守を組み合わせ、システムの特性に合わせた定期メンテナンス機能の設計と、継続的な伴走を支援します。
費用相場やSLA、契約形態を含む全体像は、あらためて完全ガイドでご確認ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。