
ITシステム維持管理の事例は、保守費の見直しから移管の失敗まで四つの場面に分けると、現場の判断や失敗、立て直しが見えてきます。維持管理には、開発のような完成という明確なゴールがなく、稼働している限り終わりなく続く活動です。
本記事は、ITシステム維持管理の導入事例・開発事例・活用事例・成功事例を、発注企業(ユーザー企業)の視点から掘り下げる「事例特化」の解説です。全体像をまだ把握していない方は、まずITシステム維持管理の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステム維持管理の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ベンダー乗り換えで保守費と障害を圧縮した事例
ITシステム維持管理の事例で、経営層にもっとも響くのは、「ベンダーを乗り換えて年間の保守費を抑えながら、むしろ障害対応の質を上げた」というケースです。
維持管理の費用は、年間で開発費の15〜20%が一つの目安とされ(出典:ripla)、規模によっては月額50〜200万円以上にのぼります。だからこそ、このコストを「当たり前の固定費」と捉えるか、「交渉と見直しの余地がある変動費」と捉えるかで、数年単位の総コストは変わります。
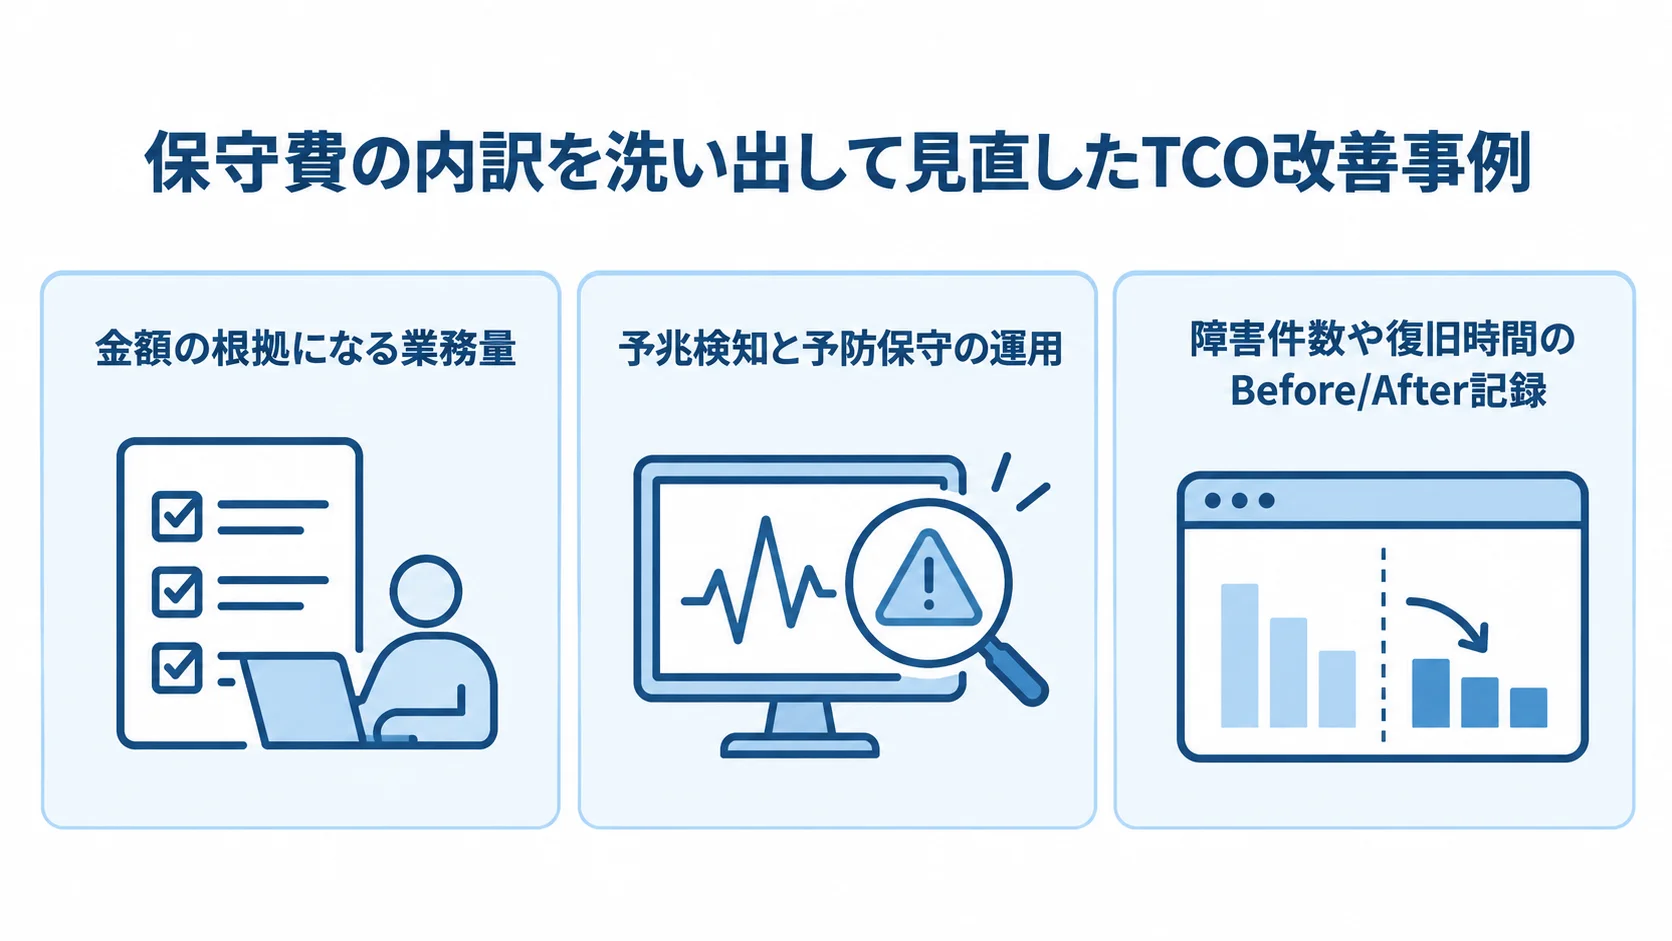
保守費の内訳を洗い出して見直したTCO改善事例
乗り換えに成功した企業に共通するのは、まず現行の保守費の内訳を分解し、見える形にしたことです。
維持管理費は一般に、定期保守が20〜30%、障害対応が25〜35%を占めます。ほかの内訳は、監視が15〜25%、問い合わせ対応が10〜20%、軽微改修が10〜15%、管理・報告が5〜10%という構成です(出典:ripla)。
こうした内訳を旧ベンダーに開示させると、「ほとんど障害が起きていないのに障害対応の比率が高い」「報告のための報告に費用がかかっている」といった、説明のつかないコストが浮かび上がってきます。
ある事例では、この内訳をもとに複数のベンダーへ相見積もりを取り、実際の障害発生頻度と監視範囲に見合う契約へ組み替えました。
大切なのは、単に安いベンダーへ替えることより、自社のシステムが今どれだけ手間を必要としているかを数字で把握し、その実態に合った契約を結び直す発想です。
- 金額の根拠になる業務量:障害発生頻度と監視範囲から見た、自社の手間の量
- 初報応答と復旧時間の目標:削減後も、むしろ厳しく設定し直す
この事例では、年間保守費を二割前後圧縮しています。
障害件数をBefore/Afterで減らした立て直し事例
費用を圧縮しつつ障害件数を減らせた事例には、ある共通点があります。それは、旧ベンダーが「障害が起きてから対応する」事後対応型だったのに対し、新しい体制では「障害が起きる前に芽を摘む」予防保守へ重心を移したことです。
たとえば、ディスク容量の枯渇や証明書の期限切れといった「起きると分かっている障害」は、起きる前に手を打つ運用へ切り替えています。
乗り換え前は月に数件の予期せぬ停止が起き、そのたびに緊急対応の追加費用がかかっていました。予防保守の導入後は、突発障害が月内でゼロに近づき、緊急対応のコストも目に見えて減りました。
維持管理は「何も起きないことに価値がある」という、成果の見えにくい仕事です。だからこそ、この立て直しはBefore/Afterを定量で示すと説得力が増します。また、見直しの効果を可視化することが、社内で維持管理の重要性を理解してもらうための土台になります。
立て直しの中身は、予兆の検知と効果の記録という二つの面から見ると分かりやすくなります。
- 予兆検知と予防保守の運用:ログの傾向分析やリソース逼迫の予兆を、標準業務に組み込む
- 障害件数や復旧時間のBefore/After記録:立て直しの前後で、同じ指標を並べて残す
ひとり情シスが委託で属人化から脱却した事例
中堅・中小企業のITシステム維持管理で、もっとも切実な課題が、いわゆる「ひとり情シス」への過度な依存です。
社内のシステム全般をたった一人の担当者が抱え、運用手順や障害対応のノウハウがその人の頭の中にだけ蓄積されている状態は、深刻なリスクをはらんでいます。その担当者が休んだり退職したりした瞬間に、事業が止まりかねないからです。
事例から学べるのは、この属人化を外部委託でどう解きほぐしたか、という具体的な手順です。
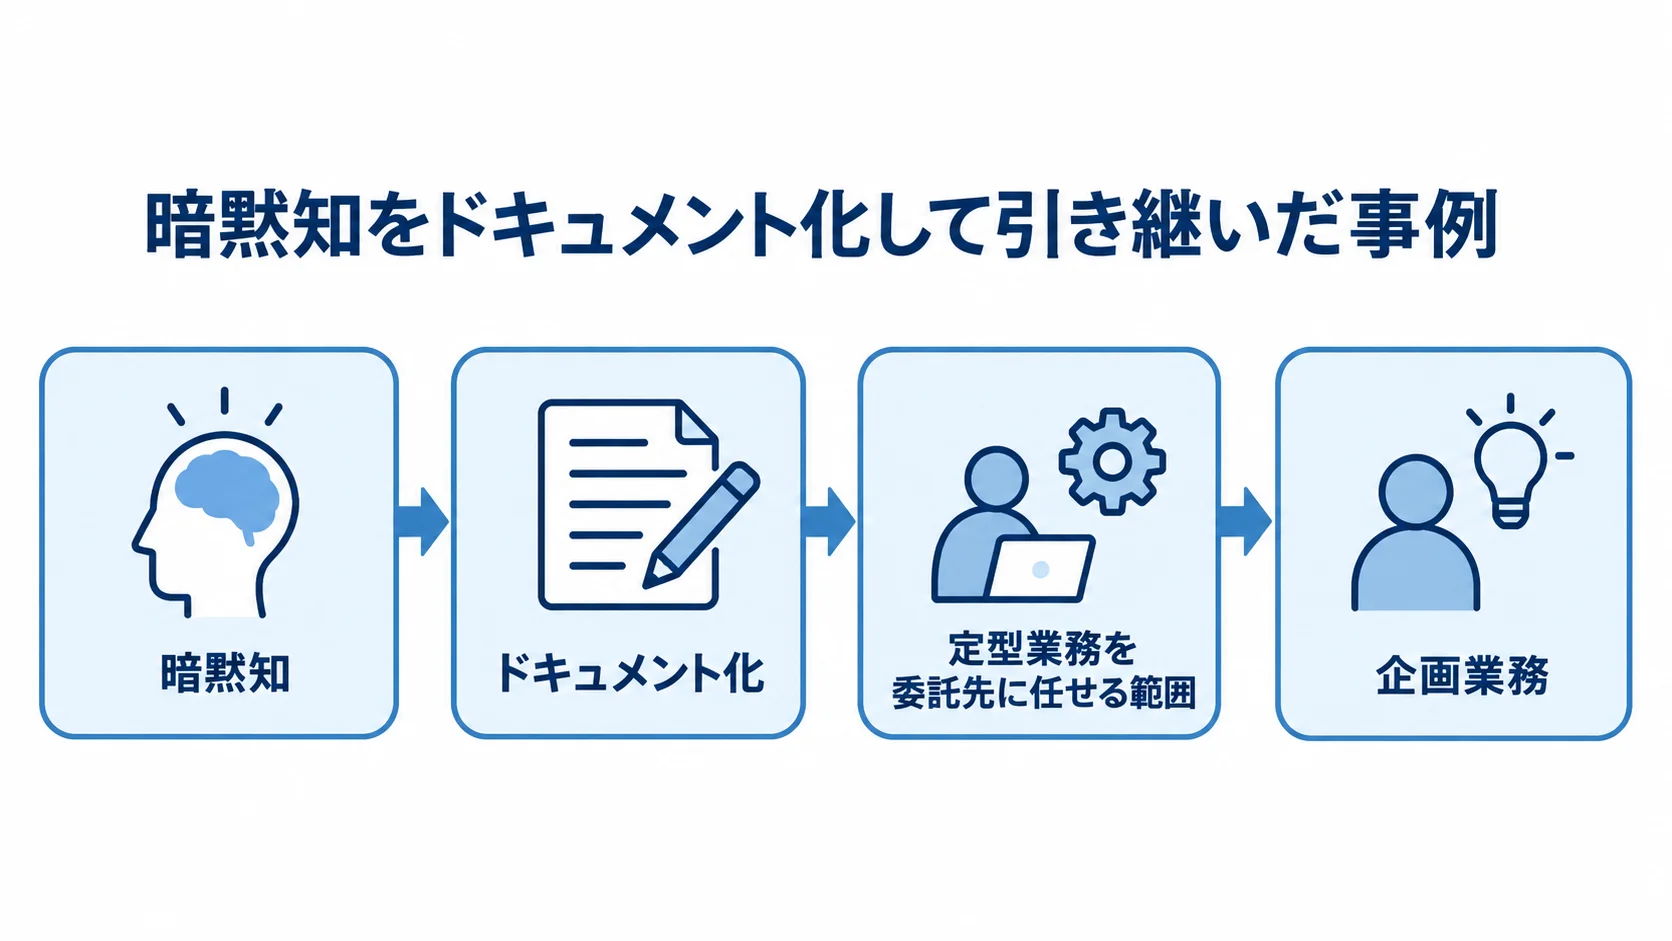
暗黙知をドキュメント化して引き継いだ事例
属人化からの脱却に成功した事例では、いきなり全業務を委託するのではなく、まず担当者の頭の中にあった暗黙知をドキュメント化する作業から着手しています。
委託先のエンジニアがヒアリングしながら整理することで、本人すら言語化できていなかった「いつもの勘どころ」まで形式知に変わっていきます。このドキュメント化の工程こそが、属人化解消の核心です。
委託に切り替えた後も、小規模であれば月額5〜15万円程度から始められるケースが多く(出典:ripla)、ひとりの担当者を雇い続けるコストと比べても十分に現実的です。さらに重要なのは、ドキュメントが残ることで、たとえ将来また委託先を替えることになっても、ゼロから引き継ぐ必要がなくなる点です。
属人化の解消とは、誰が担当しても同じ品質で運用できる状態を、ドキュメントとして自社に残すことです。特定の人への依存を特定のベンダーへの依存に置き換えるのは、属人化の解消とは別物です。
ドキュメント化を進めるときは、委託の範囲を広げる前に、暗黙知を社内に残す段取りを押さえておくことが大切です。
- 担当者の頭にある知識の書き起こし:運用手順を、第三者が読んでも再現できる形にする
- 委託先のヒアリングによる言語化:本人も言葉にできていなかった勘どころを、形式知にする
書き起こす対象は、サーバーの構成や定期メンテナンスの手順、過去の障害と対処法、ベンダーや回線業者の連絡先です。これらは運用手順書(ランブック)にまとめました。
担当者が本来の企画業務に回帰できた事例
外部委託の効果は、リスク低減のほかにもあります。定型業務を委託先に任せられると、ひとり情シスだった担当者が本来の企画的な仕事に時間を割けるようになります。
その時間を向けるのは、社内DXの推進や新しい業務システムの選定、データ活用の検討といった、付加価値の高い領域です。事例では、維持管理の現場対応に追われていた担当者が、経営層と並走してシステム戦略を描く役割へとシフトしていきました。
ここで肝心なのは、委託しても「丸投げ」にはしないことです。成功した企業は、委託先からの月次報告をきちんと読み込み、障害の傾向や改善提案について対話を続けています。
維持管理を外に出すとき、大切なのは責任を手放さないことです。委託先を社内の延長線上にあるチームとして扱い、自社のシステムを一緒に育てていく姿勢が、属人化脱却を一過性で終わらせない秘訣です。riplaも、フルスクラッチ受託と国内運用保守の立場から、作った後の継続的な伴走を重視しています。
委託後の変化を見るときは、担当者の時間がどこへ移ったかに注目するとよいでしょう。
- 定型業務を委託先へ任せる範囲:監視やバックアップ確認、問い合わせの一次対応など
- 月次報告をもとにした委託先との対話:障害の傾向や改善提案について、対話を続ける
クラウド・SaaS連携で責任分界点を整理した事例
近年のITシステムは、自社開発のアプリケーションが、クラウド基盤や複数の外部SaaSと連携して動いているのが当たり前になりました。
この構成は柔軟で拡張性が高い一方で、「どこで起きた障害を、誰が責任を持って直すのか」という責任分界点が曖昧になりやすいという、モダンな環境ならではの難しさを抱えています。
事例の中でも、この責任分界点の整理に正面から取り組んだケースは、これからのシステム維持管理を考えるうえで示唆に富みます。
クラウド側障害の責任を契約で線引きした事例
ある事例では、クラウド基盤側の大規模障害でシステムが停止した際、「これはベンダーの保守責任なのか、それともクラウド事業者の問題なのか」をめぐって、ユーザー企業と保守ベンダーの間で押し問答が起きました。
クラウド事業者側で発生した障害は、保守ベンダーがコントロールできる範囲の外にあります。ところが、契約上の線引きが曖昧だったため、復旧の主導権が誰にあるのか分からず、初動が遅れてしまったのです。
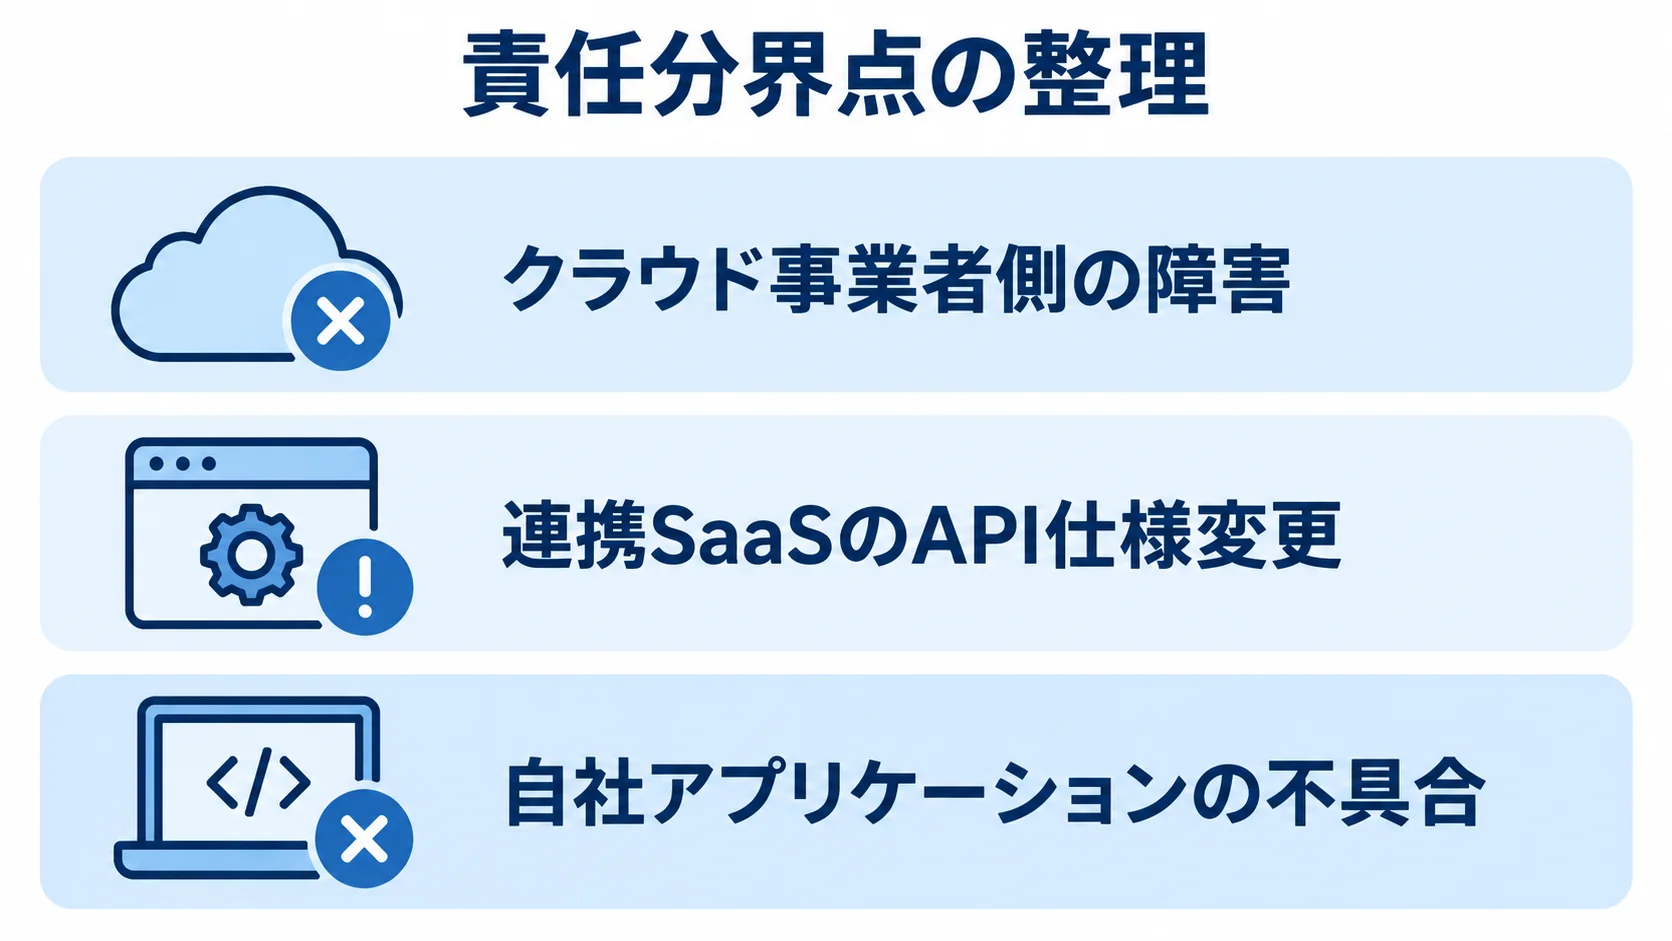
この経験を踏まえて立て直した企業は、維持管理契約を見直しました。障害の原因を、クラウド事業者側の障害、連携SaaSのAPI仕様変更、自社アプリケーションの不具合という三層に分け、それぞれの責任主体と対応フローを契約に明記したのです。
事例が教えるのは、モダンな環境では障害ゼロを保証することが不可能であり、だからこそ「障害が起きたときに誰が何をするか」を契約で定めておくことが決定的に重要だという点です。契約で責任を線引きするときは、障害の原因がどの層にあるかを先に分けておくと、対応の主導権が見えてきます。
- クラウド側の障害時の監視・報告と代替手段:障害の状況を監視して報告し、代替手段を講じる
- SaaSのAPI変更時の事前検知と改修見積もり:変更を事前に見つけ、改修の見積もりを提示する
コントロール外の事象についても、「何をどこまで責任を持つか」を具体化したのです。
監視自動化で運用負荷を下げた事例
責任分界点の整理と並んで、モダンな維持管理の事例で目立つのが、監視の自動化による運用負荷の軽減です。クラウドやSaaSが提供する監視機能とログの傾向分析を組み合わせた企業では、人が常時画面を見張る必要がなくなりました。
稼働率99.9%という目標は、月あたり約43分の停止しか許されない厳しい水準です(出典:ripla)。だからこそ、自動検知で異常の発見を早めることが、この水準を維持する土台になります。
ただし、事例からは注意点も読み取れます。監視を自動化するほど、アラートの「鳴りすぎ」が新たな課題になるからです。重要でない通知が大量に飛ぶと、本当に対応すべき重大なアラートが埋もれてしまいます。これがいわゆるアラート疲れです。
そこで、成功した企業は検知の閾値を運用しながら継続的に調整し、「対応が必要なアラートだけが上がる」状態へ磨き込んでいきました。自動化は導入して終わりではなく、運用の中で育てていくものだという視点が、ここでも大切になります。
監視を自動化するときは、通知を増やすことより、対応が必要な通知だけを残すことに重きを置くとよいでしょう。
- 予兆検知による自動アラートの仕組み:異常の予兆を自動で見つけ、アラートを上げる
- 閾値の継続的な調整:運用しながら基準を見直し、対応が必要な通知だけを残す
移管失敗から学ぶ引き継ぎの教訓事例
発注側がもっとも学べるのは、成功談よりも「なぜ移管に失敗したのか」というリアルな経験です。ITシステム維持管理のベンダー変更には、想定外の二重コストやドキュメント不足による引き継ぎ難航という、典型的な落とし穴が待っています。
この失敗から得られる教訓は、これから移管を検討する企業にとって何よりの保険になります。
二重コストとドキュメント不足で難航した事例
移管で苦しんだ事例の典型は、旧ベンダーとの契約をすぐに切れず、新ベンダーへの支払いと旧ベンダーへの支払いが一定期間重なる「二重コスト」が発生したケースです。
引き継ぎには通常、新ベンダーがシステムを理解するための調査期間が必要で、その間は旧ベンダーにも稼働を維持してもらわなければなりません。この移行期間を甘く見積もると、想定していなかった数か月分の保守費が二重にかかり、移管のコストメリットが吹き飛んでしまいます。
さらに深刻なのが、ドキュメント不足による引き継ぎの難航です。旧ベンダーが運用手順や設計情報をきちんと残しておらず、しかも非協力的だと、新ベンダーはソースコードや稼働中のシステムから手探りで仕様を読み解くしかなくなります。
失敗事例では、この解読作業に想定の何倍もの工数がかかりました。引き継ぎ期間が延び、さらに二重コストが膨らむという悪循環に陥ったのです。
維持管理の移管は、開発の発注以上に「相手の協力が前提」になるため、引き継ぎへの協力義務を契約に盛り込んでいなかったことが、後悔の最大の原因になったのです。
移管の失敗を防ぐには、旧契約をいつ終えるかと、引き継ぎの協力をどこまで契約に入れるかを押さえておくことが大切です。
- 旧契約の終了時期と移行期間の見積もり:二重コストが重ならないよう、切り替えの時期を先に見込む
- 引き継ぎ協力とドキュメント提供の義務:引き継ぎへの協力を、契約の条文として盛り込む
並行運用期間を設けて立て直した事例
同じ移管でも、計画的に進めて成功した事例があります。立て直しに成功した企業は、移管を一度に切り替えるのではなく、新旧両ベンダーが並行して関わる移行期間を意図的に設けました。
最初の数か月は、障害対応に同席して、ノウハウを実地で移転します。
その後は徐々に役割を入れ替え、最後に旧契約を終了します。
この事例が教えるのは、移管の成否が「現行ベンダーとの契約に、引き継ぎ協力とドキュメント提供の義務をどこまで明記してあるか」で大半が決まる、という冷徹な現実です。
乗り換えを将来の選択肢として残したいなら、最初の契約の段階で、契約終了時の資料引き渡しや後継ベンダーへの協力を条文化しておくことが、何よりの備えになります。
維持管理の事例は、華やかな成果より「どこでつまずき、どう備えれば防げたか」という視点で読むことが、自社の失敗を避ける最大の近道です。
移行の進め方は、主と従の役割をどの順で入れ替えるかを押さえると分かりやすくなります。
- 旧ベンダーが主、新ベンダーが従の期間:移行の前半で、障害対応の中心を旧ベンダーに置く
- 新ベンダーが単独で回せると確認できた段階:旧契約を終える判断の材料にする
まとめ
ITシステム維持管理の事例を振り返ると、四つの場面が見えてきます。ベンダー乗り換えによる保守費の見直し、ひとり情シスの属人化からの脱却、クラウド・SaaS時代の責任分界点の整理、移管失敗からの立て直しです。
四つの場面に共通する原則は、「維持管理の費用と業務量を数字で把握し、契約に責任範囲と引き継ぎ条件を明記したうえで、障害件数や復旧時間といった成果をBefore/Afterで記録する」という一点に尽きます。
年間保守費は開発費の15〜20%という目安があり、その内訳を分解すれば見直しの余地が見えてきます。事例を読むときに大切なのは、「いくら払っているか」だけでなく、「その費用で自社のシステムがどれだけ安定し、いざというときに誰が動くか」という視点です。
自社の規模と構成に照らして、まずは保守費の内訳を洗い出し、契約の責任分界点と引き継ぎ条件を点検するところから着手してください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、作った後も継続的に伴走しながら、属人化しない維持管理体制づくりを支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。