
ITシステム維持運用の事例は、保守費の圧縮、障害の削減、ひとり情シスの運用委託、保守移管の立て直しの4つに大きく分けられます。稼働後も毎月コストがかかり続けるため、近い事例は委託先選定や内製化の判断に役立ちます。
全体像を把握していない方は、まずITシステム維持運用の完全ガイドから読むのがおすすめです。
▼全体ガイドの記事
・ITシステム維持運用の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ベンダー乗り換えで年間保守費を圧縮した事例
ITシステム維持運用の事例で、経営層にもっとも響くのが「ベンダー乗り換えによる年間保守費の圧縮」です。
維持運用費は一度契約すると見直されないまま払い続けられることが多く、知らないうちに高止まりしているケースも珍しくありません。
年間保守費は開発費の15〜20%が一つの目安とされます(出典:ripla)。特に、内訳が不透明なまま割高な金額を払い続けている企業ほど、乗り換えで大きな改善余地が生まれます。
保守費の内訳を可視化して割高分を削った事例
乗り換えに成功した企業がまず行ったのは、現行の保守費が何にいくら使われているかを洗い出すことです。
維持運用費の内訳は、定期保守が20〜30%、監視が15〜25%、障害対応が25〜35%を占めるのが一般的です。また、問い合わせ対応は10〜20%、軽微改修は10〜15%、管理報告は5〜10%です(出典:ripla)。
事例では、必要な監視と障害対応だけに絞った契約へ組み替えたことで、年間保守費を3割前後圧縮しています。値引きを求めるより先に、「何にいくら払うか」を内訳ベースで再設計することが大切です。
内訳の確認では、旧ベンダーとの交渉の前に、費目ごとの金額をそろえておきます。
- 費目ごとの開示:旧ベンダーに出させる保守費の内訳
- 割高な費目:実態に合わず、交渉材料にできる費目
ある事例では、内訳を確認したところ、実際にはほとんど発生していない障害対応の待機要員費が大きな割合を占めていた、というケースが見られます。
年に数回しか障害が起きないシステムに、常時待機の人月単価60万〜150万円分が固定で計上されていれば、その費目の妥当性を問い直せます(出典:ripla)。
乗り換え前後のTCOをBefore/Afterで比較した事例
乗り換えの判断で見落とされやすいのが、移管そのものにかかる一時コストです。新旧ベンダーが並行稼働する期間の二重コストや、ドキュメント整備、引き継ぎ工数がこれに当たります。
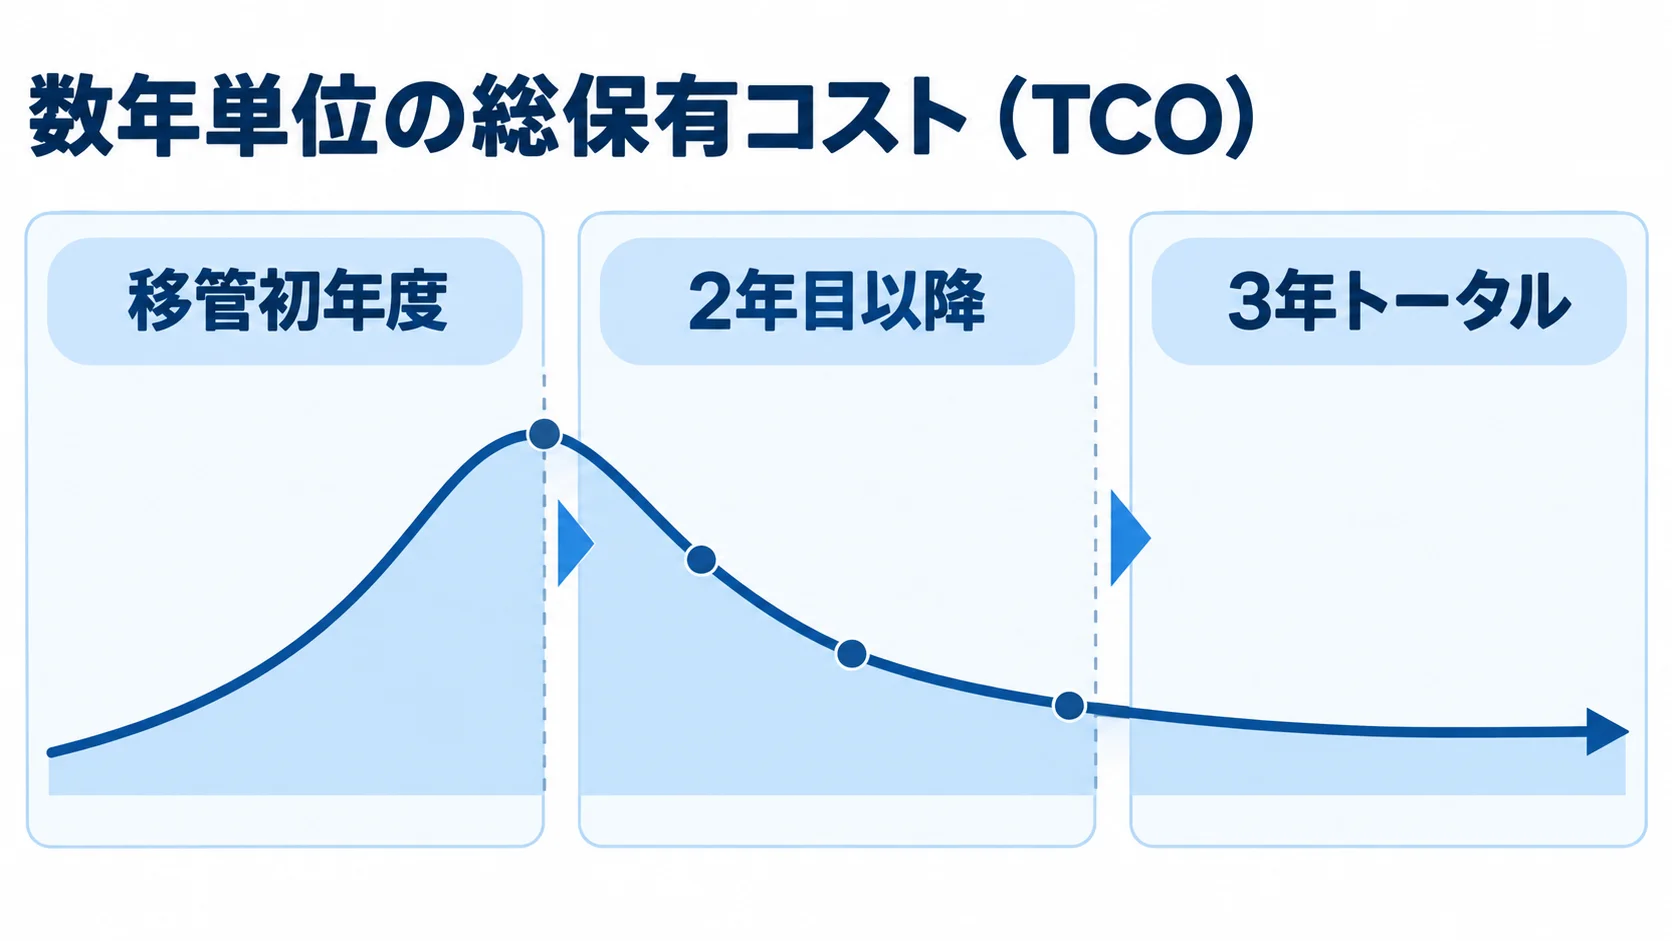
数年単位の総保有コスト(TCO)で比べないと、目先の月額が下がっても結果的に高くつくことがあります。前節で見た年間保守費の圧縮も、移管の一時費用を含めて確かめる必要があります。
成功事例では、移管初年度は一時費用でTCOが膨らむものの、2年目以降の月額削減でそれを回収し、3年トータルでは大幅にコストが下がるという見取り図を最初に描いています。
規模別の月額相場(小5〜15万、中15〜50万、大50〜200万以上)を基準に、自社のシステム規模に対して現行費用が妥当かを照らすことも有効です(出典:ripla)。
中規模システムなのに大規模相当の保守費を払っていれば、それ自体が乗り換えを検討するサインになります。事例から学べるのは、「いくら安くなったか」を月額だけで語らず、移管コストを含めた数年のTCOで評価することが、経営判断として適切だという点です。
比較では、月額の数字と移管にかかる費用を分けて並べます。
- 一時コスト:並行稼働の二重コストや引き継ぎ工数を、比較の対象に含める
- 回収までの期間:移管初年度の費用を、月額の削減で何年目に取り戻せるかを見る
障害件数をBefore/Afterで削減した監視強化の事例
維持運用の成果としてもっとも経営に伝わりやすいのが、障害件数と障害影響の削減です。
多くの企業では、障害が起きてから対応する「事後対応型」の運用になっており、ユーザーからの問い合わせで初めて障害に気づく状態が常態化しています。これを監視強化で「予兆検知型」に転換すると、障害件数そのものと、障害発生時の影響範囲を小さくできます。
予兆検知で重大障害を未然に防いだ事例
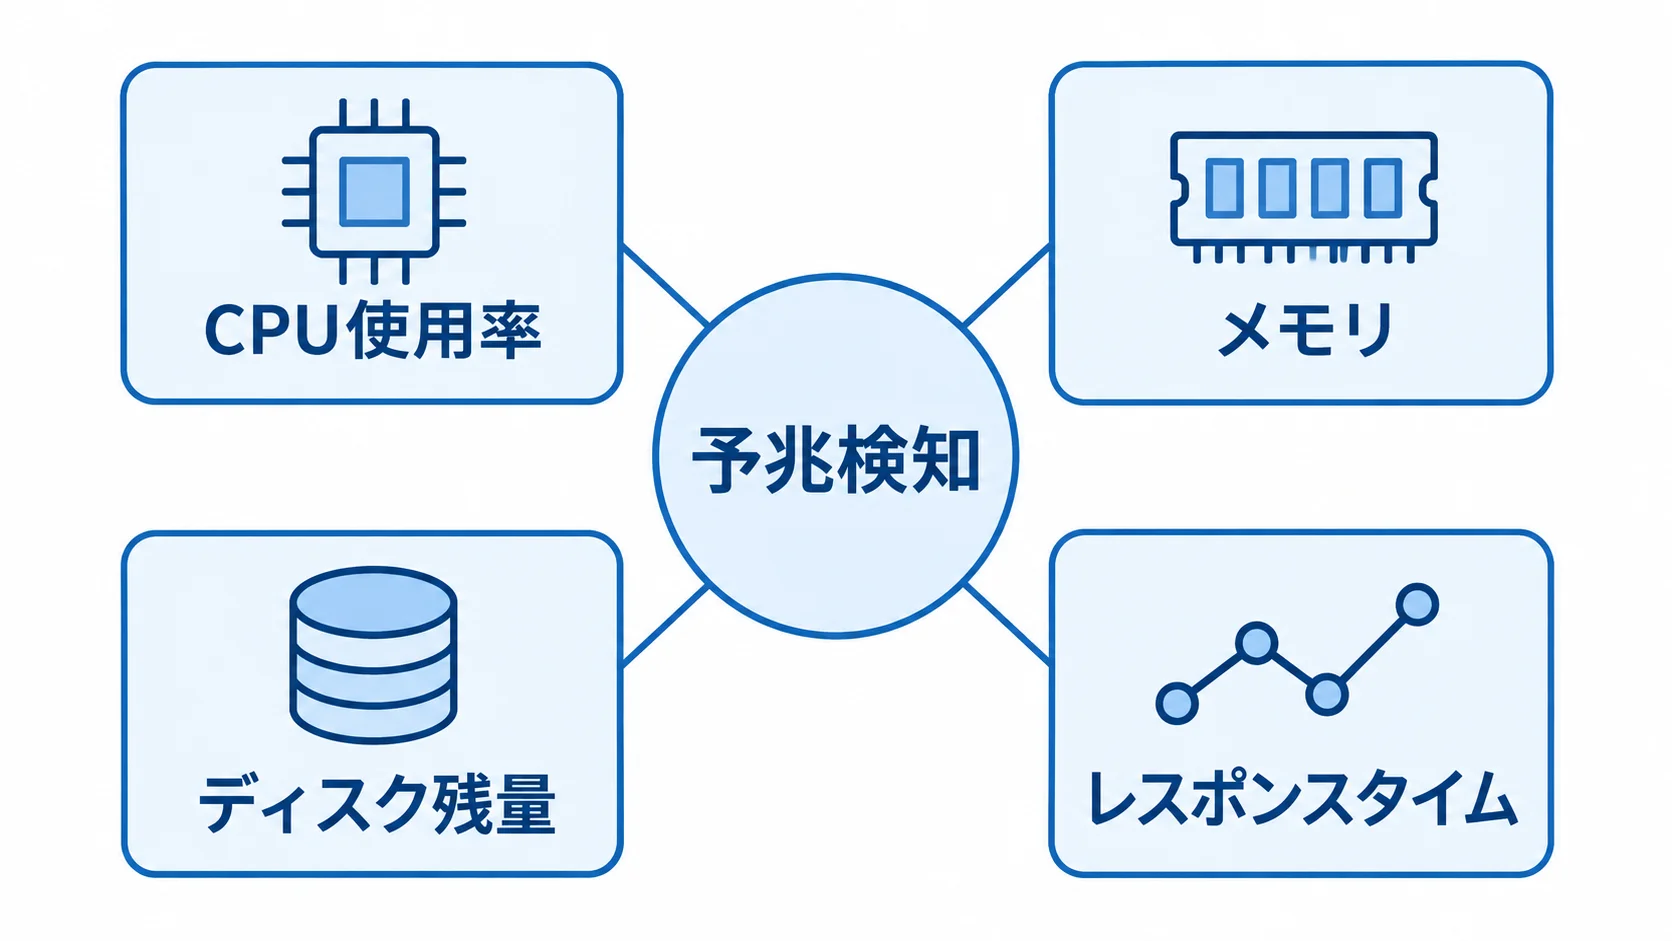
監視強化に成功した事例では、CPU使用率やメモリ、ディスク残量といった指標に閾値を設けています。レスポンスタイムも閾値の対象で、異常の兆候を障害に至る前に検知する仕組みを整えています。
ディスク残量が一定を下回った段階でアラートを上げ、業務時間外に増設対応を行えば、満杯によるサービス停止という重大障害を未然に防げます。
事後対応では数時間のサービス停止になっていた事象が、予兆検知によってユーザーに気づかれることなく解消されます。
近年は、こうした監視に機械学習を組み合わせ、平常時の挙動から外れた異常を自動で検知するAIOps的なアプローチも広がっています。国内のITインフラサービス市場は、2024年の2兆2,685億円から2029年に3兆674億円へ、年平均6.2%で成長すると見込まれています(出典:IDC)。
また、監視・運用の高度化への投資は、市場全体でも拡大傾向にあります。事例が示すのは、監視は単なるコストではなく、重大障害による事業損失を防ぐ役割を果たすという点です。
監視を組むときは、閾値を置く指標と、アラート後に誰がどう動くかを決めておきます。
- 指標と閾値:CPU使用率やメモリなどの指標ごとに、アラートを上げる値を決めること
- 対応の時間帯:アラート後に業務時間外も含めて、対応を担う人と時間帯
SLAを定量管理して稼働率を改善した事例
障害削減の効果を「感覚」ではなく「数字」で語れるようにしたのが、SLA(サービス品質保証)の定量管理を導入した事例です。監視強化で障害そのものを減らし、SLAで水準を継続して確かめるという組み合わせが、削減の効果を続けるための土台になります。
SLAを設定した事例の効果は、数字の改善だけにとどまりません。稼働率や応答時間が見えるようになると、ベンダーと発注側が同じ指標を見ながら改善を議論でき、運用の質をめぐる水掛け論がなくなります。さらに、月次の障害件数と平均復旧時間をBefore/Afterで並べて経営に報告できる体制が整えば、維持運用への投資が「なぜ必要か」を説明しやすくなります。
SLAの目標は、稼働率と復旧の時間を、報告で追える形で並べて決めます。
- 目標の数字:稼働率、初報応答、復旧のそれぞれに、目標値を置くこと
- 月次の報告:障害件数と平均復旧時間を、Before/Afterで並べた資料
稼働率は99.9%(月43分の停止まで許容)、初報応答は重大障害で15分以内、通常で2時間以内です。
復旧は重大障害で4時間以内、通常で8時間以内と契約に明記し、約束した水準が保たれているかを毎月の報告で客観的に確認できます(出典:ripla)。
ひとり情シスが運用サポートを委託した事例
中堅・中小企業の維持運用で典型的な悩みが、情報システム部門が一人、あるいは数人で複数システムを抱える「ひとり情シス」問題です。日々の問い合わせ対応や障害対応に追われ、本来やるべき戦略的なIT企画に時間を割けない状態に陥りがちです。
この負荷を外部の運用サポートに委託し、属人化を解消しつつ担当者を本来業務に戻した活用事例が増えています。
属人化したシステムを委託で標準化した事例
ひとり情シスの最大のリスクは、システムの知識がその担当者の頭の中だけにある「属人化」です。担当者が休職や退職をすれば、誰も運用できなくなり、事業が止まりかねません。
委託に踏み切った事例では、まず外部のサポート事業者と一緒に運用手順書や構成情報を整備し、暗黙知を文書として外に出すところから始めています。
サービス委託の相場は月20万〜50万円程度とされます(出典:ripla)。一人分の人件費を抱え続けるより、必要な範囲を委託して運用を安定させる、という判断です。
標準化が進めば、問い合わせ対応や定型作業を外部に任せられ、担当者は判断が必要な業務に集中できます。ただし、丸投げにせず「何を委託し、何を社内に残すか」を切り分けることが欠かせません。
委託の範囲は、担当者の作業を業務ごとに書き出してから決めます。
- 委託する業務:日常の一次対応と、ルーティンの運用
- 社内に残す業務:システムの方針判断と、ベンダーとの調整
事例では、この役割分担によって、属人化の解消とコントロールの維持を両立させています。
担当者を戦略業務に戻して成果を出した事例
運用サポートを委託した効果は、コスト面だけでなく、社内の人材の使い方に現れます。これまで日々の運用に追われていた情シス担当者が、DX推進や新システムの企画、業務改善といった付加価値の高い仕事に時間を使えるようになります。委託の意味は、コストの削減だけでなく、人材を再配置して新たな価値を生む点にもあります。
JUASの2025年の調査では、IT予算を増額する企業が49.5%にのぼります(出典:JUAS)。さらに、攻めのIT投資が求められるなかで、限られた社内人材を運用の守りに張り付けておく余裕は、多くの企業にありません。
委託の効果は、担当者の時間配分がどう変わったかで確かめます。
- 運用に取られていた時間:問い合わせや障害対応に費やしていた時間の減り具合
- 企画業務に充てた時間:DX推進や新システムの企画、業務改善に回せた時間
保守移管の失敗から立て直した事例
事例で発注側がもっとも学べるのは、成功談よりも、「なぜつまずいたのか」「どう立て直したのか」という生々しい実情です。維持運用では、ベンダーを変える保守移管でつまずき、サービス品質が一時的に悪化するという苦い経験をした企業が少なくありません。
この失敗から得られる教訓は、これから移管を考える企業にとって何よりの備えになります。
ドキュメント不足で引き継ぎが難航した事例
保守移管がつまずく最大の要因は、ドキュメントの不足です。旧ベンダーが残した設計書や運用手順書が古い、あるいはそもそも存在せず、システムの仕様が現行ベンダーの担当者の経験にしか残っていない、というケースが頻発します。
失敗事例では、移管を急ぐあまり現行システムを十分に洗い出さないまま新ベンダーへ引き継ぎ、いざ障害が起きたときに誰も原因を特定できず、復旧が長期化しました。
この事例で立て直しの起点になったのは、移管スケジュールをいったん止め、現行システムのドキュメント整備を仕切り直したことです。
新旧ベンダーが並行稼働する期間を設け、その間に旧ベンダーの知見を運用手順書や障害対応マニュアルとして文書にまとめました。さらに、新ベンダーは旧ベンダーの監修のもとで、実際の障害対応を経験しています。
この丁寧な引き継ぎ期間を確保したことで、移管後の品質低下を最小限に抑えられました。移管は「契約を切り替える」作業ではなく「知識を移転する」プロジェクトだという認識が、立て直しの鍵でした。
引き継ぎの前には、旧ベンダーの資料がどこまで残っているかを確かめておきます。
- 資料の残り具合:設計書や運用手順書の鮮度と、存在の有無
- 引き継ぎの期間:並行稼働の中で、旧ベンダーの知見を文書にまとめる時間
並行稼働期間を設けて段階移行した事例
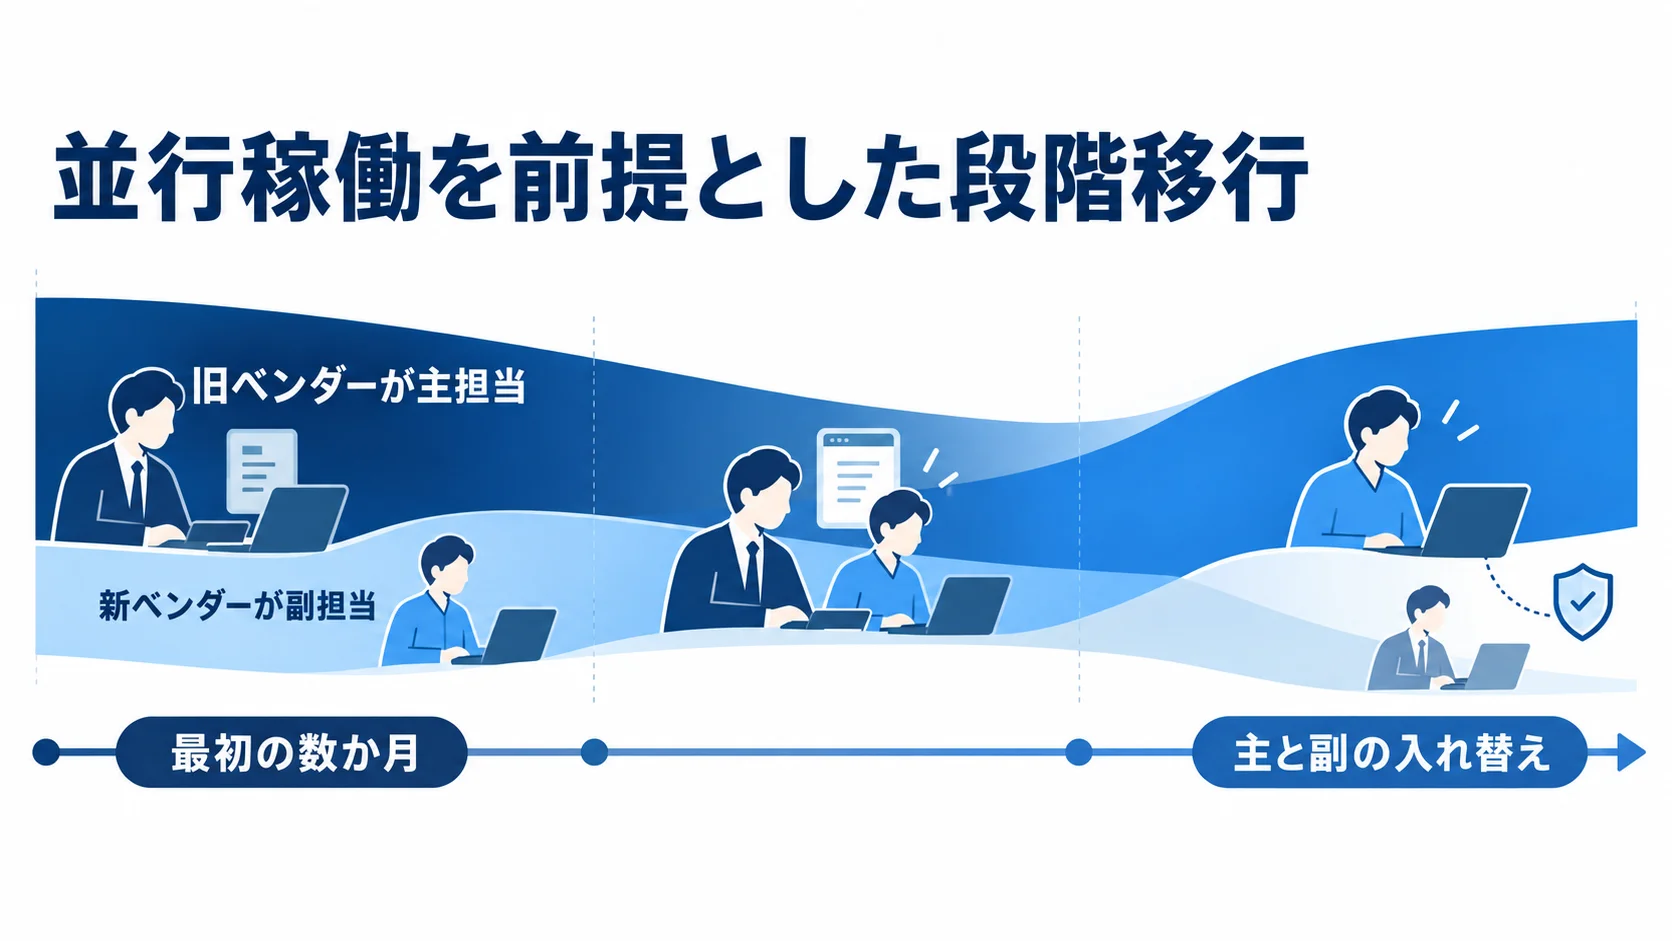
立て直しに成功した企業に共通するのは、一気に切り替えるのではなく、並行稼働を前提とした段階移行を選んだことです。最初の数か月は旧ベンダーが主担当、新ベンダーが副担当として障害対応に同席し、徐々に主従を入れ替えていきます。
この移行方式では知識の空白期間が生まれにくく、万一、新ベンダーが対応しきれない事象が起きても、旧ベンダーがフォローできます。
段階移行には、新旧ベンダーへの二重支払いという一時コストが発生します。しかし、失敗事例の教訓を踏まえれば、この二重コストは「移管リスクを下げるための必要経費」と割り切るべきです。
移管を急いで品質を落とし、障害対応に追われてかえって余計な費用がかかった企業と比べれば、計画的な並行稼働のほうが結果的に安く済みます。
事例が教えるのは、保守移管の成否は「いかに速く切り替えるか」ではなく「いかに知識を欠落なく移すか」で決まるという原則です。
段階移行は、主担当の交代の時期と、二重支払いの扱いを前もって計画に入れます。
- 主と副の入れ替え:どの段階で誰を主担当に移すかを決めておくこと
- 二重コストの扱い:一時的な二重支払いを、移管の備えとして予算に組み込むこと
まとめ
ITシステム維持運用の事例を振り返ると、成功も失敗からの回復も、結局は「保守費の内訳を洗い出し、障害削減やSLAという定量指標で効果を語り、知識の移転を欠かさない」という一点に集まります。
ベンダー乗り換えでは内訳を組み直して年間保守費を圧縮でき、監視強化と予兆検知によって障害件数をBefore/Afterで縮小できます。また、ひとり情シスの運用サポート委託は属人化を解消し、人材を戦略業務に戻します。一方で、ドキュメント不足のまま急いだ保守移管は品質悪化を招き、並行稼働による段階移行が立て直しの鍵になりました。
事例を読むときに大切なのは、「いくら削減したか」だけでなく「なぜ運用品質が維持・改善できたのか」という視点です。自社のシステム規模と運用実態に照らし、まずは保守費の内訳を洗い出すことや、監視指標を整えることなど、効果を測りやすいところから一歩を踏み出してください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、作った後も継続して伴走する維持運用を一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。