
ITシステムアラート対応は、監視対象の洗い出し、しきい値と通知経路の設計、本番後の調整の順に進めると、実運用に耐える通知につながります。期間は、準備・構築が1〜3ヶ月、本番後の調整が3〜6ヶ月が目安です。監視対象の規模や監視ツールの種類によっても変わります。
▼全体ガイドの記事
・ITシステムアラート対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステムアラート対応(しきい値設計・通知経路設計)の開発期間の全体像
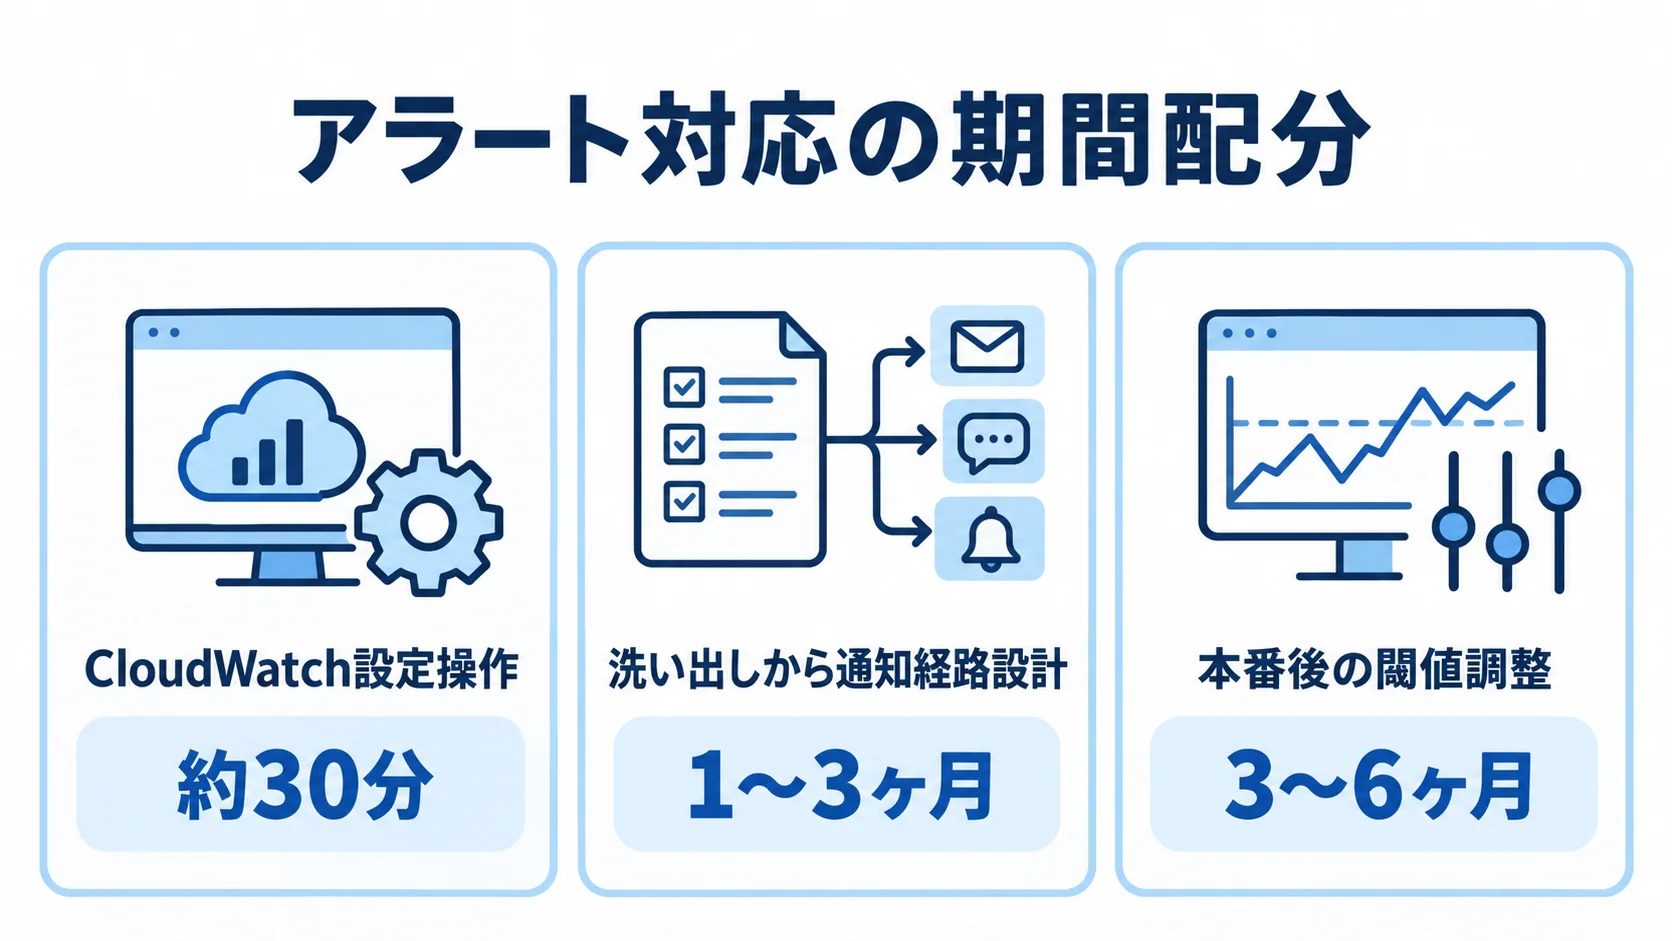
経済産業省「DXレポート」によると、日本企業のIT関連費用の8割以上は既存システムの運用保守に充てられています。アラート対応は、ツール導入や受信後の当番体制・エスカレーション構築とは異なり、通知の要否と届け先・経路を決めて整える技術実務です。
しきい値設計、誤検知削減、通知経路設計は、監視ツールの初期構築とは分けて期間を考えます。AWS環境ではCloudWatchの設定操作のみで約30分、OpManagerはインストールから最短10分で完了する場合があります。ただし、それはツールが動き出すまでの時間です。
準備・構築は、監視対象の洗い出しから通知経路設計まで1〜3ヶ月が目安です。また、本番後は実際のインシデントを通じた閾値調整に3〜6ヶ月を見込みます。
業務影響に応じてアラートを過不足なく届けるには、設計が実運用に耐える状態になるまで、別途まとまった期間が必要です。監視体制があっても、しきい値や通知経路の設計が不十分なら通知が形骸化し、重大な異常を見逃すリスクがあります。
監視対象規模・チューニング範囲別の期間目安
期間は、監視対象の規模だけでなく、しきい値をどこまで精緻に調整するかによっても変わります。
- 小規模:Zabbixの設定ファイルを手作業で書いた事例では、約1週間かかりました。
- 中規模:構成が標準的なら、洗い出しから通知経路の初期設計まで1〜3ヶ月程度です。
- 大規模・複雑:対象が多く、項目ごとに個別のしきい値ロジックが必要な場合は、3ヶ月以上かかることもあります。
ツールを導入する速さと、アラート設計が現場で機能するまでの速さは別です。そのため、期間は両者を分けて組み立てる必要があります。
期間を左右する3つの要因
同じ標準規模でも、監視範囲や設計の細かさによって期間に差が出ます。特に影響するのは、次の要因です。
- 監視対象範囲:CPUやメモリ、全ポートのトラフィックを最初から対象にすると、設定作業が膨らみます。
- しきい値の精緻さ:二値判定は単純ですが、業務影響に応じて警告・軽度・重度の段階を設けると、水準や対応方針の合意に時間がかかります。
- 通知経路:メールのみの場合より、深刻度別のSlack・電話自動音声・SMSや代替経路を設計する場合のほうが、検証工数は増えます。
工程別スケジュールと期間配分
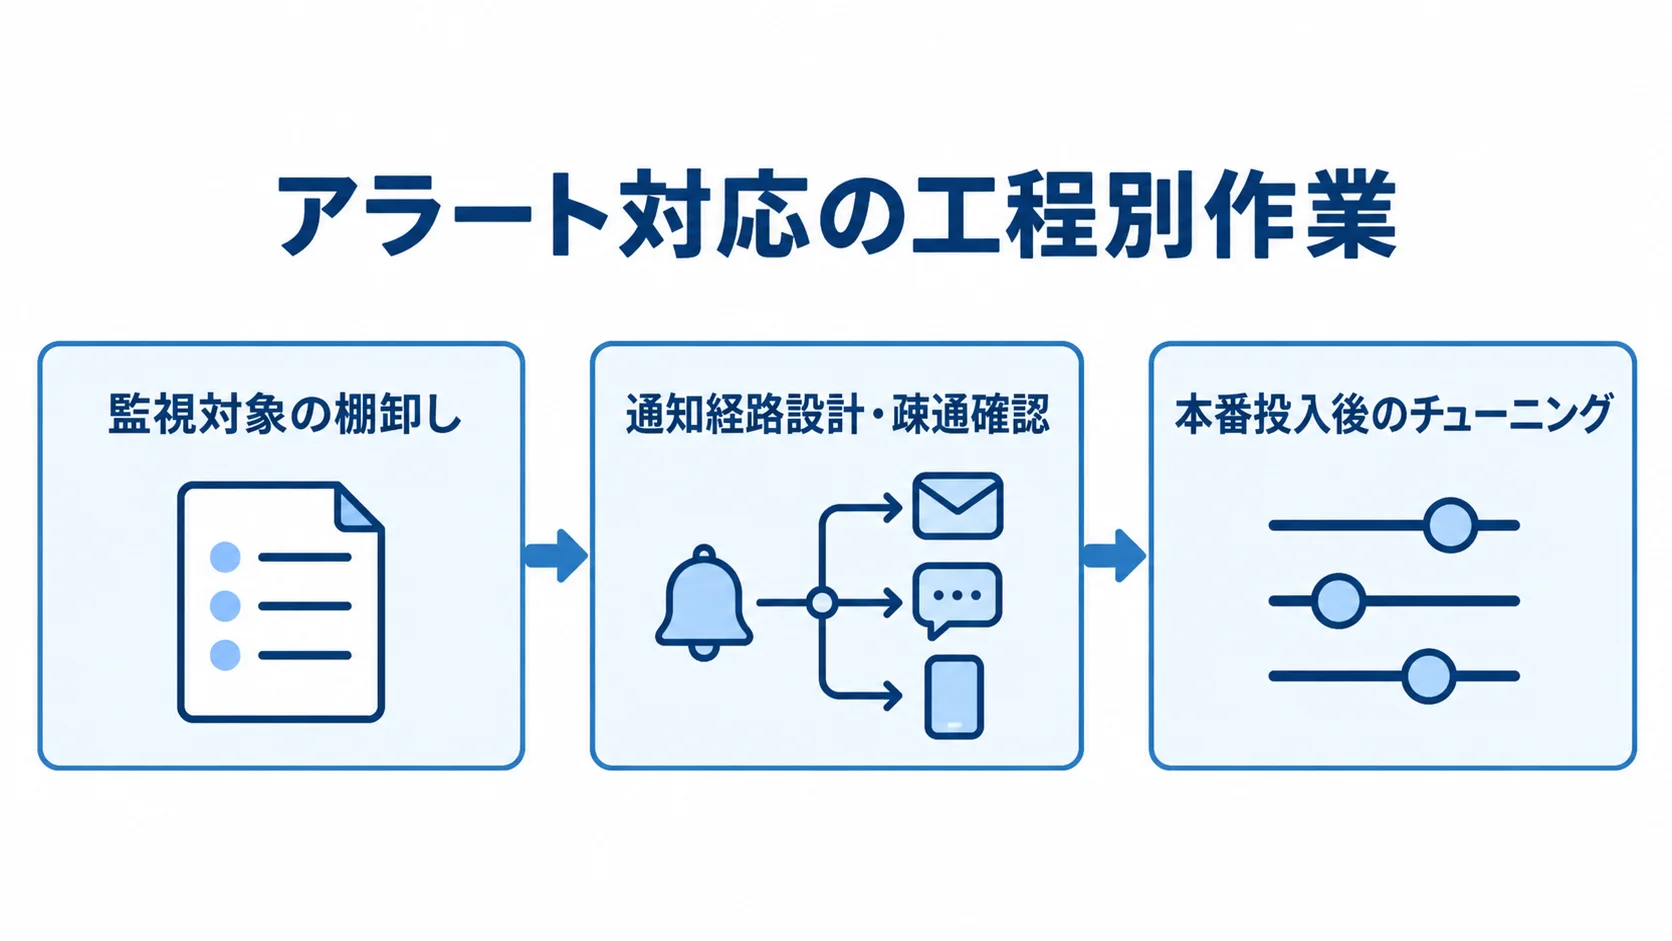
アラート対応は、監視対象の洗い出しとしきい値の初期設計、通知経路設計と疎通確認、本番後のチューニングの3段階で進みます。各工程で何が確定するかを把握しておくと、遅れの原因を早く見つけられます。
監視対象の棚卸しとしきい値の初期設計フェーズ
まず、業務影響に応じて監視対象を絞り込みます。そのうえで、段階的な複数のしきい値を設計します。
- 監視対象:業務影響の大きい機器を優先し、死活監視(Ping監視)などを設定します。
- Load Average:二値判定ではなく、「4以上で警告」「8以上で軽度障害」「12以上で重度障害」とする例があります。
- ディスク・inode使用量:「80%」「90%」「95%」を境に、深刻度別に通知レベルを分けます。
この工程は、数週間〜1ヶ月程度を見込むのが現実的です。なお、既存の運用実績や過去の障害履歴の有無によって、期間は変わります。
通知経路設計・疎通確認フェーズ
しきい値の初期設計と並行して、通知経路を設計します。次に、疎通確認の段階へ進みます。
- 通知経路:深刻度や時間帯に応じ、メールとSlack・Teams・LINE WORKSに加えて、電話自動音声やSMSを使い分けます。
- 疎通テスト:LANケーブルを抜くなどして障害を再現し、指定した経路に通知が届くかを確かめます。
- 応答がない場合:一定時間後に別経路や次の担当者へ自動で切り替わる、フェイルセーフの検証です。
通知条件の分岐が複雑になるほど、設定ミスが増えます。さらに、重要なアラートが届かないまま、障害の発見が数時間遅れるおそれがあります。そのため、疎通確認には十分な時間を確保しておきます。
本番投入後のチューニング期間(ハイパーケア)
本番直後は、想定外の誤検知が多く出るのが通例です。そのため、デフォルトの設定のままにせず、アラートを一件ずつ検証しながら調整を続けます。誤検知を減らすには、通知が出る条件そのものを見直します。
- 継続時間:一瞬のスパイクを無視し、「CPU使用率80%で通知」を「5分間継続したら通知」に変えます。
- 状態変化:異常のたびに知らせる継続通知を、異常から正常へ変化した時点の通知に切り替えます。
季節性のある業務処理を一巡させるため、調整期間は最低1ヶ月、標準的には3〜6ヶ月程度を確保します。この期間は、実効性のある設計を完成させるために使います。
監視ツールの種類によるスケジュールの違い
監視ツールをSaaS型で使うか、OSS(オープンソース)で自社構築するかによって、初期構築の期間は大きく変わります。現実的な予定を立てるには、提供形態ごとの違いを押さえておく必要があります。
SaaS型ツール(Datadog、CloudWatch、Mackerel等)の場合
Datadog、CloudWatch、Mackerelなどのクラウド型サービスは、サーバーを用意せずにGUIから直感的に設定できます。そのため、初期構築も短時間で完了します。
- CloudWatch:AWS環境なら、設定操作のみで約30分です。
- Mackerel:有料機能をすべて無料で2週間試せるトライアルがあり、小さく始めて調整できます。
ツールが動くまでの期間と、アラート設計が機能するまでの期間は、分けて考えます。初期構築が早くても、しきい値や通知経路の設計が実運用に耐えるとは限りません。SaaS型であっても、疎通確認と本番後の調整は必要です。
OSS(Zabbix等)で自社構築する場合
ZabbixなどのOSSで自社構築する場合は、作業を担う人の知識によって期間が大きく変わります。
- 費用と作業:ライセンス費用は無料ですが、設定ファイルの記述や監視項目の実装は手作業になります。
- 初期構築:小規模でも通知実装まで約1週間かかった事例があり、SaaS型より長くなる傾向があります。
- 必要な知識:細かな条件分岐には、正規表現などの専門知識が要ります。
インフラ運用の経験が浅いメンバーだけで進めると、変更のたびに動作確認とエスカレーションが発生し、想定以上に時間がかかることがあります。
納期を優先するならSaaS型、自社の監視要件に合う基盤を重視するならOSS自社構築が、選ぶときの基準になります。
納期を短縮する具体的な方法
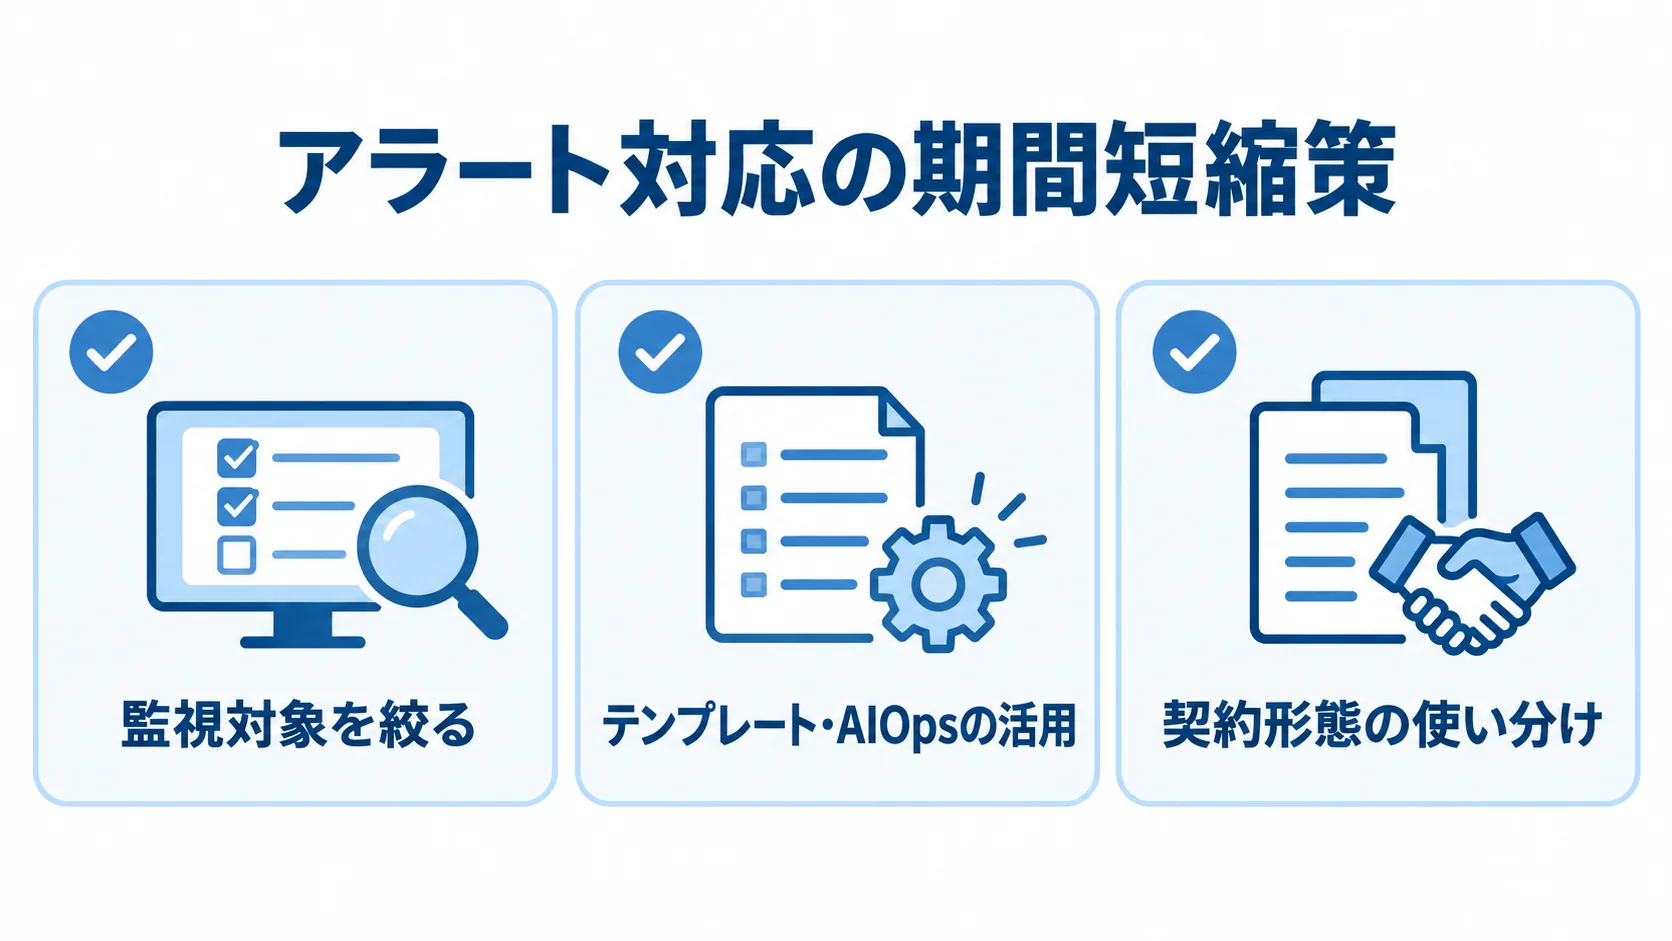
アラート対応の立ち上げ期間は、実践的な工夫によって短縮できます。
スモールスタートと段階的なしきい値設計
監視対象としきい値を小さく始め、運用が安定してから、アラートの状況を見ながら範囲を広げていく方法です。
- 監視対象を絞る:CPU・メモリ・全ポートなどを初めから監視すると、設定作業が膨らみ、導入が延びる最大の原因になります。
- 影響の大きい機器から始める:死活監視から着手し、安定後は運用しながら対象としきい値を広げます。
- しきい値は段階的に増やす:完璧を求めず警告・重度障害の2段階で始め、アラートの状況を見て追加することで、初期工数を抑えます。
テンプレートの活用と契約形態の使い分け
テンプレートやAIOps、工程に応じた契約形態を使い分けることで、設計工数や手戻りを抑えられます。
- 標準の設定:SaaS型の通知テンプレートやしきい値プリセットを使えば、条件設計を一から行わずに済み、通知経路の設計期間を短縮できます。
- AIOps:一部に導入し、AIがログやメトリクスを学習して、不要なアラートを自動で抑制します。
- 契約形態:未確定の洗い出し・初期設計は準委任、仕様確定後の実装・疎通確認は請負にし、手戻りを抑えて計画を進めます。
監視対象が多い環境では、手動でのしきい値調整が大きな工数になります。そのため、調整の手作業を減らせば、導入期間の短縮が見込めます。
納期遅延の典型要因と対策
綿密に計画しても、立ち上げには遅延のリスクが残ります。そこで、起こりやすい要因を把握し、対策を設計プロセスに組み込んでおきます。
通知条件の複雑化による設計工数の膨張
よくある遅延要因は、誰に、どの経路で、いつ届けるかという通知条件を、最初から複雑に設計してしまうことです。全システムと全深刻度に個別のルールを作ると、条件が増えて設計に時間がかかります。
複雑な分岐は設定ミスも招きます。さらに、重要なエラーログが通知されず、障害の発見が数時間遅れるおそれがあります。
まずは小さくシンプルに始めるのが有効です。基本のパターンを先に決め、運用しながら例外のルールを足していくと、手戻りを減らせます。
しきい値未調整のまま本番投入するリスク
納期を優先して、しきい値が不十分なまま本番に投入することも、遅延の要因になります。デフォルトの設定のままだと、一瞬のスパイクにも反応して誤検知が多発することがあります。
当番担当者がアラート疲れを起こし、重要な通知を見逃したり通知をミュートしたりするおそれもあります。その結果、後から緊急で閾値を調整することになり、全体の予定が後ろ倒しになります。
本番後の調整期間は、削る対象ではなく、実効性を保つための必須の工程です。最低1ヶ月、標準的には3〜6ヶ月を、計画の段階から予定に組み込んでおきます。
まとめ
ITシステムアラート対応では、ツールの初期構築と、設計が実運用に耐えるまでの期間を分けて考えます。ツールは数十分〜1週間程度で動き出す場合がありますが、監視対象の洗い出しから通知経路設計・疎通確認までは、1〜3ヶ月が標準的な目安です。
本番後は、実際のインシデントを通じて閾値を調整します。この期間(ハイパーケア)は、3〜6ヶ月が目安です。
SaaS型は早く稼働できますが、OSS自社構築は専門知識を持つエンジニアの工数を要し、リードタイムが長くなる傾向があります。納期を短縮するには、監視項目としきい値を絞るスモールスタート、通知テンプレート、AIOpsの一部導入が有効です。
通知条件の複雑化や、未調整のままの本番投入も遅延の要因になります。そのため、これらへの対策も計画に含めておくことが大切です。
具体的な予定を相談するときは、現状のシステム構成と求める通知精度を示したうえで、複数の開発会社や監視サービス会社に見積もりを依頼することから始めます。
▼全体ガイドの記事
・ITシステムアラート対応の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。