
ITシステムアラート対応のPoCは、対象を絞って通知経路を確かめ、実データでしきい値を調整する順に進めます。過不足のない検知と本番展開の判断につなげるためです。
しきい値や通知経路は、本番に入れると簡単にはやり直せません。厳しすぎると些細な変動でも通知が増え、当番担当者の疲弊や「アラート疲れ」を招きます。緩すぎれば、重大な異常を見逃すリスクが高まります。
▼全体ガイドの記事
・ITシステムアラート対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステムアラート対応のPoC・試験チューニングの定義
しきい値・通知経路設計のPoCは、全システムへ本格適用する前に、対象を絞った環境でアラートを発生させる検証です。大きなトラブルを防ぎつつ、通知の実用性を確かめます。
ツールが正常に動くかだけでなく、閾値を超えたときに指定の経路へ正しく過不足なく届くかも確認します。特に、アラート設計全体のロジックを対象にする点が、通常のシステム開発のPoCとの違いです。
最初からCPU、メモリ、全ポートのトラフィックまで監視すると、設定作業が膨大になり、挫折するおそれがあります。そこで、「止まったら業務停止になる機器」などに絞るスモールスタートが基本です。
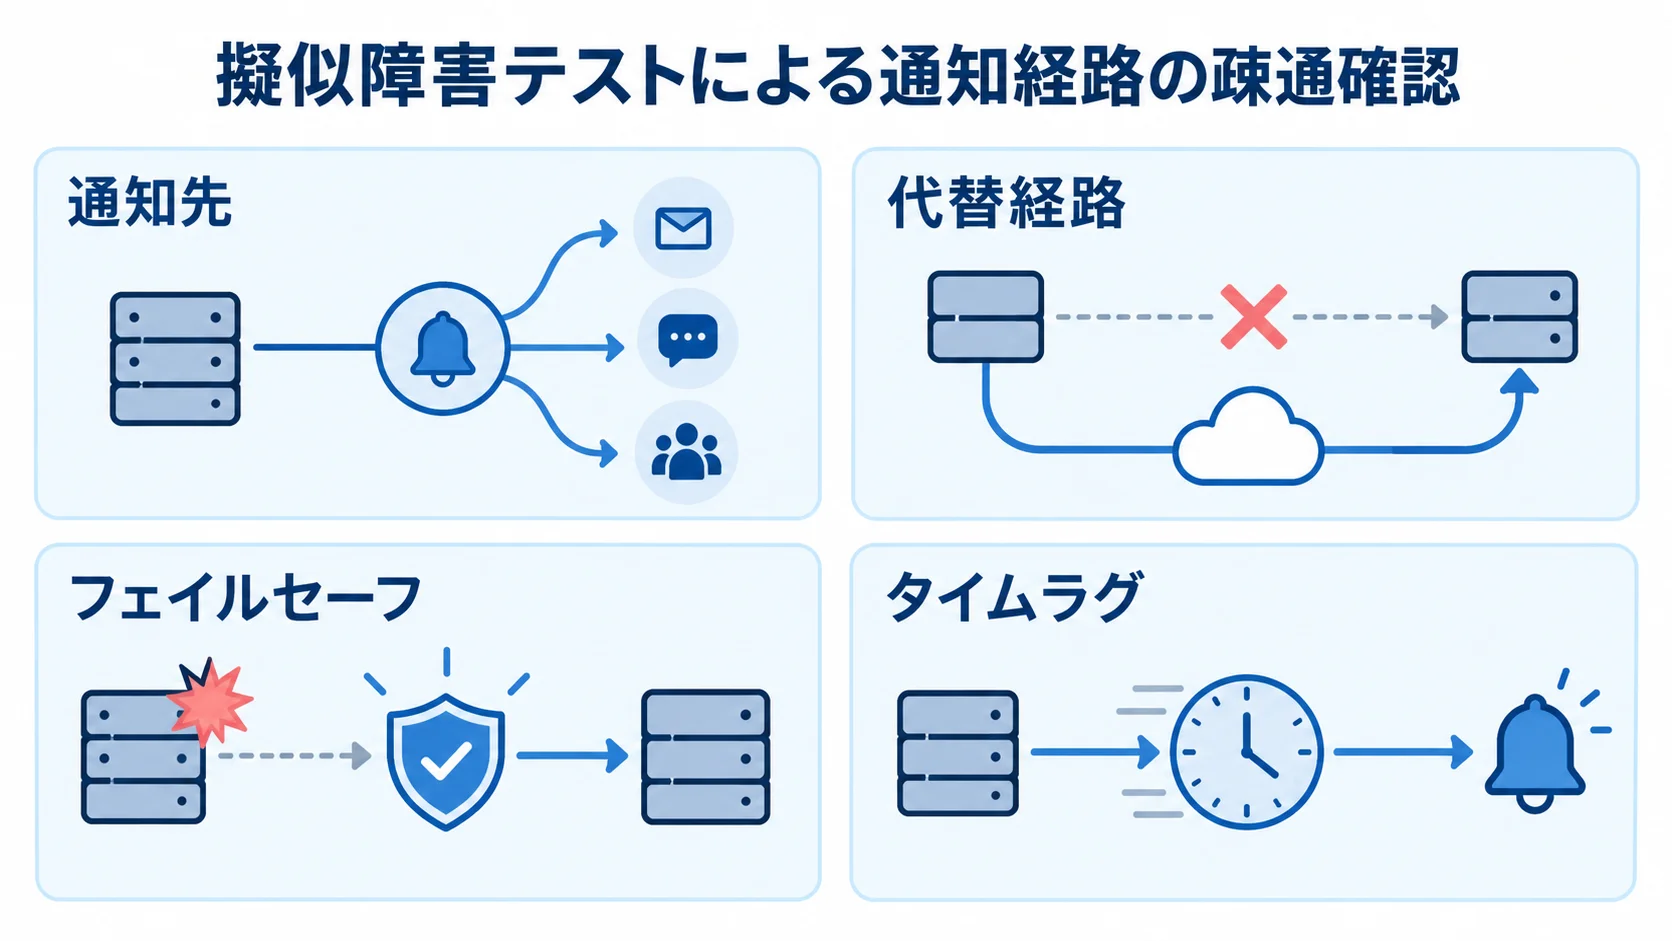
擬似障害テストによる通知経路の疎通確認
PoCの最初のステップは、通知経路の疎通確認です。監視ツールを設定したうえで、LANケーブルを抜くなどして擬似障害を起こします。
- 通知先:メール、SlackやTeamsなどのチャット、電話の自動音声
- 代替経路:一つの経路が止まった際に、フェイルセーフが作動するか
異常を検知してから指定先に通知が届くまでを確かめます。設定ミスやタイムラグは、本番に入れる前に洗い出しておくことが基本的なリスク対策です。
段階的しきい値の試験導入
通知経路を確認したら、実際の監視対象の一部でしきい値を試します。単一の「異常/正常」判定ではなく、業務への影響度に応じた複数の段階を仮に置きます。
- Load Average:4以上で警告、8以上で軽度障害、12以上で重度障害
- ディスク・inode使用量:80%、90%、95%の段階を仮設定
各水準が実際の稼働状況に合うかを見極めます。また、当番担当者もPoCから参加し、通知の頻度やタイミングへの感覚を聞くことが、本番運用の定着を左右します。
PoCの進め方
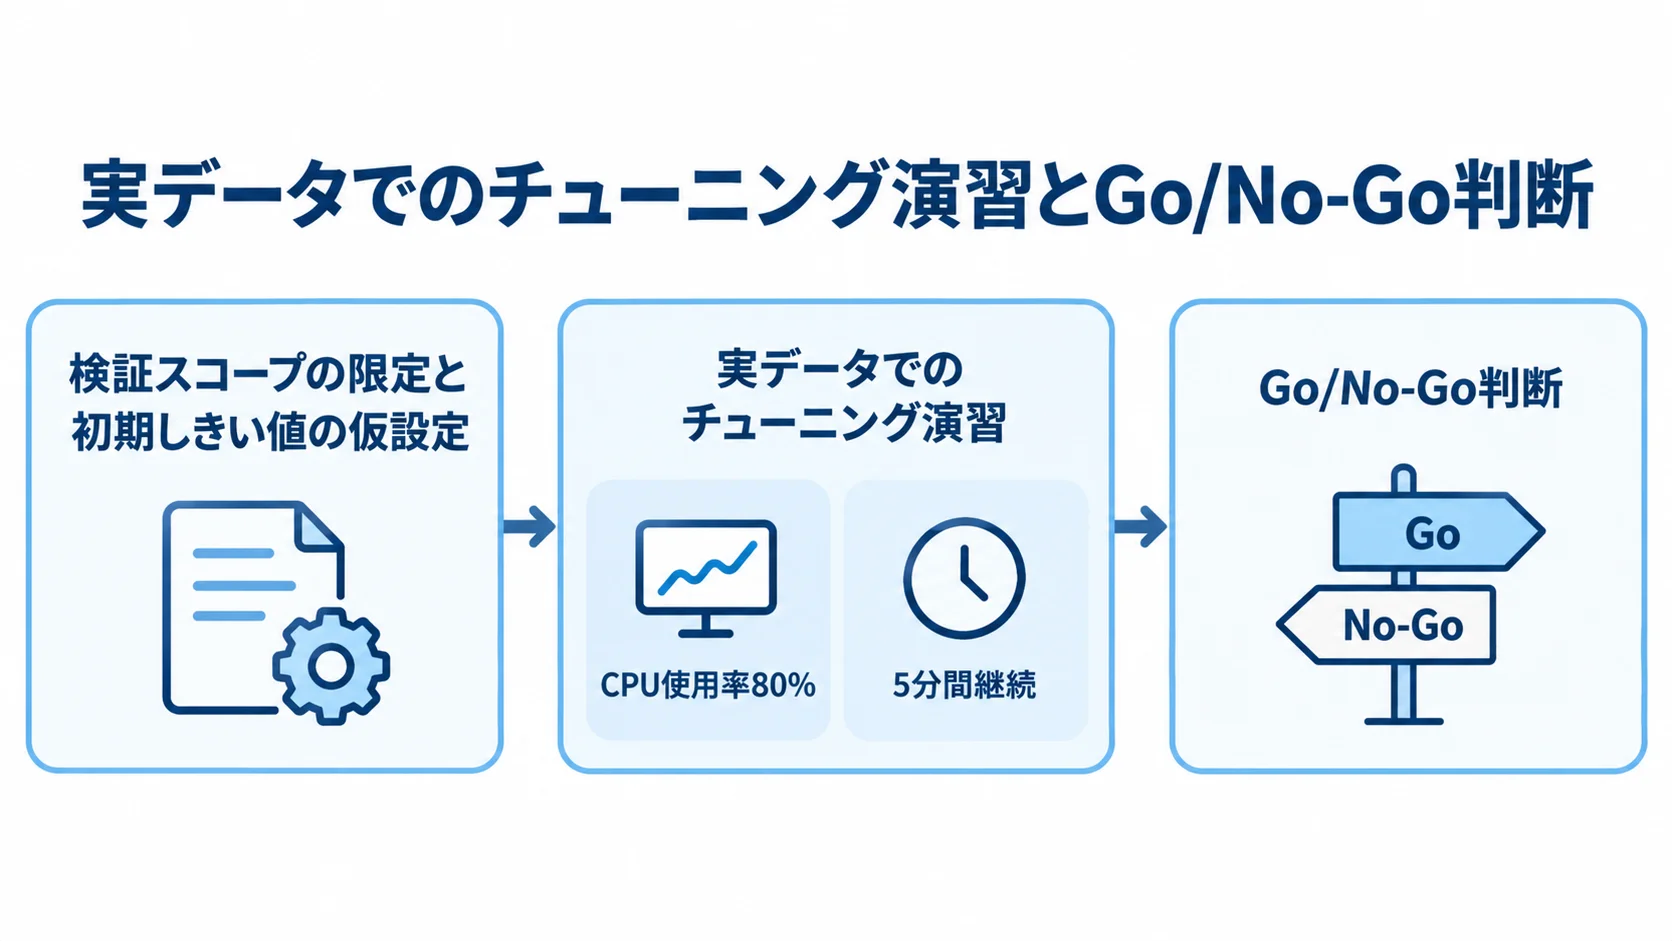
アラート設計は、実際の稼働状況で閾値と通知条件を確かめる試験チューニングとして進めるのが一般的です。順に、検証範囲の限定と初期設定、実データでの演習、評価に基づくGo/No-Go判断へ進みます。
検証スコープの限定と初期しきい値の仮設定
対象は、全システム・全項目ではなく、影響の少ない社内向けシステムや特定の監視項目などに限ります。対象を広げすぎると通知の原因を切り分けにくくなるため、過去の稼働実績や業界の一般的な目安を参考に、初期しきい値を仮に設定します。
- 対象範囲:影響の少ないシステムや一部の監視項目から始める
- 初期設定:過去の稼働実績や一般的な目安を参照する
- 通知準備:通知先と通知テンプレートも具体化する
最初から完璧を目指さず、小さくシンプルに始めて運用しながら改善します。そうすると、後続のチューニング演習も進めやすくなります。
実データでのチューニング演習とGo/No-Go判断
限定環境で負荷変動やシステム挙動を観察し、仮設定した閾値が過検知と見逃しのどちらに偏るかを確かめます。アラートを一件ずつ振り返り、条件を調整します。
- 継続時間:CPU使用率80%で頻繁に通知されるなら、「5分間継続したら通知」を加える
- 判断結果:本格展開(Go)か、閾値・通知条件の再設計かを選ぶ
収集したデータと現場担当者の意見を、事前に定めた基準で評価します。評価を省くと、本番移行後に同じ課題を繰り返すおそれがあります。そのため、Go/No-Goの評価軸は、検証を始める前に決めておきます。
検証項目とKPI(評価指標)
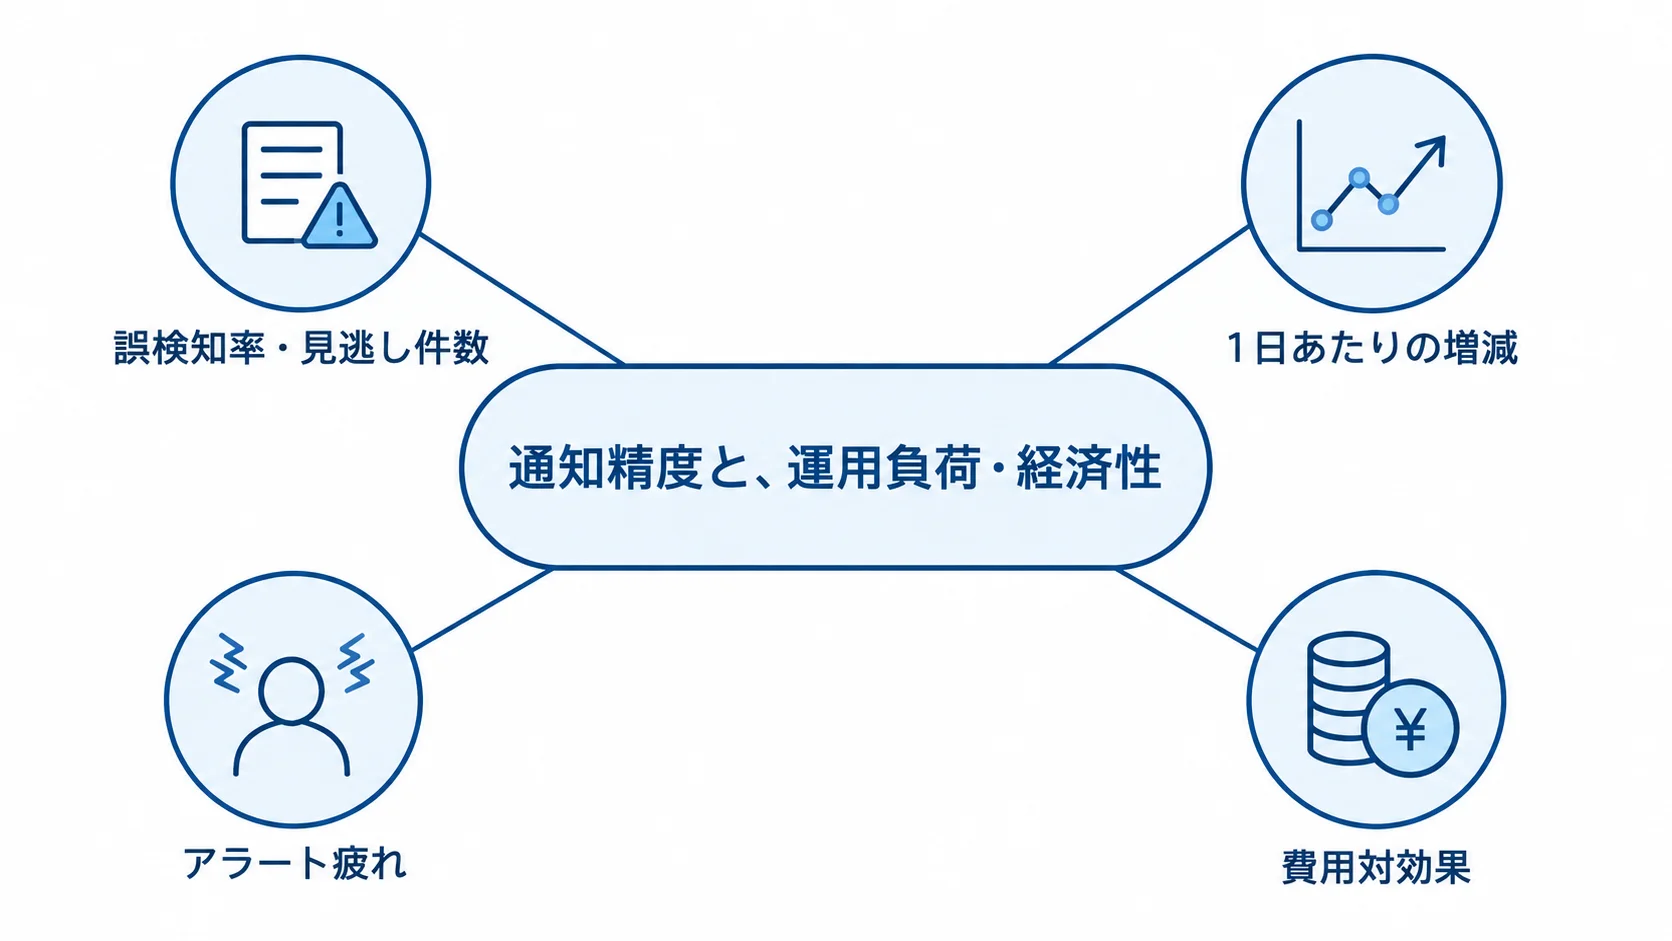
検証で終わらせないためには、通知精度と、運用負荷・経済性の2つの観点から、定量と定性のKPIを設定します。
通知精度レイヤーの指標(誤検知率・見逃し件数)
通知精度では、閾値と通知条件が過不足なく異常を検知できるかを見ます。比較できるよう、PoC開始前に旧設定・未調整状態のアラート発生状況を記録しておきます。
- 誤検知:発生したアラートのうち、対応不要だった件数・割合
- 見逃し:本来通知すべき異常が通知されなかった件数
- 代替経路:疎通テストで代替手段へ切り替わった成功率
開始前の状態をベースラインとして計測しておかないと、チューニング後との比較ができません。
運用負荷・経済レイヤーの指標
運用負荷では、新しいしきい値・通知設計が当番担当者の負担軽減につながるかを検証します。経済性では、ツールや外部委託の費用と、削減できた対応工数を比べます。
- 通知件数:1日あたりの増減
- アラート疲れ:当番担当者へのヒアリングによる体感の変化
- 費用対効果:AIOps機能の導入や通知代行の費用と、削減工数との釣り合い
すべての指標が基準を満たさなければ、閾値や通知条件を設計し直します。無理に全社展開へ進まないという判断も、PoCを実効性のあるものにします。
期間・費用感の目安
閾値が妥当かどうかは、業務の繁閑や季節によるアクセス変動を観察しなければ判断できません。そのため、トライアルは短すぎない期間を設け、最低でも数週間は続けるのが標準です。
PoC・トライアル期間の目安
環境の構築時間と、閾値・通知条件の調整期間は異なります。たとえば、CloudWatchの検証環境は約30分、OpManagerは最短10分で構築できます。
- チューニング:数週間〜1ヶ月程度のトライアルが標準
- SaaSの無料期間:Datadog、Site24x7などは最初の30日間、全機能を試せるケースが一般的
- Mackerel:有料機能を2週間無料で試せる
- Zabbix:小規模設定でも手作業で約1週間かかった事例がある
- 本格稼働後:最終形へ一度に移行せず、3〜6ヶ月程度の継続調整が推奨される
SaaSの無料期間を使えば、自社環境でのアラート発生状況と調整効果を測れます。一方で、ZabbixなどのOSSは検証環境の準備にSaaS型より時間がかかるため、その点を見込んでおきます。
PoCの費用感
SaaSの無料トライアルや小規模向け無料プランなら、ツールのPoCは実質0円から始められます。ZabbixなどのOSSも選べます。ただし、構築や変更には相応のエンジニア工数がかかります。
- Site24x7:10ホストまでのSTARTERプランは月額2,800円から
- Mackerel:スタンダードプランは1台あたり月額2,180円から
- 外部委託:一次フィルタリング・通知代行は夜間・休日のみ、または重要度の高い少数システムに絞る
迅速にPoCを進める場合は、構築工数まで含めると、SaaS型のほうがトータルコストを抑えやすい傾向があります。
陥りやすい失敗パターンと対策
アラート設計のPoCには、事前に把握しておきたい典型的な「地雷ポイント」があります。先に対策を考えておくと、検証を実のあるものにできます。
「とりあえず全部監視」による検証の破綻
CPU、メモリ、全ポートの通信量などを一度に対象にすると、設定作業が膨大になり、PoCが破綻するおそれがあります。項目が増えすぎると通知の原因を切り分けにくく、効果測定も難しくなります。
- 対象を絞る:「止まったら業務停止になる機器」など影響度の高いものから始める
- 段階的に広げる:少数の監視項目で設計ロジックを確立してから対象を増やす
通知条件の「失敗系」の未設計
監視ツールの停止やAPI連携の失敗に備えた代替連絡手段やタイムアウト設定を用意していないと、必要な通知が誰にも届かないおそれがあります。正常時の動作だけでなく、通知経路を意図的に止めた場合も検証します。
- 代替経路:経路を一つ止め、別の連絡手段へ切り替わるか確かめる
- 運用記録:閾値・通知条件の妥当性と失敗系の設計を記録する
- 本番反映:検証結果を本番のアラート設計仕様書に反映する
代替手段の設計と検証は、本格導入の前に必ず済ませる必須の要件です。加えて、試験チューニングの記録を運用ドキュメントに残しておくと、本番導入の土台になります。
まとめ
ここまで、しきい値設計・誤検知の削減・通知経路設計に関するPoCを見てきました。PoCの基本、進め方、KPI、期間・費用、典型的な失敗と対策を順に整理しています。
PoCは「止まったら業務停止になる機器」など対象を絞って始めます。通知経路の確認、段階的なしきい値の試験導入、実データでの調整を経て、通知精度・運用負荷・経済性からGo/No-Goを判断します。
トライアルは数週間〜1ヶ月程度、本格稼働後も3〜6ヶ月程度の継続調整が目安です。ツールの検証は、SaaSの無料期間を使えば実質0円から始められます。
全項目を一度に監視することや、通知の失敗時を設計しないことは、PoCが機能しなくなる典型的な失敗です。あらかじめ対策を組み込みます。
PoCで得た閾値・通知条件の妥当性は運用ドキュメントに反映し、本番の設計仕様書にも記録します。本格導入に向けた土台として活用します。
▼全体ガイドの記事
・ITシステムアラート対応の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。