
ITシステムのアラート対応は、検知から解決までを一つの流れとして組み立てる仕組みです。アラートは多いほど安心とは限らず、過剰なアラートは現場を麻痺させ、重大障害の見落としという最悪の事態を招きます。そのため、アラート設計から閾値チューニングまで順に整えると、通知に振り回されない運用になります。
- アラート疲労を防ぐ設計と検知から解決までの流れ
- 監視対象、重要度、トリアージ、エスカレーション
- PagerDuty・SOARと80/20ルールによる効率化
- 費用相場、ROI、外注時のSLAと責任分界点
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステムアラート対応の全体像
アラート対応とは、システム監視で検知した異常の通知を受け止め、影響を見極め、対処へつなげる一連の運用プロセスを指します。
監視ツールがアラートを出すことは出発点にすぎません。その後に人と仕組みがどう動くかまで設計して、はじめて価値が生まれます。
アラート対応が抱える「アラート疲労」という根本課題
アラート対応で最も深刻な問題が「アラート疲労(アラート地獄)」です。監視対象を広げすぎたり、しきい値を不適切なまま運用したりすると、重要度の低い通知が大量に発生し、担当者が次第に通知を無視するようになります。
これはいわば「オオカミ少年化」であり、本当に対応すべき重大障害の通知が膨大なノイズに埋もれて見落とされる事態を招きます。
とくに「ひとり情シス」や属人化した運用体制では、夜間・休日のオンコール対応が特定の担当者に集中し、疲弊が常態化します。アラート対応の本質は、対応すべきものだけを適切な人に、適切なタイミングで届けることにあります。この発想の転換が、アラート設計の出発点です。
アラート検知から解決までの基本フロー
アラート対応の流れは、まずアラート設計から始まります。次に検知とトリアージ(重要度判定)を行い、チケットを起票して、エスカレーションへ進みます。最後に復旧と恒久対策に至ります。
後工程がいくら整っていても、最初の設計で「何を・どの条件で・誰に通知するか」を決めておかなければ、機能しません。
この流れを支えるのが、サポート体制の階層化です。一次対応のL1がプレイブックに沿って検知と切り分けを行い、解決できないものをL2(詳細ログ分析・一時復旧)、さらにL3(アーキテクチャ変更・根本原因解決)へ引き継ぎます。この引き継ぎで迅速さと品質を両立させるには、誰がどこまで対応し、どこで上位へ渡すかを、あらかじめ線引きしておくことが鍵になります。
ITシステムアラート対応の進め方5ステップ
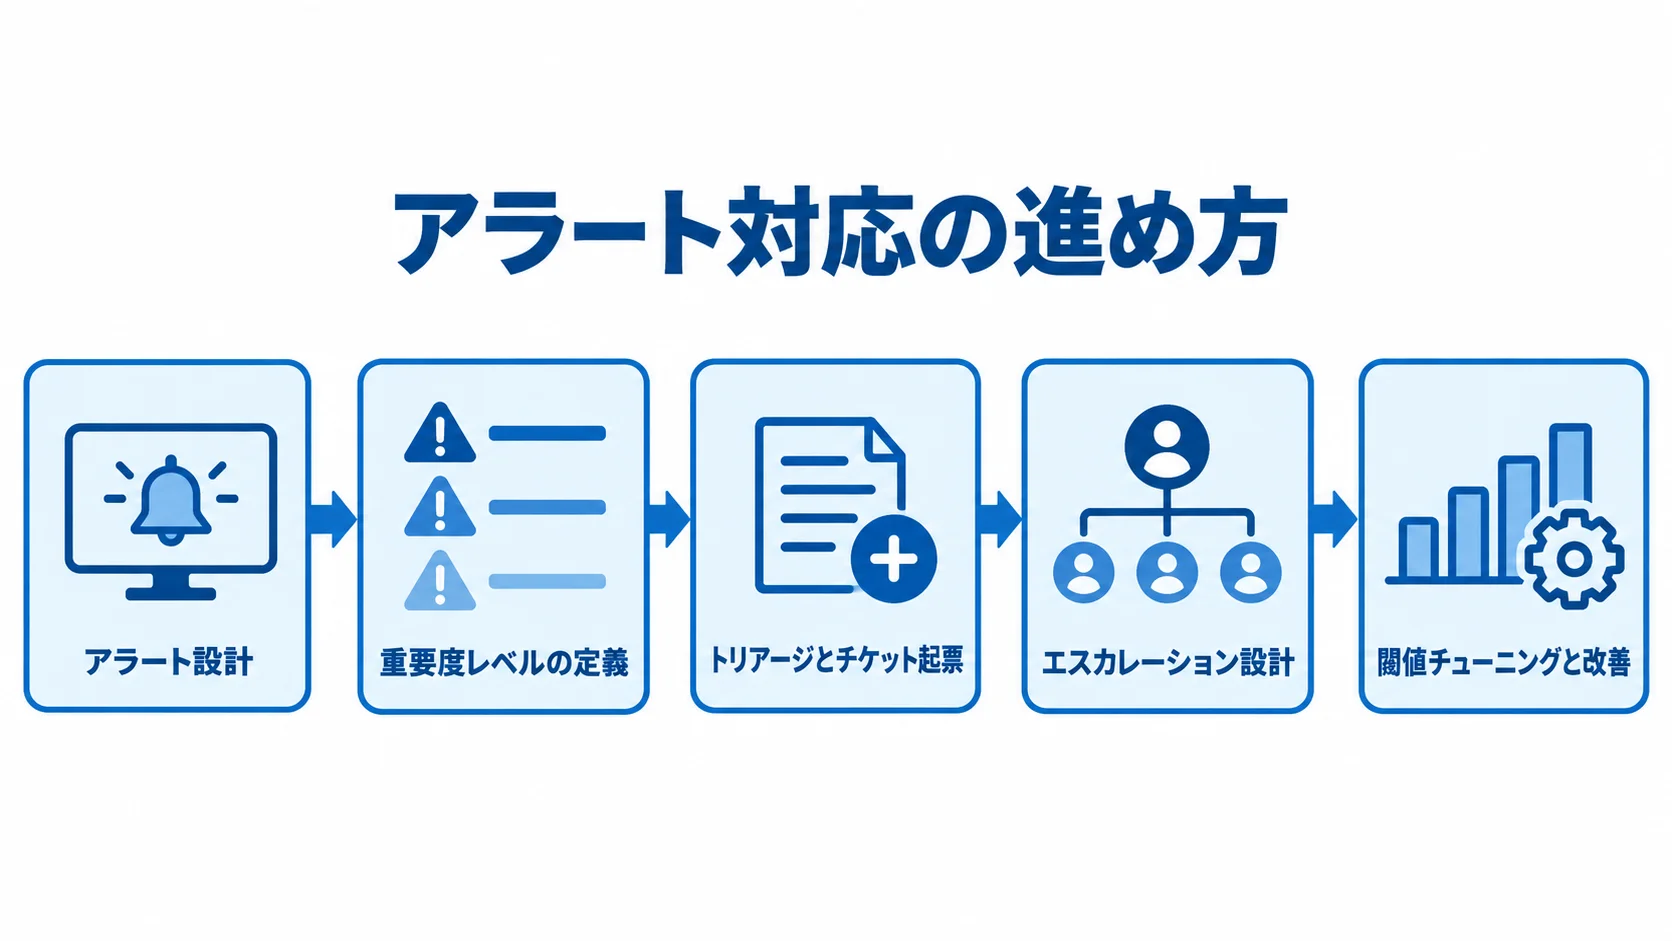
ここからは、アラート対応を仕組みとして構築するための進め方を、5つのステップに分けて解説します。
それぞれのステップで、何を決めるかと、誰が動くかを押さえていきます。5つのステップは、「アラート設計」を起点に、重要度レベルの定義、トリアージとチケット起票、エスカレーション設計を経て、「閾値チューニングと改善」で締めくくります。この順に整えることで、ノイズに振り回されない運用が実現できます。
ステップ1: アラート設計と監視対象の洗い出し
最初に行うのは、監視対象とアラート条件の洗い出しです。発注側と開発会社が一緒に、何を監視し、どの状態を「異常」とみなすかを書き出します。たとえば、サーバーのCPU・メモリ・ディスク使用率やプロセスの死活が対象になります。
ほかにも、ネットワーク疎通やアプリケーションのエラーログが対象になります。ここでは、すべてを通知対象にしない判断が欠かせません。「検知するが通知はしない(記録のみ)」「通知する」「即時オンコールで叩き起こす」の3段階に分けると、アラートの量を最初から適正化できます。
監視導入で陥りがちなのは、デフォルト設定のまますべてを通知にしてしまうことです。アラート対応の品質は、この設計段階で8割が決まると言っても過言ではありません。
ステップ2: 重要度レベルの定義と優先順位付け
次に、アラートへ重要度レベル(Severity)を割り当てます。一般的には、「Critical(サービス全停止・即時対応)」「High(一部機能不全・営業時間内に対応)」「Warning(兆候段階・経過観察)」「Info(記録のみ)」といった3〜4段階で定義します。
重要度は「影響範囲」と「緊急度」を掛け合わせて決めます。たとえば同じ「ディスク使用率90%」でも、ログ用の一時領域なのか本番DBの領域なのかで、意味は大きく異なります。
重要度ごとに「誰が・いつまでに・どう動くか」をあらかじめ紐づけておくと、検知のたびに迷う時間がなくなります。その結果、夜間の通知も本当に起こすべきものだけに絞られ、この優先順位付けがアラート疲労を防ぐ決め手になります。
ステップ3: トリアージとチケット起票の標準化
アラートが発報されたら、まずトリアージ(一次切り分け)を行います。これは「本当に対応が必要か」「誤検知ではないか」「影響範囲はどこまでか」を素早く判定する工程です。あわせて、プレイブック(対応手順書)を整備しておくと、経験の浅い担当者でも一定の品質で初動を行えるようになります。
対応が必要と判断したものは、必ずチケット(インシデント記録)として起票します。チケット化すると、対応履歴・原因・恒久対策が蓄積されるため、同種のアラートが再発したときの対応時間を短縮できます。
この「記録して資産化する」流れを徹底すると、属人化を解消し、ナレッジを組織に残せます。象印マホービンの事例でも、対応履歴をFAQに反映することで同質問の頻度を下げ、運用を効率化しています。
ステップ4: エスカレーションルールの設計
L1で解決できないアラートは、上位のL2・L3へ引き継ぐ必要があります。その引き継ぎを確実にするには、エスカレーションルールを明文化しておくことが欠かせません。
たとえば「一次対応者が15分以内に応答しなければ次の担当者へ自動通知」「Criticalは即時に責任者へ並行通知」といったルールを定めておくと、通知の取りこぼしを防げます。
あわせて、誰が何の責任を持つかを示すRACIマトリクス(実行責任・説明責任・相談先・報告先)を整備すると、対応の意思決定権が明確になります。とくに複数のベンダーやSaaSが絡む環境では、障害時に「基盤の問題か、設定ミスか、不具合か」で責任の押し付け合いが起こりがちです。そこで、あらかじめ責任分界点を定めておくと、迅速な復旧と無用な対立を避けられます。
ステップ5: 閾値チューニングと継続的改善
アラート対応は、運用しながら継続的にチューニングしていくものです。現場で効くコツのひとつが、しきい値に「継続時間」の条件を加えることです。
たとえばCPU使用率の通知を、デフォルトの「80%を超えたら即通知」のまま使うと、一瞬のスパイクでも通知が鳴ってしまいます。これを「80%が5分間継続したら通知」と変えるだけで、無意味な通知が大幅に減ります。
定期的に「発報されたが対応不要だったアラート」を振り返り、しきい値の見直しや通知のグルーピング、不要アラートの抑制を行いましょう。再発防止フローを徹底し、恒久改善を積み重ねた事例では、アラートの正常対応率99.99%を達成し、アラート対応時間を10,000時間以上削減したケースもあります。改善のループを回し続けることで、アラート対応は「楽で安定した運用」へ育っていきます。
アラート対応を効率化する自動化と80/20ルール
アラート対応の進め方を整えたら、次に取り組みたいのが自動化です。人手だけで24時間365日のアラート対応を回し続けることは、人材不足が深刻化するなかで現実的ではありません。
経済産業省はIT人材が2030年に最大約79万人不足すると試算しており、定型作業の自動化は避けて通れないテーマです。
PagerDuty・SOARによる検知から起票の自動化
PagerDutyのようなインシデント管理ツールを使うと、アラート検知から一次切り分けまでを自動化できます。チケット起票や担当者への通知、エスカレーションも、ツールに任せられます。さらにSOAR(セキュリティオーケストレーション・自動化・対応)を組み合わせれば、定型的な復旧作業(サービス再起動やリソース増強など)まで自動実行できます。
これによりMTTR(平均修復時間)を大幅に短縮できます。実際、アイレットの「cloudpack」ではアラート全体の約80%を社内システムで自動処理し、人間が対応するのは残り20%にとどめています。
また、中小企業でもネットワーク監視ツールの導入と異常検知・原因切り分けの自動化により、トラブル対応工数を最大約8割削減した事例があります。自動化は「人を減らすため」ではなく「人が本来集中すべき判断業務に時間を割くため」の投資と捉えると、効果の見通しが立ちます。
80/20ルールによる対応工数の配分
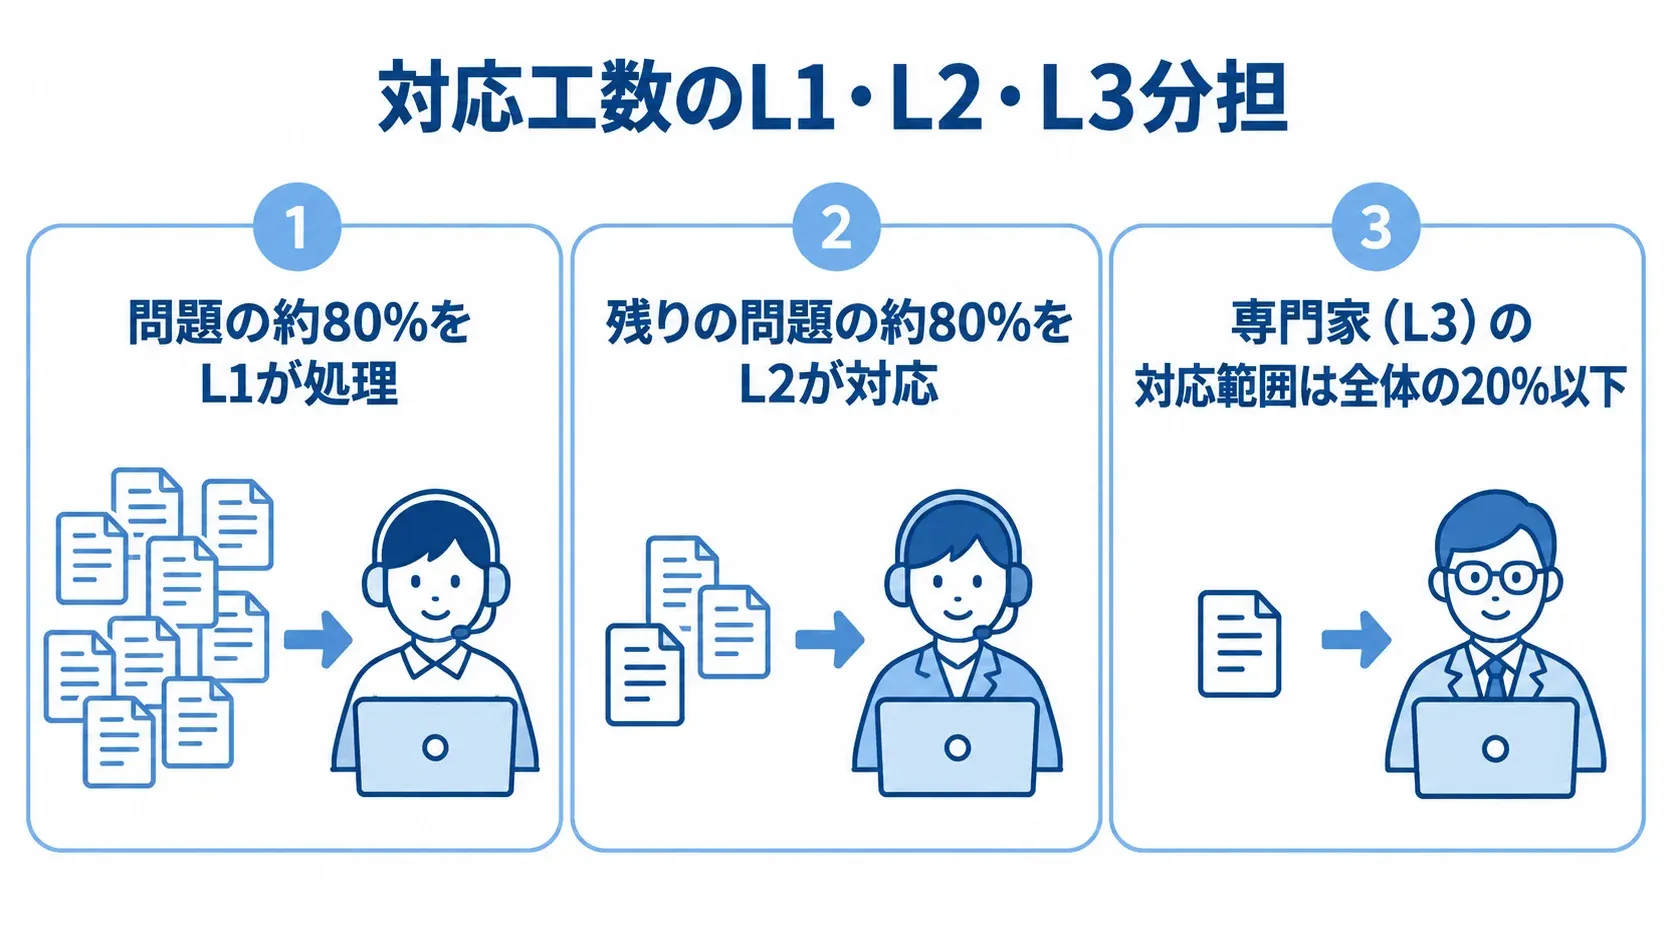
アラート対応の工数配分を考えるうえで指針になるのが「80/20ルール」です。これは、問題の約80%はL1がプレイブックに沿って処理でき、残りのうち約80%をL2が対応し、最終的に専門家(L3)が扱うのは全体の20%以下にとどまる、という経験則を指します。この構造を意識すると、限られた人材をどこに配置すべきかが明確になります。
理想は、定型的な80%を自動化とL1に任せ、判断と専門性が求められる20%に熟練エンジニアの時間を集中させることです。
安易に多機能の統合ツールを導入すると、オーバースペックで失敗しがちです。そこで、まずはSaaS型の監視ツールでスモールスタートし、自動化できる範囲から段階的に広げていくことをおすすめします。また、AIOps(機械学習による異常検知)は有効ですが、誤検知のリスクもあるため、最終判断は人が担う前提で導入するのが安全です。
アラート対応の費用相場とコストの内訳
アラート対応を外部に委託する場合、費用は対応範囲と対応時間帯、アラート件数、自動化の度合いによって大きく変わります。ここでは、内製と委託のコストを比べながら、費用相場の考え方を整理します。
料金体系と規模別の月額目安
アラート対応の委託料金は、大きく「月額固定型」と「従量型(アラート件数や対応件数に応じて課金)」に分かれます。一次対応(L1)のみの監視代行であれば、小規模環境で月額数万円から、24時間365日の有人監視や二次対応まで含めると月額数十万円規模になるのが一般的な目安です。
サーバー台数や監視対象の数が増えるほど、費用は上がります。料金を構成する主な要素は、監視ツールのライセンス費、アラート対応の人件費(対応時間帯・体制)、初期の設計・チューニング費用の3つです。とくに夜間・休日を含む24時間体制は、人員の確保が必要になるぶん、費用がかさみやすい部分です。
費用を抑えるには、自社で「どの時間帯のアラートが最も負担になっているか」を把握したうえで、必要な時間帯だけを部分的に委託する方法も有効です。
内製の隠れコストと自動化ツールのROI
自社でアラート対応を続ける場合、見落とされがちなのが「隠れコスト」です。たとえば、夜間オンコール対応による担当者の疲弊や離職リスクは、人件費の表面額には現れません。さらに、属人化による業務継続の不安や、DX推進にリソースを割けない機会損失も、数字には出にくいものです。
これらを含めて試算すると、委託のほうがトータルで安くなるケースも少なくありません。
自動化ツールのROI(投資対効果)を稟議で示すには、「現在のアラート対応に費やしている総工数(時間)×担当者の時間単価」と「自動化による削減見込み工数」を比較する形が分かりやすいです。前述のとおり、アラート対応時間を10,000時間以上削減した事例や、工数を約8割削減した事例もあるため、削減効果を金額に換算すれば、導入の妥当性を経営層に説明しやすくなります。
アラート対応を外注する際のポイント
アラート対応を外部に委託する際は、単に「監視を任せる」だけでなく、要件を明確にし、責任の所在を取り決めておくことが成功の分かれ目です。ここでは、委託先の選定と発注時に押さえるべきポイントを解説します。
要件定義とSLA・責任分界点の明確化
外注で最も多い失敗は、曖昧な要件定義によって追加費用が生じることです。発注前に、どのアラートをどの重要度で扱い、誰がどこまで対応するかを明文化しておくことが欠かせません。
そのうえで、SLA(サービス品質保証)として「インシデント応答時間は30分以内」「稼働率99.9%以上」などの客観的なKPIを定めましょう。これにより、品質を数値で管理できるようになります。
あわせて、自社と委託先の責任分界点(RACI)を明確にしておくことが大切です。とくに、クラウド基盤やSaaS、監視ツール、委託先が複雑に絡む環境では、障害発生時に責任の所在が曖昧だと復旧が遅れます。SLAのグレーゾーンの扱いや、誤検知で障害を見落とした場合の責任は、契約段階で擦り合わせておくと、いざというときのトラブルを防げます。
委託先の選定基準とブラックボックス化の回避
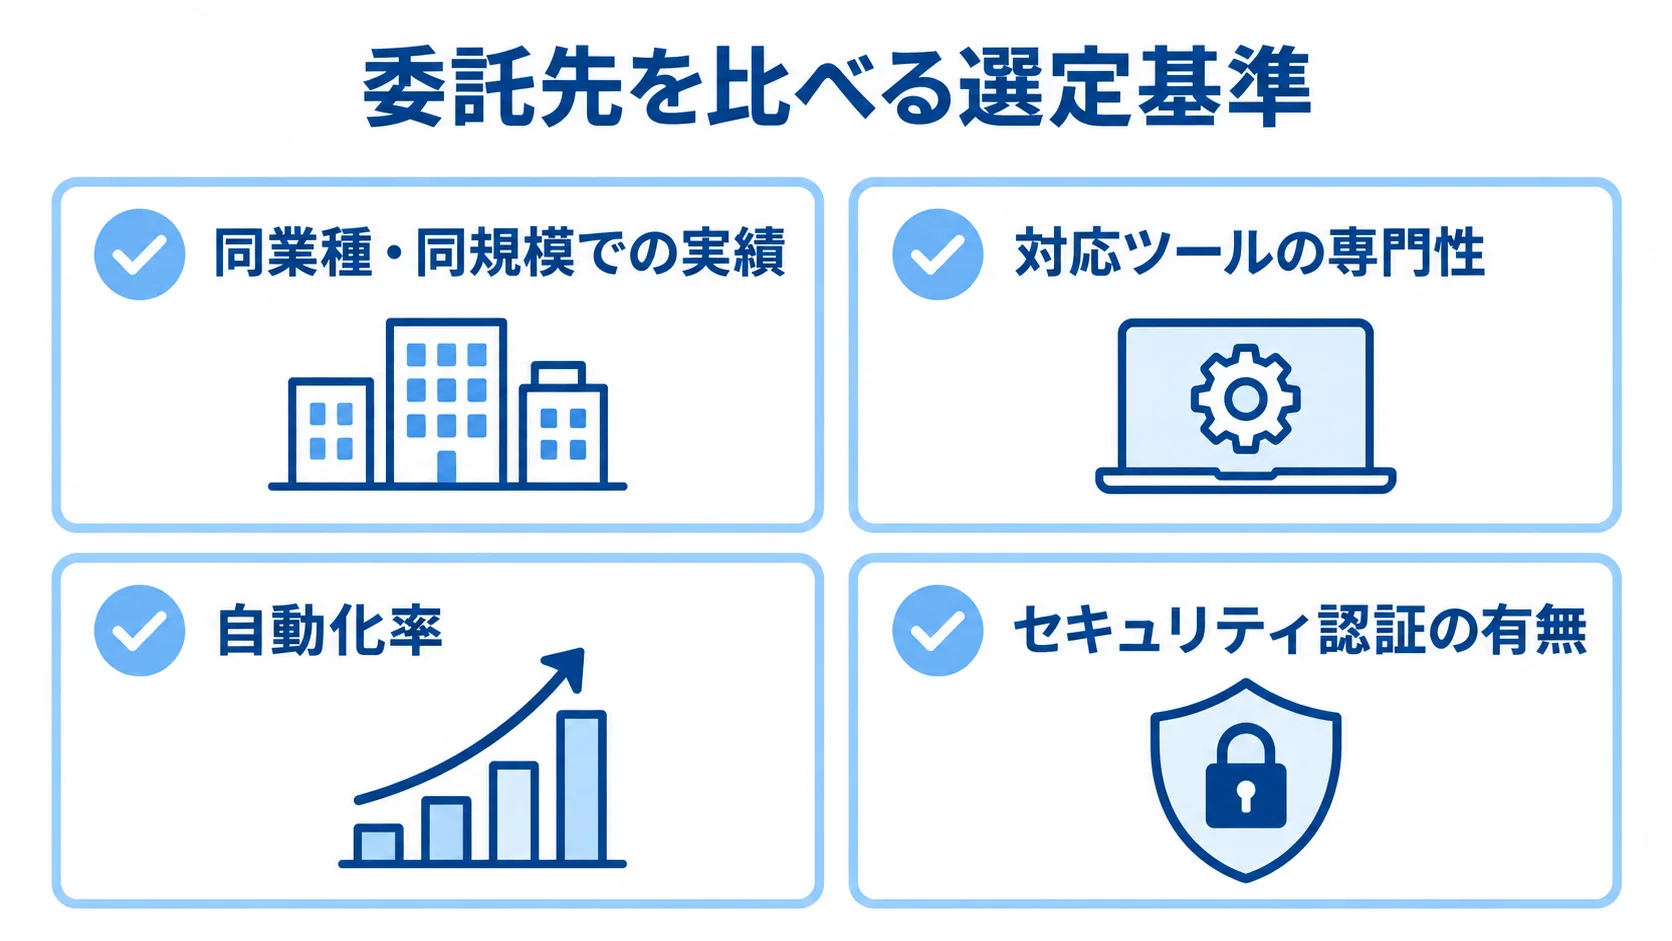
委託先を選ぶ際は、同業種・同規模での実績と、対応ツールの専門性を確かめます。加えて、自動化率の高さや、ISMSなどのセキュリティ認証の有無も見ていきます。複数社を比べ、SLAの妥当性とサポート体制を見極めることが大切です。
価格の安さだけで選ぶと、対応品質が伴わず「ハズレのベンダー」を引いてしまうリスクがあります。外部委託で警戒すべきは、運用のブラックボックス化です。すべてを丸投げすると、社内にノウハウが残らず、ベンダーロックインに陥ります。
これを避けるには、移管前にドキュメントを整備し、委託後も3〜6ヶ月の並走期間(ハイパーケア)を設けて、定期レポートで対応状況を示してもらうことが有効です。将来は内製へ戻す可能性も見据え、ナレッジが自社にも残る契約にしておきたいところです。複数の基幹システムの構築・運用を一気通貫で支援できるパートナーであれば、移管設計まで含めて相談できます。
ITシステムアラート対応の関連情報
アラート対応は、委託先選び・費用相場・発注方法といった観点を組み合わせて検討することで、より自社に合った形を導けます。目的に応じて、関連記事もあわせてご覧ください。
委託先選びと費用の詳細
アラート対応を委託する開発会社・ベンダーの選び方を具体的に知りたい方は、ITシステムアラート対応でおすすめの開発会社/ベンダー6選と選び方をご覧ください。自動化率や対応ツール、通知連携といった観点での比較ポイントを解説しています。
費用感を先に把握したい場合は、ITシステムアラート対応の見積相場や費用/コスト/値段についてで、アラート件数や自動化範囲別の料金、ROIの算出方法を確認できます。
発注方法と全体像の詳細
閾値チューニングの委託ポイントやアラート疲労回避の要件定義、SOAR導入の判断基準など、発注の実務を深く知りたい方は、ITシステムアラート対応の発注/外注/依頼/委託方法についてが参考になります。アラート対応の全体像をまとめて理解したい場合は、ITシステムアラート対応の完全ガイドで、進め方から費用、AIOpsの限界まで体系的に解説しています。
まとめ
ITシステムのアラート対応は、通知を増やすことより、対応すべきものだけを適切に届ける仕組みを作ることが本質です。
進め方は5ステップです。まずアラート設計と監視対象の棚卸しから始め、重要度レベルの定義、トリアージとチケット起票の標準化へと進みます。
続いてエスカレーションルールを設計し、最後に閾値チューニングと継続的改善で締めくくります。こうして順に整えることで、アラート疲労を防ぎながら、重大障害の見落としをなくす近道になります。
PagerDuty・SOARによる自動化や「80/20ルール」に基づく工数配分を取り入れれば、限られた人材を判断業務に集中させ、MTTRの短縮とコスト削減を同時に実現できます。
外注する際は、要件定義とSLA・責任分界点を明確にし、ブラックボックス化を避けるための並走期間を設けることが成功の鍵です。
「5分継続で通知」といった現場の小さな工夫の積み重ねが、運用を楽に・安定させていきます。本記事を出発点に、自社のアラート対応をぜひ仕組みとして見直してみてください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。