
ITシステムのバグ修正にかかる期間は、一次対応の分単位〜時間単位から、恒久対応の数日〜数週間以上まで幅があります。
その差は、原因調査、修正範囲、テストの巻き込み規模によって決まります。全体像はITシステムバグ修正の完全ガイドもご覧ください。
▼全体ガイドの記事
・ITシステムバグ修正の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
バグ修正プロジェクトの標準的な工程と期間の全体像
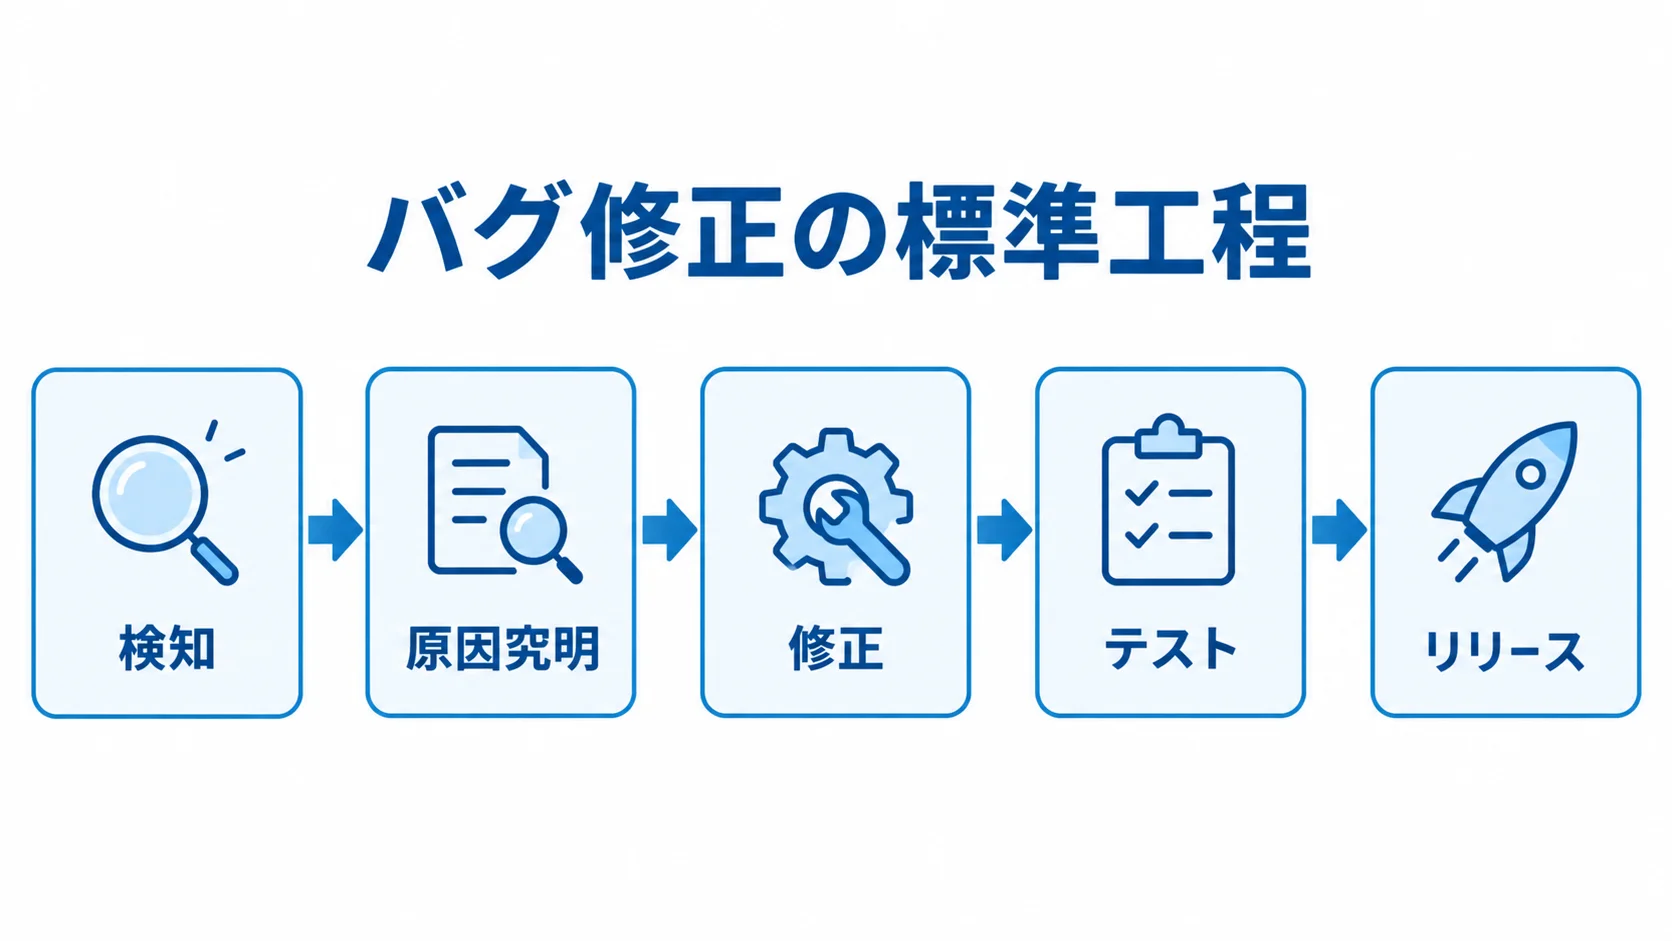
納期を見積もるには、バグ修正で何をどの順に行うかを示す標準工程を先につかんでおくことが欠かせません。工程ごとの時間が見えてくると、見積もりは現実的なものに近づきます。全体像を押さえることが、納期見積もりの第一歩です。
検知→原因究明→修正→テスト→リリースの5段階フロー
バグ修正は、検知からリリースまでの5段階で進みます。工程ごとに確認する内容が異なるため、各段階を分けて捉えることが大切です。
- 検知:監視ツールのアラートや、ユーザー・ヘルプデスクからの報告を起点に、何がいつどこで起きたか、影響範囲はどこまでかを押さえます。
- 原因究明:自社システムか外部サービスかを切り分けたうえで、ログ、類似事例、再現テストから問題の箇所を絞り込みます。
- 修正:重要度と開発リソースを踏まえて優先度、担当者、期限を決め、改修や設定変更を進めます。
- テスト:本番同等の環境で、修正の動作と既存機能への悪影響(デグレード)の有無を見極めます。
- リリース:テスト済みの修正を本番環境に反映し、解消の確認と周知まで行います。
原因究明に時間がかかる間は、予備サーバーへの切り替えなどの暫定対応を行う場合があります。また、テストが不足すると新たな障害につながるため、各段階の所要時間を把握して進行管理に生かすことが基本です。
一次対応(暫定)と恒久対応(バグ修正)の期間の違い
一次対応(暫定対応)と恒久対応(バグ修正)は、かかる時間の単位が異なります。緊急時に両方を同時に進めようとすると、テストや再デプロイに時間がかかり、停止が長引くことがあります。
- 一次対応:原因特定より業務再開を優先し、再起動、予備系への切り替え、代替手段によって復旧を図ります。
- 恒久対応:ログ分析とコード修正を行い、本番同等環境でのテストを経てパッチを適用します。
一次対応は分単位〜時間単位の対応です。一方で、恒久対応は業務影響を抑えた後に行い、数日〜数週間以上かかることがあります。
システムが復旧しても、それでバグ修正が終わったわけではありません。そのため、根本修正には別途スケジュールを確保する必要があります。
新規開発とバグ修正(改良開発)のコスト構造の違い
新規開発と既存システムのバグ修正では、工数の見積もり方が違います。
- 機能量とテスト量:新規開発ではおおむね比例しますが、既存システムの修正では両者の相関が低くなります。
- 共通部分の修正:1行の修正でも、既存機能への影響を確かめるため、システム全体のテストが必要になる場合があります。
- 見積り工数:既存システムの調査・分析、改造部分の設計・製造・テスト、既存側の確認テストを合算します。
- 納期の判断:調査や影響範囲のテストがコード作成より長くなることもあるため、修正量だけでは決められません。
重大度・優先度別の対応期間とSLAの目安
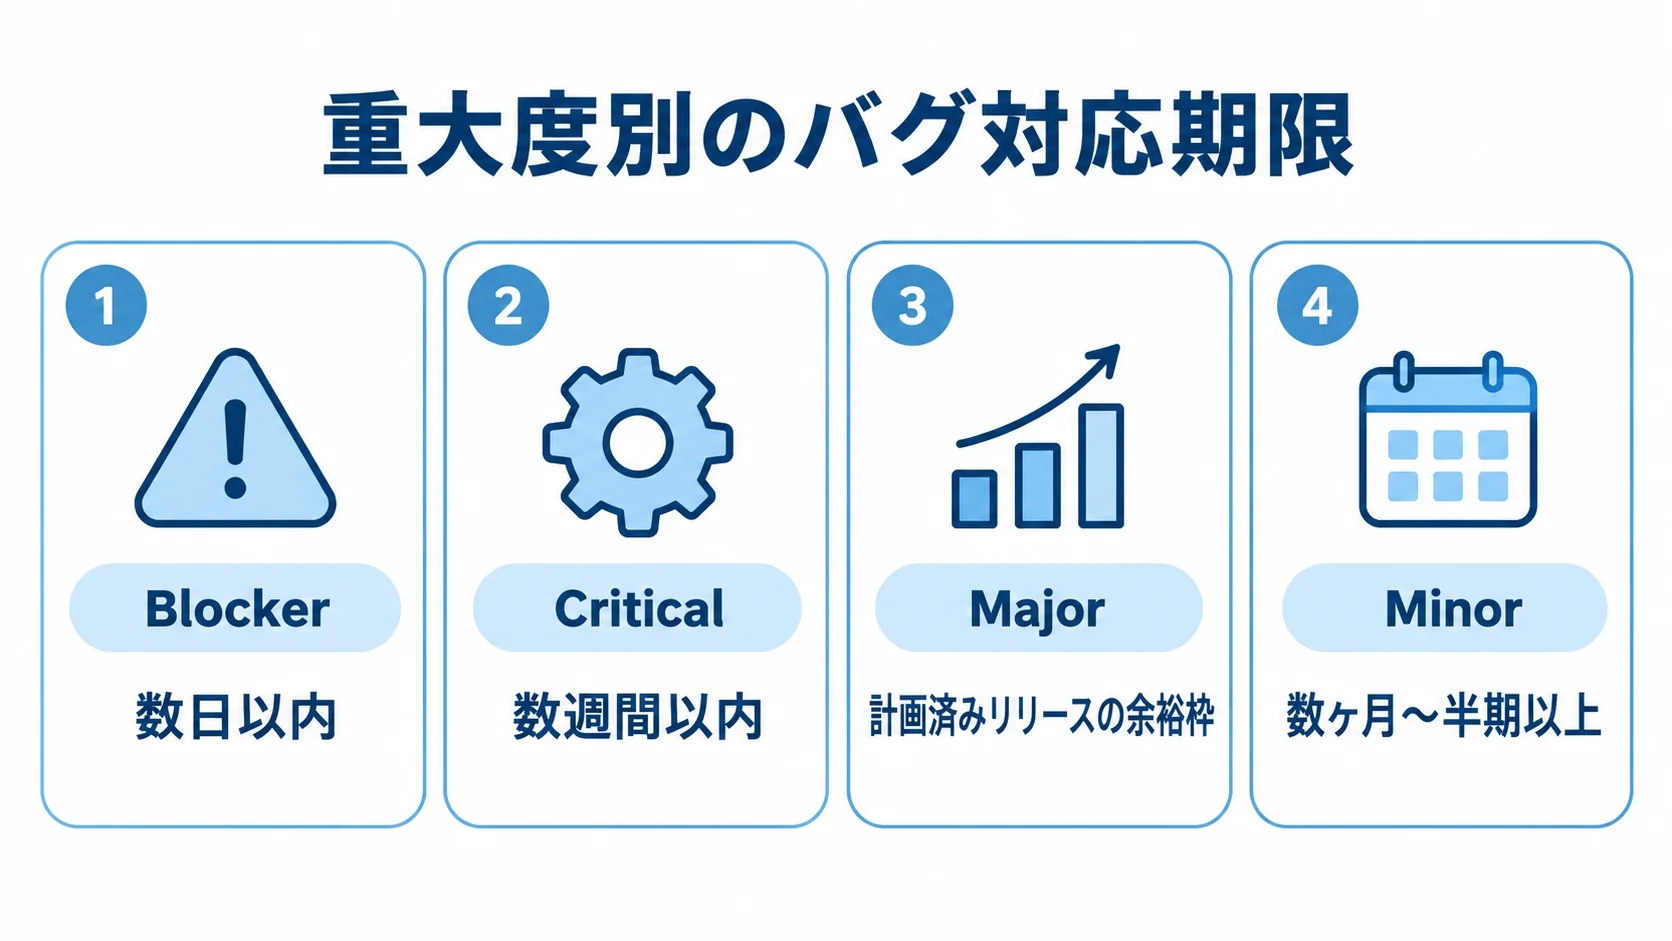
影響の大きい不具合が後回しにならないよう、優先順位は重大度と緊急度をもとに決めます。そのうえで、対応期間の目安は、SLA(サービスレベル合意)に基づいて定めるのが標準的です。
Blocker/Critical/Major/Minorの4段階と対応期限
バグの優先度は、一般的に4段階のマトリクスで判定します。対応期限は、影響度や回避手段ごとに見ていきます。
- Blocker(最高):コア機能の破損や致命的な脆弱性があり、全タスクを中断してホットフィックス(緊急修正)を行います。目安は数日以内です。
- Critical(高):主要機能が使えないものの、複雑な代替手段で回避できる状態です。数週間以内を目安に、次のスプリントで対応します。
- Major(中):補助機能の停止や、特定のOS・ブラウザなど限られた環境で起きる不具合です。
- Minor(低):操作に支障のない軽微な表示崩れなどが該当し、数ヶ月〜半期以上の期限を設ける場合があります。
Majorは、計画済みリリースの余裕枠で順次対応します。このように、同じバグでも分類によって想定する納期は変わります。
SLA(サービスレベル合意)における目標対応時間の水準
稼働中のサービスに影響する障害では、障害レベルに応じてSLAの目標時間を定めるのが一般的です。
- Critical(極大):全社業務が止まったときの目標は、15分以内の初回応答・エスカレーションと、1時間以内の復旧です。
- High(大):部門や特定業務が止まったときの目標は、30分以内の応答と、4時間以内の復旧です。
- Medium(中):代替手段がある業務上の支障の場合、翌営業日が目標です。
- Low(小):軽微な不具合の場合、1週間以内が目標です。
SLAで示す時間の多くは、初回応答や応急復旧までの目標です。そのため、恒久修正にかかる時間そのものとは限りません。そこで、SLAを確認する際は、応答、復旧、恒久対応のどの時間を指すかを明確にしておくと、認識違いを防げます。
検出者バイアスを排した優先度決定プロセス
テスト担当者が自分の見つけたバグを重要だと考える検出者バイアスなど、発見者の視点だけで優先度を決めると、全体の予定が乱れることがあります。そのため、開発全体の事情を踏まえた合意が必要です。
- 決定体制:残る技術的負債やリリース予定を把握している、マネージャーやプロダクトオーナーが合意し、優先度・担当者・期限を決めます。
- 判断材料:修正の工数・期間と、進行中の他のテストを妨げないかどうかを考慮します。
- 対応しない判断:ユーザーに利益があるバグなどは、あえて修正しない場合もあります。
発注側は、優先度を決める手順や体制を事前に確認しておくと、対応が後回しになる理由を把握しやすくなります。
修正スケジュールを左右する3つの要因
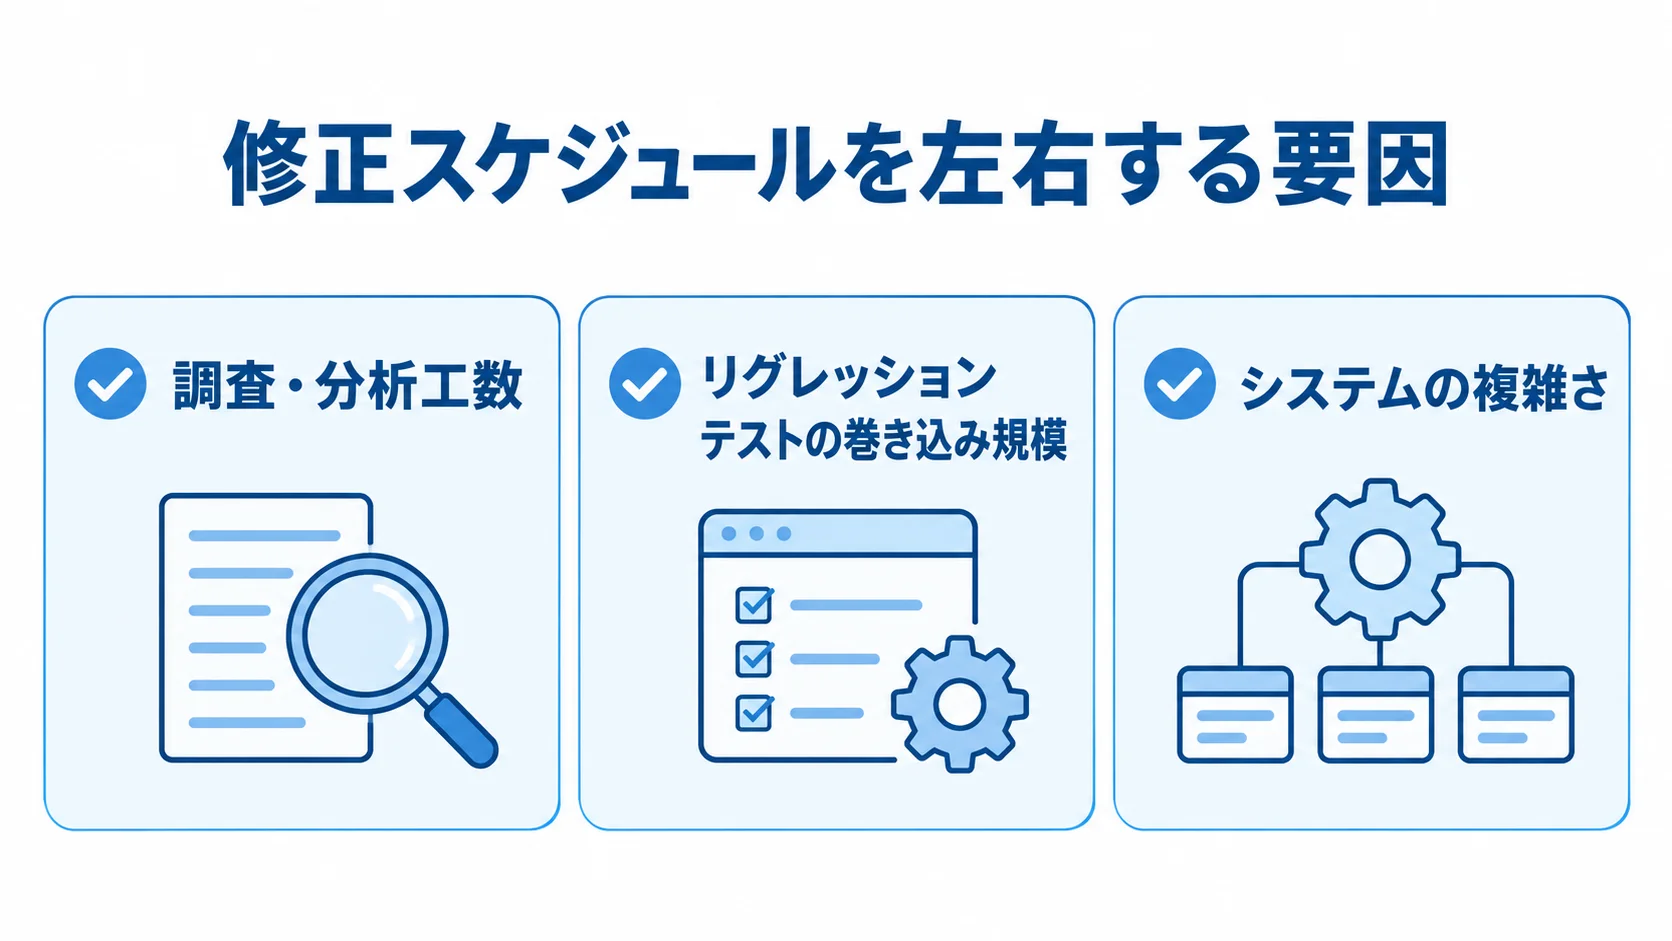
同じ優先度の不具合でも、対応期間には差が出ます。その差を生む要因を知っておくと、楽観的すぎないスケジュールを組めます。
改良開発に特有の調査・分析工数
特に既存システムでは、仕様や影響範囲を調べる時間が納期を左右します。調査・分析は、保守作業全体のおよそ30%を占めるとされます。
- 資料の整備状況:設計書や運用マニュアルが整っているほど、調査を進めやすくなります。
- システムの理解しやすさ:作りが複雑だと、原因の特定に時間がかかることがあります。
- 担当者の習熟度:システムに詳しい人がいれば、調査が短時間で済む場合があります。
資料が乏しく初めて触るシステムでは、原因の特定だけで想定以上の日数を要することがあります。そのため、金額や期間だけでなく、調査・分析に見込む工数も確かめておくと、見積もりが妥当かどうかを見分ける材料になります。
リグレッションテストの巻き込み規模がスケジュールに与える影響
第二の要因は、テスト工程での巻き込み規模です。変更していない既存機能まで確認するリグレッションテストが必要になり、範囲が広いほど期間が延びます。
- 修正箇所の分散:手を加える場所が多いほど、検証すべき範囲が広がります。
- モジュール間の結合:結合度が高いシステムでは、修正の影響が広がるおそれがあります。
- 改造密度:母体規模に対する追加・削除量をもとに、巻き込み規模を見積もる場合があります。
- 改造分散度:手を加える箇所数をもとに、テスト工数の見積り精度を高めることがあります。
修正規模が小さくても影響範囲が広ければ、テストは長くなります。そのため、納期の遅れを作業の停滞と誤解しないよう、この前提を発注側と委託先で共有しておくことが大切です。
システムの複雑さ・ドキュメント整備状況
第三の要因は、修正対象システムの複雑さです。調査期間は、構造や担当者の理解度、資料の整備状況によっても変わります。
- 複雑な構造:密結合なシステムでは、修正の影響が予想外の箇所に及び、検証が長引くことがあります。
- ブラックボックス化:長年多くの担当者が改修してきたシステムは内部構造が見えにくく、原因究明に時間がかかる場合があります。
- 担当者の習熟度:既存システムへの理解が深いほど生産性が上がる傾向があり、設計や改修履歴も調査の手がかりになります。
- 事前共有:構成、過去の改修履歴、ドキュメントの有無を委託先に伝えておけば、想定外の期間延伸を減らせます。
納期を守るためのデバッグ手法と体制
原因究明が迷走したり、不具合が再発したりすると、納期の遅れにつながることがあります。そこで、デバッグの手法と、リリース後の体制づくりが納期の安定に役立ちます。
なぜなぜ分析・レイヤー切り分けによる原因究明の迅速化
体系的な手法で原因を絞り込めば、行き当たりばったりの調査を避けられ、調査時間を縮められます。
- なぜなぜ分析(5 Whys):エラーや画面停止などの表面的な事象について、理由を5回程度たどって根本原因を探る手法です。
- レイヤー切り分け:インフラ障害では、物理層、データリンク層、OSの順に確認し、アプリケーションへ進みます。
- 仮説と再現テスト:ログで特定できないとき、類似事例や直前の変更履歴から想定を立てて検証します。
原因究明の手法をチームの標準プロセスとして決めておくと、調査の迷走による遅延を防ぐ土台になります。
ポストモーテムと再発防止策によるスケジュールの安定
リリース後に関係者で原因と対応を振り返るポストモーテム(事後検証)は、次回以降の予定を安定させます。振り返りでは個人を責めず、システムやプロセスの欠陥に焦点を当てます。
- 発生を防ぐ:静的コードチェックのCI/CD自動化などの検討
- 発生確率を下げる:統合テストの拡充など
- 早く気付く:監視の見直し
- 被害を抑える:冗長化などの検討
発生した状況を新しい試験観点としてテスト項目に加えると、以降のテストで検出率を高められます。さらに、タイムライン、根本原因、再発防止策を障害報告書にまとめて社内で共有しておくと、類似バグの調査を繰り返さずに済みます。
見積もり・進行管理で押さえるべきポイント
依頼の時点で優先度や工数、テスト範囲を確かめておくと、納期の見通しが立ちます。
- 優先度とSLA:Blocker〜Minorのどれに当たるか、そのバグに適用される目標時間を確認します。
- 工程別工数:調査・分析、修正、テストのそれぞれに、どれだけの時間を割り振るかという内訳。
- 影響とテスト範囲:修正が及ぶ先と、既存機能の確認規模を発注側と委託先ですり合わせます。
原因究明に想定以上の時間がかかっても、早い段階で状況の共有を受けられる体制があれば、後工程のテスト期間を圧迫せずに済みます。
バグ修正は、優先度に合った納期を定め、進行管理することが事業への影響を抑える近道です。
まとめ
ITシステムのバグ修正は、検知、原因究明、修正、テスト、リリースの5段階で進みます。一次対応は分単位〜時間単位ですが、恒久対応には数日〜数週間以上かかる場合があります。
対応期限は、Blockerの数日以内からMinorの数ヶ月〜半期以上まで幅があります。SLAの目標も、Criticalの初回応答15分からLowの1週間以内まで、重大度によって異なります。
納期は、既存システムの調査・分析工数、テストの巻き込み規模、システムの複雑さで変わります。特に調査・分析は、保守作業全体のおよそ30%を占めるとされます。
なぜなぜ分析やポストモーテムを取り入れ、優先度の決め方と工程別の工数を委託先とすり合わせておくと、納得感のある日程で進めやすくなります。
まずは対象バグの優先度とSLAを整理し、複数の開発会社に相談するところから進めるとよいでしょう。
▼全体ガイドの記事
・ITシステムバグ修正の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。