
保守体制構築の検証は、課題を明確にしてから、モックアップ、プロトタイプ、PoCを段階的に試し、基準に沿って移行を判断すると、本格稼働の判断材料を得られます。
3手法の使い分け、PoCの期間と費用、移行判断、失敗の回避策を扱います。全体像はITシステム保守構築の完全ガイドもご覧ください。
▼全体ガイドの記事
・ITシステム保守構築の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
保守体制構築における3手法の使い分け
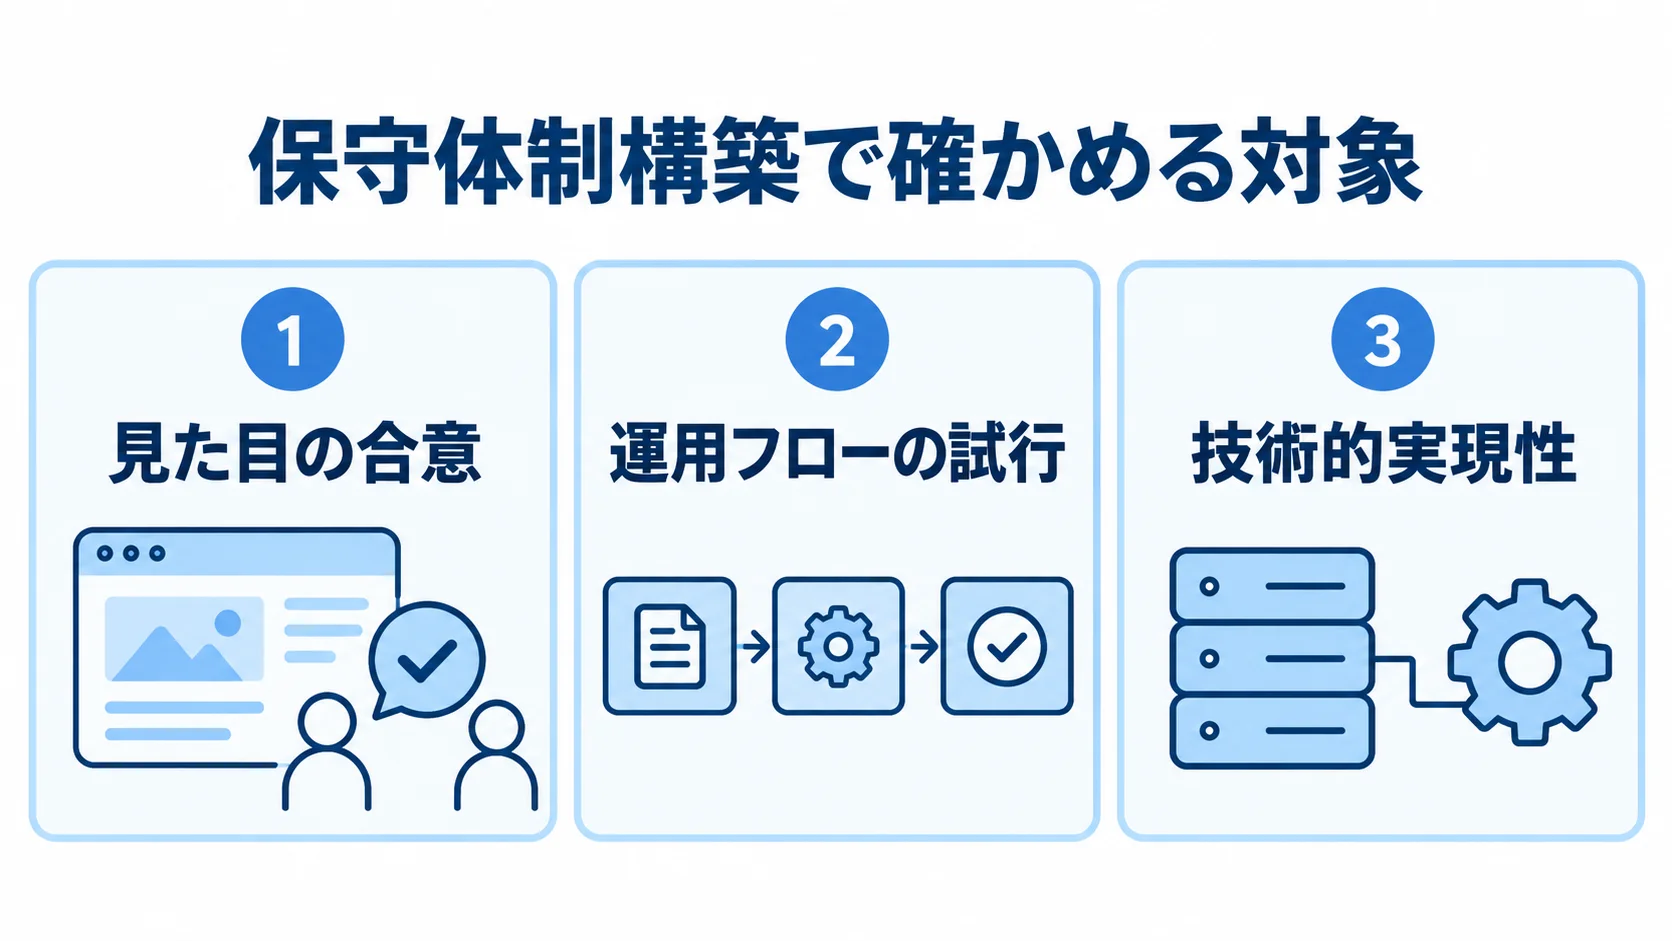
保守体制構築では、「何を確かめたいか」に応じて、モックアップ、プロトタイプ、PoCを使い分けます。確かめたい対象を取り違えると、検証が長引いたり、必要な確認をしないまま本稼働へ進んだりするおそれがあります。
モックアップ:監視ダッシュボードの「見た目」の合意
モックアップは、新しく導入する監視ダッシュボードの見た目を検証する手法です。実際には動かない画面を使い、表示する指標やレイアウトを確認します。
経営層向けと現場のオペレーター向けでは、必要な情報の粒度や優先順位が異なります。そこで、画面を現場の担当者に見せて認識を合わせておくと、後工程のプロトタイプやPoCでの手戻りを抑えられます。
プロトタイプ:サポート導線と運用フローの試行運用での検証
プロトタイプは、運用フローや操作感を検証する手法です。保守チームの一部を先行して稼働させ、実運用に近い環境でサポート導線を試します。
- 窓口と連絡先:一次の受付先やエスカレーション先が、現場の業務に合っているかどうか
- 対応目標時間:目標とする時間内に対応できるかを、現場の業務フローのなかで試す
- 継続利用のしやすさ:担当者が操作を続けられるか、既存業務に組み込めるかどうか
技術的な完成度よりも、担当者が使い続けられるかという運用面を重視します。そうすることで、課題を本稼働の前に洗い出せます。
PoC:技術的実現性の検証と期間・費用の目安
PoC(概念実証)は、技術的な実現性を検証する手法です。新技術や自動化ツールが既存システムと連携できるかを確かめます。さらに、検証項目ごとの期間や費用の目安も確認します。
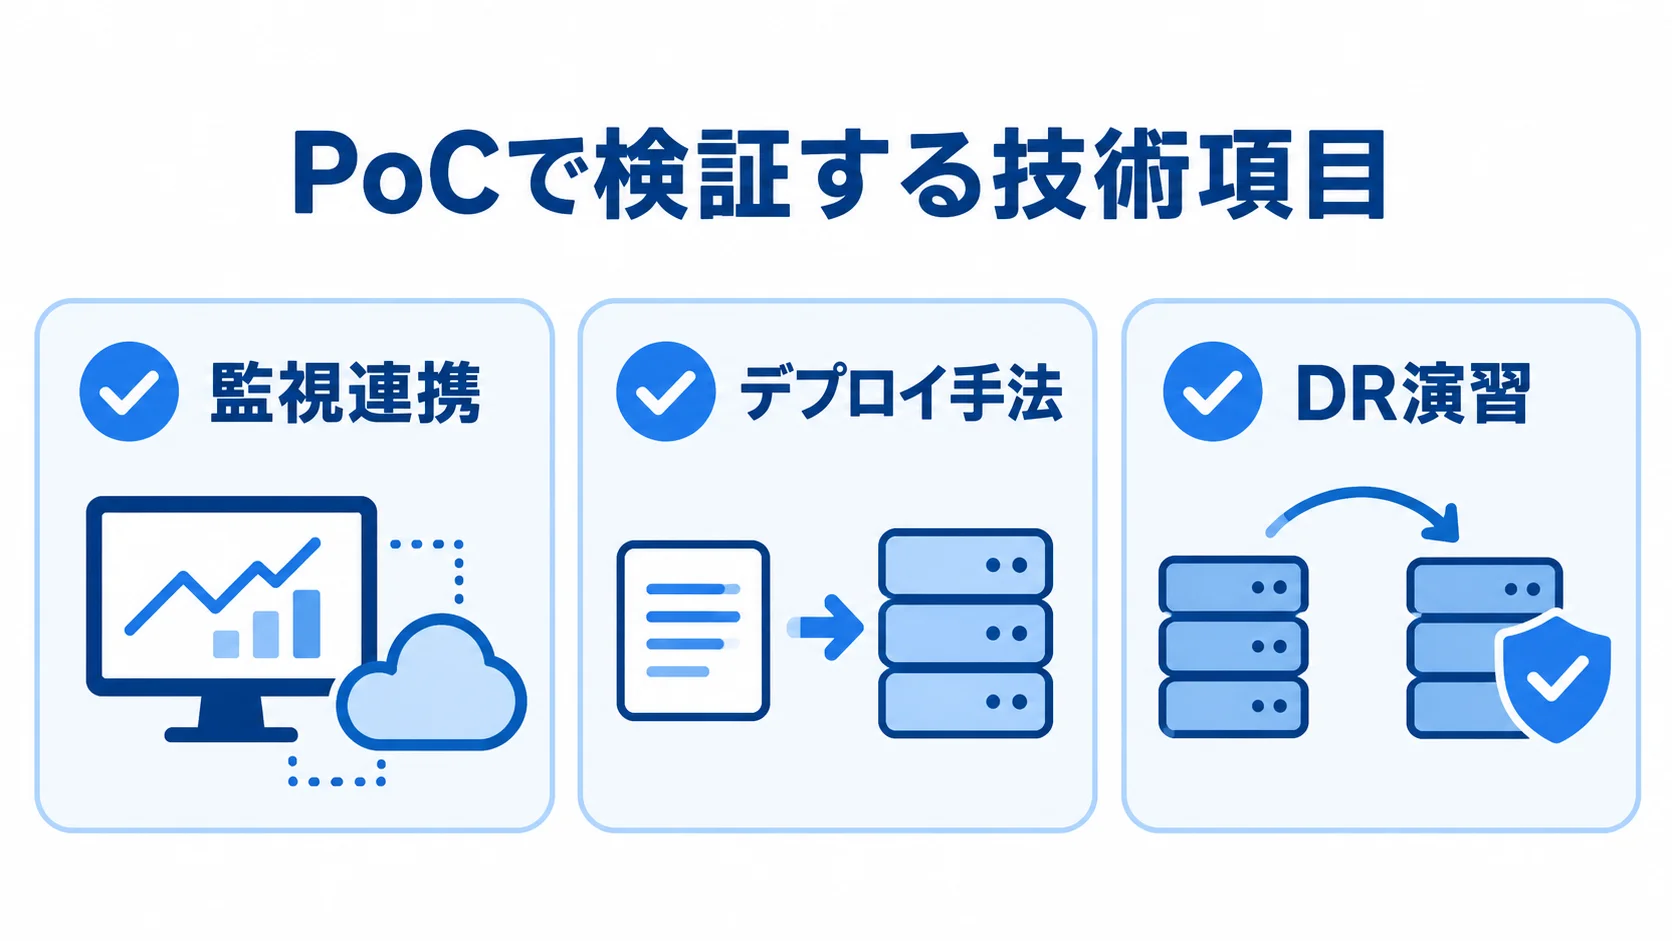
PoCで検証すべき項目—監視連携・デプロイ手法・DR演習
保守体制構築のPoCでは、既存環境との連携や障害時の復旧を本稼働の前に試すため、代表的な項目を検証します。
- 監視連携:クラウドの稼働監視・セキュリティ監視と既存アーキテクチャの連携
- デプロイ手法:インフラ層をIaCでコード化したうえで、リスクの低いカナリアリリースやブルー/グリーンデプロイが保守運用で機能するかを試す
- DR演習:障害時に計画どおりシステムを復旧できるかを、実際に確かめる
DR演習は、監視の整備だけでは確認できない復旧手順を実証するため、技術検証のなかでも特に重要です。
期間・費用の目安
モックアップ、プロトタイプ、PoCでは所要期間が異なり、費用は検証の規模によって変わります。
- モックアップ:約1〜2週間
- プロトタイプ:1〜3週間(パイロット運用を含む)
- PoC:数日〜2週間。長くなる場合も、最長3ヶ月程度で区切る
- 小規模な検証:一部の監視連携や簡易なアラート自動化などで50万〜100万円
- 中規模PoC:既存システムとの連携を含み、100万〜300万円
期間はいずれも、検証範囲を限定した場合の目安です。検証費用は、本稼働の費用とは別枠で確保します。また、初期費用より小さな投資で、技術や体制が機能するかを判断できます。
本格稼働への移行判断基準
検証の後に本格稼働へ進むか見直すかは、あらかじめ定めた基準で判断することが、体制構築の成功に欠かせません。基準が曖昧なまま移行すると、現場が回らなくなるおそれがあります。そのうえで、価値、運用、経済の3レイヤーそれぞれに継続判断の指標を設け、基準に沿って判定します。
価値・運用・経済の3レイヤーでのゲート判定
3レイヤーの指標は、検証を始める前に本格稼働の水準として決めておきます。結果を見てから基準を都合よく解釈しないことが大切です。
- 価値:新しい保守体制や自動化で、対応時間が短縮したかを確認する(例:時間削減率30%以上)
- 運用:エラー・不具合の発生率は5%以下、問い合わせは1人あたり月0.5件以下などを指標にする
- 経済:運用工数の削減が費用を上回るかどうか(ROI20%以上が目安)
運用面では、現場で安定して使えるかを定性と定量の両面から測ります。さらに、使いやすさや運用への耐性も評価します。経済面では、ライセンス、インフラ構築、研修の費用を確認します。
本格稼働(GA)判定における追加の品質ゲート
一般提供(GA)の最終判定では、3レイヤーに加えて品質ゲートを確認します。稼働中のシステムを扱うため、検証では見えなかったセキュリティや監査の問題が、本稼働の直前に表面化することもあります。
- SLO/SLI:サービスレベル目標・指標の達成状況
- 脆弱性:重大な脆弱性が残っていないこと
- 監査:監査要件を満たしていること
セキュリティと監査のゲートも満たして初めて、保守体制を本格稼働へ移せます。
検証フェーズでよくある失敗と回避策
稼働中のシステムを扱う保守体制の検証から本稼働へ移る際には、特有の注意点があります。代表的な失敗パターンを、回避策とあわせて確認します。
失敗系の設計漏れと責任分界の後回し
連携の際には、障害時の振る舞いを開発会社と設計しておく必要があります。対象は、タイムアウトとリトライ、縮退運転、レート制限です。そうしないと、新しい監視ツールや外部API側の障害が、稼働中の既存コアシステムまで止めるおそれがあります。
責任分界やガバナンスを後回しにすると、本稼働の時点で運用が回らなくなるおそれがあります。そこで、運用・障害対応と権限付与・監査対応について、RACI(責任分界)を発注側と開発会社で明確にしておきます。
データアクセス権限や監査ログの要件も、早い段階で確認しておきます。早い段階で確認しないと、稼働直前にセキュリティ部門の承認を得られず、計画が頓挫するリスクがあります。
DR演習の欠如と現場リソースの過小評価
検証の際には、非常時に復旧できるか、現場の業務に負担が生じないかを確かめます。
- 第三の失敗:DR(災害復旧)演習の欠如:演習がないと、復旧できる想定でも実行できない事態が起こりえます。
- 第四の失敗:現場リソースの過小評価:業務や課題を理解しないまま試すと、現場の反発を招き、体制が定着しないおそれがあります。
平常時の監視だけでなく、非常時の復旧手順まで実際に確認します。また、検証の早い段階から現場の担当者を巻き込み、触ってもらって出た意見をシステムに反映します。
検証で分かったこと、分からなかったこと、事故防止のための制約は、意思決定ログに残します。そのうえで、その内容を本開発の要件定義や基本設計へ引き継ぎます。
検証フェーズ全体の進め方
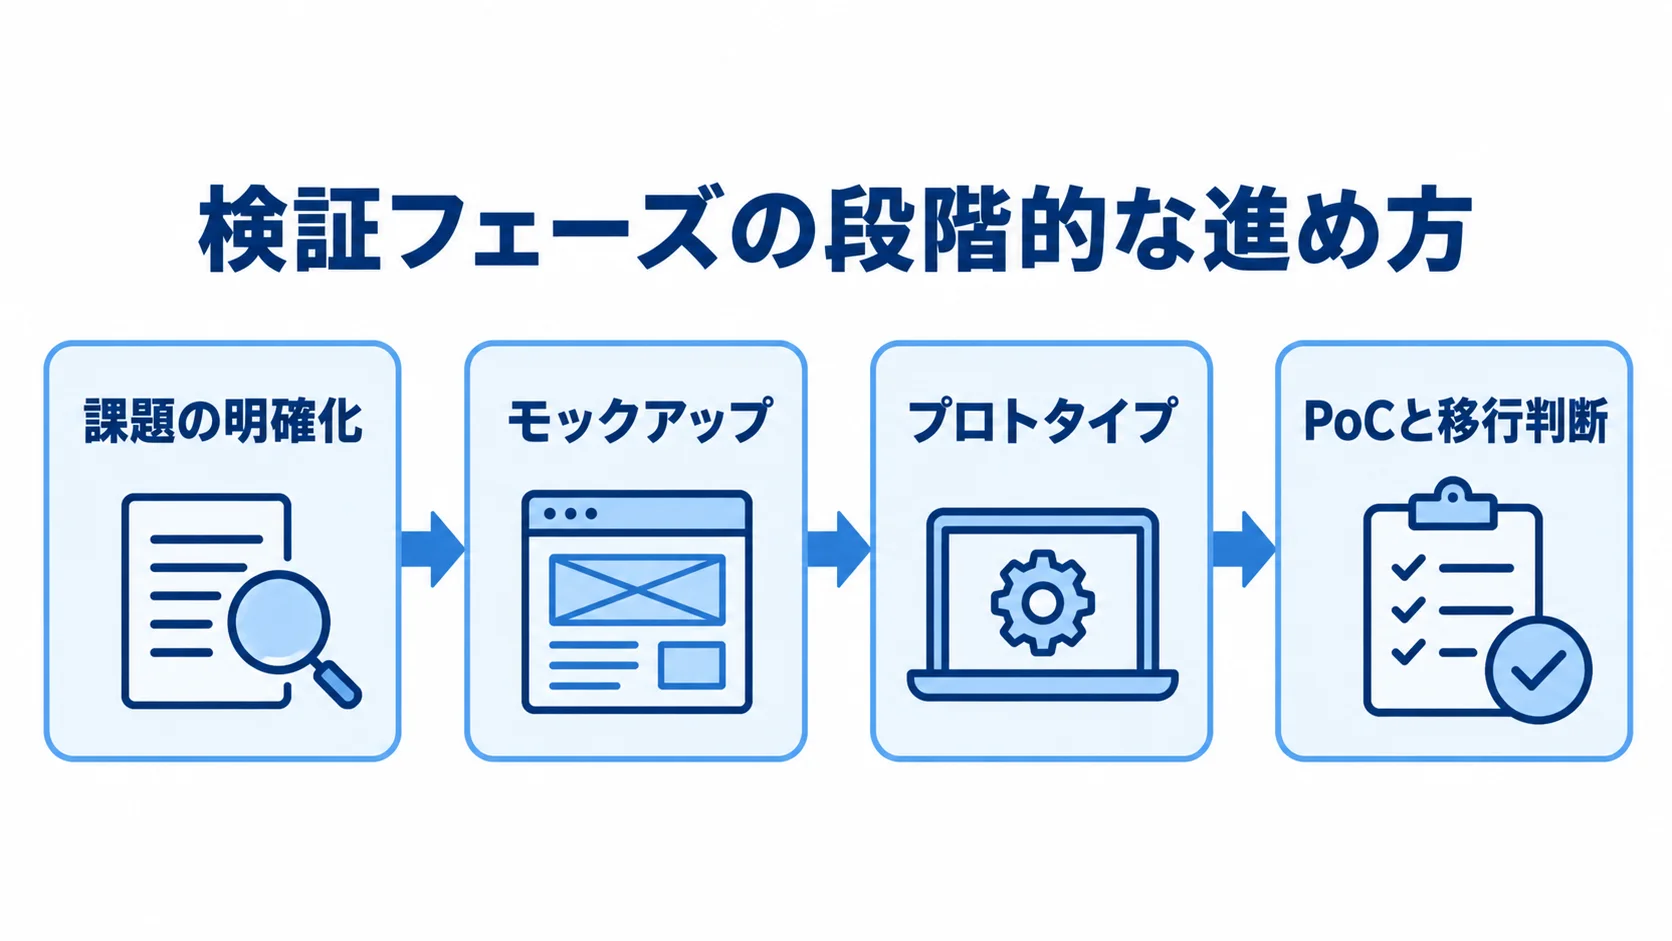
ここまで3手法を個別に見てきましたが、保守体制構築では段階的に組み合わせるのが基本です。全体の流れを理解しておくと、限られた予算でも移行判断の材料を効率よく得られます。
「課題の明確化→モックアップ→プロトタイプ→PoC→本格稼働判断」の流れ
検証では、まず課題を明確にし、そのあとで手法を段階的に進めて本格稼働の可否を判断します。
- 課題の明確化:監視業務の属人化解消、ベンダー切り替え、自動化ツール導入など、実現したい課題を決める
- モックアップ:監視画面や運用手順のイメージを、現場と合わせる
- プロトタイプ:影響度の低い一部のシステムやサーバーで、チームを先行して稼働させ、サポート導線と業務フローが合っているかを確かめる
- PoCと移行判断:監視連携、デプロイ手法、DR演習を検証し、3レイヤーで移行の可否を判断する
この流れは1〜3ヶ月程度で区切り、大きな投資判断を小さな段階に分けて進めます。ただし、技術リスクが低く、モックアップやプロトタイプで十分に合意できる場合は、PoCを省いて本稼働へ進む柔軟さも大切です。
検証対象の絞り込みと本開発への引き継ぎ
検証対象と本開発への引き継ぎは、不確実性や影響範囲に合わせて整理します。
- 検証規模:保守体制の不確かさに応じて決める。既存の監視ツールを継続利用するだけなら、大がかりな検証は不要
- 対象範囲:ベンダー全面切り替えや自動化ツール導入のように影響が大きい場合は、検証にかける価値が高まる。影響の低い一部のシステム・サーバー群に絞る
- 本開発への引き継ぎ:分かったこと、未確認のこと、事故防止の制約を意思決定ログにまとめ、要件定義や運用設計へ渡す
- 検証規模の上限:本稼働と同じ規模にはせず、判断材料に必要な最小限に抑えることが、プロジェクト成功の鍵です
まとめ
ここまで、ITシステム保守体制構築での3手法の使い分けと、PoCの技術項目・期間・費用、移行判断、失敗の回避策を見てきました。モックアップで見た目、プロトタイプで運用、PoCで技術的な実現性を確かめます。
費用は、数十万円〜300万円程度のスポット予算が目安で、本稼働の体制構築費用とは別に確保します。また、本格稼働の判定は、3レイヤーに加えてSLO/SLIや監査要件も事前に明文化し、その基準で行います。
失敗系の設計や責任分界、DR演習、現場リソースを確認し、現場の担当者を早くから巻き込みます。小さく検証して確度を高める進め方は、開発・運用のパートナーと一緒に設計します。
▼全体ガイドの記事
・ITシステム保守構築の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。