
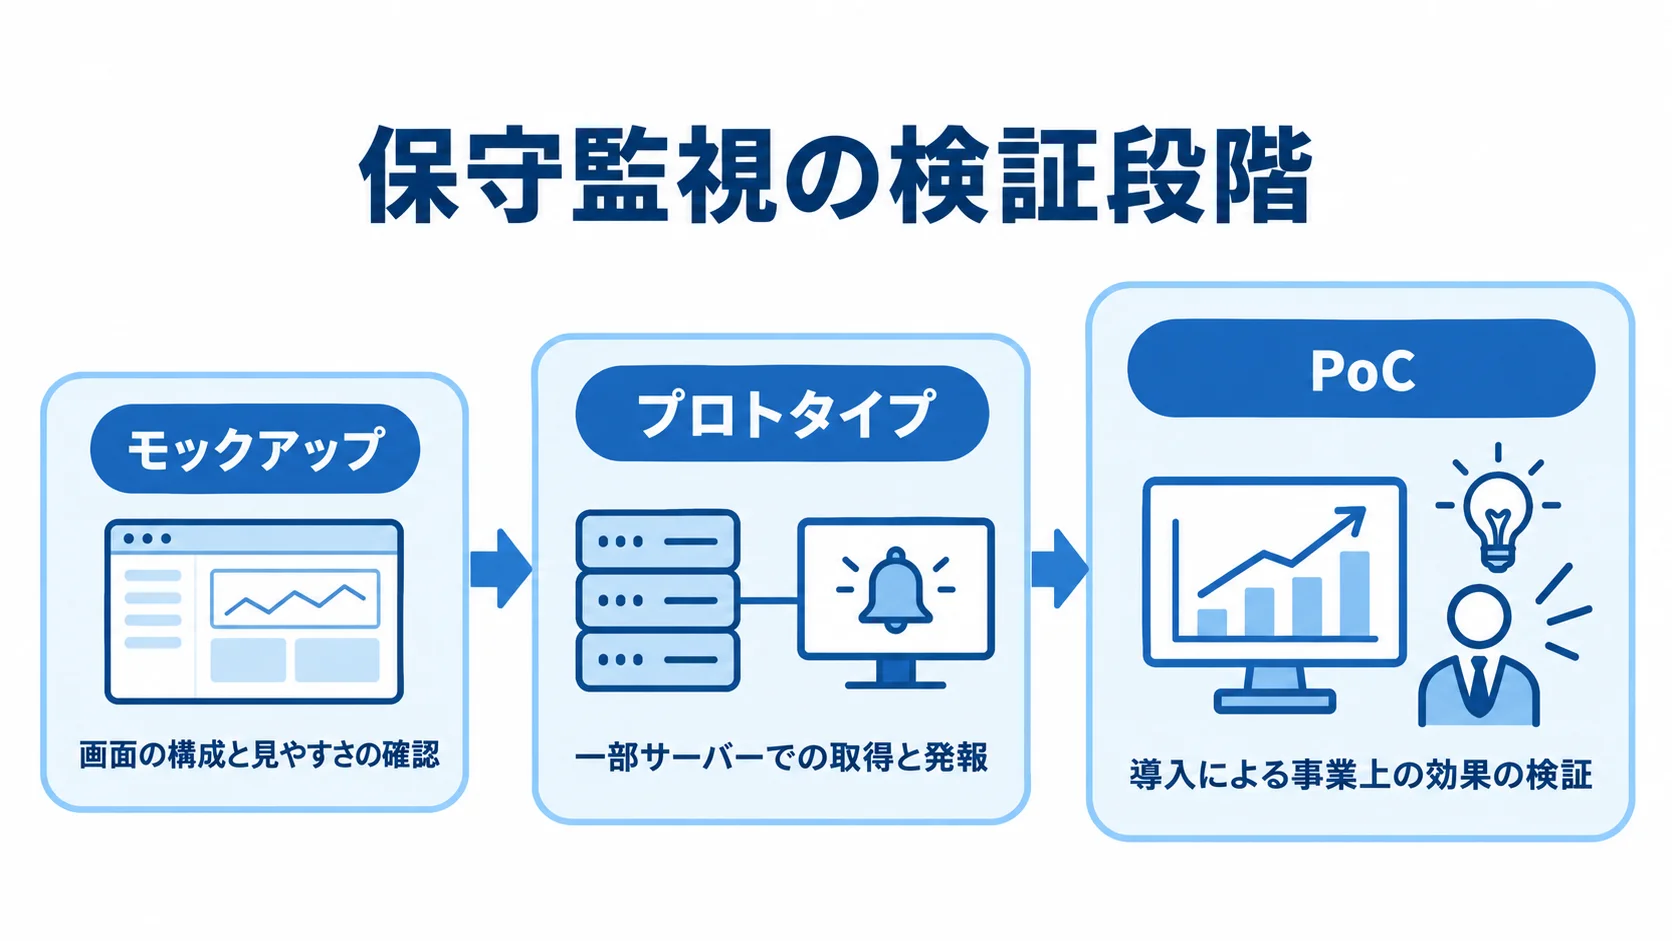
保守監視の検証は、モックアップで見た目を、プロトタイプで検知・通知の動作を、PoCで工数削減などの効果を、この順に小さく試す進め方が有効です。
各段階の結果を見てから、検知精度やSLA、コスト、現場の受容性を総合して、本格導入を判断します。
▼全体ガイドの記事
・ITシステム保守監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
保守監視におけるモックアップ・プロトタイプ・PoCの違いと定義
ITシステム保守監視は、稼働中のシステムを常時見張る実務です。CPU使用率やディスク容量、応答速度の異常、機器停止を検知すると、迅速にアラートを発報します。さらに、SLA(サービスレベル合意)に基づいて一次対応と復旧対応を行います。
本番稼働後は、ツールや委託先の切り替えに高いコストがかかります。そのため、導入前の検証の丁寧さが、その後の運用品質を左右します。
保守監視の検証では、SLAの妥当性、現場での使い勝手、委託先との相性を確かめます。
本格導入の前に、システムの一部を実際の監視対象に加えます。そのうえで、障害検知から報告までの流れをシミュレーションし、提案されたSLAの実現性も測ります。
SLAの確認では、たとえばインシデント応答30分以内や報告精度を数値で確かめます。また、自社ユーザーが違和感なく使えるかも、実際に体験して評価します。
- モックアップ:動作しない画面や通知を使った、画面の構成と見やすさの確認
- プロトタイプ:一部サーバーにエージェントを入れ、取得と発報を試す
- PoC:導入による事業上の効果の検証
モックアップ、プロトタイプ、PoCの順に、検証の深さと再現性が増していきます。見た目、動作、効果とコストを段階的に確かめたうえで、本導入を判断します。
現場のオペレーターが、UIや通知文面を見やすく分かりやすいと感じるかどうかを確かめます。
PoCでは、手作業の監視・確認業務を自動化や委託でどれだけ減らせるかを検証します。さらに、SLAの復旧時間を達成できるかも確かめます。
トライアル期間の目安
既存のSaaS型監視ツール(例:Site24x7)では、全機能を使える最初の30日間を無料評価期間とするケースが一般的です。無料期間であれば、実環境で費用負担なく機能を検証できます。
トライアルは、モックアップ、プロトタイプ、PoCを一貫して試す期間です。まず、最初の1〜2週間でUIと通知形式を確認します。
続く1〜2週間はエージェントを動かし、検知・通知を確認します。終盤には効果を測定します。こうした段階的な進め方は30日間でも可能で、無料期間であれば追加のスポット予算も不要です。
アウトソーシング活用時のPoC—人と組織の相性の確認
監視・障害対応を委託するPoCでは、技術面に加えて委託先との相性も確かめる必要があります。そこで、日常業務や軽微なアラート対応を一定期間任せます。
- 連携:エンジニアとの連絡が円滑に進むか
- 改善提案:委託先が改善案を積極的に出してくるか
- 緊急対応:夜間・休日の初動や報告が丁寧か
委託先の人や組織の相性は、提案書や価格表、契約前の面談で確かめるのが難しい項目です。
複数の委託先候補がある場合は、本契約の前に、小さな範囲で短期間のトライアル委託を依頼します。また、実際の業務品質を比べる方法も有効です。
技術面と人・組織の相性の両方を検証することで、アウトソーシング選定の失敗を防げます。
スモールスタートの手法とプロトタイピング
すべての機器やメトリクスを一度に監視しようとすると、設定が膨大になって失敗を招きます。そのため、保守監視の検証では、対象範囲を絞るスモールスタートが有効です。
監視対象と監視項目の絞り込み
まず、基幹ルーターや重要サーバーなど数台を対象にします。監視項目は、停止すると業務が止まる機器の死活監視(Ping監視)から始めます。
CPUやメモリ、ディスクに加えてネットワークトラフィックまで一度に加えると、閾値の検証項目が増えて検証が長引きます。そこで、優先度の高い項目から段階的に増やします。
費用や委託範囲を抑えて試す方法は、3つあります。
- 無料プラン:4ホストまでのサーバー・Webサイト監視と、1アプリのAPMが使える例もあります。
- 有料プラン:従量課金や、10ホストまでの小規模プランに移行できます。
- 委託範囲:夜間・休日の監視や、重要システムに絞って試す
対象を絞ると、設定ミスや見落としの影響を抑えられ、短期間・低コストで結果を得られます。効果を確かめた範囲から、対象、SLA水準、委託範囲を順に広げます。
ダッシュボード・アラート設計のプロトタイピング
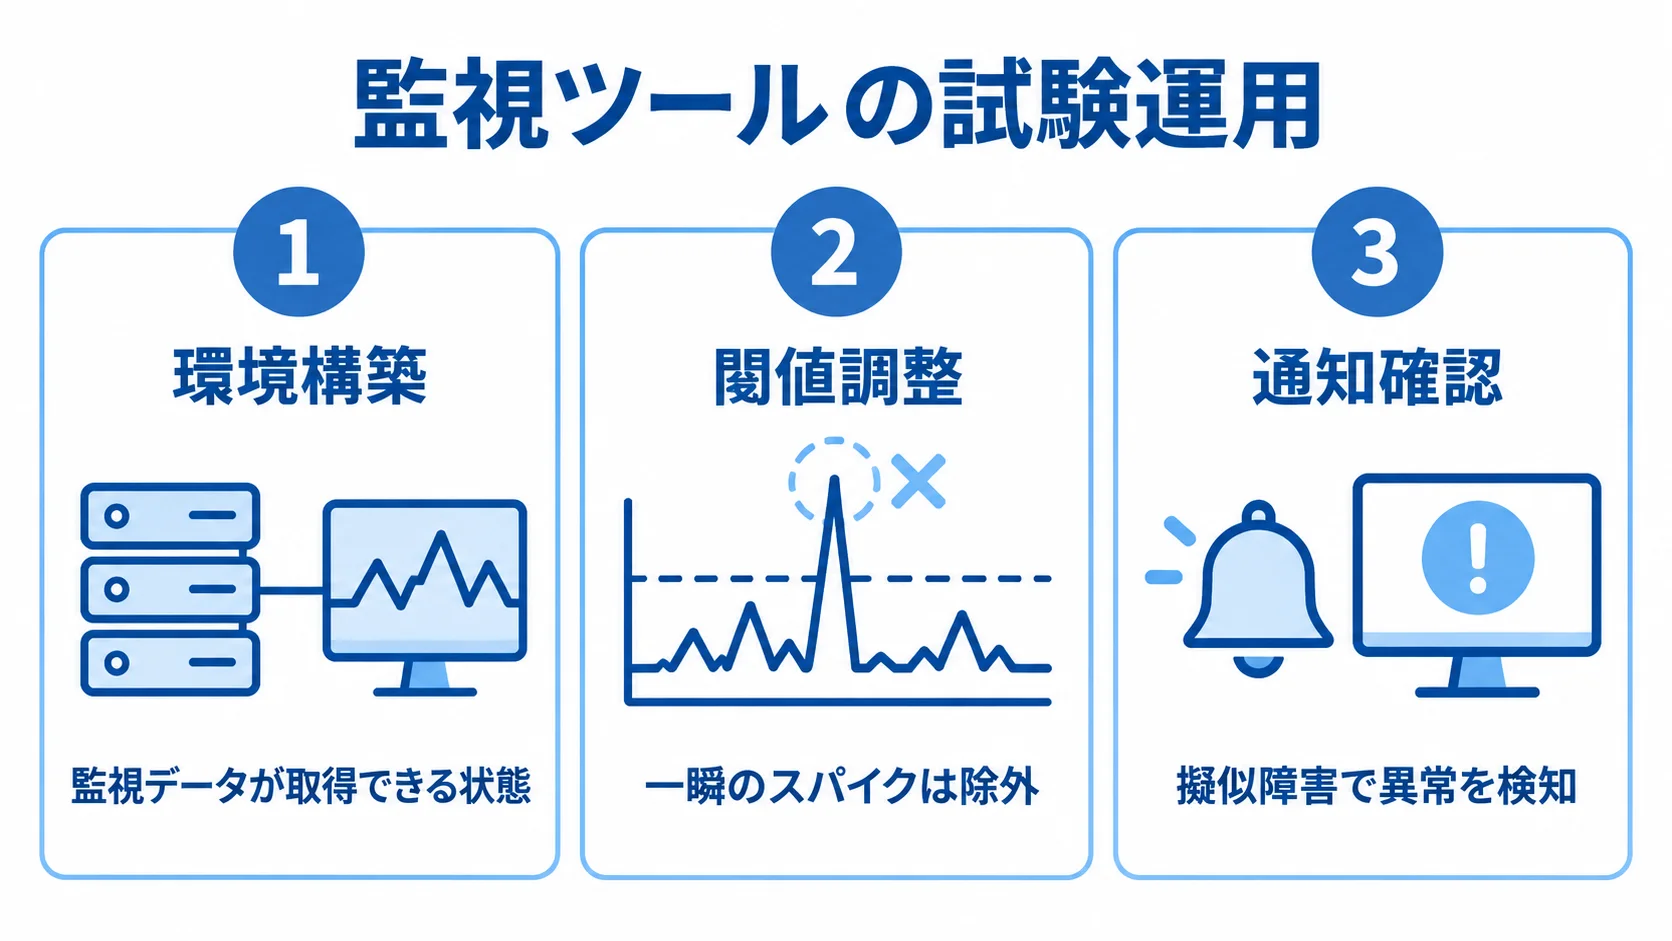
監視ツールの試験運用では、ダッシュボードに何を表示するかと、アラートの調整を、プロトタイプとして作って検証します。
- 環境構築:監視データが取得できる状態をつくる
- 閾値調整:一瞬のスパイクは除外し、5分継続した場合に通知する
- 通知確認:擬似障害で、異常が検知されるかを試す
Ubuntuなどの仮想マシンに、DatadogやSite24x7のエージェントを入れます。次に、CPUやメモリ、ディスク使用量、Syslogがグラフ化され、ホスト名も取得できるかを確認します。
デフォルトでは、CPU使用率80%で通知する設定例があります。そのため、試験運用中にアラートが鳴りすぎる場合があります。
ツールを設定したら、LANケーブルを抜くなどして擬似障害を起こします。そのうえで、メールやSlack、Teamsなど設定先へ即時に通知されるかを確認します。
環境構築、閾値調整、通知確認の3段階を試すことで、本番導入後の検知漏れや通知未達を防げます。
本格導入への移行判断基準
発注側と開発会社で、移行の基準を検証の前に決めておきます。「問題なさそう」という曖昧な判断のままだと、導入後に通知が多すぎたり、必要な検知が漏れたりすることがあります。
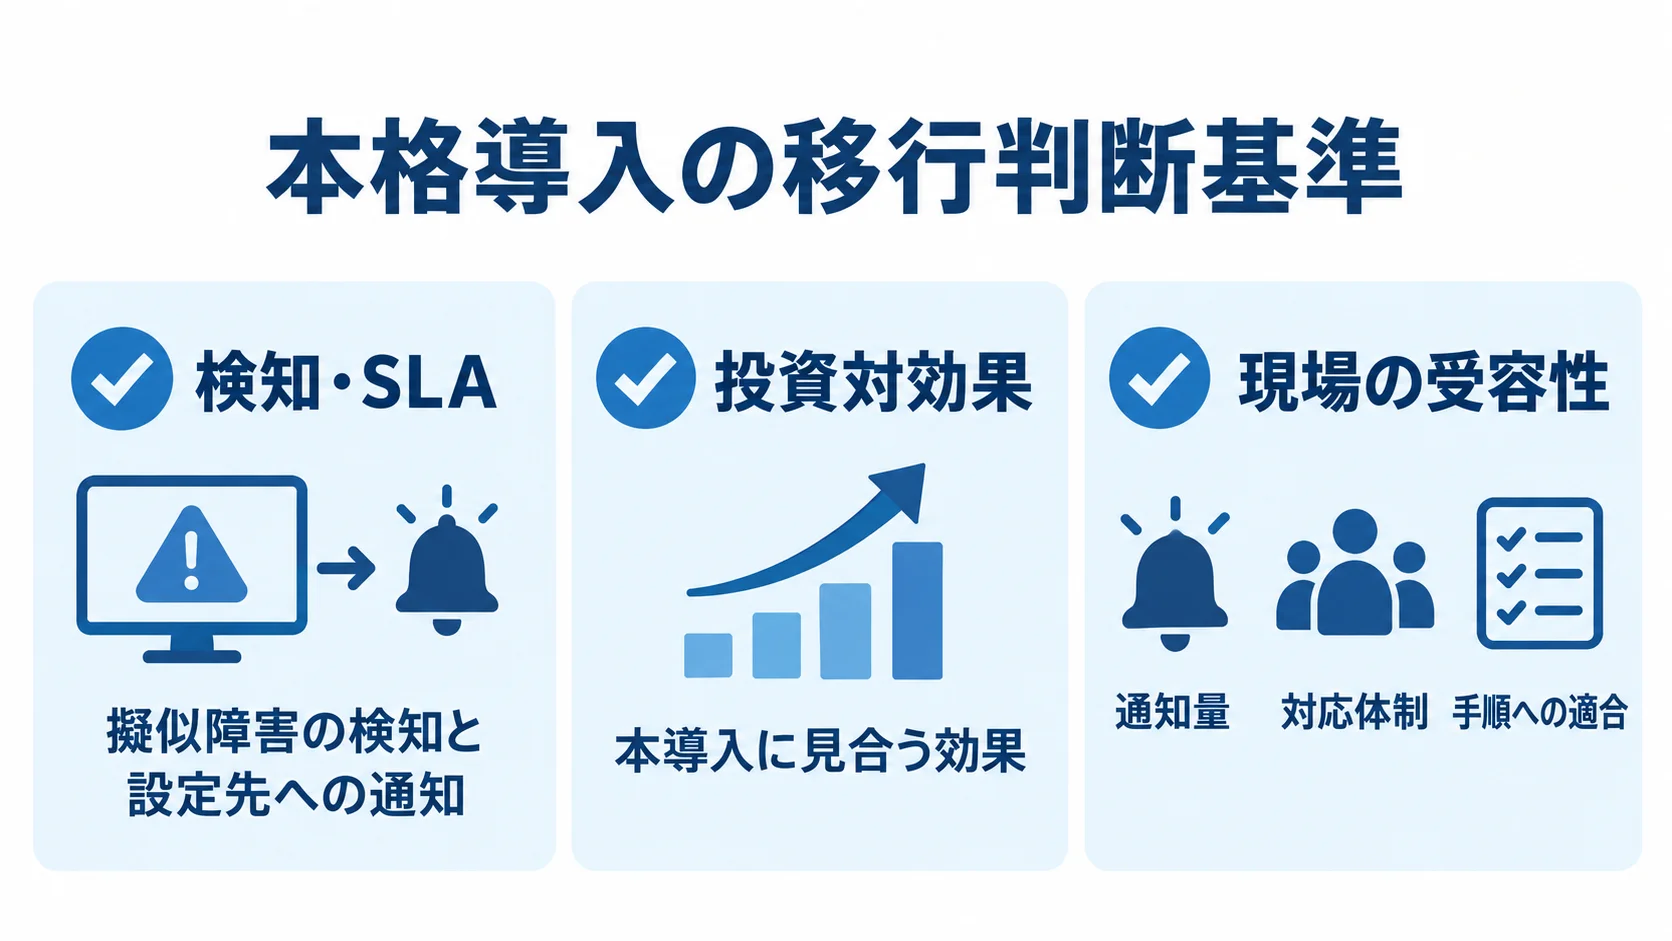
判断では、検知精度、コスト面、現場の受容性を確認します。基準を先に決めておけば、結果を都合よく解釈するのを避けられます。
検知精度・SLA達成度とコスト面の基準
本格導入を判断するときは、検知の確実性と、運用コストに対する効果の両面から見ます。
- 検知・SLA:擬似障害の検知と、設定先への通知が基準を満たしているか
- 投資対効果:本導入に見合う効果があるか
「応答30分以内」「重大障害の復旧4時間以内」などの目標SLAを、試験運用で達成できるかを確認します。
見逃しや通知遅延があれば、閾値や通知フローを見直し、再検証します。
ツールの導入・運用費用と、手作業の監視・確認を減らせる工数を比べます。具体的には、削減できる工数が費用を上回るかを試算します。
本導入の水準は、検証の前に数値や条件で定めておきます。そうすると、複数のツールや委託先も、担当者の主観に頼らずに比べられます。
現場の受容性という判断基準
基準を満たしていても、現場が通知の多さや見づらさを感じるなら、導入を見送ります。日々対応する人が使い続けられてこそ、仕組みの効果が出ます。
現場の担当者が日々アラートに対応するため、保守監視は情報システム部門だけで完結しません。
- 通知量:業務に支障がない水準に収まるか
- 対応体制:複数人で分担できるか
- 手順への適合:既存の運用手順書に沿って組み込めるか
検証の段階から現場を巻き込み、画面や通知について意見をもらいます。シフト勤務や当番制の現場なら、複数人に試してもらい、特定の一人だけに頼らない体制かも確かめます。
検知精度、SLA、コスト、現場の受容性を総合して、移行の可否を判断します。
検証フェーズでよくある失敗と回避策
保守監視の検証にも、よくある失敗のパターンがあります。代表的なものは2つで、通知が多すぎることと、検知や通知の抜けです。小さく試しても、進め方を誤ると本導入の判断ができず、現場に受け入れられないことがあります。
「アラート地獄」による現場の疲弊
閾値を調整せずに本導入すると、通知が鳴りすぎる「アラート地獄」を招きます。デフォルト設定のまま対象を広げると、無害な一瞬のスパイクにも通知されます。
担当者が通知を無視し始めると、重大なアラートまで見落とされ、監視が形だけのものになります。そこで、プロトタイプの段階で継続時間などを加えて閾値を調整し、通知量が現場の対応力に収まるかを確認します。
検知漏れ・通知未達という致命的な見落とし
擬似障害テストを省くと、検知や通知の不具合が本番稼働後に判明することがあります。エージェントや通知先の設定漏れは、平常時には気づきにくいからです。
LANケーブルを抜く、サービスを止めるといったテストで、検知から通知までを確かめます。監視対象や通知フローを変えたあとにも、同じテストを繰り返します。
モックアップでは通知の見た目を、プロトタイプでは擬似障害の動きを、現場の担当者にも確認してもらいます。出た意見を画面や通知に反映すると、本導入後の信頼性につながります。
まとめ
保守監視の検証は、見た目、検知・通知の動作、工数削減効果の順に進めます。SaaS型ツールの30日間の無料トライアルも、段階的な確認に使えます。
移行の前に、検知精度やSLA、コスト、現場の受容性を文書にして決めておきます。小さく試し、現場の意見を得ながら対象を広げる方法が有効です。
▼全体ガイドの記事
・ITシステム保守監視の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。