
ITシステムのリリース検証は、受入れテストや段階的な適用、リハーサル、切り戻し訓練を含みます。特に、段階的な適用、手順のリハーサル、切り戻し訓練を順に進めると、本番障害の影響を抑えられます。
この記事は、アプリ開発のMVPやプロトタイプではなく、本番リリースの安全検証を扱います。安全検証の柱は、本番に近い環境での確認、段階的な適用、手順の訓練であり、検証を省いた失敗事例もその必要性を示しています。
▼全体ガイドの記事
・ITシステムリリース対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
リリース対応におけるPoC・検証の位置づけ
PoC(Proof of Concept、概念実証)は、新規事業やアプリ企画の初期に、アイデアの技術的な実現可能性を確かめる活動を指すことが多いです。ここでいう検証は、新しいプログラムや構成変更が本番で問題なく動くかを、影響を限って事前に確かめるプロセスです。リリース時の検証も、PoCと同じ発想に立っています。
リリース時の検証には、本番に近いステージング環境での受入れテスト、手順のリハーサル、一部ユーザーやサーバーへの段階的な適用が該当します。検証を省いて本開発へ進むと後工程に大きなリスクを抱える点は、企画段階でPoCを省く場合と共通します。
モバイルアプリやWebサービスは更新頻度が高く、リリースサイクルが短いほど、毎回の検証時間を確保しにくい圧力が現場にかかりがちです。しかし、検証で得る時間短縮よりも、本番障害への対応コストや信用を失うことの方が大きいという教訓が、多くの現場で示されています。
リリース頻度が高いプロジェクトほど、検証を担当者個人の丁寧さに頼らず、自動化や標準化によって仕組みにする必要があります。
リリースにも「検証」が必要な理由
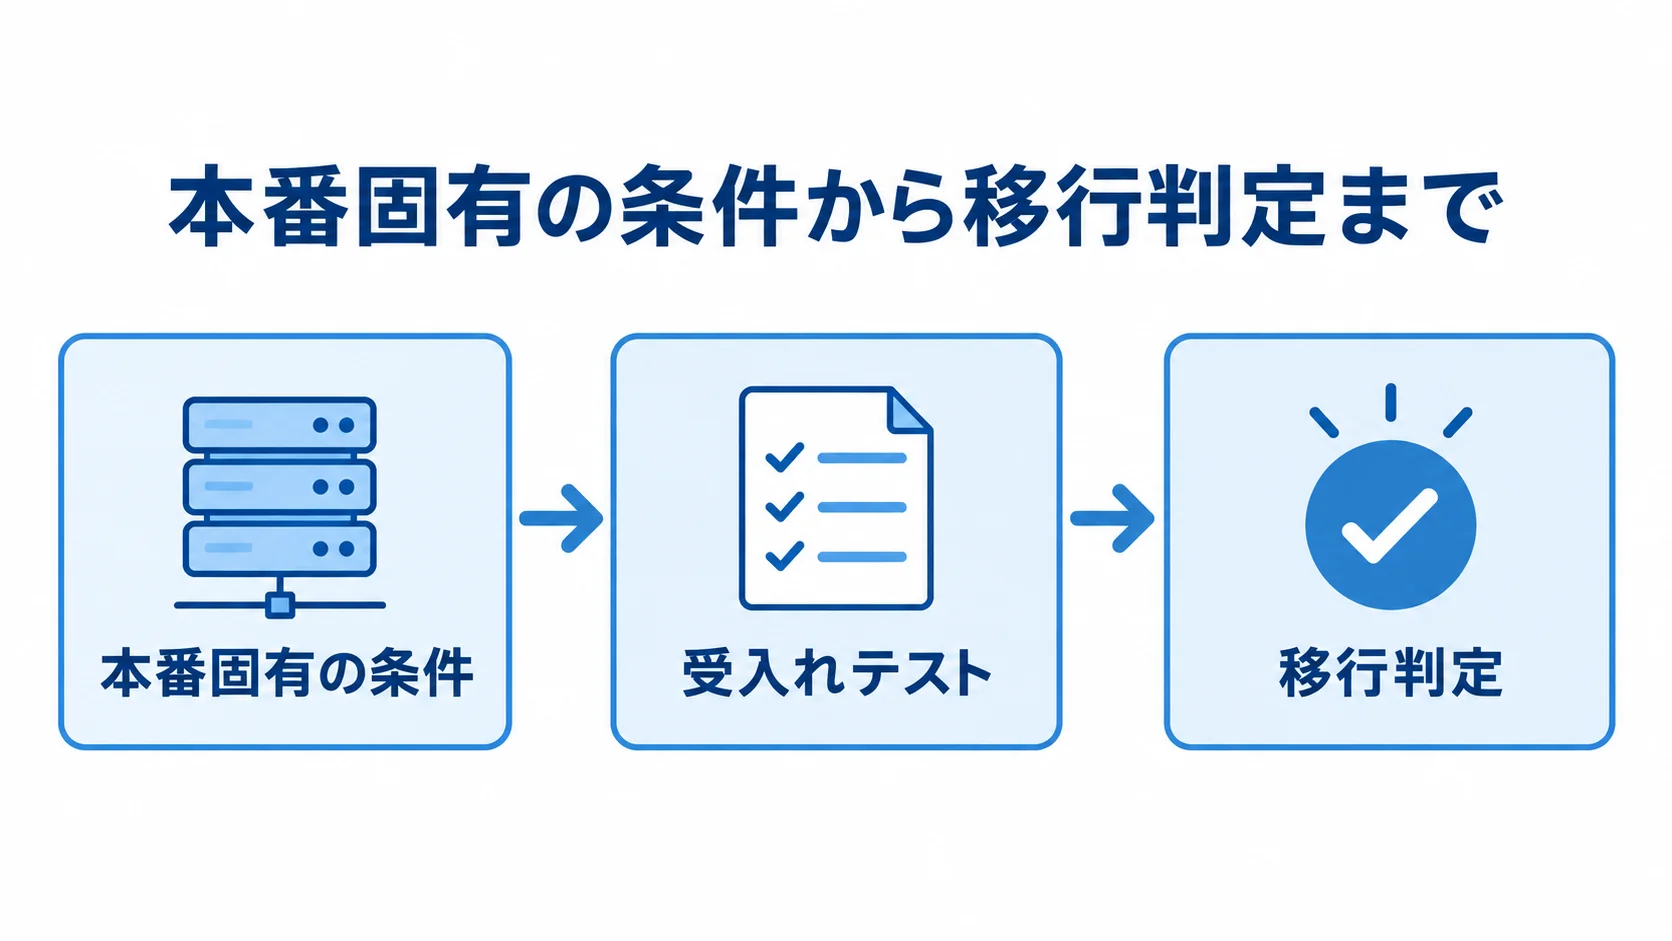
ユニットテストや結合テストを丁寧に行っても、本番環境固有の条件をすべて事前に再現することはできません。本番には、開発・テスト環境と桁違いのデータ量や、予測しづらいアクセス、外部システムとの本番用連携設定があるためです。
受入れテストでは、本番に近い環境でリスクを評価し、そのうえで本番へ移行するかを判定します。
- 本番固有の条件:テスト環境で再現しきれないデータ量やアクセスを見ておきます。
- 受入れテスト:本番に近い環境で、動作とリスクを確かめます。
- 移行判定:確認結果をもとに、本番へ進むかを決めます。
開発完了だけを理由に移行すると、テストで見えなかった問題が本番で表面化し、ユーザーに影響する障害へ発展するおそれがあります。
ステージング環境と本番環境に近いテスト環境
リリース前検証の中心になるのは、本番環境に近い構成を持つステージング環境です。構成が本番とかけ離れていると、受入れテストの結果から本番での動作を保証することはできません。
理想的には、本番との差を小さくしておくことが望まれます。ただし、コストや構成上の制約で近い環境を用意できない場合は、テストが不十分になる可能性があります。
- 環境の構成:サーバー、ミドルウェア、外部連携先を本番に近づけます。
- テストデータ:本番相当のデータ量に近いものを用意します。
- 制約の共有:環境を合わせられない場合の対応と許容するリスクを、発注側と開発会社が事前に協議します。
環境への投資を抑えると、本番で予期せぬトラブルが起きる確率が高まる、というコストとリスクの関係を理解しておく必要があります。
そこで、近年はInfrastructure as Codeにより、本番構成をコードで定義し、必要な時に同等のステージング環境を再現しやすくする取り組みも広がっています。この仕組みを整えれば、環境を常時維持するコストを抑えつつ、検証の質を保ちやすくなります。
段階的リリースという「実践的なPoC」
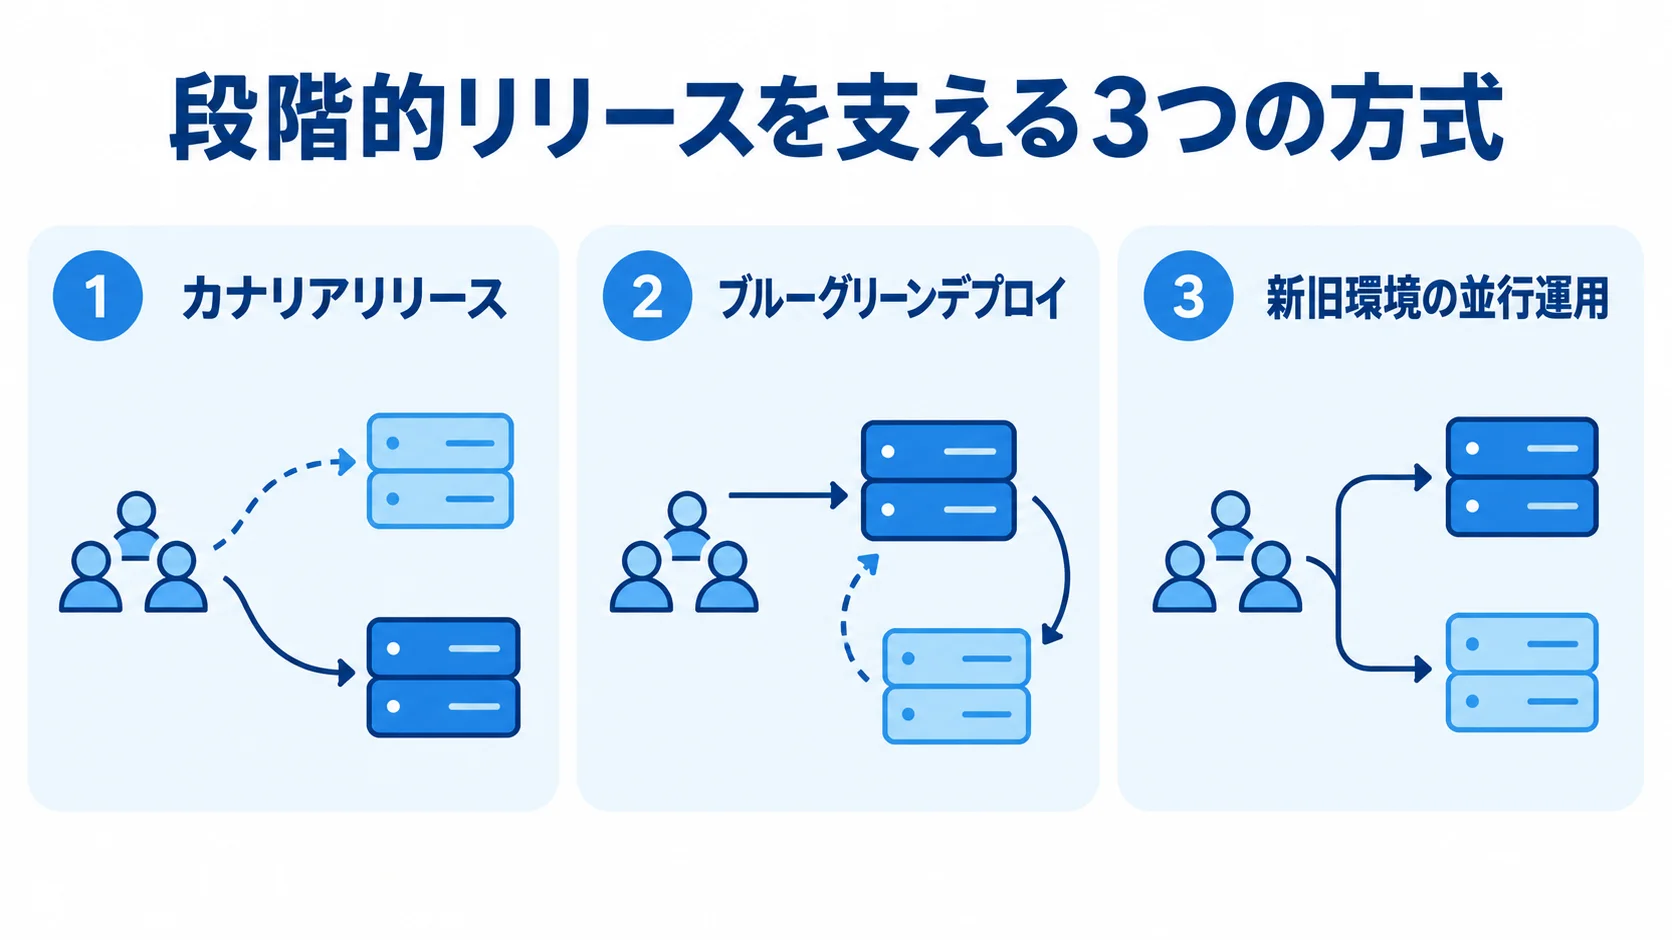
ステージングで事前検証した後も、全ユーザーへ一斉に切り替えず、影響範囲を限定して本番適用を広げる方法があります。これは、本番で小さく試して安全を確かめてから広げる実践です。また、共通フレームでも、新旧環境の並行運用と移行評価のレビューが定められています。
カナリアリリース
カナリアリリースは、新バージョンを一部のユーザーやサーバーに先行公開して、問題を監視する手法です。
- 対象を限定:先行適用する範囲を一部に絞ります。
- 異常を監視:実トラフィックの一部で問題の有無を見ます。
- 適用範囲を拡大:異常がなければ段階的に広げ、最終的に全体に反映します。
不具合が起きても影響を一部にとどめられます。そのため、切り戻しの判断と対応時間を大幅に縮められます。
一斉切り替えでは、問題が起きたときにシステム全体の緊急対応が必要になり、全体の予定が大きく遅れるおそれがあります。カナリアなら、このリスクを抑えられます。特に、24時間稼働が求められる基幹システムでは、カナリアリリースを標準の運用プロセスに組み込む価値があります。
ブルーグリーンデプロイ
ブルーグリーンデプロイは、旧版から新版への移行を、環境の切り替えで行う手法です。
- 2環境を用意:ブルー環境とグリーン環境を本番相当で運用します。
- 向き先を切り替え:ロードバランサーで新版へ移行します。
- 旧環境へ戻す:問題時は向き先を戻すだけで即時に切り戻せ、ロールバック時間を大きく短縮できます。
カナリアリリースは一部のユーザーで段階的に検証します。一方で、ブルーグリーンデプロイは全体を切り替えますが、すぐ戻せる状態にしておきます。
採用する手法は、システムの特性やリスク許容度に応じて使い分けます。どちらも、問題が起きたときに早く安全な状態へ戻せる設計である点は共通しています。
新旧環境の並行運用とレビュー
高度な仕組みがなくても、新旧環境を一定期間動かして結果を比べれば、段階的リリースに近い安全性を確保できます。
- 新旧環境を並行運用:旧環境をすぐに止めず、新環境の妥当性を確認します。
- 移行をレビュー:問題がないことを確認してから旧環境を段階的に停止します。
- 結果を監視:手法に応じて、見るべき指標を変えます。
旧環境が動いているうちに不具合を見つければ、ユーザーへの影響を抑えて修正できます。大がかりな仕組みを導入できない場合も、この発想は取り入れられます。
カナリアでは先行公開範囲のエラー率や応答時間を、ブルーグリーンでは切替直後の全体の挙動を監視します。また、並行運用では新旧の処理結果の差をリアルタイムで把握します。小さく試すことと、その結果を正しく観測することは、切り離せない関係にあります。
リハーサル・ドライランの実施
段階的なリリースと同じく、本番反映の作業そのものを事前にリハーサルしておくことも大切です。優れた手順書があっても、実際に作業して初めて分かる抜け漏れは残ります。
手順書に基づく導入訓練
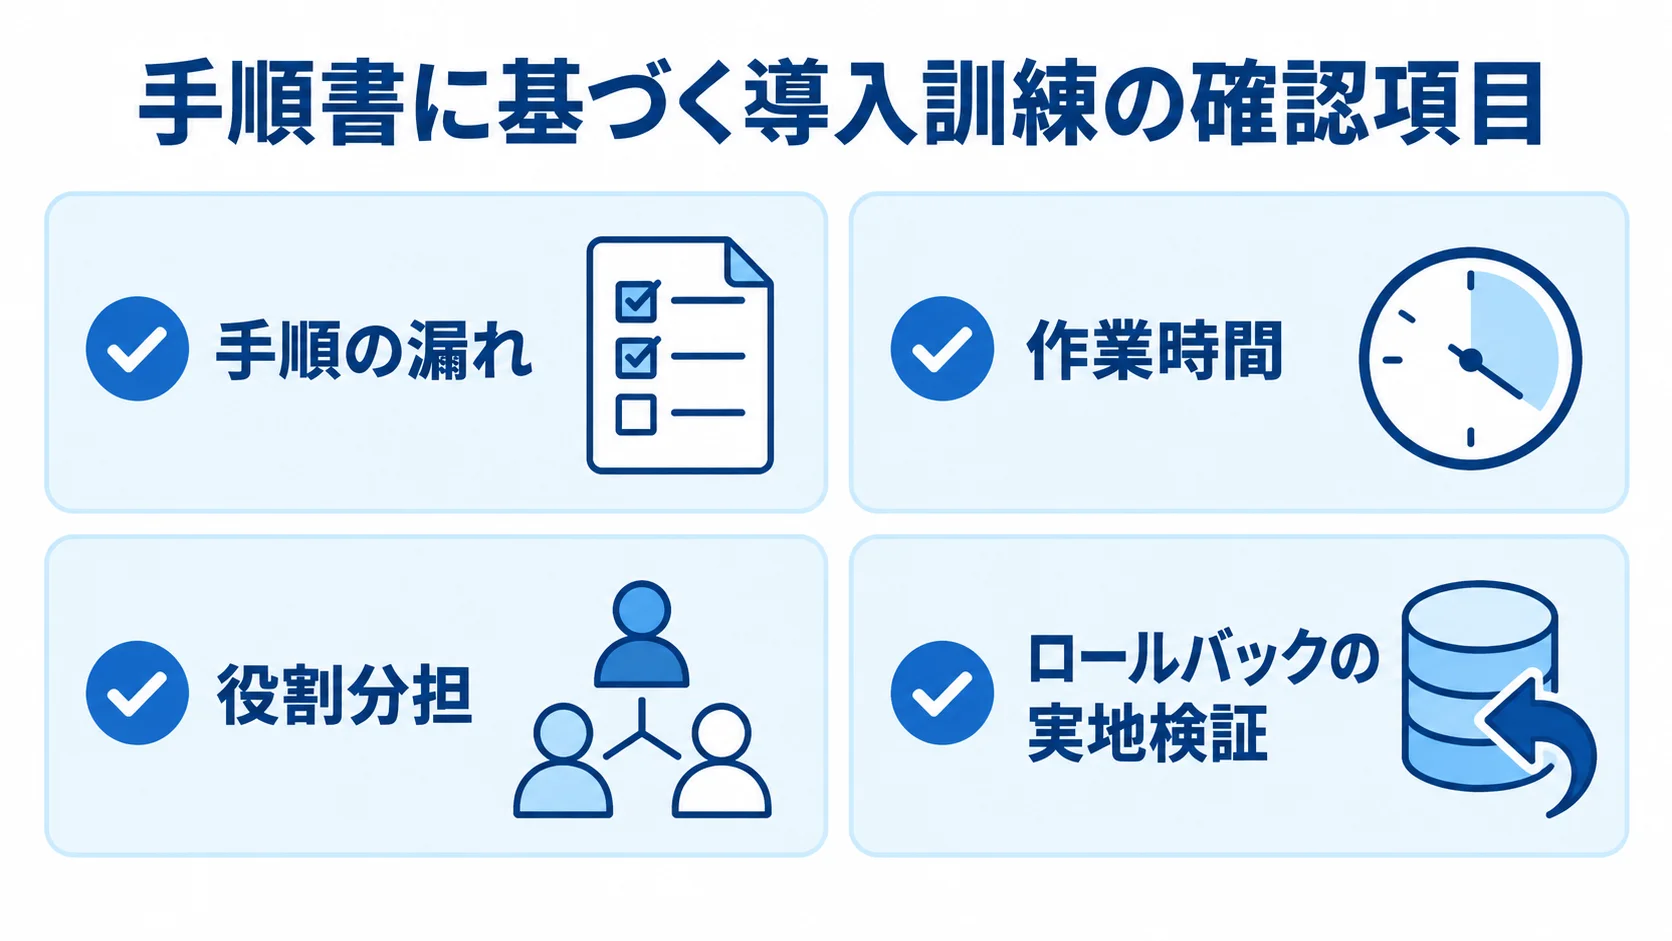
保守・運用のガイドラインは、情報システムを安定して稼働させるため、関係者間でマニュアルに基づく導入訓練(リハーサル)を行うよう定めています。
- 手順の漏れ:手順書に載っていない作業を洗い出します。
- 作業時間:想定時間と実際にかかった時間のずれを見ます。
- 役割分担:担当者どうしの連携に曖昧さがないかを確かめます。
複数のサーバーやサービスが連携する構成や、複数担当者で作業するリリースでは、訓練で連携ミスを発見できます。
事前に手順書の完成度を上げておくことが、本番作業を計画した時間内に終える鍵になります。
また、システム構成や担当者が変わるたびに、手順書と訓練内容を見直します。定期的なリハーサルをリリース管理に組み込めば、安定運用につながります。
緊急対応訓練とロールバックの実地検証
リハーサルは、正常な反映手順だけでなく、障害時の緊急対応訓練とセットで行います。
切戻し(ロールバック)の計画を文書にしただけでは、手順が機能するかは分かりません。そこで、ステージングで操作を試し、想定時間内に元へ戻せるかを検証します。訓練を重ねておけば、本番で障害が起きても、落ち着いて対応できます。
- 正常系:手順書どおりに本番反映をリハーサルします。
- 異常系:ステージングでロールバックし、復旧手順を確かめます。
- 対応力:障害時に手順どおり動けるかを見ます。
実地検証をせずにリリースを繰り返すと、手順どおりに操作しても想定外の挙動になるおそれがあります。このため、リリース前検証の仕上げとして、正常系のリハーサルと異常系のロールバック訓練の両方を行うことが推奨されます。
検証を省略した場合の失敗事例と教訓
検証を省いたときに何が起きるかは、実際の失敗事例から読み取れます。代表的な事例と、そこから導かれる教訓を順に見ていきます。
「再現しない」で片付けたことによる本番障害
テスト中に障害が起きたものの、何度か試しても再現しなかったため、原因究明を諦めて、そのまま本番リリースを迎えた事例があります。その結果、本番に新たな不具合を混入させた可能性が高まり、「なぜ発生しなくなったのか」を追うことや修正に、多大な工数を費やしました。
背景には、テストの設計や計画、構成管理、プログラム構造の明確化(保守性)への配慮が弱かったことがあります。
- 異常を軽視しない:一度でも異常が観測されたら、原因不明のまま判定しません。
- 合意を得る:判定を現場担当者だけに委ねず、複数人で確認します。
「本番で再現しなければ問題ない」という考えは危険です。特に、納期の圧力が強いほど、問題を見なかったことにする判断が起きやすくなります。
失敗から学ぶ検証プロセスの設計
テストツールを活用し、再現しない不具合を軽視せず、タイミング依存の問題を捉える仕組みを整えます。
- ログを集める:詳細な記録から再現性の低い問題を追えるようにします。
- テストを自動化:負荷やタイミングを変えて繰り返し検証します。
- 判定基準を明文化:原因不明の異常が一度でもあれば、特定までリリースを見送ります。
判定を個人の裁量にすると、納期の圧力の中で「たぶん大丈夫」と楽観的な判断へ流れかねません。そのため、組織のルールとして設計することが、同じ失敗を防ぐ確実な方法です。
失敗を一度のインシデントとして終わらせず、リリース判定基準やテスト計画を見直すきっかけにします。また、障害報告を関係者と共有し、次のリリースチェックリストに具体的な確認項目を加えて初めて、再発防止の体制が整います。
まとめ
ITシステムのリリース検証は、本番に近いステージング環境での受入れテストを基本として、安全を確かめる取り組みです。カナリアやブルーグリーンなどの段階的リリース、反映作業のリハーサル、ドライランも、その検証に含まれます。
段階的リリースは、本番全体へ一斉展開せず、影響を限って小さく試す点で、企画段階のPoCと同じ発想です。手順書に基づく訓練とロールバックの実地検証は、本番当日の混乱を防ぐ最も確実な備えです。
テストで再現しないことを理由に安全と判断するのは危険で、実際の失敗事例も、その危険性を示しています。そのため、検証を組織のルールとして定め、平時から訓練を重ねることが、安全なリリースにつながります。
▼全体ガイドの記事
・ITシステムリリース対応の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。