
サーバー監視は、死活・性能・ログの3つの役割、アラートの条件、一次対応の担当まで設計して初めて機能します。進め方は、監視対象と目的の整理、監視項目の設計、しきい値とアラートの設定、運用体制の確立の順です。この流れは、自社で立ち上げる場合も外部委託を検討する場合も、判断の土台として活用できます。
たとえば、高価なSaaSを入れても、誰もダッシュボードを見なければアラートを見落とします。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステムサーバー監視の全体像
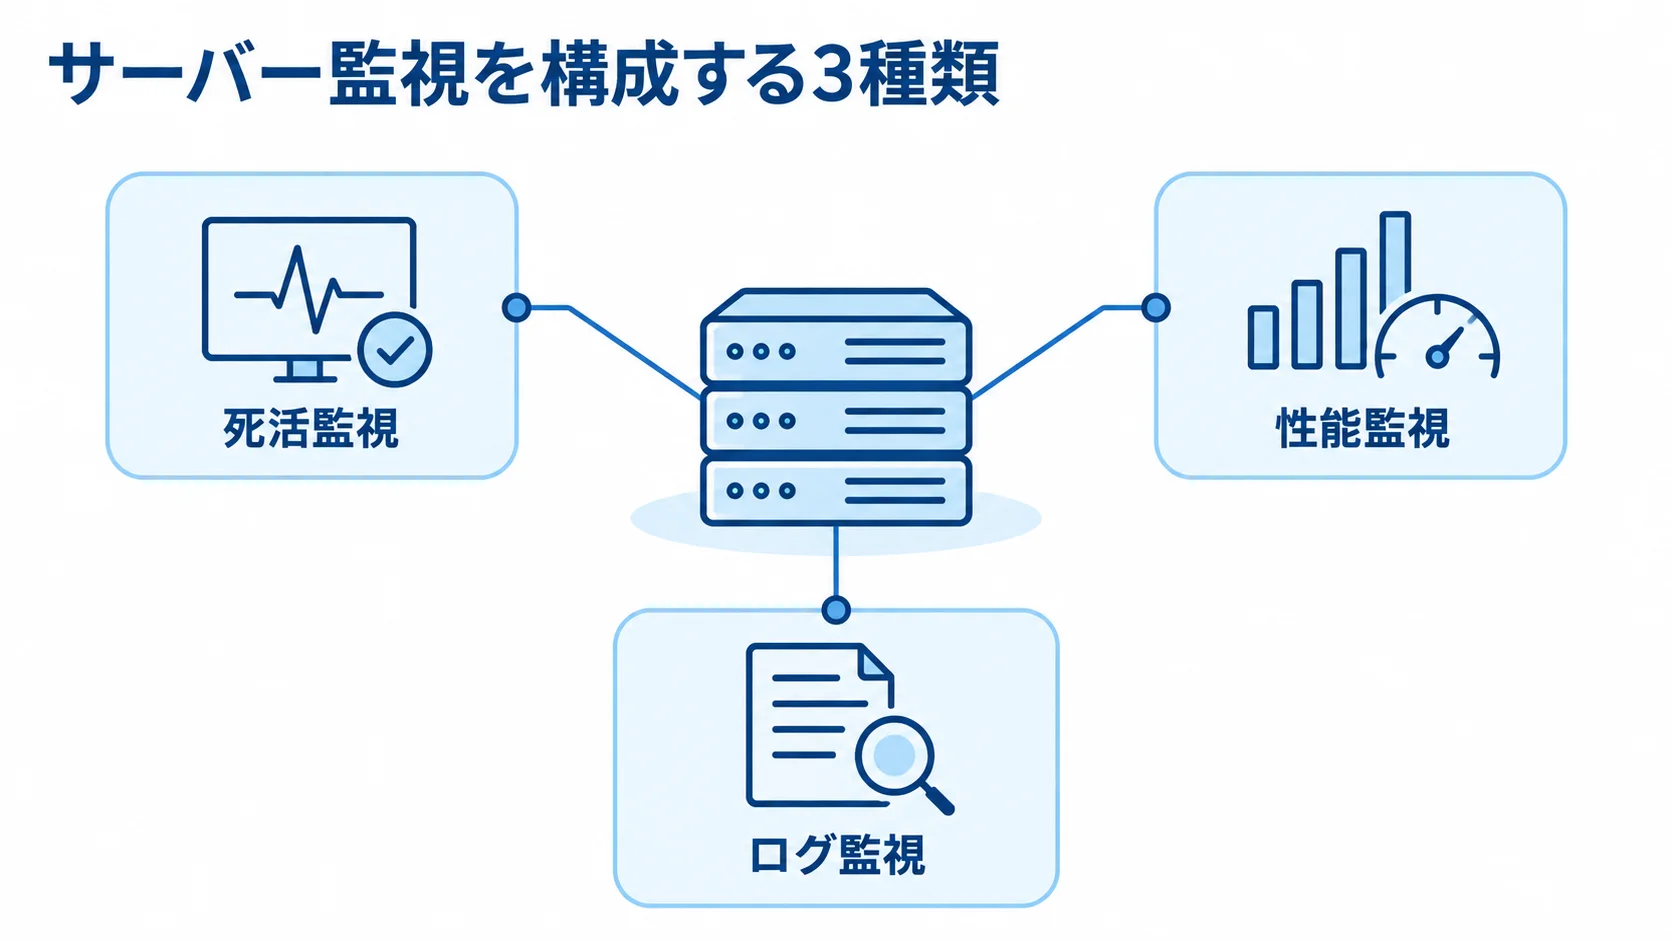
サーバー監視とは、サーバーが正常に動いているか、リソースに余裕があるか、エラーが起きていないかを継続的に把握する仕組みの総称です。
目的の異なる複数の監視を重ね合わせてこそ、「障害が起きる前に気づく」「障害が起きたらすぐ原因にたどり着く」状態が実現します。
まず、監視を構成する要素と、現代ならではの難しさを整理します。
死活・性能・ログという3種類の監視
サーバー監視は、大きく死活監視・性能監視・ログ監視の3種類に分かれます。
死活監視は、PingやSSH、ポート疎通などでサーバー自体が生きているかを確認する最も基礎的な監視です。「動いているか、止まっているか」を即座に検知します。
性能監視は、CPU使用率・メモリ・ディスク・レスポンスタイムといったリソース状況を継続して観測し、性能劣化やリソース枯渇の予兆をつかみます。
ログ監視は、アプリケーションやOSが出力するログを収集・解析し、エラーや異常な挙動を記録から追います。3つはそれぞれ単独でも機能しますが、補完関係にあります。
- 設計の本質:死活・性能・ログの3種類をどう重ねるかを決めることです。
- 障害の切り分け:死活監視で「落ちた」と分かっても、理由は性能監視のリソース推移とログ監視のエラーメッセージを突き合わせて初めて特定できます。
オンプレとクラウドが混在する現代の難しさ
かつてのサーバー監視は、自社データセンター内の物理サーバーを対象にすれば足りました。
しかし現在は、オンプレミスの基幹システムとAWS・Azureなどのクラウド、さらにSaaSが混在するハイブリッド環境が一般的です。
クラウドには、CloudWatchのような標準の監視機能があります。一方で、オンプレ機器はSNMPやエージェント型ツールで別々に収集するため、監視が環境ごとに分断されやすくなります。
環境ごとに別々のダッシュボードを見ていると、障害時に「どこで何が起きているか」を横断して把握できず、原因の特定が遅れます。
サーバー監視の全体像は、オンプレとクラウドを一つの画面で俯瞰できる統合監視を前提に描きます。また、後述するツール選定でも、自社環境のどこまでをカバーできるかが判断材料になります。
- 個別の解説:各監視の種類や環境別の進め方は、近接するテーマの記事でも詳しく扱っています。
- 死活監視の委託先:比べる際は、ITシステムサーバー監視でおすすめの開発会社/ベンダー6選と選び方などを参照すると、自社に合う委託先を絞り込めます。
サーバー監視の進め方と設計の流れ
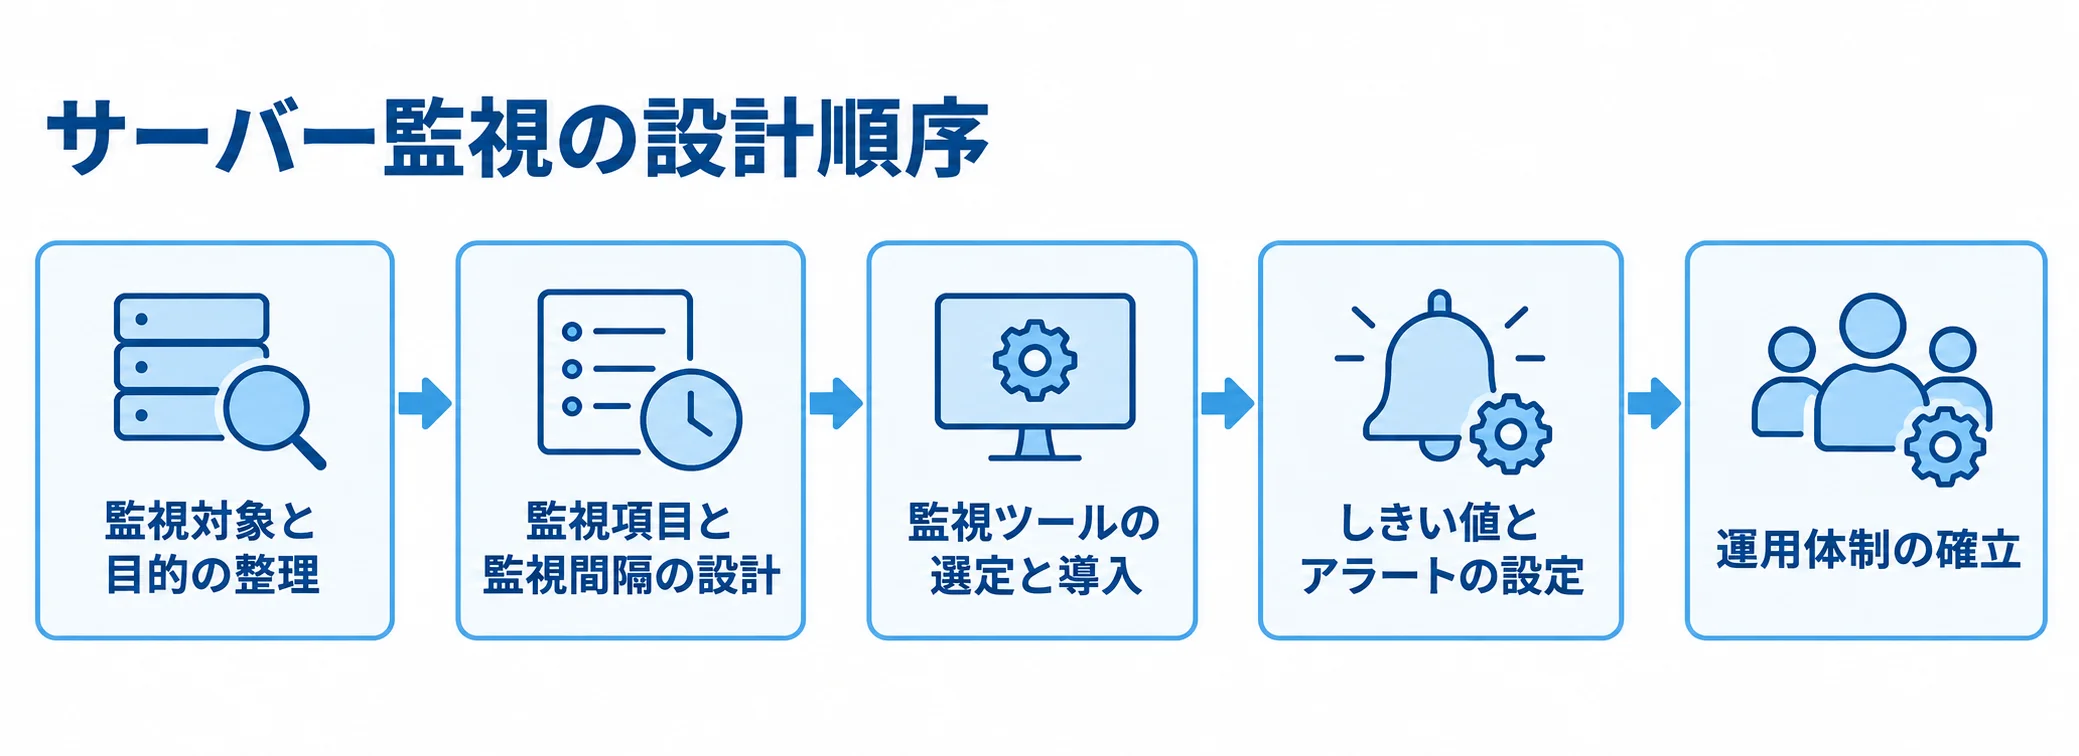
サーバー監視の立ち上げは、ツールの導入から始めると失敗につながります。正しい順序は、監視対象と目的の整理、監視項目の設計、しきい値とアラートの設定、運用体制の確立という流れです。
ここからは、実際に手を動かすときの工程を順に見ていきます。
ステップ1:監視対象と目的の棚卸し
最初に、何を監視するかを洗い出します。
Webサーバーやデータベースサーバー、バッチサーバーなどに加え、ネットワーク機器やクラウド上の仮想マシンも一覧にします。それぞれが停止した場合に、業務へどれだけ影響するかも整理します。
サーバーごとに監視の重みを変えます。止まると売上に直結するサーバーと、多少の遅延が許容されるサーバーとでは、求められる監視の密度が違うためです。
棚卸しの段階で、各サーバーの目標復旧時間も決めます。「いつまでに復旧させるか」と許容できるダウンタイムを決めておくと、しきい値や運用体制の判断がぶれにくくなります。
- 監視項目の増やしすぎ:目的が曖昧なまま増やすと、後述する「アラート疲れ」を招きます。
- 導入の順番:まずは欲張らず、ビジネス上の重要度が高いサーバーから監視を固めていくのが有効です。
ステップ2:監視項目と監視間隔の設計
次に、棚卸しした対象ごとに、死活・性能・ログのどれを、どの間隔で監視するかを決めます。
例として、重要なWebサーバーは死活監視を1分間隔で確認します。性能監視はCPU・メモリ・ディスクを5分間隔で記録し、エラーログはリアルタイムで収集します。
監視間隔を短くするほど検知は早くなります。ただし、サーバーや監視基盤への負荷とコストも増えるため、重要度とのバランスで決めます。
性能監視で予兆を捉える設計も欠かせません。たとえば、ディスク使用量が一定の速度で増え続けていれば、満杯になって停止する前に検知して対処できます。
- 予兆の検知:死活監視だけでは「落ちてから気づく」事後対応にとどまりますが、性能監視を重ねれば「落ちる前に気づく」予防保全に近づけます。
ステップ3:監視ツールの選定と導入
監視項目が固まったら、それを実現できるツールを選びます。
代表的なツールとして、無料で始められるOSSのZabbixがあります。
AWS環境と相性のよいCloudWatch、オンプレからクラウドまで可視化できるDatadog、国産で導入しやすいMackerelも候補になります。
選定では、まず予算と監視対象の環境(オンプレ/クラウド/マルチクラウド)を確かめます。そのうえで、運用チームの技術レベル、監視範囲、アラート通知の柔軟性を比べます。
予算の目安としては、月額5万円未満なら初期コストゼロのZabbixを選べます。
月額5万〜20万円なら、取込量に応じた従量課金のCloudWatchが候補になります。一方、月額20万円以上でホスト数が多い場合は、ホスト課金型のDatadogを選べます。
- 移行の負担:導入後に作り込みが進むほど移行コストは膨らみ、最初の選定が長期の運用コストを左右します。
- 将来の規模:現時点の規模だけでなく、サーバー台数が増えたときに課金がどう伸びるかまで見越して選びます。
しきい値とアラート設計の具体値
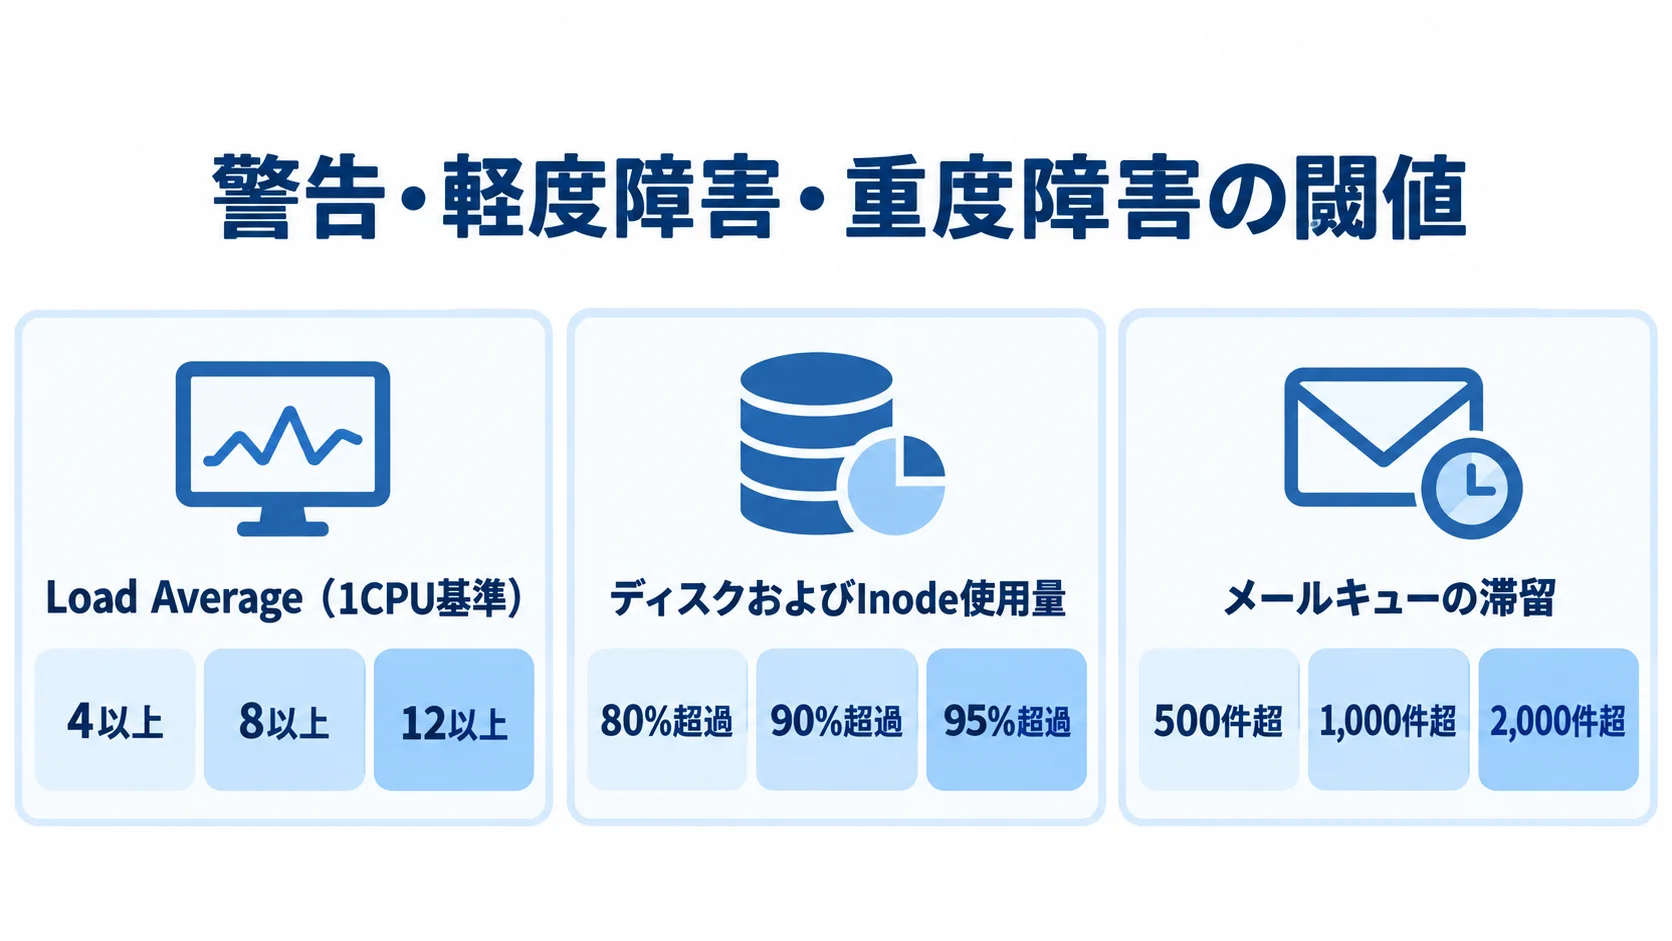
監視設計でつまずきやすいのが、どの値でアラートを鳴らすかという閾値の設定です。閾値が緩すぎると障害を見落とし、厳しすぎると過検知で「アラート疲れ」を招きます。
ここでは、現場ですぐ使える閾値の目安と、通知が機能しなくなるのを防ぐ設計の考え方を示します。
警告・軽度障害・重度障害の閾値目安
リソース監視では、一段階で「障害」と判定するより、警告・軽度障害・重度障害と段階を分けて閾値を設けるのが実務的です。
代表的な運用例では、Load Average(1CPU基準)を4以上で警告、8以上で軽度障害、12以上で重度障害と設定します。
ディスクおよびInode使用量の場合は、80%超過で警告、90%超過で軽度障害、95%超過で重度障害という三段階が広く使われています。
メールサーバーを運用しているなら、メールキューの滞留も見ておきたい指標です。500件超で警告、1,000件超で軽度障害、2,000件超で重度障害といった段階を設けると、配送遅延の悪化をいち早く捉えられます。
瞬間的なスパイクを誤検知しないよう、継続時間も条件に加えます。たとえば、「Load Averageが8以上の状態が5分間継続したら軽度障害として通知する」と定義します。
- スパイクの扱い:一瞬だけ閾値を超える事象は珍しくないため、継続条件を入れるだけで不要なアラートを大きく減らせます。
- 数値の位置づけ:これらの数値は一般的な出発点にすぎず、自社のサーバーの平常時の値を一定期間観測して、実態に合わせて微調整する前提で使います。
アラート設計の単純化
アラート設計で最も避けたいのは、複雑な条件分岐の作り込みです。
ある中規模システムでは、「特定キーワードを含むログだけをSlackに通知する」条件を設定しました。しかし、設定ミスで重要なエラーログが届かず、障害の発見が3時間遅れました。
高機能なツールほど複雑な条件を組めます。ただし、複雑さは設定ミスのリスクと表裏一体です。
- アラート疲れ:通知過多で重要な警告が埋もれる状態は、監視を形骸化させる最大の敵です。
- 通知ルール:誰が見ても挙動を予測できる程度に単純にし、人が対応すべきアラートだけを鳴らすことで、障害の早期発見につながります。
運用体制の選び方とハイブリッド設計
監視の仕組みを設計できても、24時間365日それを回す体制がなければ意味がありません。たとえば、深夜や休日にアラートが鳴っても誰も対応できなければ、監視は単なる記録装置になってしまいます。
ここでは、自社運用と外部委託、そしてその中間にあたるハイブリッド設計の考え方を整理します。
インハウスとMSP委託の判断軸
自社のエンジニアだけで24時間365日の監視当番を組むと、人員面でも精神面でも負担が大きくなります。慢性的なIT人材不足の中では、現実的でないケースも少なくありません。
そこで選択肢になるのが、監視運用を専門に請け負うMSP(マネージドサービスプロバイダー)への委託です。MSPに任せると、夜間や休日も含めた一次対応をプロに代行してもらえます。
料金の目安は、24時間365日の監視と一次対応を含むパッケージで、1台あたり月額10,000〜30,000円程度です。
- 社内当番との比較:自社の当番に必要な人件費と委託費を比べ、コストと品質の両面から判断するとよいでしょう。
- オプションの追加:個別サービスの監視は月額200円程度、Apacheなどの自動復旧監視は月額3,000円程度で、重ねるほど費用が積み上がります。
ハイブリッド運用で手放してはいけないスキル
全部を外注するか自社で抱えるかの二つから選ぶより、一部を委託し一部を内製する「ハイブリッド運用」が現実的に有効です。
たとえば、一次受けの監視と定型対応はMSPに任せ、システム構成の判断や恒久対策の決定は自社が担う分担です。また、深夜帯だけMSPに任せ、日中は自社で対応する時間帯指定の委託も選択肢になります。
注意したいのは、丸投げによってシステムがブラックボックス化することです。
委託する場合でも、SLAを自ら定義できる力は社内に残しておきます。さらに、システム全体のアーキテクチャを把握する力も、将来の内製化に必要です。
発注者の事業所に請負作業者が1人で常駐する形態には、注意が必要です。たとえば、管理責任者宛のメールで作業担当者をCCに入れ、担当者へ直接指示を出す運用は、指揮命令とみなされて偽装請負のリスクがあります。
- 運用設計の段階:委託の契約形態(請負・準委任)と指揮命令の所在は、押さえておくべき論点です。
- 知見の空白:MSPに任せきりにして、自社システムの構造を理解する社員がゼロになると、契約を見直すときも別ベンダーに移るときも身動きが取れなくなります。
導入後の改善サイクルと高度化
サーバー監視は、作ったあとも続けて手を入れていくものです。システムは変化し続け、アラートの傾向も移り変わります。そのため、導入後に監視を育て、より高度な可観測性へ発展させていく流れを押さえておきましょう。
ポストモーテムによる監視の改善
障害が起きたら、復旧後にポストモーテム(事後検証)を行う習慣をつけます。
何が起きたか、検知は早かったか、アラートは適切なタイミングで鳴ったか、そもそも予兆を捉えられなかったかを振り返ります。そのうえで、監視設定そのものを更新していきます。
この振り返りを通じて閾値や監視項目を調整すると、同じ障害を次は予兆の段階で捉えられるようになります。
一方で、誤検知で鳴りすぎたアラートがあれば、その条件を見直してノイズを減らします。監視を形骸化させないためには、検知・通知・対応・振り返りという改善サイクルを回し続けることが欠かせません。
- 形骸化の原因:高価なツールを入れても誰もダッシュボードを見なくなる失敗は、多くの場合、この改善サイクルが回っていないことが根本原因です。
- 検知条件:振り返りの際に定期的に更新の対象とします。
監視からオブザーバビリティへの移行
監視の高度化として注目されているのが、オブザーバビリティ(可観測性)への移行です。
従来の監視は、「何が問題か、どこに異常があるか」を示します。一方、オブザーバビリティは、メトリクス・ログ・トレースを統合して、「なぜその問題が起きたのか」を明らかにします。
たとえば、ある中規模のSaaS企業では、APM・ログ・メトリクス・トレースを統合して可視化したことで、障害の原因特定にかかる時間が3分の1に短縮された事例があります。
ただし、AI予測には十分な学習データが必要です。過去にないエッジケースには対応しきれない限界もあるため、人の判断を支援する道具として現実的に使います。
導入や運用に不安があれば、ITシステムサーバー監視の発注/外注/依頼/委託方法についても参考になります。
- AIでログやメトリクスから異常を予測するAIOpsや、障害時にシステムを自動で復旧するセルフヒーリングといった技術も登場しています。
まとめ
ITシステムサーバー監視は、死活・性能・ログの3種類を理解することから始まります。監視対象の棚卸しと間隔の設計を経て、ツール選定、アラート設定、運用体制の確立へ進みます。導入後は、改善を重ねて育てていきます。
特に、Load Average 4/8/12やディスク80/90/95%といった段階的な閾値設定は、押さえておきたいところです。アラートは複雑にせず、現場で使える設計にします。
オンプレとクラウドが混在する環境では、統合監視を前提にします。24時間365日の運用負荷には、MSP委託と内製を組み合わせるハイブリッド設計が現実的です。
その際も、SLAを定義する力やアーキテクチャ全体の把握といった核となるスキルは自社に残し、丸投げによるブラックボックス化を避けます。
本記事を出発点に、自社の環境と体制に合ったサーバー監視を設計し、障害に強いシステム運用を実現していただければ幸いです。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。