
Jaeger導入の流れは、要件整理、選定、設計開発、テスト、稼働、定着の6フェーズです。対象業務を決め、構成を選び、重要な業務から段階的に稼働させると、障害時に原因を追いやすくなります。
全体像は、下に掲載した完全ガイドの記事も合わせてご覧ください。
▼全体ガイドの記事
・Jaegerのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Jaegerのシステム開発の全体像
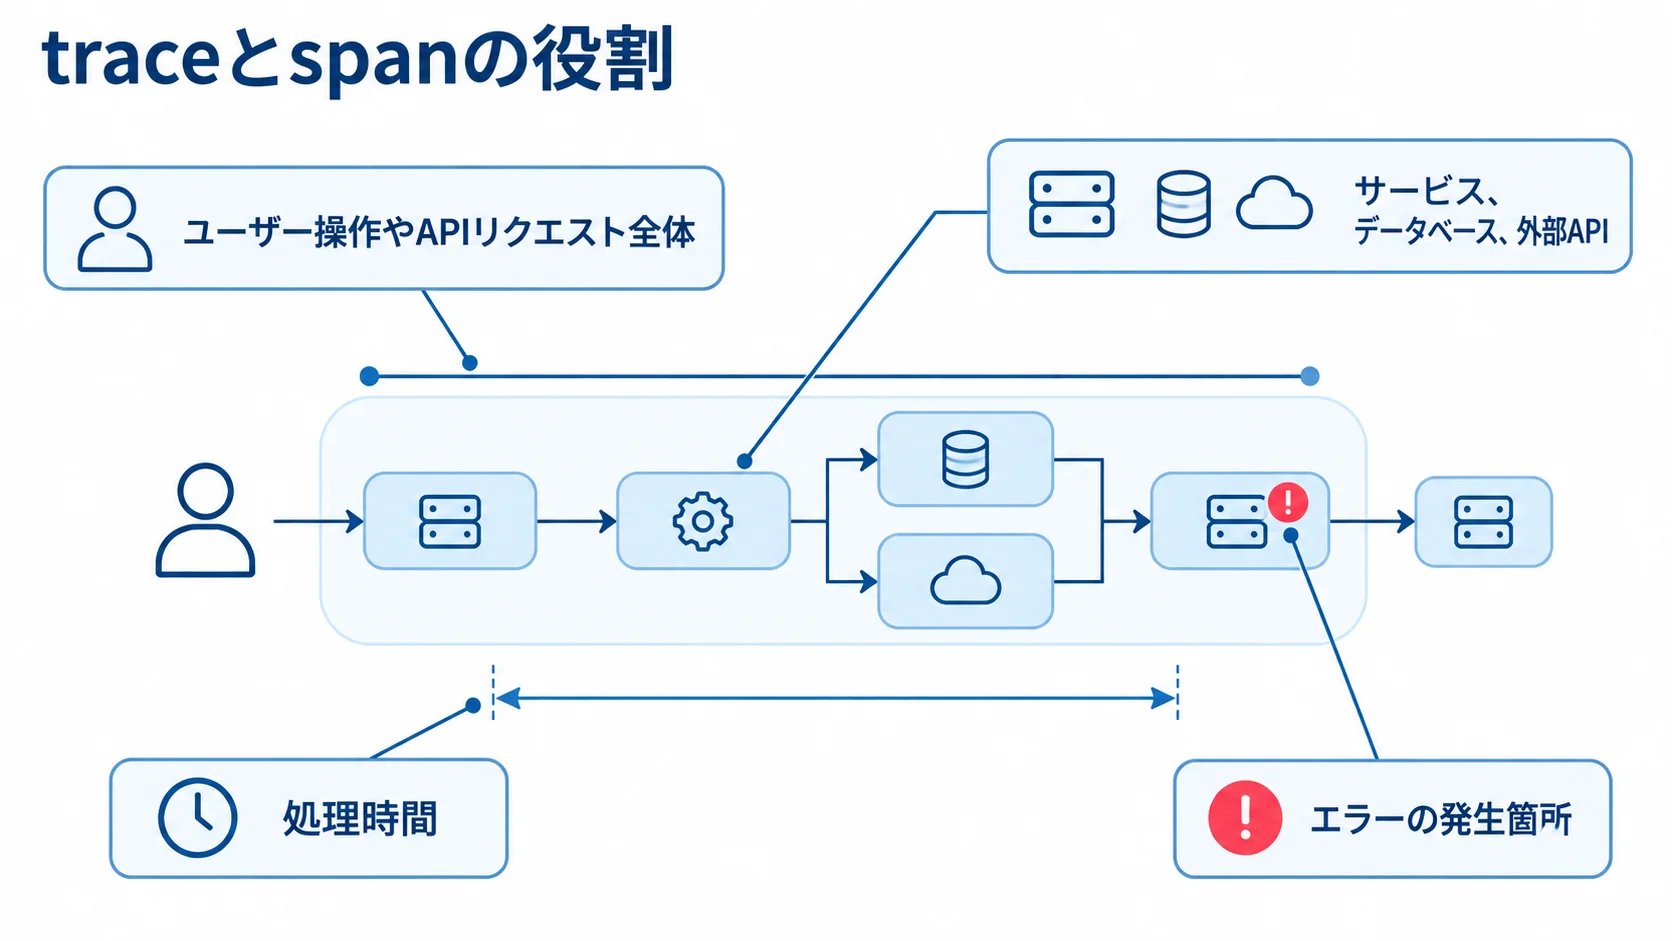
Jaegerは、分散した処理を1本のトレースとして追えるようにするオープンソース基盤です。ここでいうtraceは、ユーザー操作やAPIリクエストの全体を指します。
trace内では、サービス、データベース、外部APIなどの処理単位がspanとして記録されます。そのため、UIやAPIから処理時間やエラーの発生箇所を確かめられます。
Jaegerは業務システムを横断してリクエストを追う基盤
販売管理や会計のように業務データを登録するアプリとは、役割が異なります。Jaegerが扱うのは、業務アプリの中を通る処理経路です。
- 処理経路:各spanを1つのtraceに結び付け、注文・在庫・決済・配送をまたいで追う仕組み
- 原因の特定:同じIDで画面、API、DB、外部決済を順にたどる調べ方
- 観測情報:ログは個別の事象、メトリクスは傾向、traceは1件の処理の流れ
ログ、メトリクス、traceを関連付けると、原因を追いやすくなります。ただし、計装が不足したサービスはtraceから抜けるため、Jaegerを入れるだけでは全処理を追える状態にはなりません。
v2の小規模構成と本番向けの分離構成
Jaeger v2はOpenTelemetry Collectorを基盤にしており、用途に応じて次の役割を組み合わせられます。
- collector:spanの受信・処理・保存の担当
- query:検索APIとUIを受け持つ部分
- ingester・all-in-one:Kafkaからの取り込み、またはcollectorとqueryの統合に使う構成
Jaeger公式資料は、開発・検証ではall-in-one、本番では規模や可用性に応じてcollectorとqueryを分ける考え方を示しています(出典: Jaeger公式「Architecture」、2026年)。
本番でメモリだけに保存すると、再起動時にトレースが失われます。そのため、OpenSearch、Elasticsearch、Cassandraなどの永続ストレージを用意します。
2026年7月時点のJaeger公式資料では、これらが主要な分散ストレージとして案内されています。なかでも、大規模な本番用途ではOpenSearchが推奨されています(出典: Jaeger公式「Storage Backends」、2026年)。
ピーク負荷やデータ損失への要求が高い場合は、collectorとストレージの間にKafkaを置き、ingesterで書き込む構成も比べる候補になります。
Jaegerのシステム開発の進め方
Jaeger導入では、サーバーを起動してUIを開く前に、追跡対象、保存情報、障害対応で速めたい判断を決めます。要件整理から定着までの6フェーズを、成果物と判断基準に沿って進めます。
フェーズ1:要件整理での対象業務と成功指標の設定
要件整理では、対象業務、現状の接続状況、成功指標を順に明らかにします。
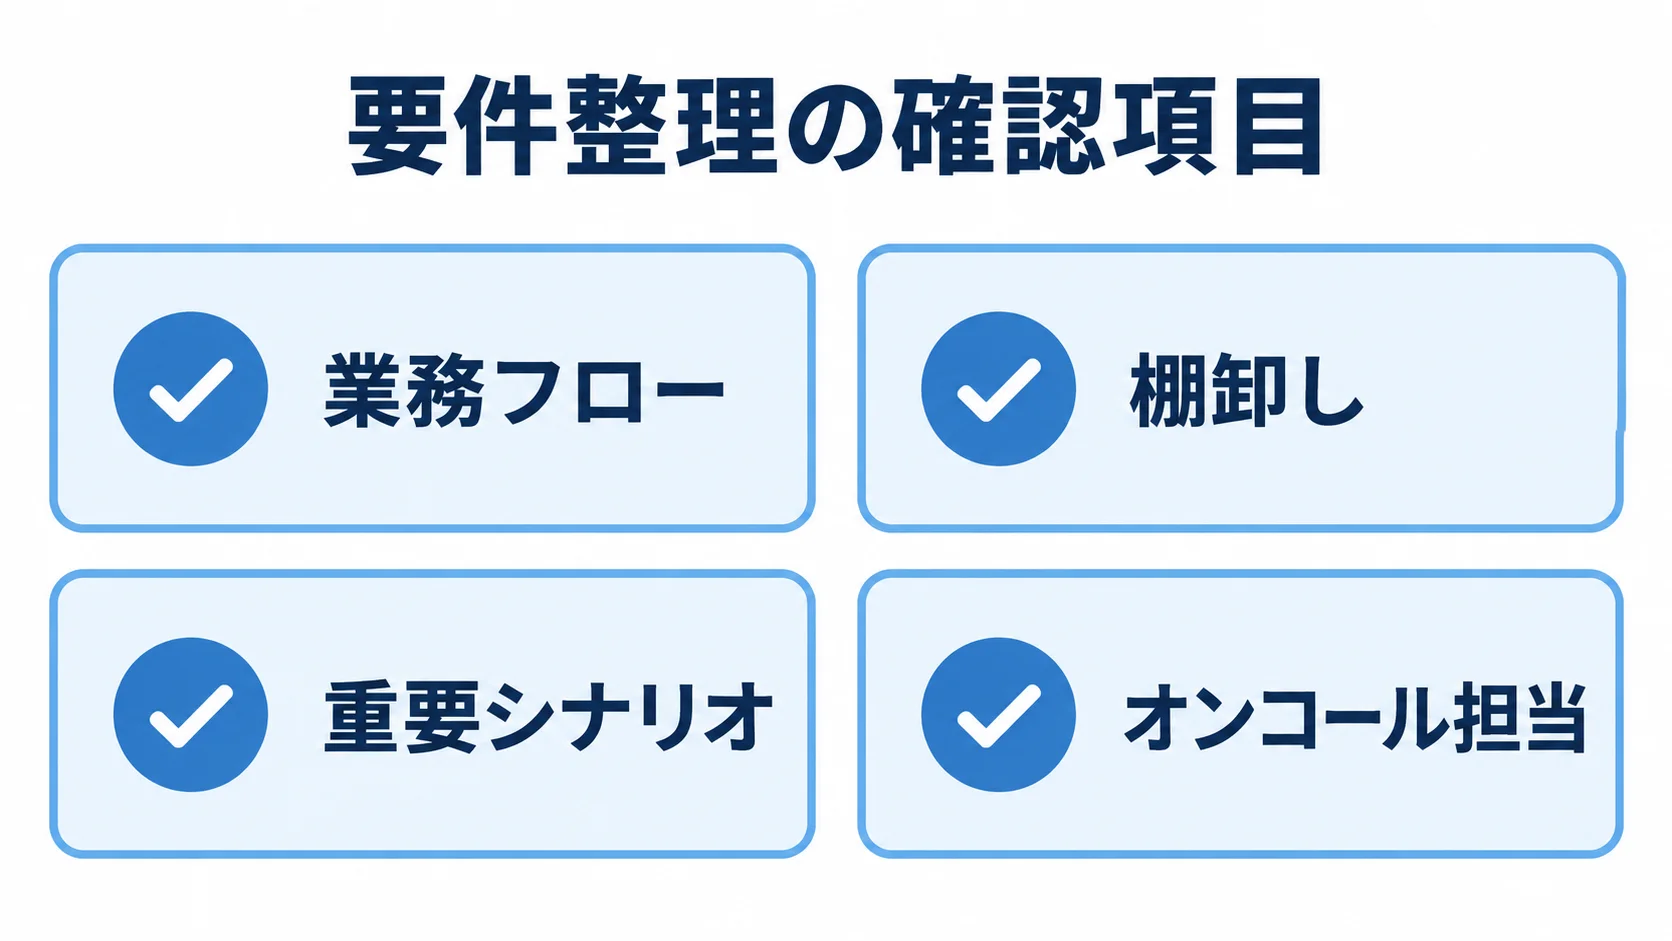
- 業務フロー:利用者が目的を果たすまでの流れ(例は注文から決済まで)
- 棚卸し:サービス、API、DB、外部サービス、実行環境の現状
- 成功指標:原因特定時間、平均復旧時間(MTTR)、注文APIのp95、再現率など
たとえば、注文APIのタイムアウト時に原因サービスを30分以内に特定できる状態を目標にします。その目標から逆算すると、必要なspan、権限、保持期間、検索性能が分かります。
既存のログとメトリクスから、traceの接続状況を確かめます。あわせて、重要シナリオ、許容遅延、保持期間、オンコール担当も調べます。さらに、個人情報を扱うかどうかと、既存のJaeger clientの有無も確認します。
フェーズ2:選定でのJaeger・マネージドサービス・周辺基盤の比較
計装から運用までを一つのシステムとして比べます。中心になるのは、計装、Collector、ストレージです。そのほかの周辺機能として、UIや監視に加え、バックアップと認証も比べます。
- 周辺基盤:計装、Collector、ストレージを中心に、ほかの周辺機能の比較
- 提供形態:マネージドは運用負担、セルフホストはデータの所在と保持制御が論点
- 本番要件:永続化と冗長化、保持期限、権限管理の条件
小規模のPoCであれば、all-in-oneとメモリ保存で短期間に試せます。
新規アプリでは、Jaeger固有のSDKを前提にせず、OpenTelemetry API・SDK・自動計装からOTLPで送る方針を基本にします。また、OpenTelemetry公式もJaeger clientを非推奨とし、OpenTelemetry API・SDK・計装への移行を推奨しています。
Jaeger backendはv1.35以降でOTLPを受け付けます(出典: OpenTelemetry公式「Migration」、2026年)。
既存環境は止めずに、サービス単位で移行計画を作れます。移行では、対応言語と自動計装の範囲を確かめます。そのほか、Kubernetes運用、OpenSearchの経験、OpenTracingの移行方法も確認します。
フェーズ3:設計開発でのデータ経路と非機能要件の確定
設計開発では、データ経路、計装ルール、非機能要件を決めます。
- データ経路:アプリ、OTel・Jaeger Collector、Kafka、保存先、query、UIを含めた流れを図にしたもの
- 配置と負荷:アプリ近く、DaemonSet、ゲートウェイの配置を、可用性や再送などの面から比較した結果
- 計装ルール:trace・span IDの伝播方法と、サービス・環境・地域・版の表記の統一
- 非機能要件:可用性、認証、保存、サンプリング、監視、連絡体制の取り決め
- 計装属性:HTTPメソッドやstatus、DB操作属性の共通化
collectorとqueryを分けるなら、受信系と検索系の負荷が互いに影響しない構成にします。
span属性には、顧客ID、メール、注文番号を入れないのが原則です。Authorizationヘッダーやリクエスト本文も対象に含めます。
Collectorではattributes processorやfilter processorで削除・置換します。アプリ側でも、計装規約をallowlistで定めます。
非機能要件では、RTO・RPOとTLSの扱いを先に決めます。加えて、1秒あたりのspan数とピーク時のバッファも決めておきます。アクセス権の管理や監査、データの保存に関する条件も、ここで決めておきます。
- 認証・権限:SSO、RBAC
- 監査・データ:監査ログ、バックアップ、保存期間
個人情報を扱う場合は、個人情報保護委員会のガイドラインに沿って設計します。そのうえで、委託先の安全管理や再委託、監査、海外リージョン、漏えい時の対応を契約に反映します(出典: 個人情報保護委員会「個人情報の保護に関する法律についてのガイドライン(通則編)」、2026年確認)。
フェーズ4:テストでの正常系と障害時の追跡の検証
テストでは、span生成とサービス間のtrace連結を確かめ、次の観点で検証します。
- 業務シナリオ:注文や在庫不足、決済タイムアウト、外部APIの5xxなど
- 処理パターン:リトライやサーキットブレーカー、非同期キュー、バッチ
- 負荷と障害:処理量やCollector、保存、queryの測定、停止や遅延の再現
負荷試験では、1秒あたりのリクエスト数とspanの数・サイズを測ります。Collectorについては、CPUやメモリ、キュー滞留、ストレージへの書き込みも確かめます。
query応答時間とサンプリング後の保存量も測ります。障害については、Collectorの停止やストレージ障害、Kafkaの遅延を試します。加えて、ネットワーク断やアプリの再起動も試します。
画面で何が見えるべきかを受入条件にし、担当者が確かめます。トレースIDをログにも出しておけば、Jaegerから関連ログへ移れるかを試せます。
データ損失の範囲と復旧手順も記録に残します。さらに、個人情報がUI、API、ログ、バックアップに残らないかも確認します。
フェーズ5:重要ドメインからの段階的な稼働
全社展開の前に重要ドメインでPoCを行い、効果を確かめてから段階的に広げます。
- 開始対象:影響が大きく経路が明確な1つのドメインでのPoC
- 効果測定:導入前後のMTTR、p95、原因特定時間、span欠落率、保存量などの比較
- 展開順:周辺サービス、共通基盤、バッチ、外部連携の順
本番切替の前には、ダッシュボード、アラート、権限、バックアップを確かめておきます。
ロールバック、問い合わせ先、障害時の連絡先も確認しておきます。そのうえで、全件保存が必要な業務と代表値でよい業務とでは、サンプリング率を分けます。
失敗や高レイテンシーを優先するtail samplingも候補になります。ただし、Collectorの負荷と欠落リスクを負荷試験で確かめてから採用します。
フェーズ6:定着での運用KPIと計装ルールの改善
Jaegerの画面を開発者だけのものにせず、障害対応と定期レビューに組み込みます。
- 障害対応:trace IDの取得、遅いspanの特定、ログと履歴の照合、原因と再発防止策の記録
- 月次確認:未接続サービスとquery latency、保存量、サンプリング率の状況
- 計装レビュー:属性とエラー分類、伝播、保持、マスキングの点検
PII検出件数やダッシュボードの利用状況も、月次で確かめます。旧Jaeger clientやOpenTracingについては、サービスごとに移行期限を設けます。
互換層を長期の前提にはせず、障害訓練でJaegerを使います。さらに、運用チームが改善要求を出せる場も設けます。
Jaegerのシステム開発にかかる費用相場とコストの内訳
Jaeger本体はオープンソースのため、ライセンス費用は原則として無料です。ただし、実際の予算は、計装やCollectorの構築、OpenSearchなどのストレージによって変わります。
クラウド利用料や保守のほか、セキュリティや監視、バックアップも必要です。なお、以下の金額はJaegerの公定価格ではありません。
この金額は、リサーチノートにある業務システム一般の開発相場と公開料金をもとにした、初期検討用の推定です。span量や保持期間が分からない段階では、金額を断定しないことが大切です。
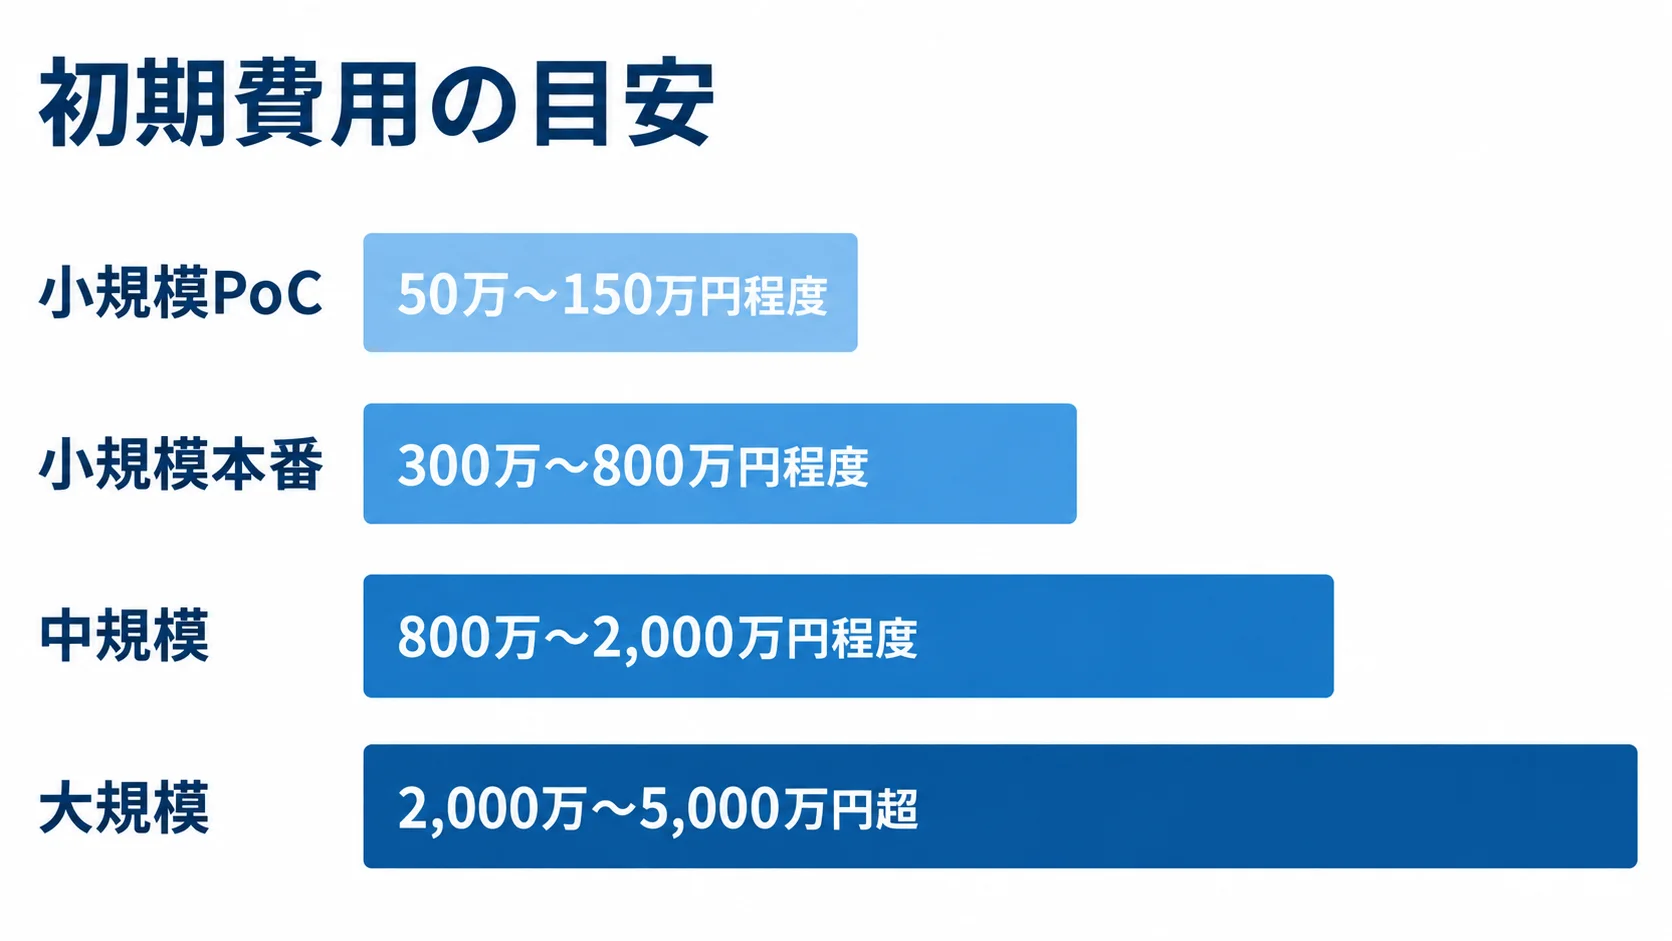
導入段階ごとの費用の幅(50万円台〜5,000万円超)
導入段階の規模と構成によって、初期費用の目安は次のように変わります。
- 小規模PoC:1〜2サービス、1〜2か月で50万〜150万円程度
- 小規模本番:5〜20サービス、2〜4か月で300万〜800万円ほど
- 中規模:複数環境や冗長化などを含み、800万〜2,000万円の見込み
- 大規模:Kafkaや複数クラスタなどを含み、2,000万〜5,000万円超の可能性
小規模PoCは自動計装とall-in-one、小規模本番はCollectorやOpenSearch、権限、バックアップを含む想定です。
中規模はKubernetesの複数環境、冗長化、SSO、監査、長期保持を含みます。大規模は、災害復旧と企業横断の運用も含みます。
これらは、業務システム一般の相場をJaeger導入に当てはめた推定です。実際の金額は、サービス数やOpenTelemetryへの対応状況、会社の単価、可用性、データ量によって変わります。
一般的な開発会社の人月単価は80万〜120万円程度、保守は初期費用の年15〜25%程度という相場情報もあります。ただし、Jaeger案件にそのまま当てはまるとは限りません。
見積書は、要件整理や設計、計装、基盤構築といった工程ごとに分けて比べます。テストや移行、教育、保守も、項目ごとに見ます。
ランニングコストを左右する保存量・保持期間・運用体制
セルフホストとマネージドの費用を比べるときは、運用範囲と利用量をそろえておきます。
- 小規模本番:クラウド、ストレージ、監視の費用で月5万〜30万円程度
- 中規模・複数環境:月20万〜100万円程度
- 大規模運用:Kafkaや冗長化、長期アーカイブ、24時間運用を含み、月100万円超の可能性
セルフホストでは、Collectorとqueryの計算資源やストレージノードが継続費用になります。ディスクとバックアップも継続費用です。さらに、データ転送や監視、更新、障害対応も費用に含まれます。
これは、利用量とSLAに基づく推定です。契約前には、実測データをもとに金額を置き換えます。
Grafana Cloud Application Observabilityでは、ホスト時間1時間あたり0.025米ドルです。この料金の対象は、2026年2月13日以降の新規顧客です。
ホスト時間の料金に加えて、トレースなどのテレメトリは1GBあたり0.50米ドルです(出典: Grafana公式「Application Observability host-hours pricing」、2026年)。
10ホストを月730時間稼働させ、トレースを100GB取り込む場合を単純計算すると、18.25米ドルと50米ドルを合わせて月68.25米ドルです。
実際には、ログやメトリクス、プラン、超過、為替などが加わります。この数字はJaegerセルフホストの料金ではなく、データ量を抑える効果を考えるための参考値です。
サンプリングと保持期間の設計による費用管理
保存方法と期間を決め、必要なtraceを残しながら保存量を管理します。
- 保存率:正常系は一定割合で、エラーや高レイテンシーを優先して残す
- 保持先:primaryは短いTTLとし、必要なtraceはarchiveへ移す
- 保持期間:通常は2週間で、重大インシデントを長期保存する例もある
見積もりの前に、1日あたりのリクエスト数や、1リクエストあたりの平均span数・サイズを測っておきます。あわせて、サンプリング率、保持日数、環境数、バックアップ世代、ピーク倍率も押さえます。保持期間は、業務上の調査要件から決めます。
PoCで測った保存量を使えば、ストレージ費用を推測しやすくなります。
全件保存を要件にする場合は、費用に加えて、PIIが記録される確率や検索性能、削除要求への対応も評価します。
Jaegerのシステム開発で見積もりを取る際のポイント
Jaeger案件の見積もりを比べるには、計装対象、保存先、運用担当、調べたい障害と目標時間を条件に記すことが欠かせません。「構築一式」とだけ書かれた見積もりでは、比べる材料が足りないためです。
対象範囲と除外範囲をそろえておくと、価格差が技術力によるものか、作業の漏れによるものかを判断しやすくなります。
要件定義書に記載する対象・KPI・データ分類・除外範囲
RFPや要件定義書には、対象、KPI、データ保護、既存環境の情報を盛り込みます。
- 対象と負荷:業務、サービスと版、言語、通信、環境数、1日・ピーク時のリクエスト数
- KPIと受入条件:p95、保持期間、検索時間、可用性、RTO・RPO、trace連結
- データ保護:認証、個人情報、メールをspanやバックアップに残さない条件
- 現行環境:リポジトリ、通信、クラスタ、クラウド、監視、ログ、CI/CD
受入条件には、エラーのtraceからログへ移れることも含めます。あわせて、OpenTracingやJaeger clientの利用状況、リリース頻度も共有します。
現状が分からない場合は、いきなり本番構築を頼まず、現状調査とPoCを別々の契約に分けるのが安全です。
複数社比較でのJaeger以外の責任範囲
比較先の実績は、Jaegerを起動した経験だけでなく、OpenTelemetry計装とCollectorの負荷設計まで確かめます。
- 技術実績:OpenSearchやElasticsearchの運用、Kafka、Kubernetesの経験
- 安全・運用:TLS、SSO・RBAC、PII対策、IaC、バックアップ、24時間対応
- 提案内容:構成図、工程、成果物、テスト、体制、引き継ぎの内容
「Jaeger導入実績あり」と書かれていても、計装、基盤運用、障害対応のどこを担ったかは分かりません。
Grafana Labs、Elastic、AWS、Red Hatなどの製品・基盤の提供元と、国内のSI会社やクラウド専門会社は、分けて比べます。
AWSを使う場合はADOTやAmazon OpenSearch Serviceの経験を、OpenShiftを使う場合はOperatorと権限設計の経験を見ます。
既存の基幹系では、JavaやミドルウェアなどSDK計装の経験を重視します。なお、Jaeger専用の受託価格表があるわけではありません。
評価では、会社の知名度よりも、現行環境に近い構成の設計・運用の責任を説明できるかを見ます。
見積条件に含めるリスクと対策
見積条件には、想定するspan量やtrace連結、データ保護、成果物と契約上の責任を含めます。
- 技術リスク:span過多、伝播切れ、非同期の追跡漏れ、検索遅延
- 対策と受入:負荷、保存量、検索時間、相関ID、trace連結の確認
- 本番移行条件:マスキング、権限、復元テストと障害訓練
PIIの残存、UIを見る担当者の不在、旧clientの移行の長期化もリスクです。そのため、PoCでは実トラフィックに近い負荷を測ります。
成果物には、ソースコードやCollector設定、Helm chart、TerraformなどのIaCを明記します。加えて、ダッシュボード、アラート、運用手順も含めます。
計装規約、テスト結果、構成図も成果物に含めます。さらに、再委託の範囲とクラウド費用の支払者も確かめます。
OSSの脆弱性対応やバージョンアップ、障害時の一次対応、ログとtraceの削除も取り決めます。契約終了時のデータ返却も確認します。
条件が曖昧なままだと、初期費用が安く見えても、運用開始後に追加作業が生じるおそれがあります。
よくある質問(FAQ)
導入目的、サービス数、障害の種類、運用体制、データ分類を整理しておくと、PoCから始めるか、本番基盤まで設計するかを判断しやすくなります。
Jaegerはどのようなシステムに必要ですか?
複数のサービスやDB、外部API、非同期処理が連携し、ログだけでは遅延や障害の原因を特定しにくいシステムに向きます。
単一のアプリで処理経路が短く、障害を一つのログで把握できる場合は、まずログとメトリクスを整理する選択肢があります。
技術構成を選ぶより先に、導入目的とKPIを定義しておく必要があります。
Jaegerは無料で導入できますか?
Jaeger本体はオープンソースなので、ライセンス費用を抑えて始められます。
本番では、サーバーや永続ストレージ、OpenTelemetry計装、セキュリティ、監視、バックアップが必要になります。また、更新や障害対応にも費用がかかります。
無料かどうかだけで判断せず、PoCと本番のそれぞれで責任範囲を分けて予算化してください。
既存のJaeger clientやOpenTracingはすぐに移行すべきですか?
新規開発ではOpenTelemetryを標準にし、既存サービスは段階的に移行する方針が現実的です。全サービスを一度に止める必要はありません。
互換層で現行コードを動かしたまま、サービス単位で自動計装、手動計装、テスト、切替を進めます。
移行期限や計装の差分、trace連結、ロールバックを決めないまま併用すると、属性や運用方法がばらつくおそれがあるため注意が必要です。
Jaegerに顧客情報や注文情報を保存しても問題ありませんか?
顧客情報や認証トークンを、span属性や本文に無制限に保存する設計は避けます。記録してよい属性は、allowlistで定めます。
アプリとCollectorでマスキングや削除を行い、TLS、SSO、RBAC、暗号化、監査ログ、保持期限を設計します。バックアップからの削除も考えておきます。
委託先や海外クラウドを使う場合は、保存場所や再委託、契約、監査について、法務・セキュリティ部門と確かめます。漏えい時の連絡と報告の要否も、あわせて確認します。
まとめ
Jaeger開発では、all-in-oneを起動するだけでは足りません。OpenTelemetryで業務フローを追跡し、Collectorや永続ストレージ、query、セキュリティ、運用体制を組み合わせます。
要件整理で業務とKPIを決めたうえで、セルフホストとマネージドを比べます。設計とテストを終えたら、重要ドメインから稼働させ、運用KPIで定着させます。
導入判断の軸となる調査時間と運用要件
複数サービス間の遅延やタイムアウト、リトライ、外部API障害が事業に影響し、ログだけでは原因を追いにくい場合は、検討する価値があります。
対象業務やKPIが未定なら、まずサービスマップやログ、メトリクス、オンコール手順を整理します。そのうえで、1つの業務フローでPoCを行うほうが、失敗しにくくなります。
無料という理由で全件保存を始める前に、必要な調査とデータ保護のバランスを取ってください。
最初の一歩となる1業務の現状調査とPoCの見積もり
発注するときは、現状と運用条件をそろえたうえで、複数社に相談します。
- 共有情報:サービス、業務、導入前MTTR・p95、span量、保持期間、PII
- 発注条件:権限、成果物、運用分担の提示
- 費用比較:初期費用に加え、計装、クラウド、保守、更新、障害対応の費用
将来のOpenTelemetry移行まで含めて判断すると、自社に合うJaegerを現実的な予算で構築しやすくなります。
▼全体ガイドの記事
・Jaegerのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。