
k平均法は、ラベルのないデータをk個のクラスタに分け、各クラスタの中心を繰り返し更新する教師なし学習の手法です。似たデータ同士を同じグループにまとめられます。
正解ラベルを用意できない場面でも、顧客や商品、設備などのデータに含まれるグループを探す手がかりになります。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
k平均法によるデータの割り当て
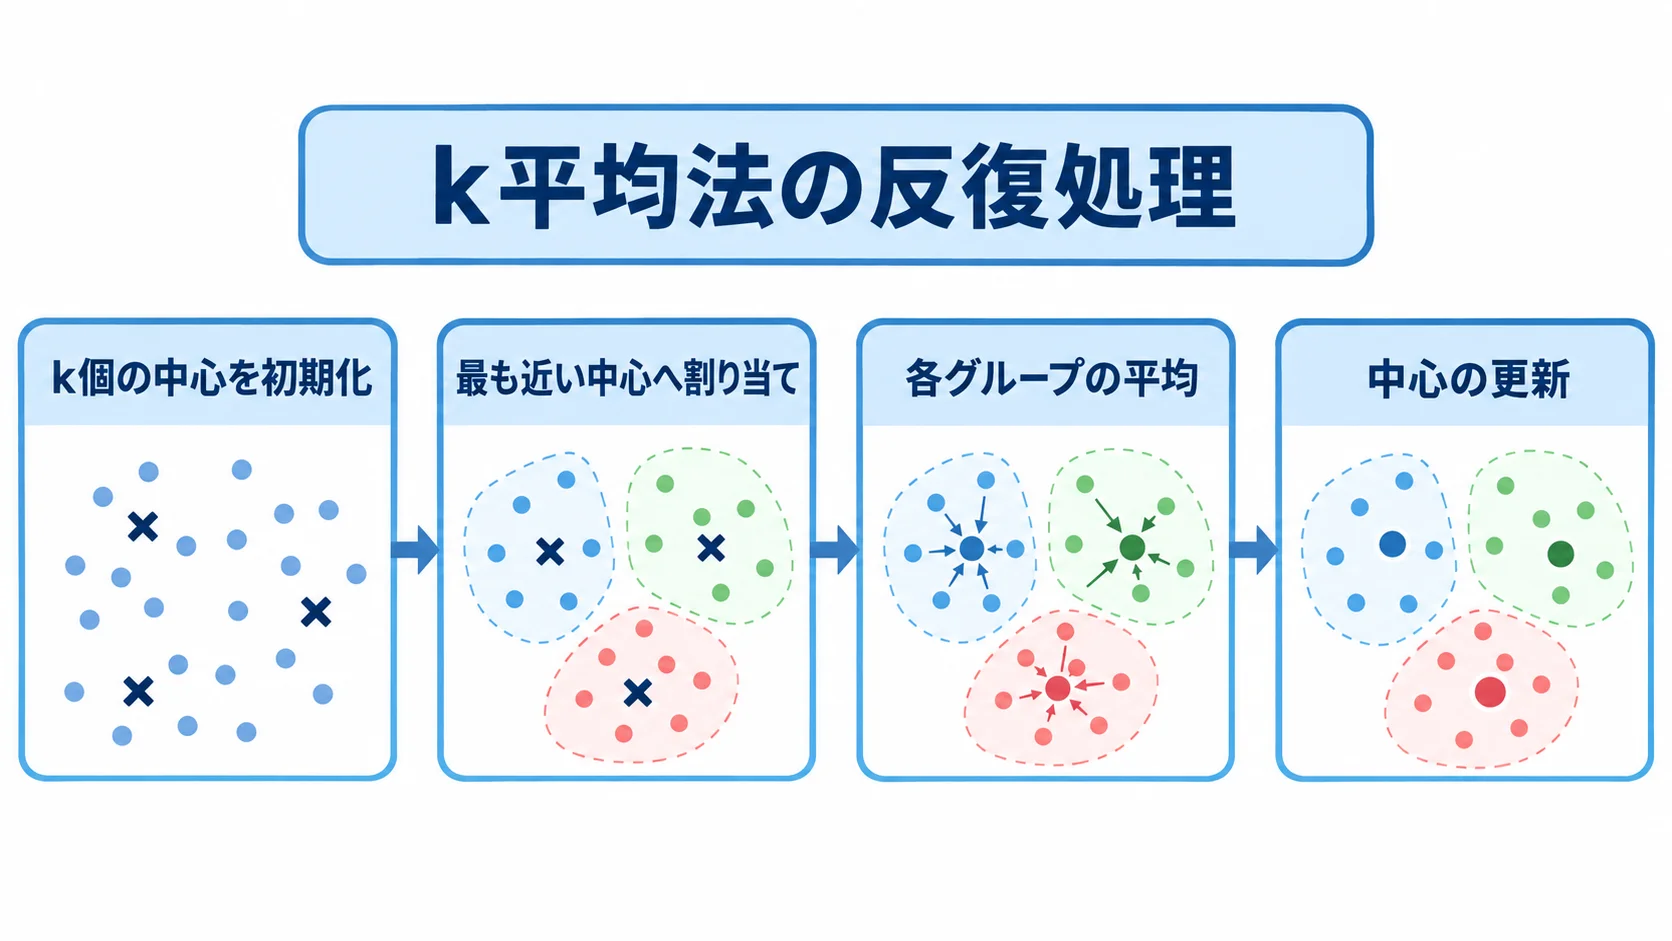
k平均法は、まずk個の中心を初期化し、各データを最も近い中心へ割り当てます。そのうえで、各グループの平均を新しい中心とします。
割り当てと中心の更新は、中心がほとんど動かなくなるか最大反復回数に達するまで繰り返され、その時点で結果を確定します。
顧客、商品、アクセス、センサーなどのデータを特徴量で表すと、似たデータを同じグループとして整理できます。
目的関数とクラスタ内のばらつき
k平均法の代表的な目的は、各データと所属するクラスタ中心との距離の二乗和(inertia)を小さくすることです。クラスタ内の点が中心に近いほど、inertiaは小さくなります。
ただし、inertiaはkを増やすほど単調に小さくなります。そのため、inertiaの値だけでクラスタ数を決めることはできません。
k-means++による初期中心の選び方
初期中心をランダムに選ぶと、局所解に収束して結果が変わることがあります。このため、scikit-learnでは既定の初期化としてk-means++が使われます。
k-means++は、互いに離れた初期中心を選びやすくします。それでも乱数の影響は残るため、分析ではrandom_stateを固定し、複数の初期化で結果を比べます。
k平均法の結果を左右する前処理と距離の選択
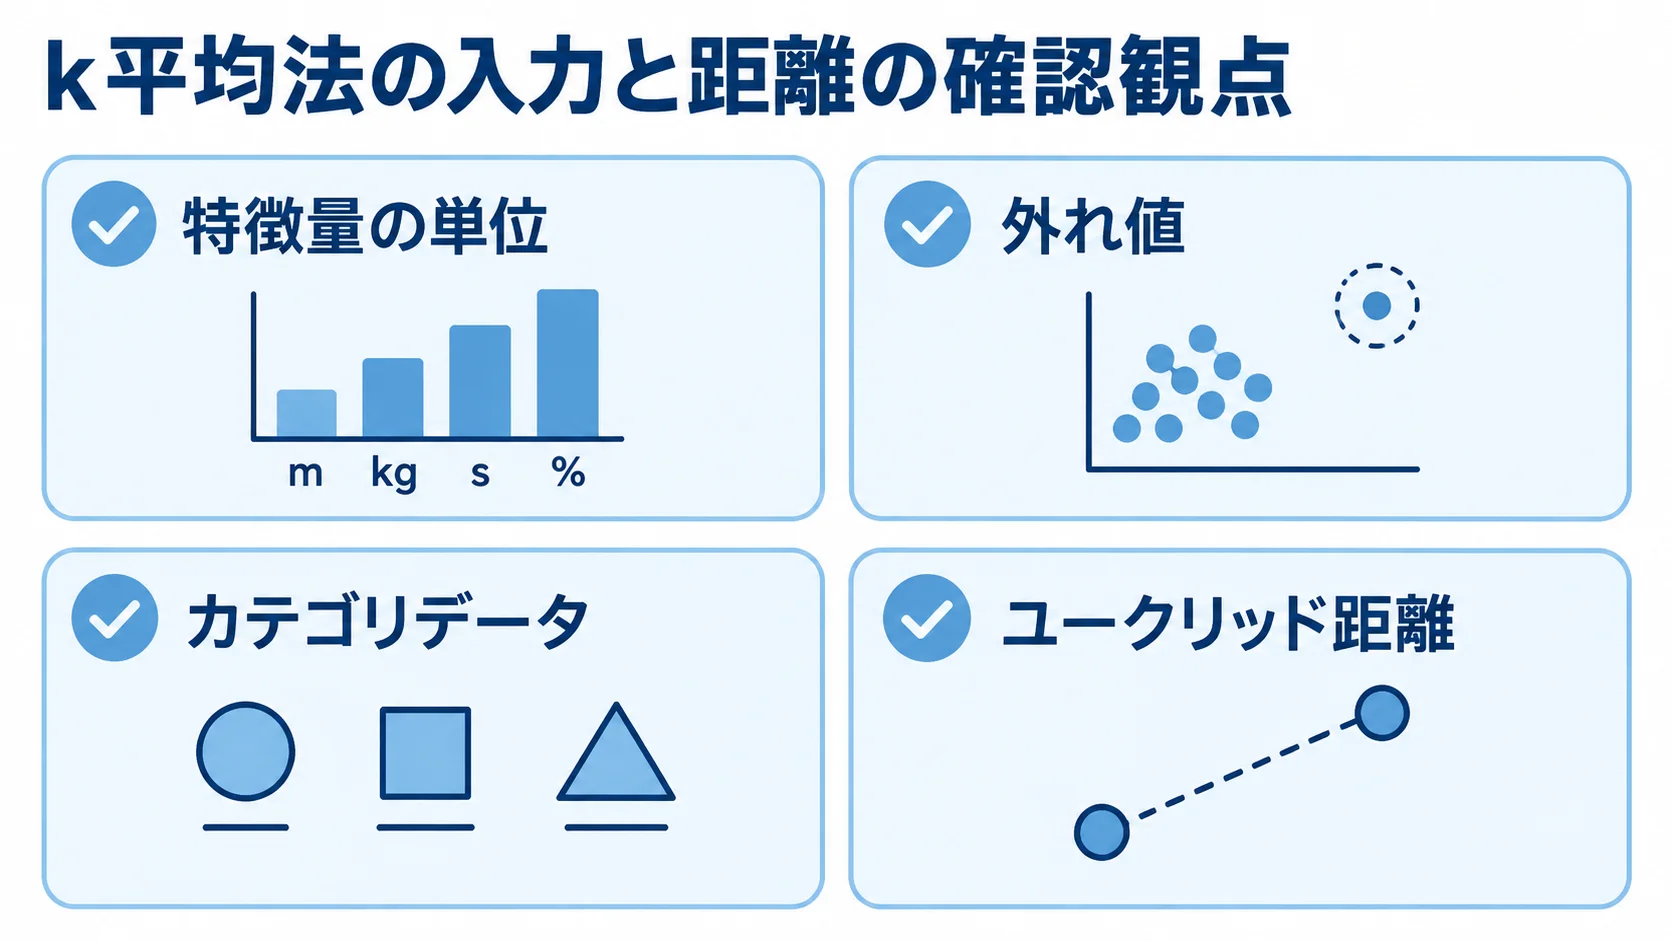
特徴量の単位が揃っていないと、値の大きい特徴量が距離を支配します。たとえば、身長をメートル、年収を円で入力すると、年収の影響ばかりが大きくなります。
標準化、正規化、対数変換などを検討し、どの前処理をなぜ選んだか、そのパラメータを記録しておきます。外れ値は中心を引っ張るため、削除やwinsorize、ロバストな前処理などで扱うか、別手法と比べます。
カテゴリデータを単純な整数に置き換えると、数値の大小に意味があるかのように誤解されてしまいます。そのため、one-hot化や埋め込みを検討します。混合データを扱う場合は、カテゴリ向けの距離や、それに対応した手法も候補になります。
使う前に、入力特徴を平均とユークリッド距離で比べてよいかを確認します。
クラスタ数kを複数の観点から決める方法
エルボー法とinertiaの減少が鈍る点
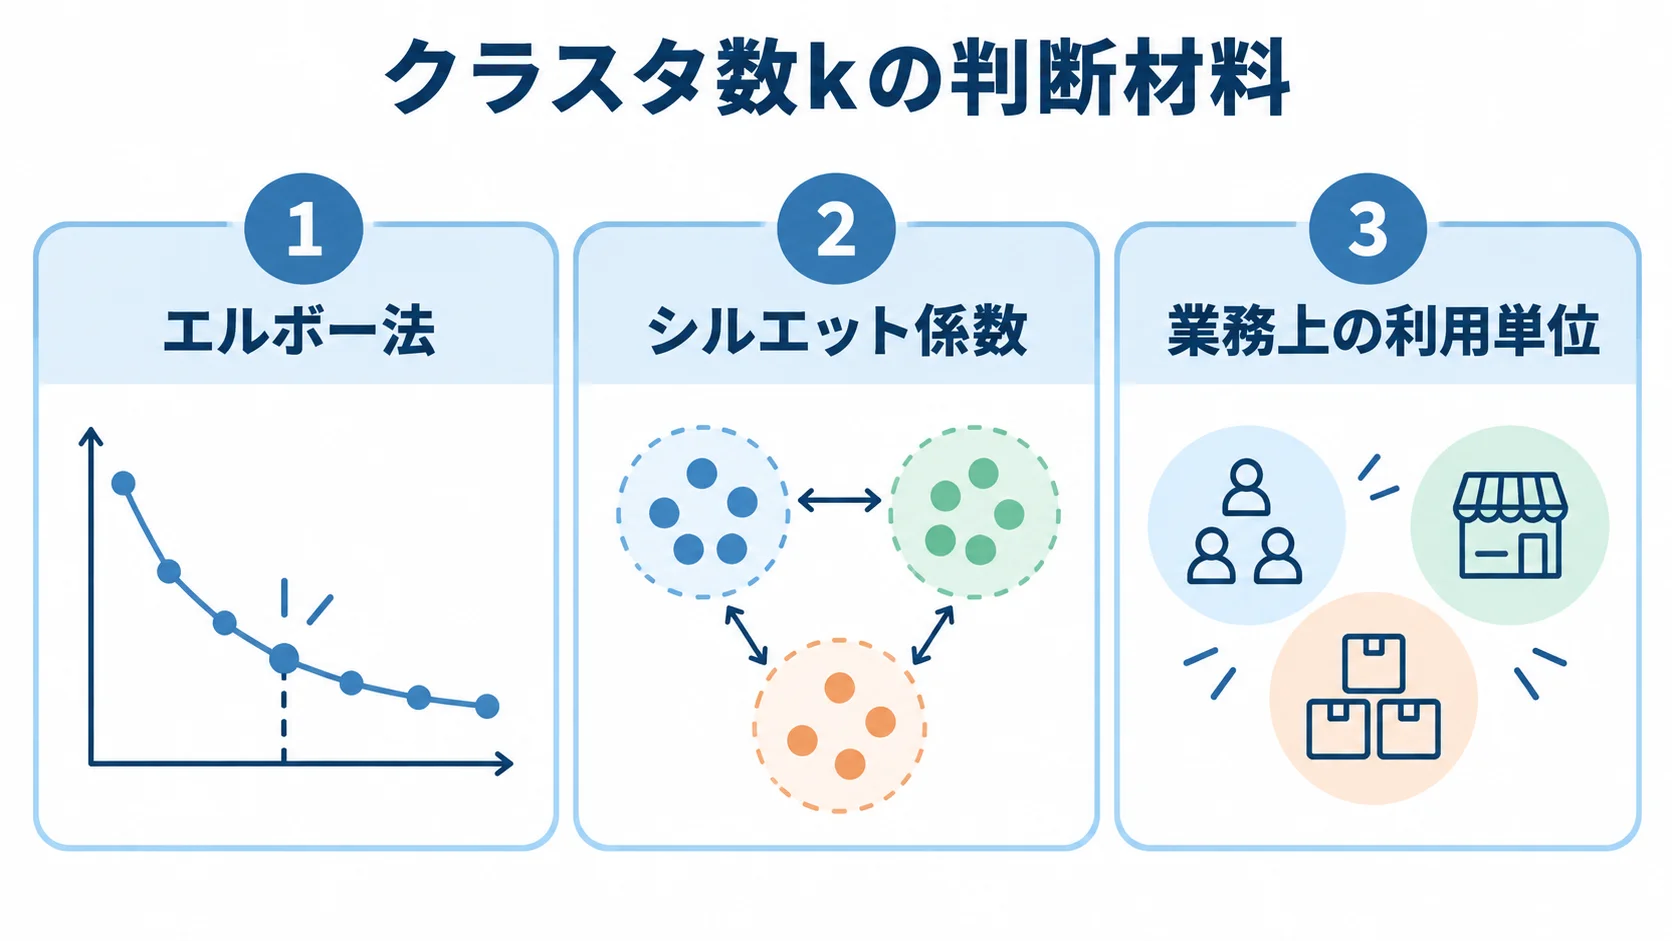
kを変えながらinertiaを計算し、kを増やしても改善が小さくなる「肘」のような点を、クラスタ数の候補とします。
データによっては曲線に明確な肘が出ないため、この方法だけで候補を一つに絞れないこともあります。そうした場合は、業務上の利用単位や説明しやすさも合わせて判断します。
シルエット係数によるクラスタ内外の距離の比較
シルエット係数は、同じクラスタ内の距離と、最も近い別クラスタまでの距離を比べる指標です。値が高いほど、所属クラスタに近く、他クラスタから離れている傾向を示します。
値を読むときは、球状で均等なクラスタを前提とするk平均法の性質と、使った距離の選び方を考慮します。
業務で使える粒度を優先する考え方
たとえば顧客施策では、営業チームが運用できる人数を基準にkを決めることがあります。商品管理では、補充ルールを変えられる単位が判断材料になります。
指標の値がわずかに高いkよりも、クラスタの特徴を説明でき、施策を変えた結果を測定できるkのほうが、実務では価値につながることがあります。
k平均法の活用例
k平均法は、特徴量を組み合わせてグループを探す用途に使えます。たとえば、次のような対象を分類できます。
- 顧客セグメント:購入頻度、単価、カテゴリ、利用期間による施策の対象グループ
- 商品分類:売上、粗利、在庫回転、返品率による管理単位の整理
- センサー状態:設備の稼働値から状態パターンを分け、点検候補を絞り込む
- 文書ベクトル:埋め込みやTF-IDFで資料を分類し、資料の整理や検索改善に役立てる
クラスタを作ったあとは、平均や中央値、代表データを見て、各クラスタに名前と業務上の意味を付けます。平均だけでは外れ値や大きな分散を見落としがちです。そのため、ばらつきや期間別の人数、重要顧客の偏りまで見ておく必要があります。
顧客分類では、購入額の平均に加えて、継続率や問い合わせ内容、施策への反応を見ます。クラスタ作成に使った特徴量へ、後から得られる業務KPIを重ねて見ると、数値上の分類を施策へつなげやすくなります。
再学習のときは、クラスタ番号が以前と同じ対象を指すとは限りません。そのため、新旧の中心や代表データを対応づけ、ダッシュボードや配信ルールの参照先を確かめます。分布が変わったときに再評価する条件も、あらかじめ決めておきます。
複数回の初期化による安定性の確認
初期中心の選び方によっては、k平均法が異なる局所解に到達することがあります。k-means++を使っても、データの重なりや外れ値で結果が揺れる場合があります。
そこで、同じkと前処理のままで乱数シードを変えて複数回実行し、中心や所属が大きく変わらないかを見ます。
新しいデータへの割り当て方法
学習済みの中心を保存しておけば、新しいデータも最も近い中心へ割り当てられます。ただし、学習時と同じ欠損処理、標準化、特徴量の順序を適用しなければ、距離を正しく比べられません。
入力の分布が学習時から大きく外れていないかを監視し、適用対象外かどうかの判定や、再学習の基準も用意しておきます。
割り当ての説明、クラスタ外データの扱い、実験記録について判断の観点を先に決めておくと、更新後も結果を検証できます。そのため、割り当てた結果は、後から照らし合わせられる形で残しておきます。
- 施策への適用:特徴を短く説明し、対象者が所属理由を確かめられる状態にする
- 名称の確認:「優良顧客」などの呼び名は、購入額、継続率、利益、期間を見てから付ける
- 未知データ:中心から遠いデータは無理に割り当てず、「未知」「要確認」として定期的に見直す
- 実験と監査の記録:中心、前処理、評価値、採用理由、更新履歴、適用期間、責任者、承認履歴を残す
未知データを見直すことは、新しい顧客層や設備状態を見つける機会にもなります。記録は、次回更新の再評価や監査で正式な判断材料になり、結果を安全に継続して使うことにつながります。また、モデルの変更と施策の結果を切り分けやすくなります。
k平均法の限界と他手法の使い分け
k平均法は、クラスタが概ね球状で、距離と平均が意味を持つデータに向いています。細長い形の集団や密度が異なる集団、外れ値が多いデータでは、別の手法も比べます。
比べる相手には、DBSCANや階層的クラスタリングがあります。ガウス混合モデルやスペクトラルクラスタリングなどもあります。ただ、手法を変える前に、特徴量と距離の設計を見直すことが大切です。
再学習ではクラスタ番号が入れ替わることがあるため、番号の一致を前提にダッシュボードを作るのは避け、中心の特徴やクラスタ間の対応を計算し直します。分布が変わって施策が誤って適用されないよう、クラスタの移動とデータドリフトを監視します。
k平均法を使う前のチェックリスト
分析を始める前に、入力データ、評価、運用の各段階で、確かめておきたい項目を並べておきます。
- 似ている状態の定義と、使う距離を決めたか
- 特徴量の単位、欠損、外れ値、カテゴリ表現の扱い
- 複数のkを試し、inertiaとシルエット係数を比べたか
- 初期値や乱数シードを変えたときの、クラスタの代表値・分布・件数
- 施策、監視、再学習、クラスタ番号の対応づけを運用の手順に組み込んだか
k平均法の利点と前提の確認
k平均法は、データをk個の中心へ割り当てては中心を更新していくクラスタリング手法です。計算や説明が比較的分かりやすいため、顧客・商品・設備などの初期探索に使えます。
まず、kの選び方と特徴量のスケールを確かめます。そのうえで、初期値や外れ値、クラスタ形状にも注意し、結果を過信しないことが大切です。
候補の比較には、inertiaやシルエット係数に加えて、代表データや担当者の解釈も使います。さらに、施策の実行可能性と、期間をまたいだ安定性も見ます。
分布が変わるときに備えて、再学習の条件とクラスタの対応付けを記録しておきます。そうすれば、分析結果を継続して運用しやすくなります。
よくある質問(FAQ)
k平均法を使うときによく挙がる疑問に、順に答えます。
Q. k平均法とは何ですか?
ラベルのないデータをk個のクラスタに分け、各クラスタの中心を繰り返し更新する教師なし学習の手法です。距離の近いデータを、同じグループにまとめます。
Q. kはいくつに設定すればよいですか?
kは、エルボー法やシルエット係数、クラスタの解釈しやすさ、施策で扱える粒度を組み合わせて決めます。inertiaだけでは、kを自動的に決めることはできません。
Q. 標準化は必要ですか?
特徴量の単位や値の範囲が異なる場合は、多くの場合は標準化が必要です。距離を使うため、大きな数値の特徴量が結果を支配しないよう、前処理を検討します。
Q. 外れ値が多いデータに使えますか?
そのまま使うと、中心が外れ値に引っ張られることがあります。まず外れ値の意味を確認し、そのうえで前処理や重み付け、ロバストな手法、DBSCANなどを比べます。
Q. クラスタ番号に意味はありますか?
番号そのものに意味はありません。各クラスタの中心や代表データ、分布、業務上の特徴を確かめ、再学習のときは特徴の対応関係を計算し直します。
参考資料
k平均法の仕組みや使い方は、次の資料で確認できます。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。