
知識蒸留は、大きな教師モデル(teacher)の予測や中間表現を、生徒モデル(student)に学ばせるモデル圧縮の方法です。
Kerasの公式例では、教師の軟らかい予測分布と正解ラベルを組み合わせて生徒を学習させます。この方法を使うと、推論のメモリ、計算量、遅延を減らせます。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」をダウンロードできます。で詳しく解説しています。
知識蒸留は教師の出力を生徒へ移す仕組み
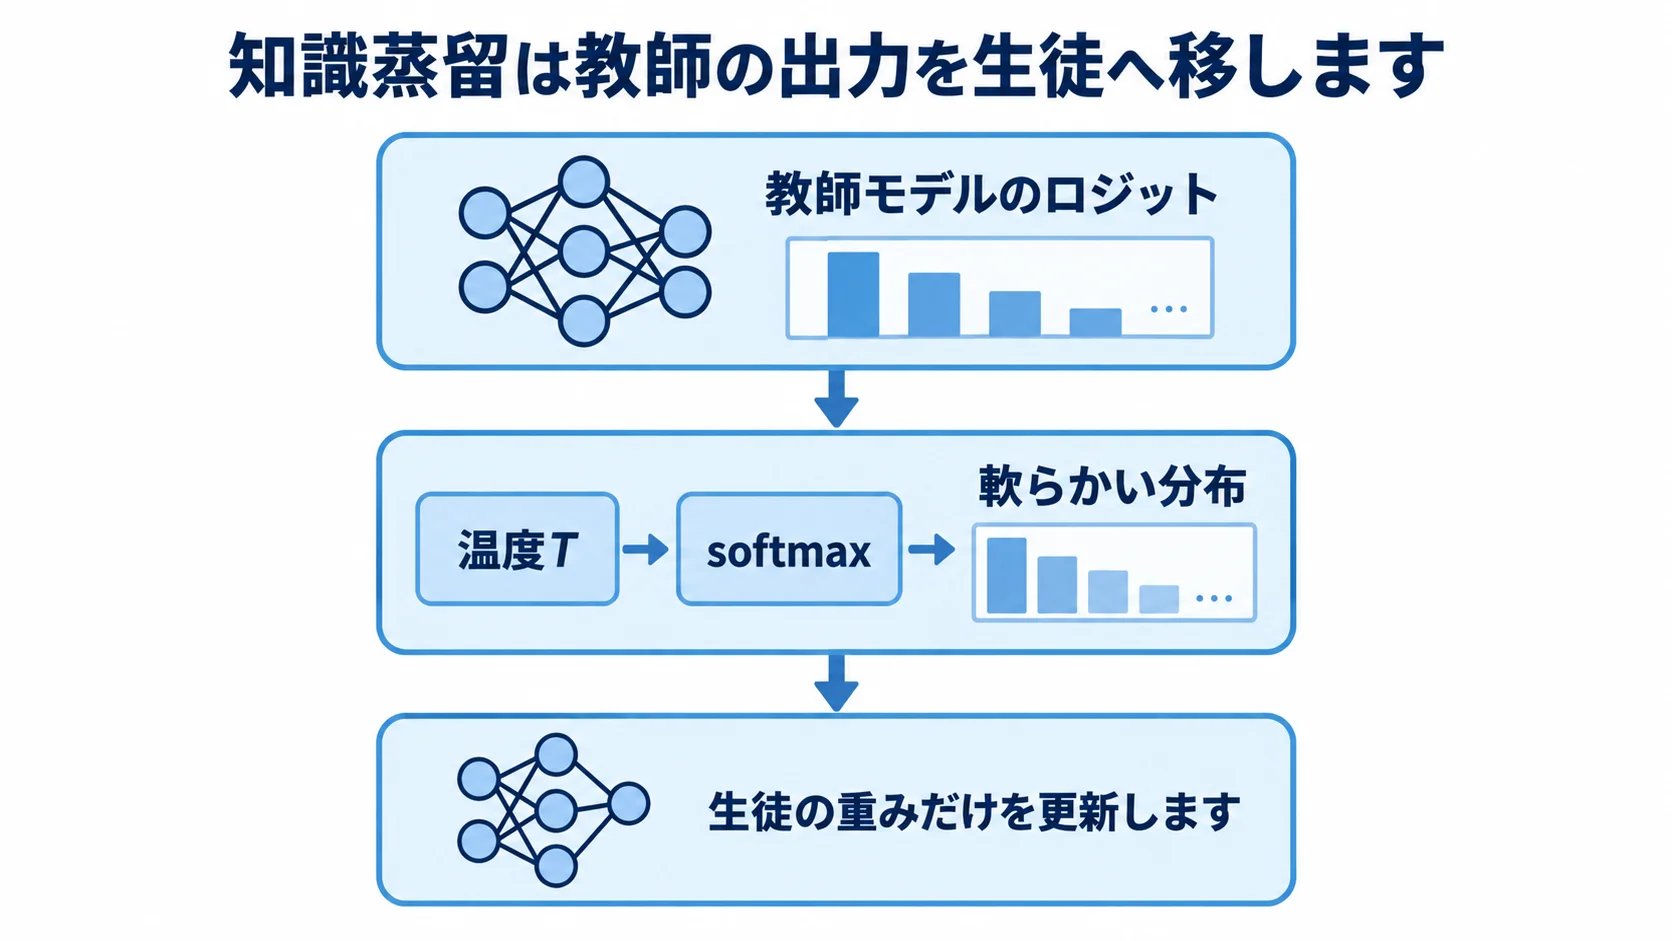
教師モデルのロジットを温度Tで割ってsoftmaxにかけると、正解クラス以外の相対的な確率も残った軟らかい分布になります。生徒の学習では、正解ラベルへの損失と、教師と生徒の軟らかい分布の差を組み合わせます。また、教師は通常固定し、更新するのは生徒の重みだけです。
温度と損失の重みの調整
温度を高くすると、分布が滑らかになり、クラス間の関係を生徒へ伝えやすくなります。ただし、温度だけを上げても、教師が対象の分布を理解していなければ効果は限られます。さらに、正解ラベルの損失と蒸留損失の比率は、教師の信頼性、生徒の容量、対象データに照らして比較します。
出力・特徴・関係を蒸留できる範囲
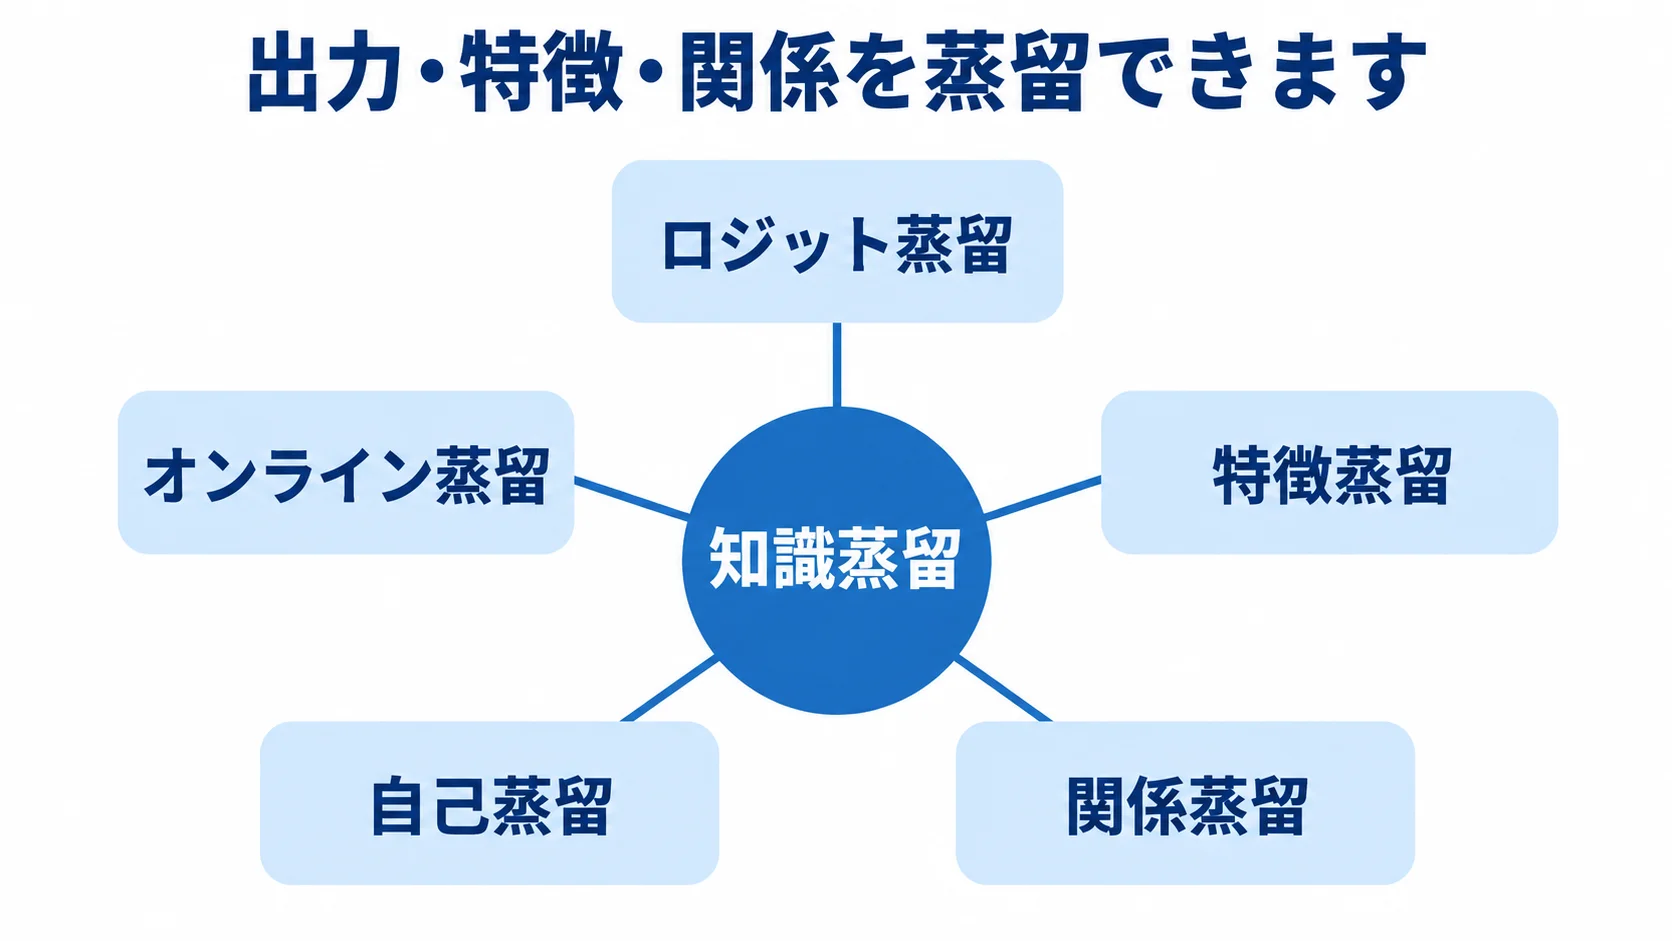
知識蒸留では、教師の出力だけでなく、中間層の特徴やサンプル間の関係も生徒へ移せます。確認では、ロジット蒸留、特徴蒸留、関係蒸留のそれぞれの観点から、何を移すのかを分けて見ます。
- ロジット蒸留:教師と生徒の出力分布を揃える方式。
- 特徴蒸留:中間層のベクトルや特徴マップを近づける方式。
- 関係蒸留:サンプル間の距離や類似度を移す方式。
- 自己蒸留:同じモデルの過去版や深い層を教師にする方式。
- オンライン蒸留:複数モデルを同時に学習し、互いの予測を利用する方式。
導入時の教師・生徒の制約の整理
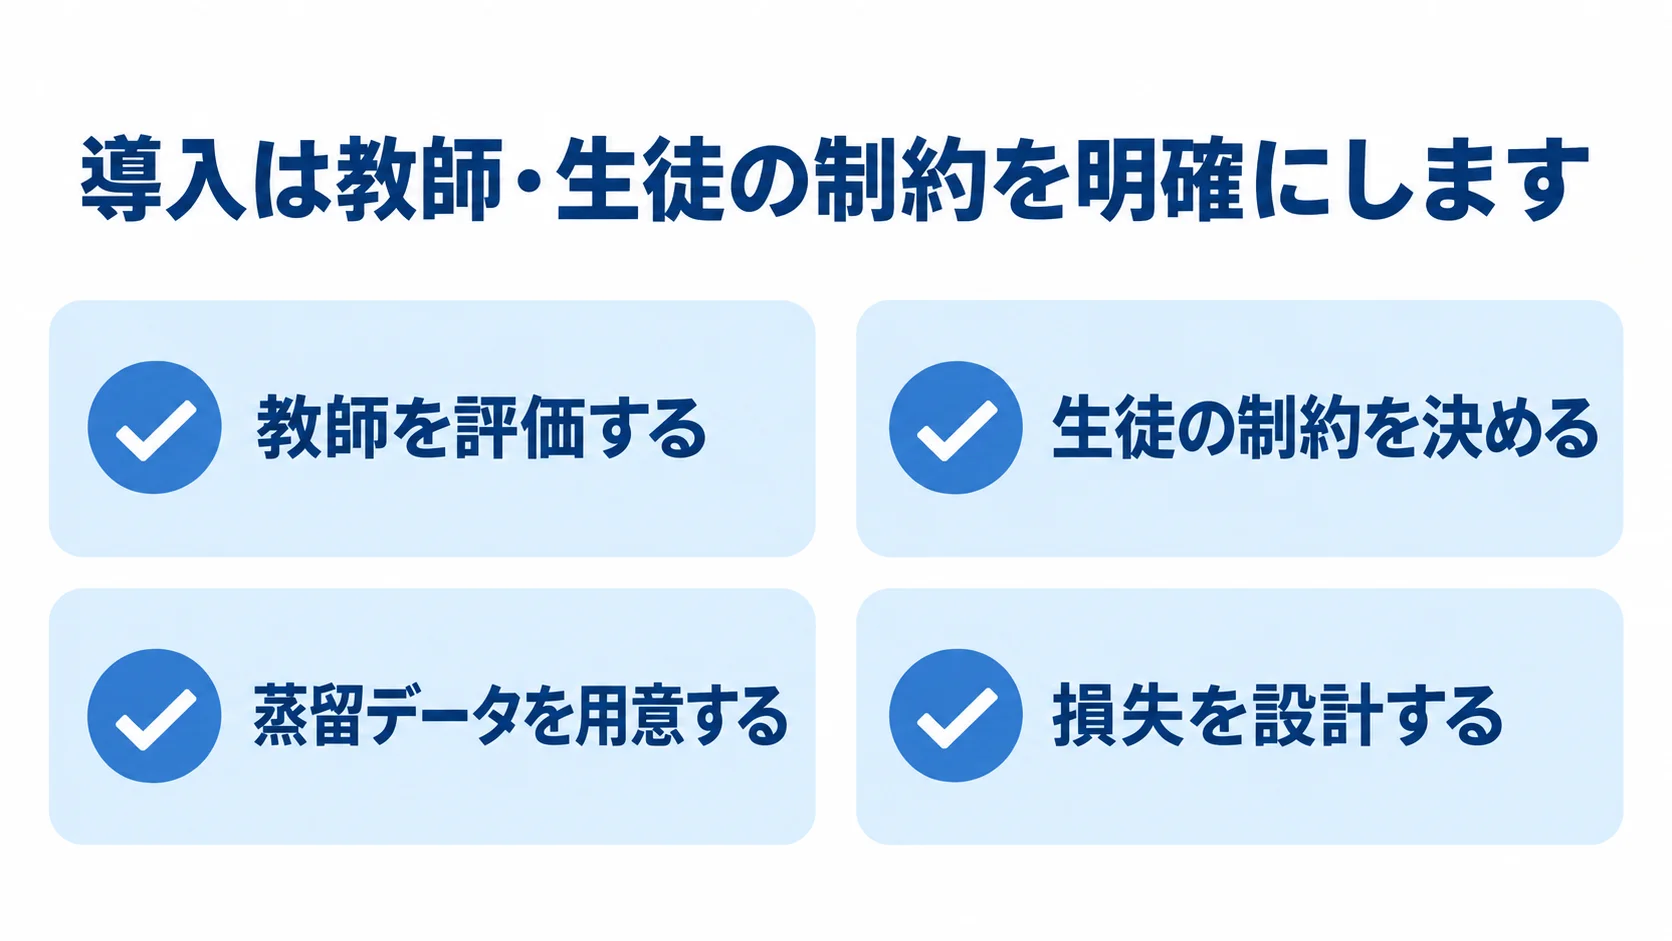
導入前には、教師の精度や誤りを見たうえで、生徒の制約や蒸留データ、損失の設計を決めておきます。
- 教師を評価する:対象ドメインの精度、誤り、校正、バイアスを確かめる。
- 生徒の制約を決める:モデルサイズ、CPU/GPU、遅延、消費電力を定義する。
- 蒸留データを用意する:ラベル付きデータ、未ラベルデータ、難例を分ける。
- 損失を設計する:正解、教師出力、特徴の重みを比べる。
- 量子化などと比較する:蒸留単独、量子化、枝刈り、併用を測る。
精度・サイズ・遅延の比較方法
比較では、蒸留なしで学習した生徒、教師、蒸留後の生徒を同じテストセットで並べます。精度に加えて、モデル容量、ピークメモリ、推論遅延を測ります。さらに、消費電力やクラス別の失敗も見ます。
教師の誤りや偏りも生徒に伝わります。そのため、精度・サイズ・公平性・安全性を比べて確かめる必要があります。
推論を軽くすると、スマートフォンやエッジ端末へモデルを配置しやすくなります。特にエッジ端末では、実機の結果を優先します。
知識蒸留で起きやすい失敗と対策
教師の誤りの持ち越し
教師の誤分類を分析したうえで、正解ラベルとの重みの見直し、難例の再確認、教師の校正を行います。
生徒の容量不足
生徒の層と幅に加えて、特徴蒸留、入力解像度、蒸留温度も比べます。
評価データの蒸留への混入
蒸留データと最終テストは分けておき、モデルの選択は検証データで行います。
知識蒸留の要点
知識蒸留は、教師の軟らかな予測や特徴を生徒に学習させ、サイズ・遅延・メモリを減らす方法です。そのうえで、温度と損失の重み、蒸留データを調整し、生徒の容量も見直します。
蒸留なしの生徒や教師と、量子化や枝刈りを同じ条件で比べます。精度だけでなく、実機の遅延やバイアスも確かめ、誤りやデータの分離もあわせて見ます。
よくある質問(FAQ)
知識蒸留についてよく寄せられる疑問に答えます。
Q. 知識蒸留とは何ですか?
大きな教師モデルの予測や特徴を小さな生徒モデルへ学習させるモデル圧縮の方法です。
Q. 温度は何のために使いますか?
教師の確率分布を滑らかにし、正解以外のクラス間の関係を生徒へ伝えやすくするために使います。
Q. 教師モデルは必ず高精度である必要がありますか?
教師の誤りや偏りも伝わるため、対象ドメインで精度・校正・失敗例を確認する必要があります。
Q. どのような効果がありますか?
生徒モデルのサイズ、メモリ、推論遅延を抑えながら、教師に近い性能を目指せます。
Q. 量子化と併用できますか?
併用できます。蒸留単独、量子化単独、併用を同じテストと実機条件で比較します。
参考資料
本文の説明では、Keras公式のサンプル、API資料、レシピを参照しました。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブックをダウンロードできます。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。