
L1正則化は、機械学習モデルの損失関数に係数の絶対値の合計を加え、係数が大きくなりすぎるのを抑える方法です。
係数の一部がちょうど0になりやすいため、特徴量選択やモデルの疎化に使えます。ただし、残った特徴量が因果関係を表すわけではないため、統計的・業務的な検証も必要です。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
L1正則化とは?係数の絶対値にペナルティを加える方法
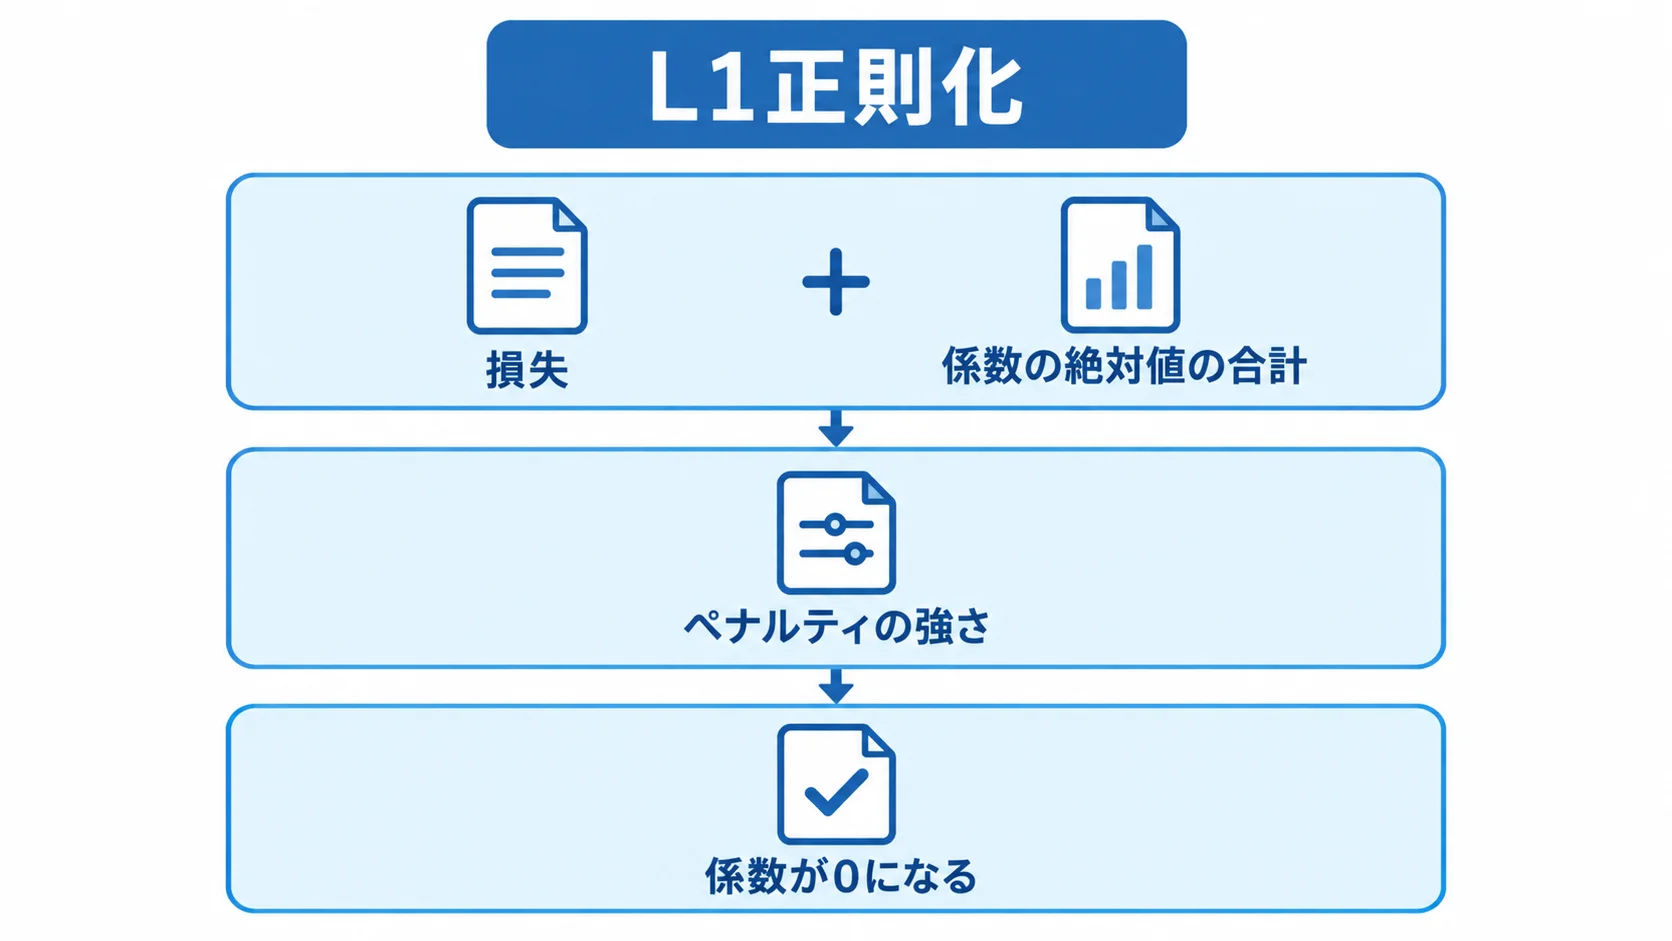
線形モデルは、入力特徴量に係数を掛けて予測を作ります。学習データに複雑に合わせすぎると係数が極端に大きくなり、未知のデータで誤差が増えることがあります。
そこでL1正則化では、通常の損失に係数の絶対値の合計を重み付きで加えます。最適化では、予測誤差を小さくしつつ係数も小さく保つバランスを探します。
回帰ではLasso、分類ではL1ペナルティ付きモデルと呼ばれることがあります。回帰の代表例であるLassoは、二乗誤差にL1ペナルティを加えたモデルです。分類ではロジスティック損失にL1ペナルティを加えます。
ペナルティの強さを大きくすると、多くの係数が縮みます。十分に強い場合は0になる係数も増えますが、強くしすぎると必要な特徴まで消えてしまいます。そのため、検証データで性能と解釈のバランスを確認します。
L1正則化の数式|損失と係数の大きさを合わせた目的関数
線形回帰で予測値をŷ、正解をy、係数をwとすると、L1正則化の目的関数は概念的に「二乗誤差 + λ × Σ|w_j|」と書けます。λは正則化の強さを表すハイパーパラメータです。
切片を正則化するかどうかは実装の仕様によるため、利用するライブラリの説明を確認します。分類でも考え方は同じで、損失の種類が変わるだけで、係数の絶対値に対するペナルティを加える点は変わりません。
係数が2つ以上あると、L1のペナルティの形は角のある領域になります。最適解はその角に当たりやすく、その結果、係数が0になります。
一方で、L2正則化の二乗和は滑らかな円形に近いため、係数を完全な0にするより、全体を小さくする傾向があります。これは数式の見た目だけの違いではなく、特徴量選択や相関した変数の扱いに影響します。
L1正則化とL2正則化の違い|疎な係数と均等な縮小
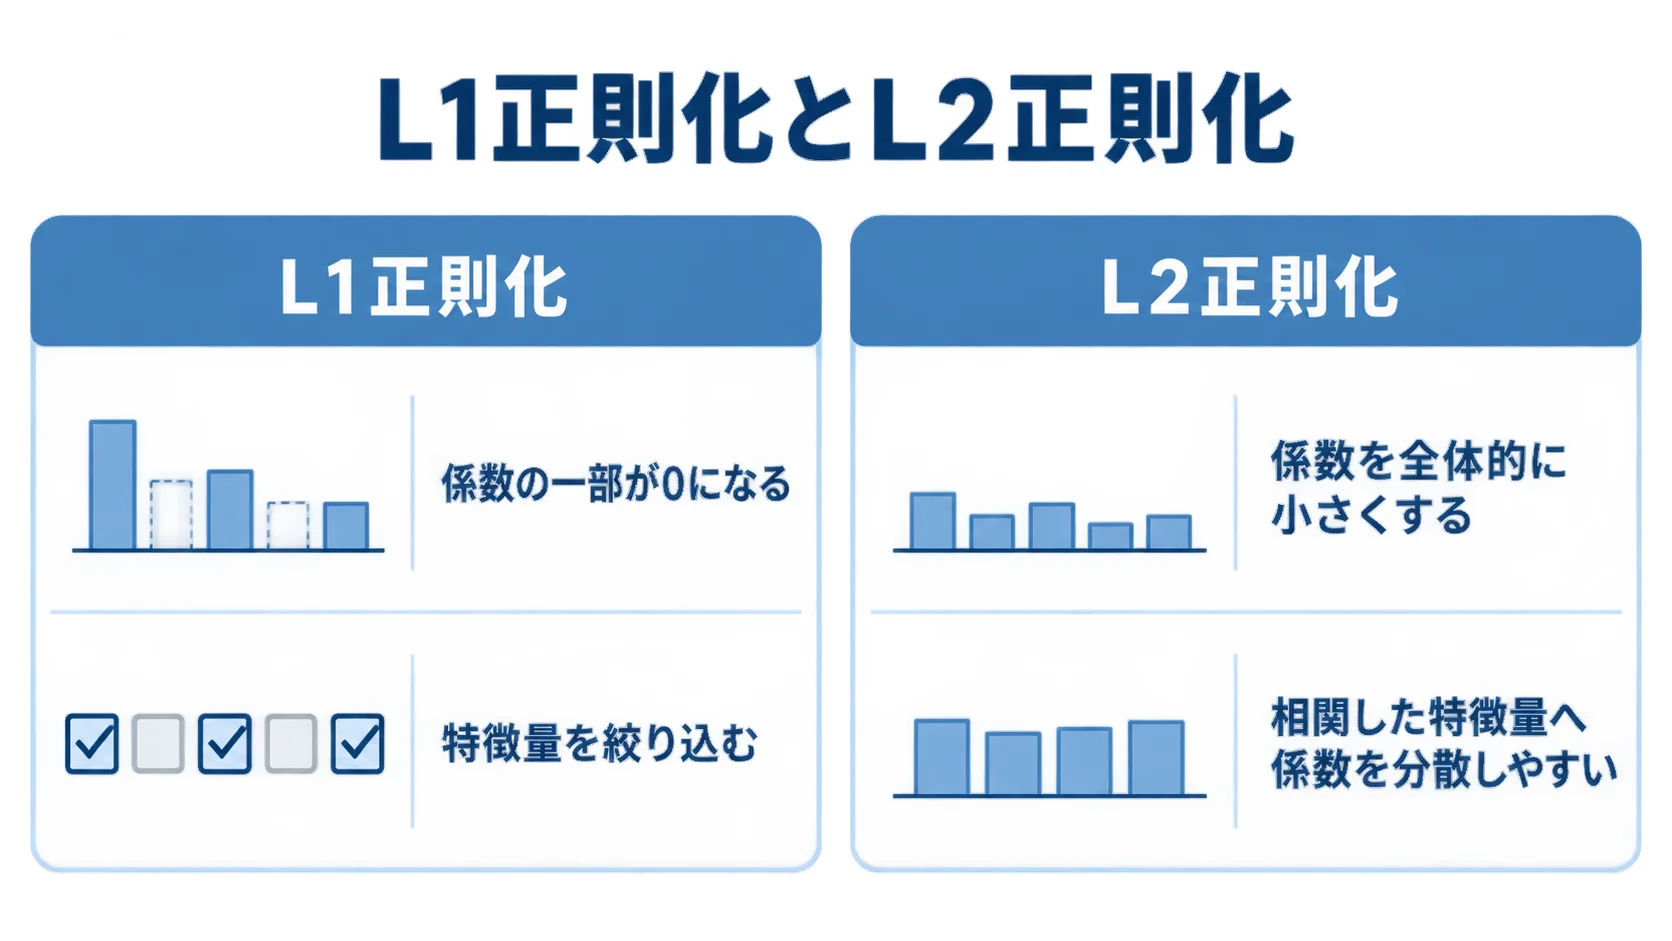
L1による係数の0化と特徴量の絞り込み
L1正則化の大きな特徴は、係数の一部が0になることです。係数が0の特徴量は予測式に寄与しないため、入力項目を減らしたり、説明の対象を絞ったりできます。
高次元のテキスト特徴量や、候補列が多い業務データで役立ちます。ただし、0になった特徴が本当に無関係とは限りません。データ分割や正則化強度が変われば、選ばれる列も変わるためです。
L2による相関した特徴量への係数の配分
L2正則化は係数の二乗和をペナルティにし、極端に大きい係数を強く抑えます。相関した特徴量がある場合は、それぞれに小さな係数を分けて持たせる傾向があります。
L1のような明確な特徴量の削減は起きにくいものの、入力列が少し変わっても係数が急変しにくい場合があります。どちらを選ぶかは、特徴量の相関、予測の安定性、説明要件で決めます。
Elastic NetによるL1とL2の組み合わせ
Elastic NetはL1とL2の両方のペナルティを目的関数に加える方法です。L1による疎化と、L2による係数の安定化を同時に狙えます。
強く相関した特徴量をすべて落とすのではなく、まとまりとして残したい場合に候補になります。L1比率と全体の正則化強度という2つのハイパーパラメータを持つため、交差検証で探索範囲を決めておきます。
特徴量スケールの影響|正則化前の標準化
L1正則化は、係数の大きさそのものにペナルティを加えます。そのため、身長をセンチメートル、年収を円で入力するように単位が異なる列が混ざると、同じ効果を表す係数の大きさが変わってしまいます。
標準化しないままL1を適用すると、スケールの大きい列が有利になったり不利になったりします。その結果、係数0の選択が単位に依存する可能性があります。そこで、数値列の尺度を確認し、必要なら訓練データだけで標準化器を適合します。
ワンホット化した0/1列を標準化するかは、モデルと実装を見て検討します。たとえば、数値列だけを標準化し、カテゴリ列はそのままにする設計もあります。
重要なのは、学習時と推論時に同じ変換を適用し、交差検証の各fold内で統計量を計算することです。標準化を全データで先に行うと、平均や分散を通じて評価データの情報が漏れるため、注意が必要です。
線形回帰でL1正則化を使う|Lassoの特徴と解釈
回帰でL1正則化を使う代表的な方法がLassoです。目的変数が連続値で、候補となる特徴量が多い場合に、予測へ寄与する列を絞り込む用途があります。
ただし、係数が0になった列を「不要」と断定することはできません。複数の分割や再標本化で選択頻度を調べると、選択の安定性を確認できます。
from sklearn.linear_model import Lasso
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

model = Pipeline([
    ("scale", StandardScaler()),
    ("regressor", Lasso(alpha=0.01, max_iter=10000)),
])
model.fit(X_train, y_train)
prediction = model.predict(X_test)
scikit-learnのLassoでは、alphaが正則化の強さに関係します。alphaが小さすぎると係数がほとんど縮まず、大きすぎると多くの係数が0になって予測性能が落ちます。
max_iterを増やしても収束しない場合は、まず特徴量のスケールとalphaを確認します。そのうえで、許容誤差や入力の欠損、無限値も見直します。また、実験ではalphaと検証スコア、非ゼロ係数数を一緒に記録しておきます。
分類モデルでL1正則化を使う|ロジスティック回帰の設定
二値分類や多クラス分類では、L1ペナルティ付きのロジスティック回帰を使えます。テキストの単語出現、顧客属性、ワンホット化したカテゴリなど、特徴量が多い問題で予測式を疎にできます。
ただし、scikit-learnのLogisticRegressionでは、solverごとに使えるペナルティが異なります。そのため、公式ドキュメントで組み合わせを確認します。
分類の正則化パラメータCは、一般に小さいほど正則化が強く、大きいほど弱くなる向きで設定されます。回帰のalphaと向きが異なるため、パラメータ名だけを見て比べないようにします。
不均衡データでは、class_weight、評価指標、しきい値を同時に設計します。係数の絶対値が大きい列を重要と読む前に、標準化とカテゴリの基準、相関、正則化強度を確認しておきます。
正則化強度の選び方|交差検証による性能と疎性の比較
正則化強度を決めるときは、訓練データのスコアだけに頼らないようにします。訓練データを複数のfoldに分け、各候補値で学習して検証指標を比べます。
回帰ならMAEやRMSE、分類ならF1やPR-AUCが候補になります。業務上の誤りに合う指標を、再現率なども含めて選びます。最終テストデータは候補値を選んだ後に一度だけ使い、開発中の調整には流用しません。
スコアがほぼ同じ候補が複数あるなら、非ゼロ係数が少ないモデル、推論が軽いモデル、係数の選択が安定したモデルを選べることがあります。ただし、疎であることが常に優先されるわけではありません。
取りこぼしのコストが高い業務では、わずかな精度差であっても密なモデルを採用する場合があります。また、採用基準は事前に文書化し、後から都合よく選ばないことが大切です。
相関した特徴量とL1正則化|選択結果の受け止め方
身長と腕の長さ、売上と注文数のように相関の強い特徴量があると、L1正則化は片方だけを残すことがあります。分割によっては、残す列が入れ替わることもあります。
係数が0になった列は、情報を持たないとは限りません。似た情報を別の列が代表している可能性があるためです。特徴量選択の結論を出すなら、相関行列、選択頻度、ドメイン知識を合わせて判断します。
同じグループの特徴をまとめて残したい場合は、Elastic Netやグループ正則化などの方法を検討します。なお、単一の学習結果から重要度ランキングを作り、施策の因果効果まで推論するのは危険です。
L1は予測モデルの複雑さを制御する道具です。特徴量の意味や介入の可能性を直接証明するものではありません。
L1正則化のデータリーク対策|分割内での標準化と特徴量選択
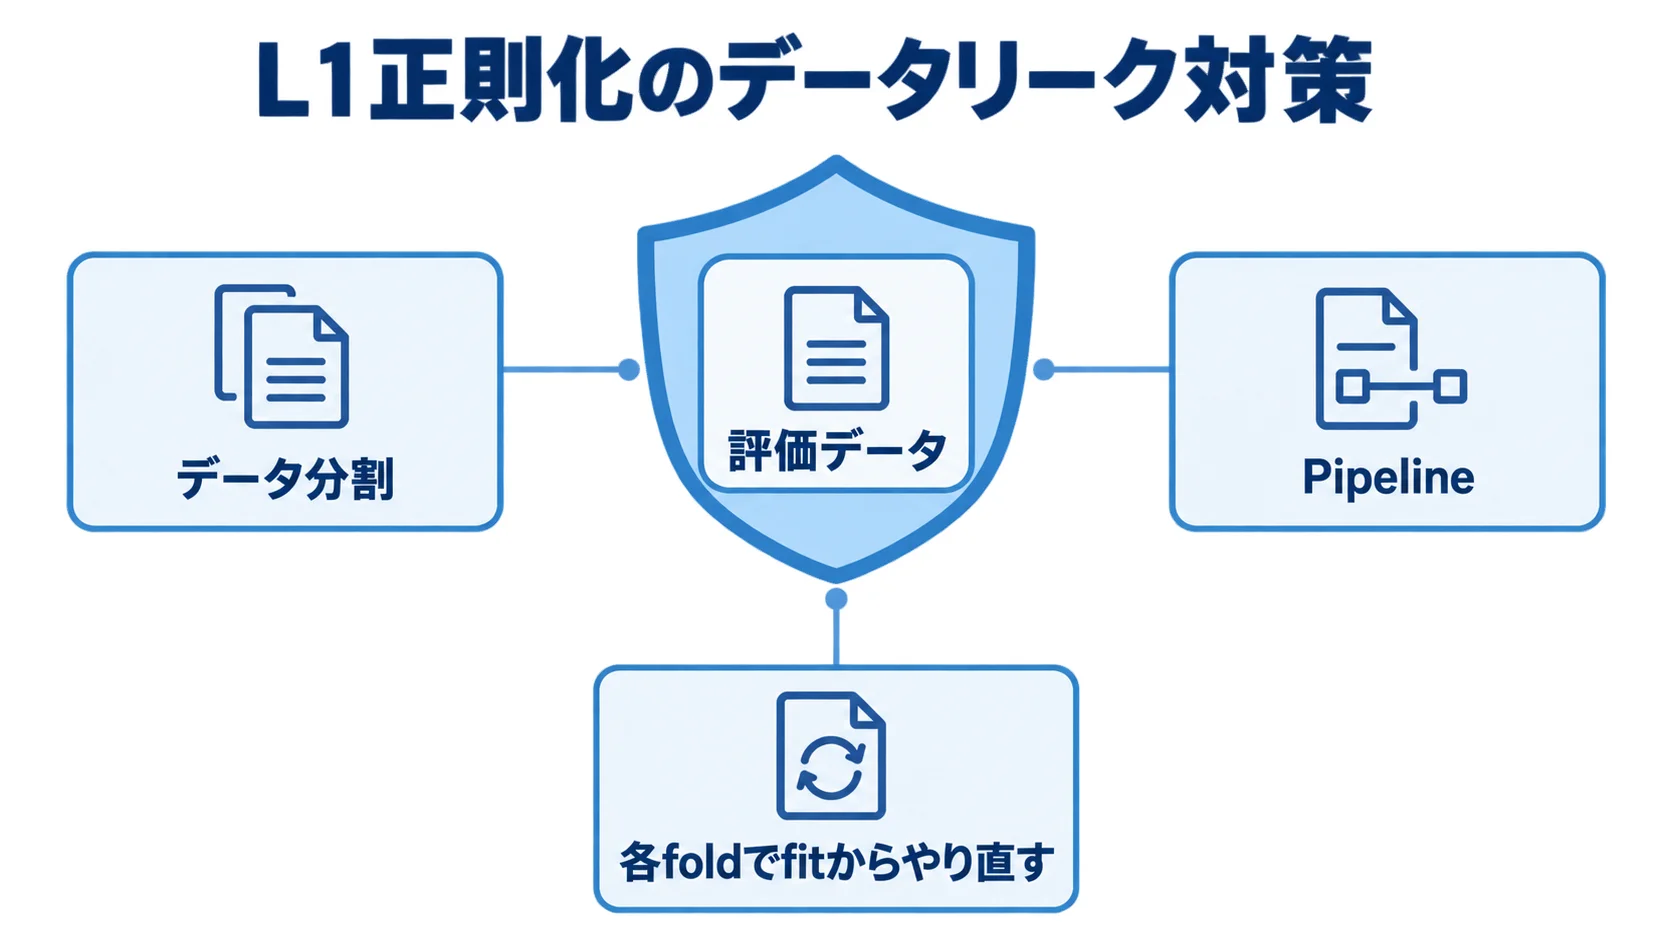
特徴量の標準化、欠損値補完、特徴量選択を全データに先に適用すると、評価データの情報が訓練側へ入ってしまいます。L1で係数を0にする処理も学習の一部なので、交差検証の外で選択してはいけません。そこで、前処理とL1モデルをPipelineへまとめ、各foldでfitからやり直す構成を採用します。
時系列データでは、未来の観測から標準化統計量や特徴量の選択を行わないようにします。また、顧客や患者など同一個体の行が複数ある場合は、同じ個体が訓練と検証にまたがらない分割を選びます。
L1を使ったからといってリークがなくなるわけではありません。データ分割、前処理、評価の順序を一貫させる必要があります。
運用と解釈|係数0と業務判断の切り分け
運用では、予測性能だけでなく、特徴量選択の安定性と再学習での変動を監視します。非ゼロ係数の数や推論時間も、継続して追います。
新しい期間で係数が大きく入れ替わる場合は、データ分布の変化、特徴量の相関、正則化強度の不足や過剰を確認します。また、係数と前処理器を同じバージョンで保存し、どの列がどの変換後の列かを追跡できるようにします。
係数の符号は、他の特徴量を一定にしたときのモデル上の関係を表します。観測データだけから、原因と結果を示すものではありません。
施策を決める際は、係数と予測への寄与を、実験結果や業務知識、個人情報・公平性の制約と合わせてレビューします。説明資料には、標準化後の単位、基準カテゴリ、L1強度、評価期間を明示します。
L1正則化まとめ|疎性と予測性能のバランスの検証
L1正則化は、損失関数に係数の絶対値の合計を加えて係数を縮小し、一部を0にしやすくする方法です。L2正則化が係数を全体的に小さくするのに対し、L1は特徴量を絞り込む効果があります。
Elastic Netは両方の性質を組み合わせた方法で、相関した特徴量が多い場合の候補になります。
利用時は、特徴量のスケールをそろえ、標準化・欠損補完・特徴量選択を交差検証の各訓練分割内で行います。正則化強度は業務指標で選んだうえで、スコアと非ゼロ係数数を記録します。また、選択の安定性と推論コストも記録しておきます。
0になった係数は、因果関係がないことの証拠とは扱わず、相関とデータ分割の影響を確認したうえで業務判断へつなげます。
よくある質問(FAQ)
Q. L1正則化とは何ですか?
L1正則化は、損失関数に係数の絶対値の合計を加えて係数を縮小し、一部を0にしやすくする方法です。予測性能の改善だけでなく、特徴量を絞り込む目的にも使われます。
Q. L1正則化とL2正則化は何が違いますか?
L1は係数の一部を0にしやすく、L2は係数全体を小さくする傾向があります。使い分けは、特徴量を減らしたいか、相関した列へ係数を安定して分けたいかで決まります。
Q. L1正則化で標準化は必要ですか?
単位や尺度が異なる数値列を含むなら、標準化を検討します。標準化器は訓練データだけで適合し、検証・テストへ同じ変換を適用してデータリークを防ぎます。
Q. 正則化の強さはどう決めますか?
交差検証で複数の強度を比べ、業務に合う検証指標と非ゼロ係数数で決めます。選択の安定性と推論コストも確認します。最終テストデータは候補を決めた後に一度だけ使います。
Q. 係数が0になった特徴量は不要ですか?
不要と断定はできません。相関した特徴量の代わりに選ばれなかった可能性があり、データ分割や強度で結果が変わります。選択頻度や業務知識を合わせて判断してください。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
参考資料
L1・L2正則化と前処理の公式資料は、Lasso、LogisticRegression、ElasticNet、StandardScalerのいずれも scikit-learn の公式ドキュメントにあります。
- scikit-learn「Lasso」
公式資料 - scikit-learn「LogisticRegression」
公式資料 - scikit-learn「ElasticNet」
公式資料 - scikit-learn User Guide「Linear Models」
公式資料 - scikit-learn「StandardScaler」
公式資料
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。