
L2正則化は、機械学習モデルの係数や重みが大きくなりすぎないように、重みの二乗和に応じたペナルティを損失関数へ加える方法です。線形回帰でL2正則化を使う代表的な手法が、リッジ回帰です。
訓練データへの当てはまりだけを追うと、ノイズを覚えて未知データで外れます。そこで、L2正則化は予測誤差とモデルの複雑さを同時に小さくし、過学習を抑えます。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
L2正則化の定義|重みの大きさにペナルティを加える方法
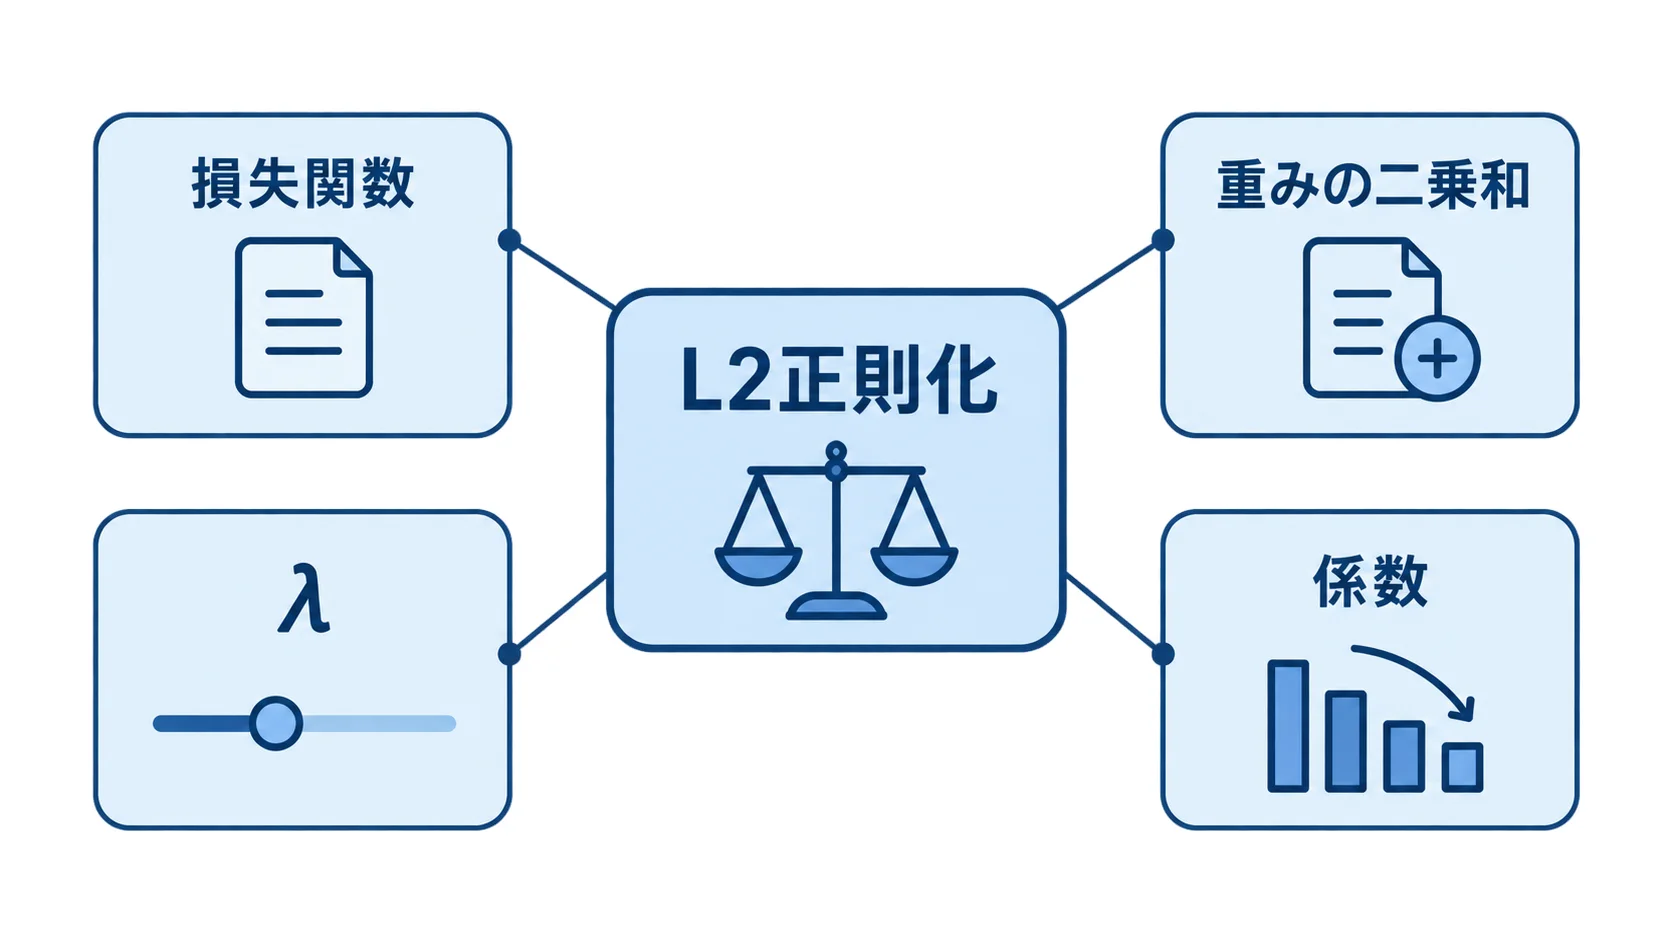
L2正則化は、損失関数に重みの二乗和を加えることで、極端に大きな係数を持つ解を選びにくくする仕組みです。具体的には、回帰の損失を二乗誤差、重みをw、正則化係数をλとすると、概念的には「データへの誤差 + λ×重みの二乗和」を最小化します。λが0なら通常の最小二乗法と同じになり、λを大きくするほど重みを小さくする力が強くなります。
ここでいうL2は、重みを二乗して足し合わせるノルムに由来します。二乗しているため、絶対値が大きい重みほど強いペナルティがかかり、すべての重みを少しずつ縮める方向に働きます。
L2は係数を完全に0へ固定することを直接の目的にしません。そのため、関連する特徴量を残しながらモデル全体を滑らかにしたい場合に向いています。
L2正則化の仕組み|損失関数と係数の関係
予測誤差と係数の大きさの同時評価
L2正則化は、予測誤差と係数の大きさを同時に評価します。
- 予測誤差の縮小
- λによるL2ペナルティの強さの調整
- 一部の係数だけでなく、係数全体を縮める働き
正則化なしのモデルは、訓練データの誤差を下げるために係数を大きくすることがあります。特に特徴量同士の相関が強い場合や、特徴量の数がサンプル数に近い場合は、データを少し変えただけで係数が大きく変わりやすくなります。そこで、L2のペナルティを加えると、誤差がわずかに減る代わりに係数が急増する解を避け、より小さな係数で説明できる解を選びます。
λの大きさは、データへの適合と単純化のバランスを決めます。小さすぎるλでは正則化の効果が弱く、過学習が残る可能性があります。
一方で、大きすぎるλでは係数が一様に小さくなり、必要な信号まで抑えてしまうため、訓練・検証の両方で誤差が高い未学習状態になります。最適値は理論だけでは決まらないため、未知データを模した検証手順で選びます。
切片の正則化と実装による違い
線形モデルでは、特徴量に掛かる係数と切片を分けて扱うのが一般的です。切片まで強く縮めると、特徴量を平均中心化していない場合に予測の基準値が不自然にずれる可能性があるため、多くの実装では切片を正則化の対象から外します。
ただし、ライブラリや自作実装で扱いが違うことがあります。使用するAPIの仕様と、前処理の有無を実験記録に残してください。
L2正則化とL1正則化の違い|縮小とスパース化
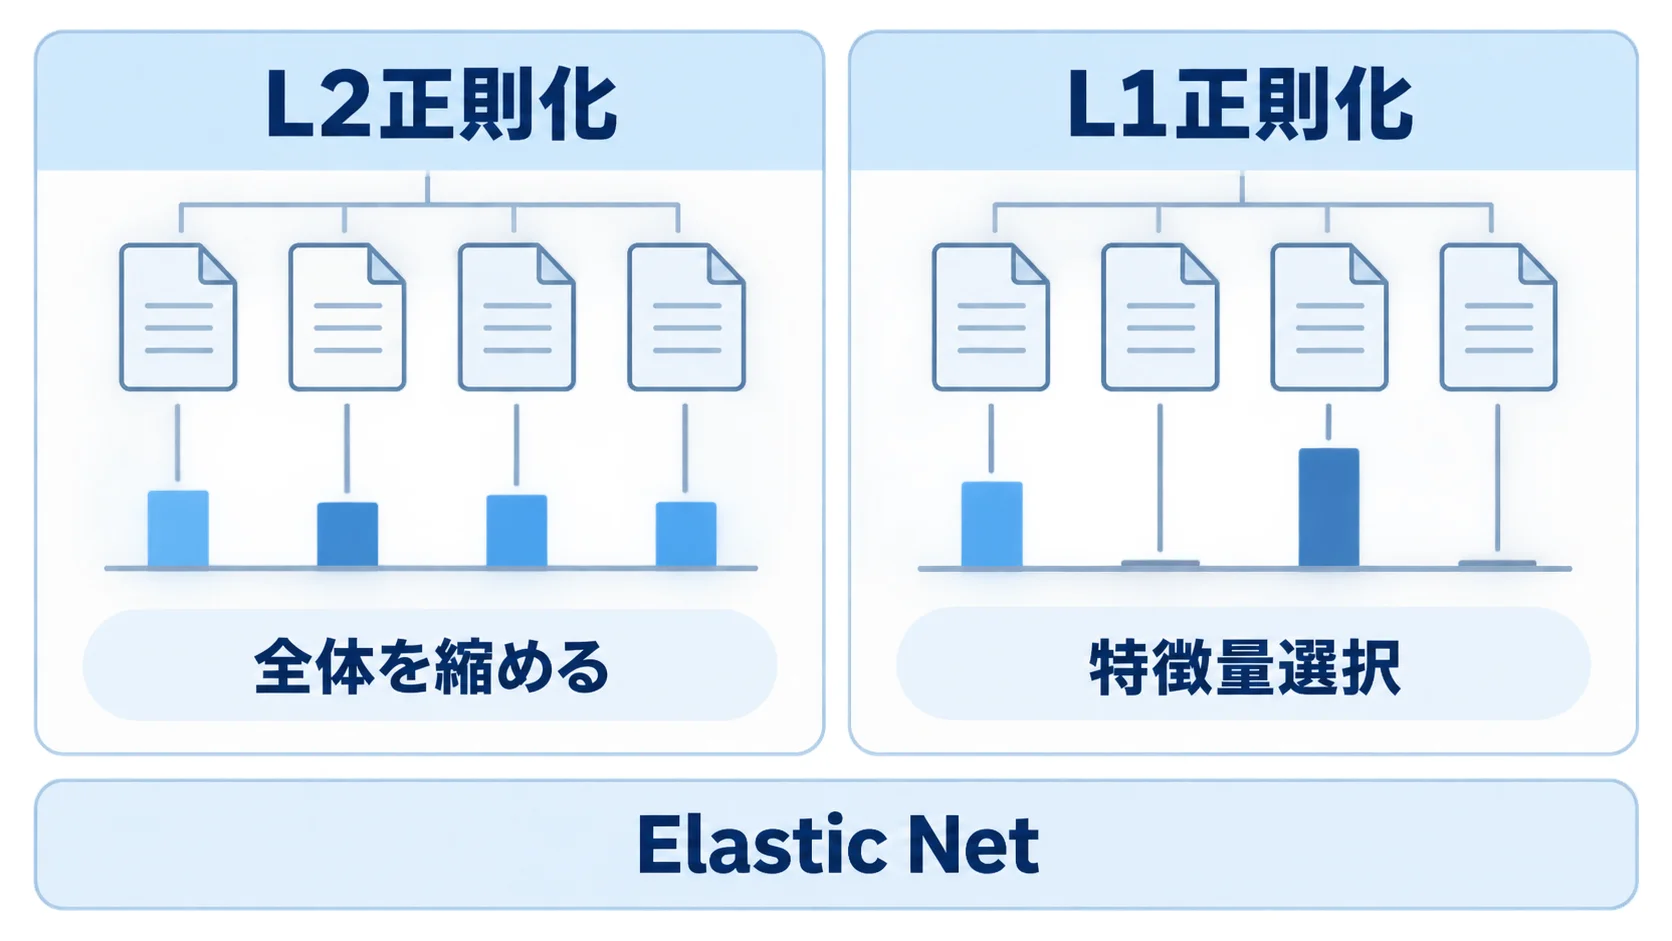
L1正則化は、重みの絶対値の和をペナルティにします。L1では一部の係数がちょうど0になりやすいため、特徴量選択やスパースなモデルを得たいときに使われます。
一方、L2は相関した特徴量へ係数を分散させながら全体を縮める傾向があります。どちらが適しているかは、特徴量の性質、説明の仕方、予測の安定性を踏まえて選びます。計算コストも合わせて見ます。
Elastic NetによるL1とL2の組み合わせ
L1とL2を同時に使うElastic Netは、スパース化と係数の安定化の両方を狙う方法です。特に、強く相関した特徴量が多いとき、L1だけではどれか一つを選ぶ結果が分割ごとに変わることがあります。
そこで、L2成分を加えると、関連する特徴量へ重みを分けて持たせる余地が生まれます。正則化の種類を増やすほど調整対象も増えるため、検証データで比較し、採用理由を説明できるようにします。
L2正則化で重要な前処理|特徴量の尺度調整
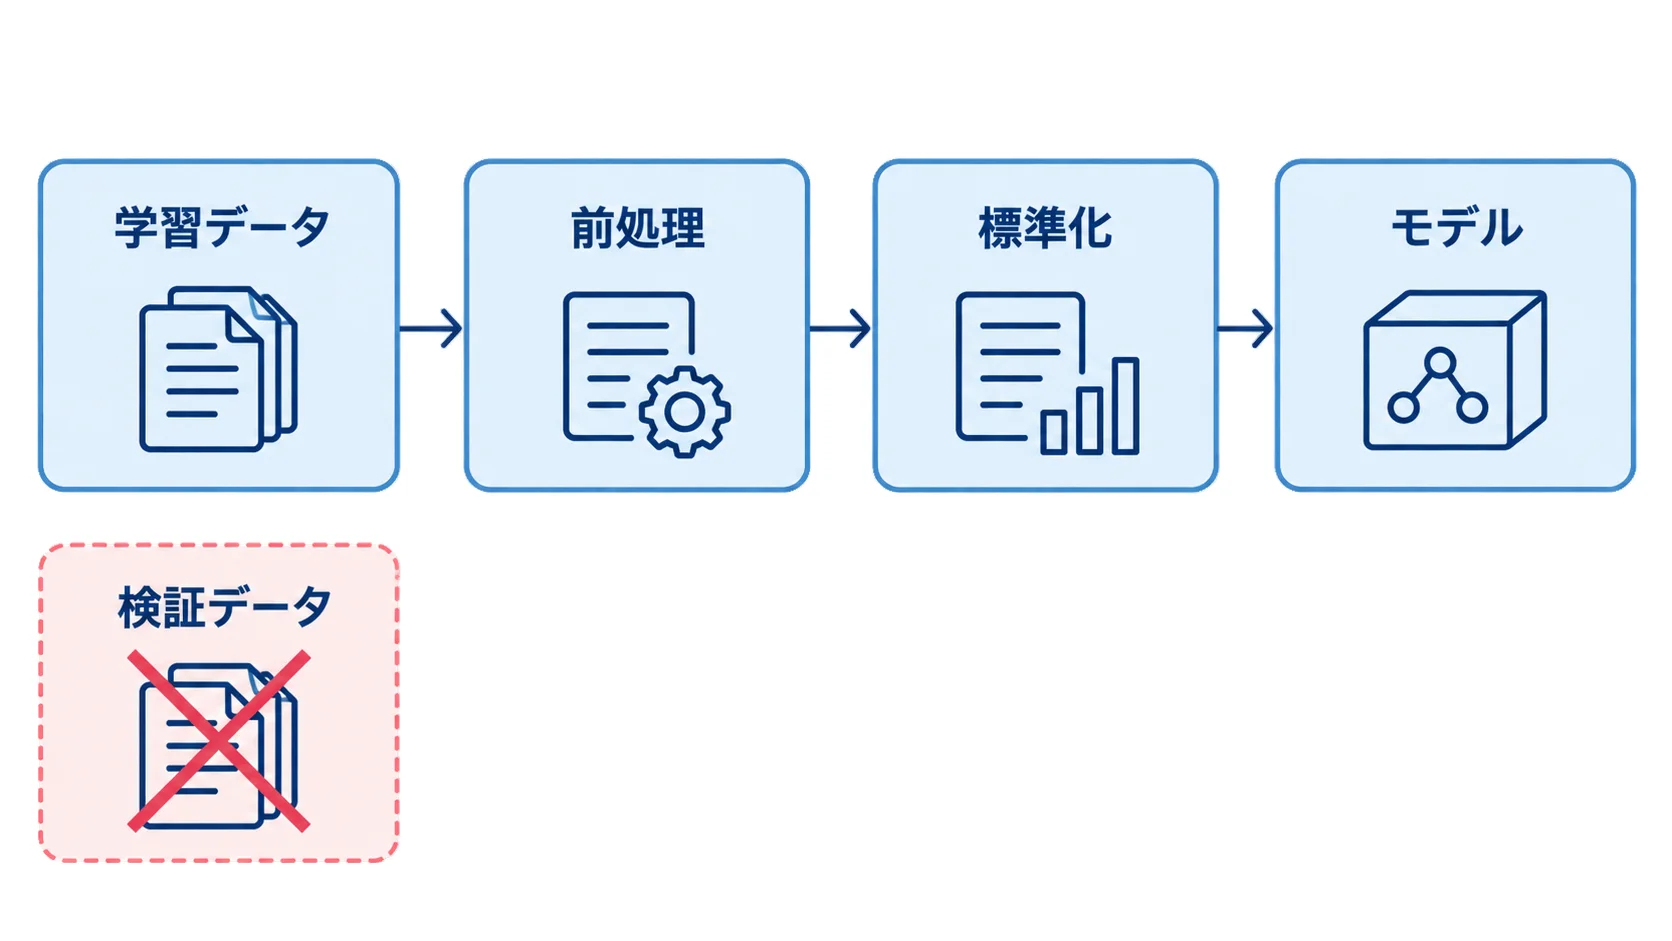
L2正則化は係数の大きさに直接ペナルティをかけます。そのため、特徴量の単位が異なると、同じ情報量でも係数の数値が変わり、正則化の効き方に差が出ます。
たとえば、年齢を年単位、売上を円単位のまま同じモデルへ入れると、尺度の大きな特徴量の係数が相対的に小さく見えることがあります。そこで、標準化や適切な変換を検討し、変換のパラメータは学習データだけで推定します。
標準化の平均と標準偏差は、学習データだけから計算します。検証データの分布を使うと、検証情報が学習処理へ漏れてしまうからです。
前処理とモデルを一つのパイプラインとして扱い、分割のたびに学習側だけで変換を適合させます。カテゴリ変数のエンコードや欠損値補完、外れ値処理も、この仕組みに含めて管理します。
L2正則化係数の決め方|交差検証と実務的な探索
λの対数スケールによる候補設定
正則化係数は、0.0001、0.001、0.01、0.1、1、10のように桁をまたぐ候補を対数間隔で試すと、効果の変化を捉えやすくなります。
係数の記号やAPIのパラメータ名が異なる点には注意が必要です。たとえば、リッジ回帰のalphaとロジスティック回帰のCでは、値と正則化の強さの向きが逆になります。
ドキュメントで値の向きを確かめたうえで、開発会社は実験表に実際のペナルティの強さを併記します。
交差検証による未知データへの性能比較
λの候補は、交差検証で同じ評価条件のもとに比べます。
- 訓練データの複数分割
- 各訓練分割の中だけで行う前処理の適合
- 各分割の検証指標の集計と比較
係数の候補を選ぶときは、訓練誤差だけでなく交差検証のスコアを比較します。一つの分割だけで選ぶと、たまたまその分割に合った値を選んでしまうおそれがあるためです。
分類ではクラス比率を保つ層化分割、時系列では未来を使わない時系列分割、同一顧客が複数行ある場合はグループ分割を使うなど、業務の予測単位に合わせます。
最終評価用のテストデータは、λの選択や特徴量の比較には使わないでください。交差検証を何度も見て設計を調整すると、モデルが検証スコアにも適合してしまいます。そのため、最終的なテストは、モデルと正則化係数、前処理が固まった後に一度だけ実施するか、必要に応じて入れ子交差検証を検討します。
L2正則化の実装例|前処理とモデルの一体検証
# scikit-learnの概念例(数値特徴量を標準化してリッジ回帰を評価)
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge
from sklearn.model_selection import GridSearchCV

pipeline = make_pipeline(StandardScaler(), Ridge())
search = GridSearchCV(
    pipeline,
    {"ridge__alpha": [0.001, 0.01, 0.1, 1, 10]},
    cv=5,
    scoring="neg_mean_absolute_error",
)
search.fit(X_train, y_train)
prediction = search.predict(X_test)
この例では、標準化とリッジ回帰をパイプラインにまとめ、交差検証の各学習分割で標準化を適合します。実際には、開発会社がデータの順序や分割方法、欠損処理を業務に合わせて設定します。評価指標も、業務で重視する点に沿って選んでください。
分類であれば、ロジスティック回帰などへ置き換えます。クラス不均衡がある場合は、正解率以外の指標も確認します。
また、正則化を使うモデルでは、係数を単純に「重要度」と断定せず、解釈の前提を確かめる必要があります。標準化後の係数は単位がそろいますが、相関した特徴量では係数が分担されます。
係数の符号や大きさを読むときは、特徴量の定義や欠損処理、交互作用に加え、学習期間も確認します。予測性能と説明の目的が異なる場合は、係数の安定性を分割ごとに比べます。
ニューラルネットワークでのL2正則化|重み減衰の考え方
ニューラルネットワークでは、損失関数に重みの二乗和を加える方法と、最適化器の更新で重みを減衰させる方法が関連します。
単純な確率的勾配降下では似た挙動になります。一方、Adamなどの適応的な最適化器では、勾配へL2項を足す方式と、重み減衰を更新から分離する方式で結果が異なる場合があります。
開発会社は、PyTorchやTensorFlowのAPIで引数の意味を確認し、実験条件に最適化器、学習率、減衰率を記録します。
実際には、L2のほかに、データ拡張やドロップアウトを組み合わせることがあります。早期終了やバッチ正規化と重ねる場合もあります。
ただし、正則化を複数重ねると、どの仕組みが効いたのか分かりにくくなります。まずベースラインを固定し、一つずつ変更して検証スコア、学習曲線、推論コストを比較してください。
L2正則化で起こりやすい失敗と対策
分割前の前処理によるリーク
平均・分散の計算、特徴量選択、欠損値補完を全データで先に行うと、検証データの情報が学習側へ混ざります。L2の有無にかかわらず評価が楽観的になりますが、正則化係数を選ぶときには特に危険です。
開発会社は、変換器をパイプラインに入れ、各分割の学習部分だけで適合させることで、リークを防ぎます。
正則化の強すぎによる信号の消失
検証誤差が高く、訓練誤差も高い場合は、λが大きすぎる、特徴量の尺度が不適切、モデルの表現力が不足しているなどの原因が考えられます。係数が小さくなったことを成功とみなさず、学習曲線と指標を見て判断します。
開発会社は、業務上重要な少数の特徴量まで抑えられていないか、正則化なし・弱い正則化との比較を残しておくと原因を切り分けやすくなります。
学習時と運用時の分布のずれ
L2正則化は学習データの範囲で係数を安定させる方法であり、将来の分布変化を自動で解決するものではありません。顧客層や価格帯が変わると、正則化係数の最適値や誤差の傾向が変わります。季節や計測機器が変わる場合も、最適値は動く可能性があります。
運用開始後は、開発会社が入力分布、予測分布、実績が得られた後の性能を監視し、再学習の条件を決めます。
L2正則化を採用する判断基準|単純なベースラインとの比較
まず正則化なしの線形モデル、L2、L1、Elastic Netを同じ分割と指標で比較します。データ量が少ない場合や、特徴量が多く相関が強い場合には、L2が有力な候補です。係数を極端に大きくしたくない場合にも、L2が選ばれやすくなります。
開発会社は、明確な特徴量選択やスパースな説明が必要ならL1、両方の性質が必要ならElastic Netを検討します。
モデルを選ぶときは、平均スコアだけでなく分割間のばらつきも確認します。平均性能が同じでも、L2のほうが結果の振れ幅が小さいなら、運用時の予測リスクを抑えられる可能性があります。
ただし、わずかな改善のために係数の説明やパイプラインを複雑にする価値がない場合もあります。精度、安定性、説明可能性を同じ表で比べます。推論速度と再学習の手間も、表に書き添えてください。
L2正則化まとめ|係数の抑制と未知データへの適応
L2正則化は、重みの二乗和に応じたペナルティを加え、極端な係数を避ける方法です。L1のように係数を0へ寄せるよりも、特徴量を残しながらモデル全体を滑らかにする方向に働きます。
正則化係数は対数スケールの候補を交差検証で比較し、前処理を含むパイプラインとして評価します。
判断では、正則化の設定値の調整に加えて、尺度の統一やデータ分割、リーク対策も見ます。指標や分布変化、運用コストまで含めて、採用の是非を決めます。
ニューラルネットワークではL2項と重み減衰の実装差にも注意し、使用する最適化器の仕様を確認してください。単純なベースラインとの比較を残せば、L2正則化が本当に業務上の価値を生んだかを説明できます。
よくある質問(FAQ)
Q. L2正則化とは何ですか?
L2正則化とは、モデルの重みの二乗和に応じたペナルティを損失へ加え、極端に大きな係数を抑える方法です。訓練データへの過適合を抑え、未知データでの安定性を高める目的で使います。
Q. L2正則化とL1正則化はどう違いますか?
L2は重みを全体的に縮め、L1は一部の係数を0にしてスパース化しやすい方法です。特徴量を残したまま安定させたいときはL2、特徴量選択を重視するときはL1が候補になります。
Q. L2正則化の係数はどう決めますか?
係数の候補は対数スケールで用意し、前処理とモデルを含む交差検証で、未知データを模した指標を比べます。APIによって値の大小と正則化の強さの関係が違うため、仕様を確認してください。
Q. L2正則化で標準化は必要ですか?
特徴量の尺度が大きく異なる場合は、標準化などで尺度をそろえることを検討します。平均や分散は学習分割だけで推定し、検証データの情報が前処理へ漏れないようパイプラインで管理します。
Q. ニューラルネットワークの重み減衰はL2正則化と同じですか?
単純な勾配降下では似た挙動になりますが、適応的な最適化器ではL2項を勾配へ加える方法と重み減衰を更新から分離する方法が一致しない場合があります。使うフレームワークと最適化器の仕様を確認してください。
参考資料
scikit-learnとPyTorchのL2・Elastic Net関連資料を挙げます。
- scikit-learn User Guide「Ridge regression and classification」
公式資料 - scikit-learn User Guide「Elastic-Net」
公式資料 - scikit-learn「Pipeline」
公式資料 - PyTorch「AdamW」
公式資料
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。