
大規模システムの年間保守運用費は、初期開発費の規模、高可用性の要件、運用体制によって、数百万円から数千万円規模まで変わります。
費用を見るときは、年額の大きさに加えて、冗長化や運用体制による増え方も押さえておくと役立ちます。
▼全体ガイドの記事
・大規模システム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
大規模システムの運用保守費の規模感
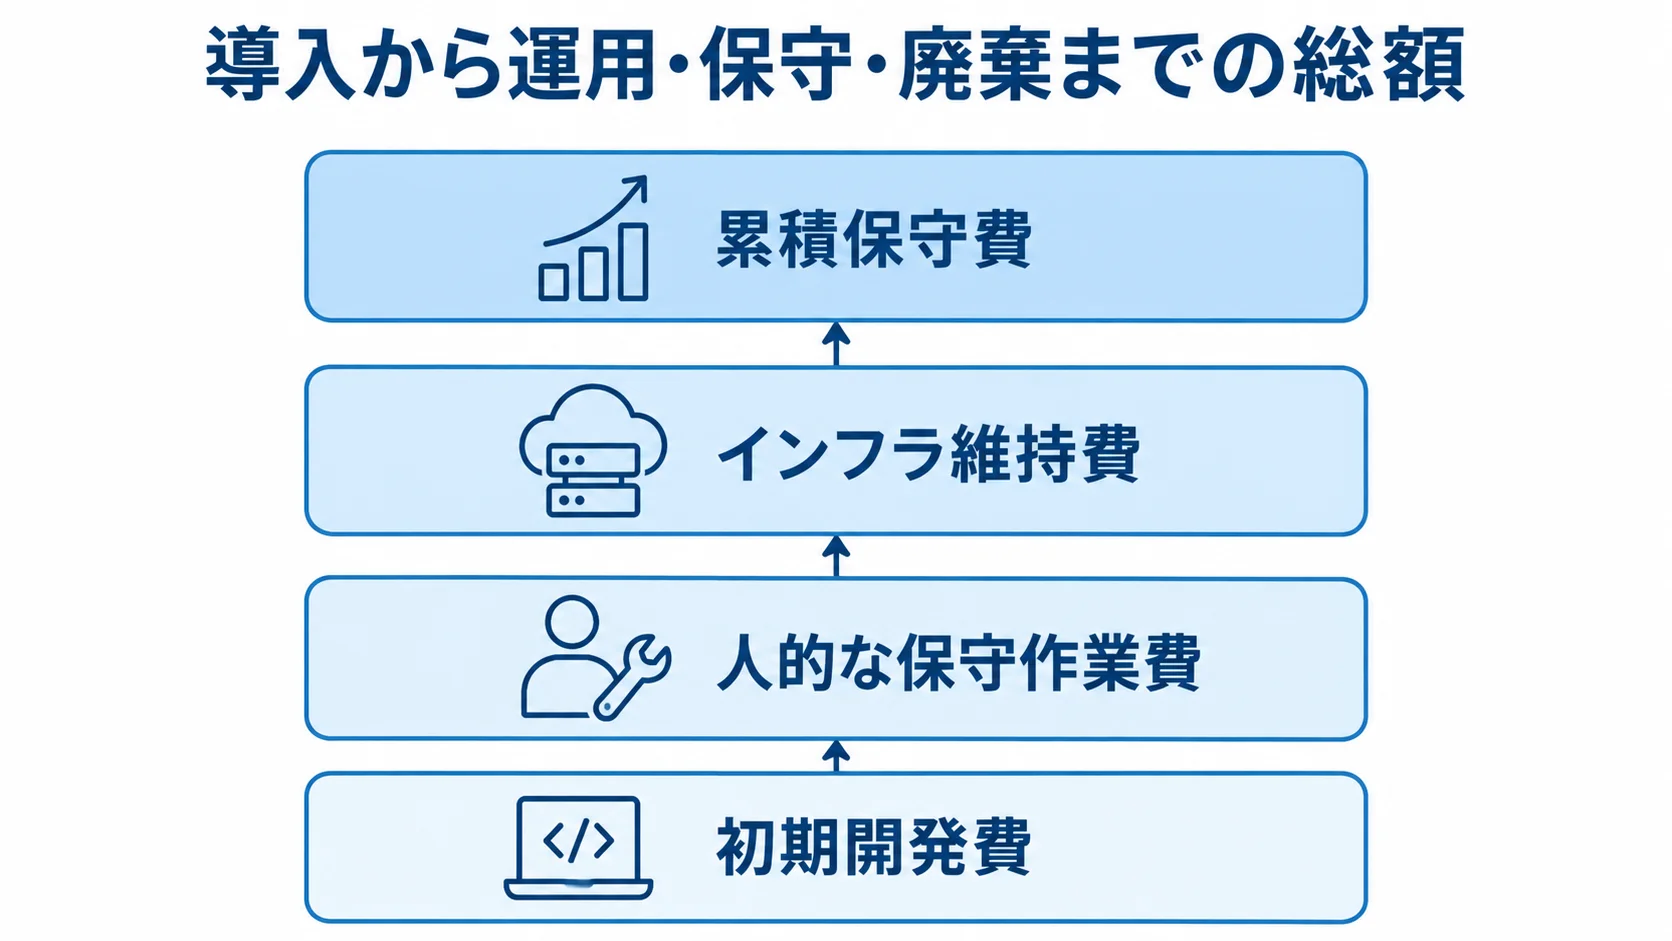
大規模システムは初期開発費が大きいぶん、保守費も高額になりやすい構造です。長く使うほど運用費の累積額も膨らみ、開発費が数千万円から数億円の規模なら、年間保守費が小規模システムの初期開発費を上回ることも珍しくありません。
発注側は、年間保守費の目安と絶対額を確認したうえで、数年単位のTCO(総所有コスト)で捉えることが大切です。
年間保守費の比率と絶対額
比率自体は小規模でも大規模でも大きく変わりません。ただし、大規模では初期開発費が桁違いに大きく、保守費の絶対額も膨大になります。
- 年間保守費:初期開発費の10%から20%程度が目安です。
- 開発費3,000万円の場合:年間300万円から600万円の保守費が発生します。
- 数億円規模の全社基幹システム:年間数千万円になることも珍しくありません。
保守費はシステムを使い続けるかぎり毎年発生し、大規模システムではクラウドインフラだけでも月額数十万円から100万円以上になる場合があります。年額に直すと、インフラ費は数百万円から1,000万円以上に達することもあります。
人的な保守作業費とインフラ維持費が二重に積み上がるのが、大規模システムの特徴です。このため、発注側は初期開発費だけで判断せず、稼働後に毎年発生する保守費も当初から予算に含める必要があります。
5年TCOで初期開発費と同等以上になる構造
TCO(Total Cost of Ownership/総所有コスト)は、導入から運用・保守・廃棄までの総額です。比較の際は、保守費の累積や初期費用以外の支出も判断材料に入れます。
- 累積保守費:年10%から20%なら、単純計算で5年から10年で初期開発費に匹敵します。
- 5年間のTCO:大規模システムでは初期開発費と同等以上になることも珍しくありません。
- 3億円で構築した場合:5年間で6億円以上になる可能性があります。
- ベンダーや構成の選定:初期費用が安くても、運用段階で高くつく場合があります。
- 保守しやすい構造:初期に投資すると、長期的なTCOを抑えられます。
投資判断では、この視点が欠かせません。予算を「導入から数年間の総額」で計画すると、後悔のない判断につながります。
止めないための冗長化・BCP対策のコスト
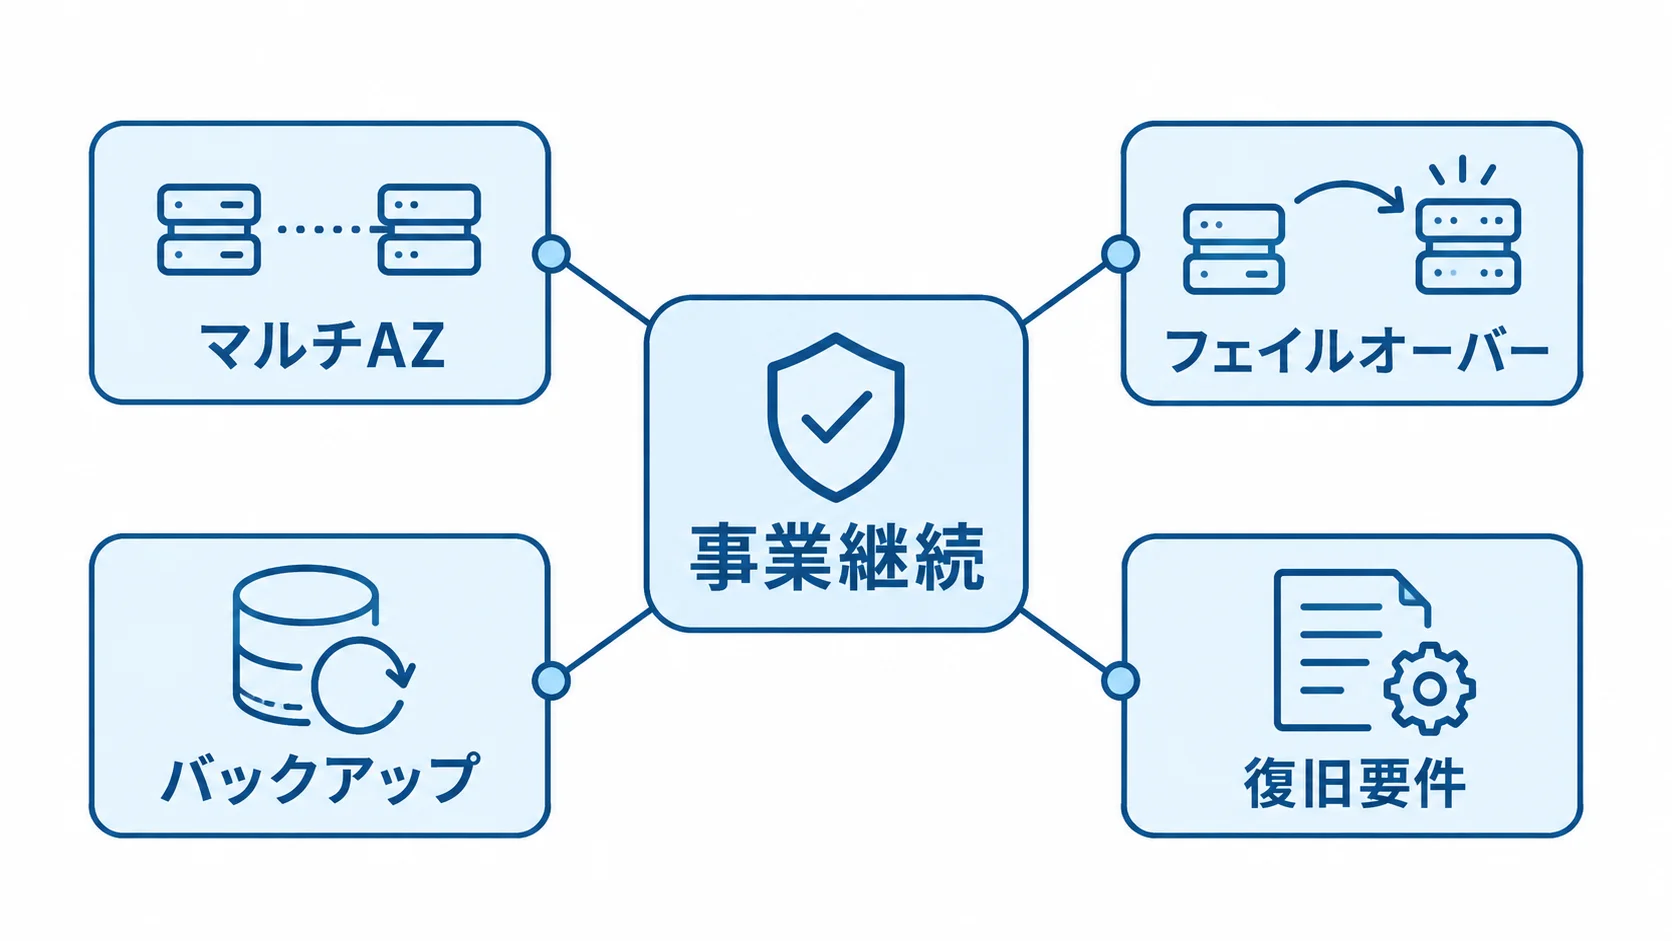
大規模システムの運用費を小規模と分けるのは、「絶対に止められない」という要求が生む冗長化と災害対策の費用です。ミッションクリティカルなシステムでは、サーバー1台の故障で事業が止まる事態を避けるため、機器を二重・三重に用意します。また、障害時に自動で切り替える仕組みも構築します。
こうした可用性を高める仕組みは、インフラコストを何倍にも押し上げます。さらに、データセンターが災害で機能しなくなる事態に備え、BCP(事業継続計画)に基づく対策も必要になります。
高可用性(マルチAZ)構成のコスト
高可用性構成の費用は、配置の方法と委託の範囲によって変わります。
- マルチAZ:大規模で一般的な構成で、複数のAZにサーバーやデータベースを分散します。
- インフラ費:中規模から大規模なら月額8万円から20万円程度が目安です。
- 環境構築:専門ベンダーへの委託は70万円からが相場です。
マルチAZでは、物理的に離れたデータセンターへ分散し、片方に障害が起きた際はもう一方へ自動でフェイルオーバーします。同じ機能の機器を二重に持つ追加費用は、可用性を確保するための備えにかかるコストです。
環境構築を委託する場合は、拡張性・高可用性・セキュリティを強化した大規模向けWebサーバー環境が対象になります。冗長化は無駄な二重投資ではなく、停止による機会損失や信用の失墜に備えた必要経費と捉えられます。そのうえで、発注側は必要な可用性の水準を、停止が事業に与える損害と照らし合わせて決めます。
BCP・災害対策(DR構成)のコスト
DR(Disaster Recovery/災害復旧)は、災害時の事業継続に備える構成です。費用は、想定する災害と復旧要件によって変わります。
- 分散先:オンプレミスとクラウド、または離れた地域の二拠点。
- バックアップ:保存方法を工夫すれば費用を抑えられます。
- ネットワーク帯域:海外拠点のBCPでは、災害時の通信集中に備えます。
- 復旧要件:目標復旧時間と目標復旧時点を定めます。
たとえば、長期保存用のS3 Glacier Deep Archiveを使えば、約0.2円/GB/月で大量のバックアップを保存できます。
特に費用が膨らみやすいのは、ネットワーク帯域です。海外拠点への展開では、ピーク時の通信集中でも遅延しない帯域幅が必要になります。
対策が過剰なら無駄な費用になり、不足すれば事業継続のリスクになります。そのため、事業への影響に応じた水準を選ぶことが大切です。
また、BCPは平時には価値が見えにくいものの、有事に事業を守るための備えです。大規模システムでは、欠かせない投資です。
大規模インフラの維持費と隠れコスト
大規模システムでは、小規模なら無視できる細かな費用も積み重なります。見積もりに含まれないコストが重なると、稼働後の請求額が見積もりの数倍になることもあります。
代表的な隠れコストのほか、大規模だからこそ得られるスケールメリットも押さえておくと、予算の見通しを立てるうえで役立ちます。
複数環境・データ転送で膨らむ従量課金
複数環境とデータ転送の費用は、利用量に応じて従量で積み上がります。
- 環境数:開発・ステージング(本番に近いテスト)・本番が一般的です。
- データ転送:クラウドのデータ転送費(アウトバウンド通信量)は送信量に応じて発生します。
- 配信量:動画や画像を大量配信すると、転送費が運用費の大きな割合を占める場合があります。
3環境なら、単純計算でインフラ費用は約3倍になります。そのため、品質を保つうえで必要な環境数を、予算に反映しておきましょう。
アクセス集中や大量データのやり取りでは、転送費が当初見積もりの数倍になる場合があります。利用量が読みにくいぶん、稼働後に表面化しやすい費用です。
したがって、変動する従量課金には一定の余裕を見込んで予算を組むことが賢明です。
ネットワーク接続費とスケールメリット
クラウドとオンプレミスをつなぐ場合は、ネットワーク接続費が継続してかかります。接続方法とデータ量を含めて、維持費を確認しておくことが大切です。
- VPN接続:インターネット経由なら月額約3,000円からです。
- 専用線接続:AWS Direct Connectなどは、より高額な維持費が発生します。
- ストレージ割引:使用量が多いほど単価が下がる場合があります。
大規模なシステム間連携では、通信費も見落とせない固定費になります。なお、安定した通信品質を求める場合は、専用線が選択肢になります。
たとえば、AWS S3は50TBまで0.023ドル/GB、500TB以上では0.021ドル/GBです。大量のデータを扱うほど、ボリュームディスカウントを受けやすくなります。
規模によって費用が膨らむ部分と割安になる部分の両方があります。そのため、割高な要素を抑えつつ割引を活用する設計が、運用費最適化の鍵になります。
大規模障害対応体制の人件費
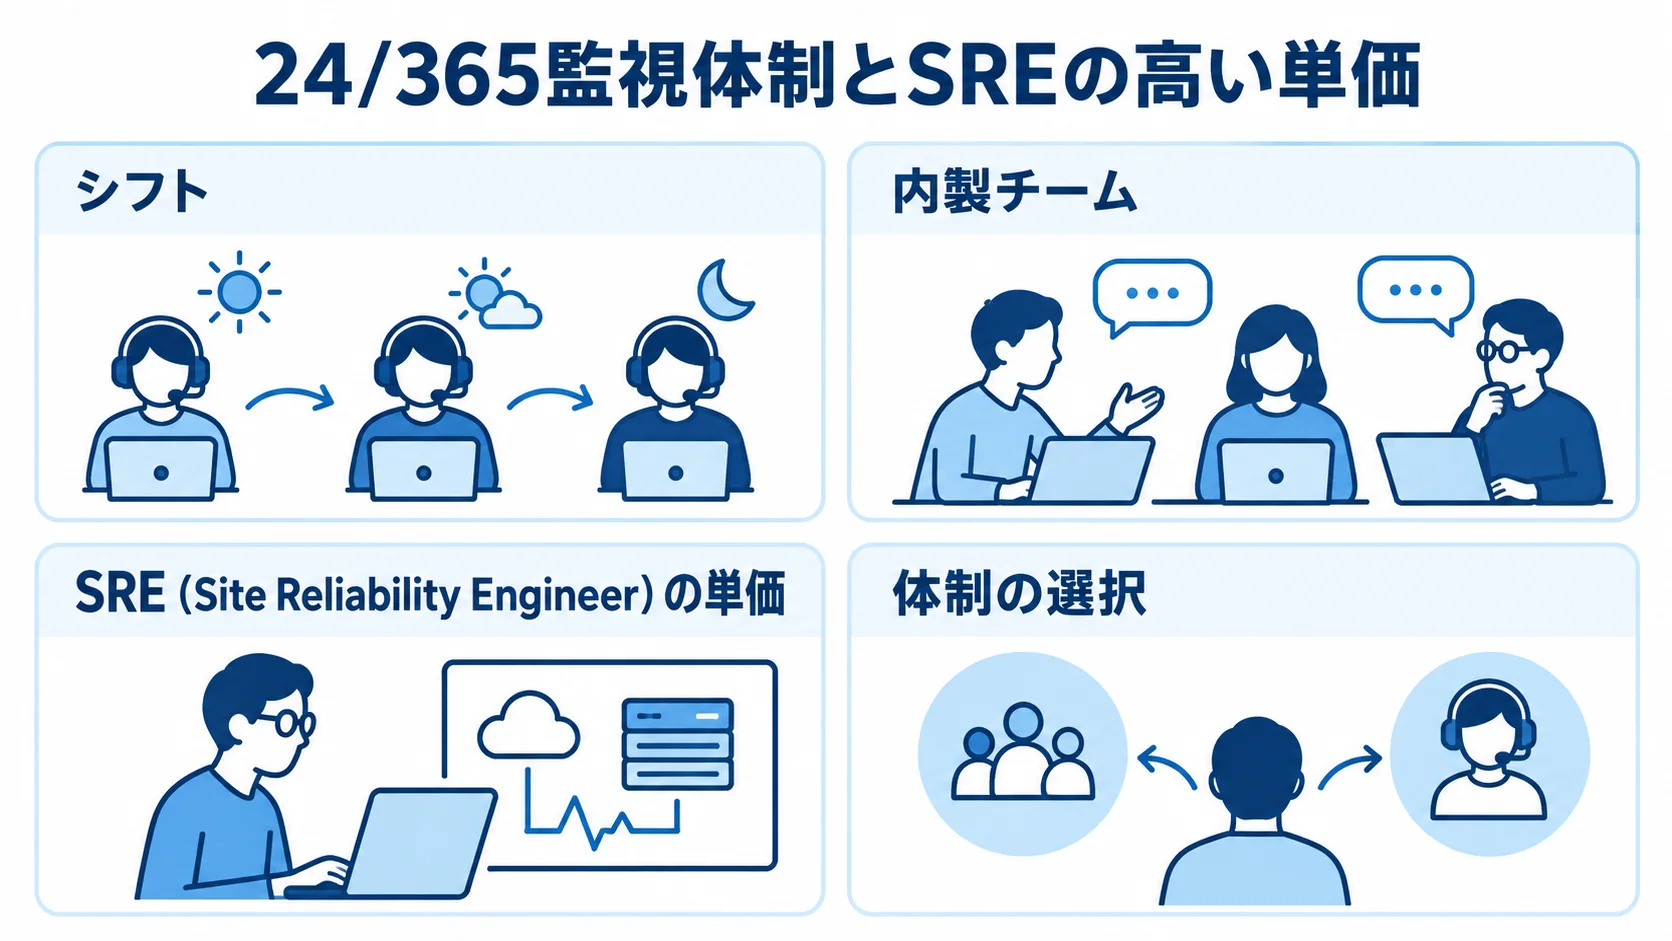
運用費では人件費が大きな割合を占めます。24時間365日の監視と復旧には高いスキルが必要で、専門人材は市場価値が高いぶん単価も高額です。
監視体制の人件費に加えて、SREなどの専門人材、監視ツール、クラウド公式サポートの費用もかかります。
24/365監視体制とSREの高い単価
監視体制の人件費は、勤務時間と必要な人材の専門性で変わります。内製と外部委託の範囲も判断材料になります。
- シフト:1日を複数のシフトで回し、休日や深夜も対応できる状態を保ちます。
- 内製チーム:少なくとも数名から十数名規模が必要です。
- SRE(Site Reliability Engineer)の単価:月額80万円から120万円以上です。
- 体制の選択:すべてを内製するか、一部を外部委託するかを検討します。
自社だけで24時間365日の監視を行うと、交代要員の人件費がかさみます。夜間や休日も誰かが必ず対応できる体制が必要になるためです。
チームには、クラウド設計や障害対応を担うアーキテクト級の人材も求められます。こうした専門人材は採用競争が激しく、確保も容易ではありません。
SREの単価は100万円を超えることも多く、この単価のエンジニアで24時間体制を組むと、月に数百万円、年に数千万円の人件費になります。高度人材の費用が運用費を押し上げる最大の理由です。そのため、体制の選択は費用と安定性の両面から判断することが重要です。
監視ツール・エンタープライズサポートの費用
監視ツールとクラウド公式サポートにも、別途費用がかかります。見積もるときは、対象ホスト数と必要なサポート水準を確認しましょう。
- 監視ツール:Datadogはホストあたり月額15ドルから23ドル程度です。
- 公式サポート:最上位プランは月額15,000ドル(約200万円以上)の場合があります。
- 合算費用:個々は見過ごしがちでも、年間では無視できない金額になります。
数百台規模のサーバーを監視すれば、ツール料金だけで毎月数十万円に達します。AWSやAzureなどのクラウド公式サポートは、重大障害時に迅速な技術支援を受けるための費用です。
事業を止められない大規模システムでは、発注側が最上位の有料サポートに加入せざるを得ない場合もあります。
運用予算を組む際は、監視ツールや公式サポートなどの周辺費用も漏れなく洗い出すことが大切です。
保守体制の最適化とコスト削減策
運用保守費は、放置すれば膨らんでいきます。体制や契約を工夫し、全内製でも全委託でもないバランス型を設計すると、費用を最適化できます。
発注側は、クラウド運用の費用削減策や、SLA・責任分界点を明確にする方法もあわせて押さえておきたいところです。
内製と外部委託のハイブリッド体制
内製と外部委託を組み合わせる体制は、費用対効果が最も高いとされます。
- 自社で担う領域:コア業務やシステムの中身を理解すべき部分。
- 外部へ委託する領域:24時間監視や専門的なインフラ設計。
- 人材の調達:高単価SREを複数の正社員で抱えるより、必要な専門性を外部からスポット調達すると総費用を抑えられる場合があります。
監視を専門ベンダーに任せれば、自社の人材は日中の運用改善やシステム企画に集中できます。
コアは自社で握り、周辺を任せるのが基本です。知識まで外部に依存すると、ベンダーロックインで費用が高止まりするおそれがあります。そのため、自社に残す領域を戦略的に決めておきましょう。
パートナー活用とSLA・責任分界点の明確化
クラウドの公式パートナー(請求代行サービス)の活用は、大規模運用で強力な削減策です。サポートや利用料を抑えられる場合がありますが、適用条件は契約で確認が必要です。
- 技術サポート:エンタープライズ相当の支援が無償になる場合があります。
- 利用料割引:クラウド利用料が常時3%から5%程度割引されます。
- 責任分界点:担当範囲と対応水準を契約で明確に定めます。
クラスメソッドやアイレット経由では、24時間365日の専任技術窓口を無料で使える場合があります。月額数百万円のクラウド費なら、割引だけで年数十万円から数百万円の削減につながります。
SLA(サービス品質保証)と責任分界点が曖昧だと、障害時に担当の押し付け合いが起き、復旧が遅れるおそれがあります。特に複数ベンダー体制では、システム連携部分の担当が決まりにくくなります。
発注側と各ベンダーは、責任分界点を図にして合意し、SLAで対応レベルを数値で定めておきましょう。そのうえで、契約で役割を決めておけば、迅速な復旧と不要な費用負担の回避につながります。
まとめ
大規模システムの保守・運用費は、規模と高可用性の要求に応じて大きく増えていきます。数億円規模のシステムでは年間数千万円に及ぶこともあり、5年間のTCOが初期開発費と同等以上になることもあります。
高可用性構成は月額8万円から20万円が目安で、BCP・DR対策ではネットワーク帯域が費用を押し上げる場合があります。さらに、複数環境やデータ転送の従量課金も、稼働後に表面化する隠れコストです。
運用費では、SREなどの人件費が大きな割合を占めます。監視ツールやエンタープライズサポートも合算すると、無視できない金額になります。
費用を抑えるには、コア業務を内製し、周辺業務を外部へ委託する方法があります。パートナーの割引やサポートも活用できます。
複数ベンダーで運用する場合は、SLAと責任分界点を明確にしましょう。予算は初期費用だけでなく、稼働後の費用とTCOで計画することが大切です。
運用フェーズを見据えた保守体制は、実績のあるパートナーへ早い段階で相談するとよいでしょう。
▼全体ガイドの記事
・大規模システム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。