
マルコフ決定過程(Markov Decision Process:MDP)は、結果が不確実な逐次意思決定を、5つの要素で表す数学モデルです。この枠組みは、ロボット、ゲーム、推薦、在庫、設備制御などで、長期的な報酬を最大化する方策を設計する基礎になります。
現在の状態だけで次の状態と報酬が決まるというマルコフ性を仮定し、強化学習では、環境を観測して行動し報酬を受け取る問題をMDPとして整理します。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」をダウンロードできます。で詳しく解説しています。
MDPの5つの構成要素
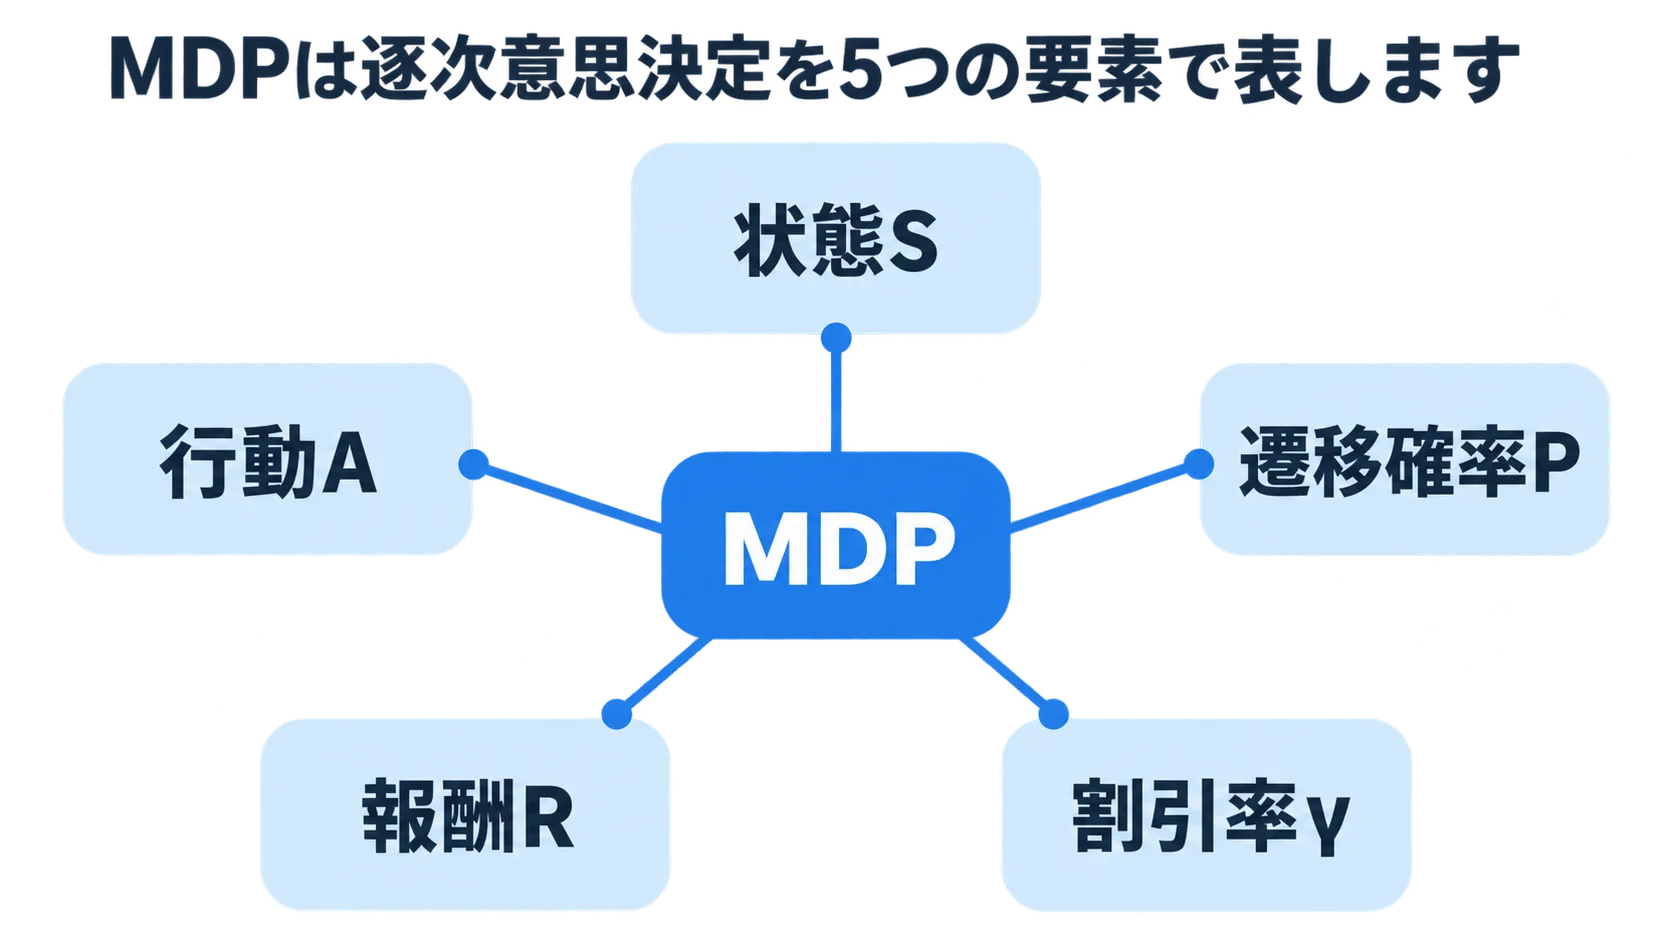
MDPを仕様として扱うには、各要素が何を指すかを揃えておく必要があります。基本要素は次の5つです。
- 状態S:意思決定に必要な環境の状況を表す集合。
- 行動A:エージェントが状態で選べる操作の集合。
- 遷移確率P:行動後に次の状態へ移る確率。
- 報酬R:状態と行動、または遷移に対して得る評価。
- 割引率γ:将来報酬を現在の価値に反映する重み。
業務に当てはめるときは、状態S、行動A、遷移確率Pが現場の何を指すのかを、発注側と開発会社で一つずつ確かめます。状態Sには業務のどの情報を含めるか、行動Aには現場がどの操作を選べるか、遷移確率Pには行動の後に状態がどう移るかを書き出します。
状態・行動・遷移・報酬の定義が曖昧なままだと、アルゴリズムを変えたときに結果を比べられなくなります。そこで、観測できる情報と行動の制約を仕様書に書きます。あわせて、報酬がいつ与えられるか、エピソードがどこで終わるかも記録しておきます。
マルコフ性と現在の状態による履歴の要約
マルコフ性が成り立てば、過去の状態列をすべて追わなくても、現在の状態から次の状態の分布を計算できます。逆に、状態に必要な履歴が欠けていると、同じ状態に見えても遷移や報酬が変わってしまい、MDPの仮定が崩れます。
開発会社は、履歴の特徴を加えるなどして状態を拡張し、情報を補うことを検討します。
方策と価値関数による長期的な良さの表し方
方策πは、各状態で選ぶ行動を定める規則です。一つの行動を選ぶ決定的方策と、行動の分布を返す確率的方策があります。
方策の良さは、価値関数で測ります。状態価値Vπ(s)は、方策πで状態sから得られる期待累積報酬です。行動価値Qπ(s,a)は、状態sで行動aを選んだ後の価値です。
リターンと割引累積報酬
時刻tのリターンは、Rt = rt + γrt+1 + γ2rt+2 … のように、将来の報酬を割り引いて足し合わせたものです。
γが0に近いと短期の報酬を重視し、1に近づくほど遠い将来の報酬を重視します。特に長いエピソードでは、報酬の規模と数値の安定性も確認します。
ベルマン方程式による価値の一段先への分解
状態価値は、現在の報酬と次の状態の価値の期待値として書けます。最適価値では、各行動のうち価値が最も高いものを選びます。この再帰的な関係を使うと、価値反復、方策反復、Q学習などの解法を組み立てられます。
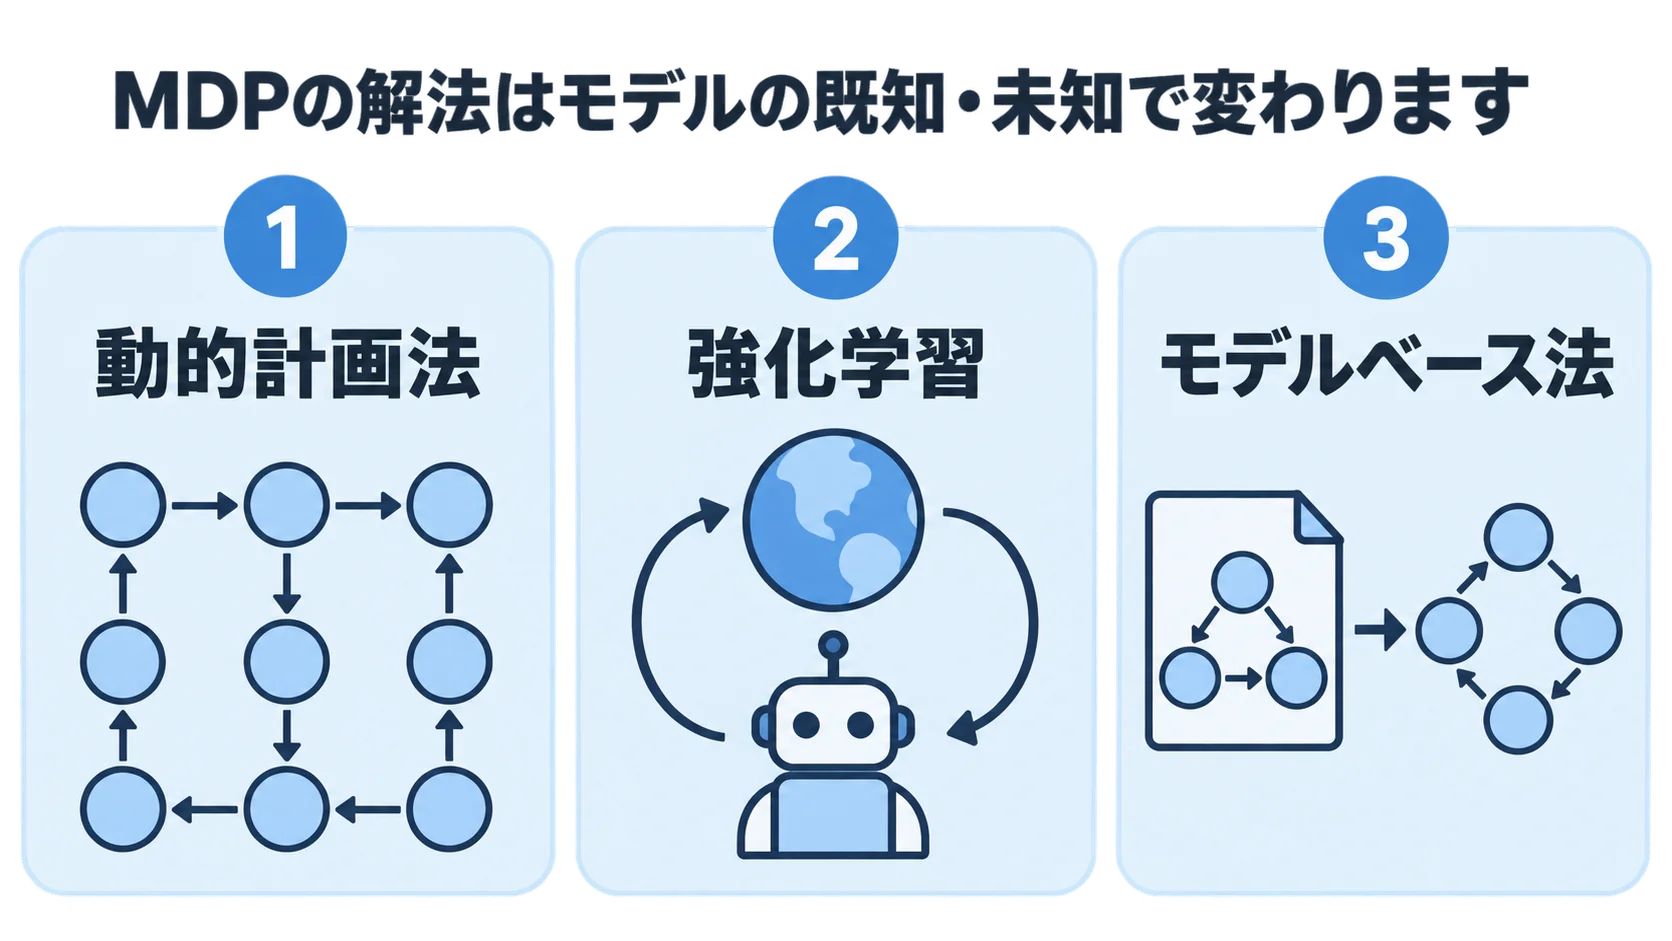
モデルの既知・未知で変わるMDPの解法
遷移と報酬が既知の場合の動的計画法
遷移確率と報酬が既知の場合、価値反復はベルマン最適方程式を繰り返し適用し、方策反復は方策評価と方策改善を交互に行います。どちらも、状態と行動の数が有限で、モデルをメモリに保持できる問題に適しています。また、収束条件と計算量は事前に見積もっておきます。
モデルが未知の場合の強化学習
現実の環境では、遷移確率を正確に書き下せないことがあります。そうした場合は、Q学習や方策勾配法を使い、行動して得た状態遷移と報酬から価値または方策を学びます。
この方法では探索が必要になるため、未知の行動を試すコストや安全性を設計し、シミュレーターやオフラインログを組み合わせます。
遷移モデルを学習して計画するモデルベース法
観測データから遷移モデルを推定し、そのモデル上で将来を予測して行動を選ぶ方法もあります。実環境での試行回数を減らせる可能性がある一方で、モデルの誤差は長期の予測で積み重なります。
発注側と開発会社は、予測の不確実性を管理しつつ、実環境での検証を行います。
見えない情報がある問題の部分観測としての扱い
MDPでは状態を完全に知ると仮定しますが、現実にはセンサーのノイズや遅延、隠れた相手の意図などがあり、全状態を観測できない場合があります。このときは、部分観測マルコフ決定過程(POMDP)として扱い、観測から状態の信念分布を更新するか、履歴を使うモデルを検討します。
実務では、最初からPOMDPの厳密解を求めず、状態に直近の履歴や移動平均を加えたうえで、評価でマルコフ性の妥当性を確かめる進め方もあります。あわせて、履歴の長さを変えた比較、欠損時の挙動、遅延を含むテストを行います。
業務へ適用する際の状態・報酬・制約の設計
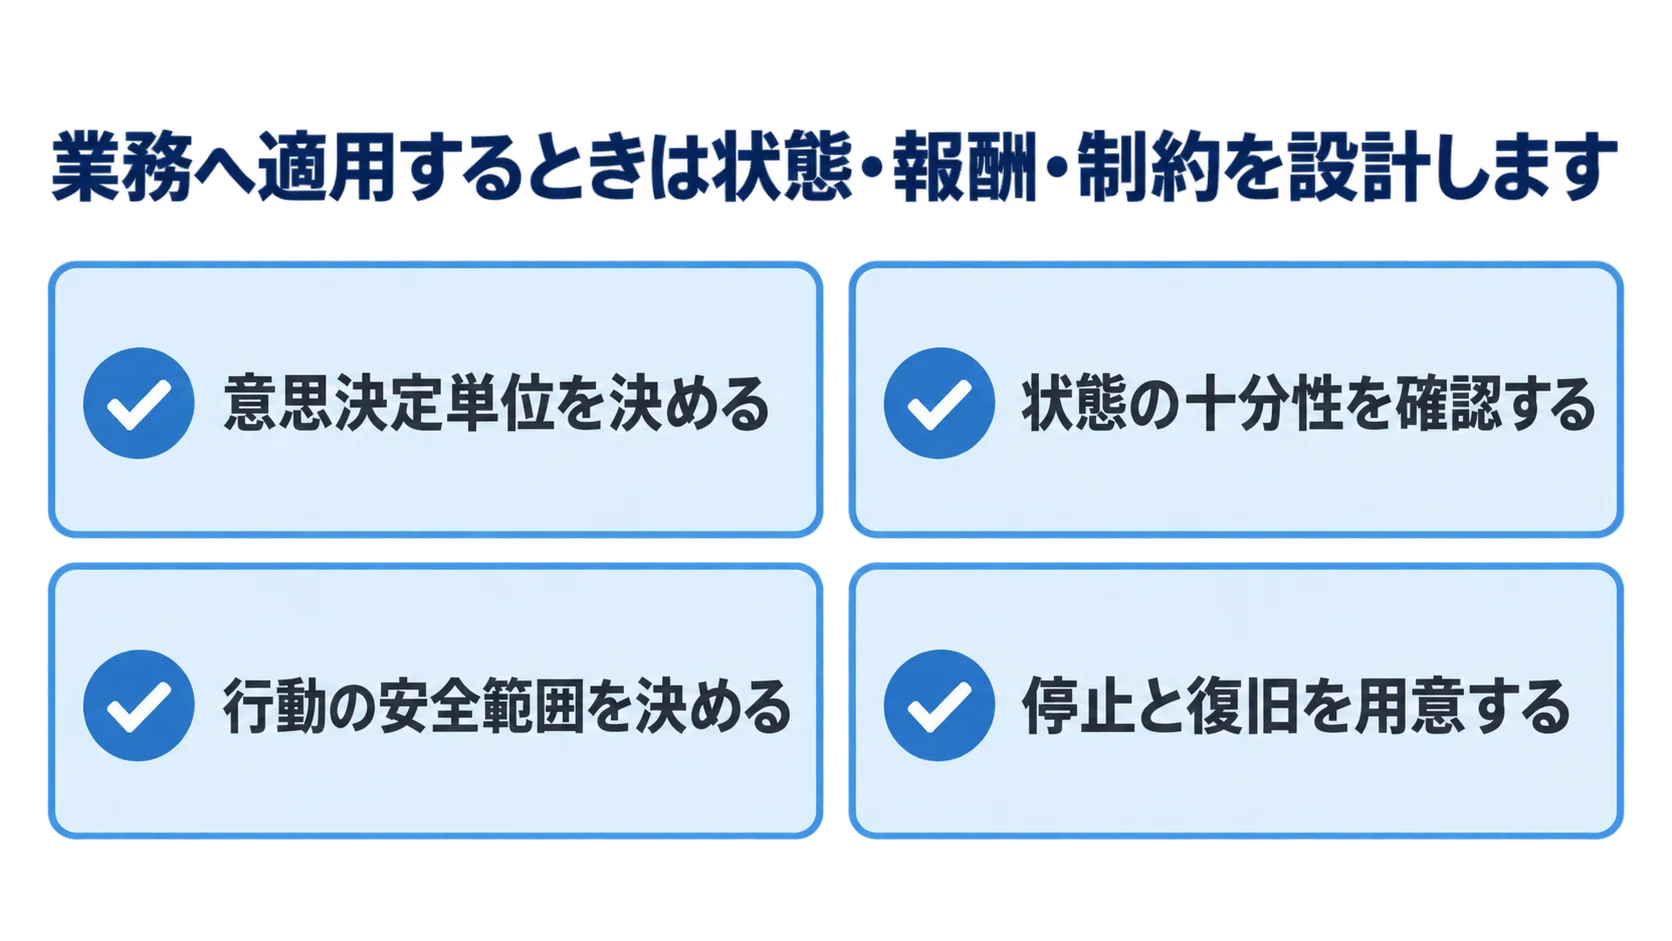
業務に載せる前に、MDPの前提が現場に合っているかを一つずつ確かめておきます。
- 意思決定単位を決める:一回の行動、時間間隔、エピソードの開始と終了を定義する。
- 状態の十分性を確認する:推論時に使える情報だけで将来を予測できるかを調べる。
- 行動の安全範囲を決める:実行不可の操作、承認が必要な操作、コスト上限などを明示する。
続いて、報酬と副作用の扱い、評価環境の分け方、停止と復旧の条件を見ていきます。
- 報酬と副作用を並べる:短期の成果に加えて、品質、安全、顧客への影響も指標にする。
- 評価環境を分離する:学習、検証、テスト、本番監視のデータを分ける。
- 停止と復旧を用意する:異常時に旧方策へ戻せる手順を作る。
報酬にすべての業務目的を詰め込むと、予想しない抜け道まで最適化されることがあります。そのため、禁止事項は報酬の罰則だけに頼らず、行動マスク、ルール、承認フローなどの制約として別に実装します。
開発会社は、代表的な軌跡を人が読んで、なぜその行動を選んだかを説明できるログを残しておきます。
予測・方策・業務指標によるMDPの妥当性の評価
遷移モデルを使う場合は、次の状態と報酬の予測誤差を、期間・状態・顧客ごとに測ります。強化学習の場合は、累積報酬と成功率を中心に確認し、制約違反や探索量、シード間のばらつきも見ておきます。
モデル上で良い方策が実環境でも良いとは限りません。そのため、段階的なオンライン検証を行います。
状態に未来の情報が混ざると、テストでは高い性能が出ても、本番では再現しません。そのため、特徴量の生成時刻とデータ遅延を確かめ、欠損処理や更新頻度も監査します。
また、環境や顧客構成が変わった場合は、同じMDPとして扱えるかを再評価します。
マルコフ決定過程で起きやすい失敗と対策
状態の小ささによる履歴の欠落
現在値だけでは、季節性、直前の行動、滞留時間を区別できないことがあります。履歴特徴やカウンタを候補に挙げ、状態を増やした場合の計算量とのトレードオフを比べます。再帰モデルやPOMDPの信念状態も候補になります。
報酬の抜け道の発生
報酬を最大化しても、品質や安全が悪化することがあります。そこで、報酬の外にある業務指標や制約違反、代表的な軌跡を監視し、禁止行動は別の制約として扱います。
シミュレーターと現実の差の見落とし
遷移や遅延、ノイズが現実と異なると、最適な方策も本番で機能しません。利用者の反応が現実と違う場合も、本番で機能しなくなることがあります。そのため、現実のログで検証し、段階的な試験や上限、旧方式への切り戻しを用意します。
強化学習の意思決定問題を形式化するMDP
マルコフ決定過程は、5つの要素で逐次意思決定を表し、方策と価値関数を通じて長期的な良さを定義します。モデルが既知なら動的計画法を、未知なら強化学習を選びます。部分観測の問題であれば、POMDPを検討します。
実務では、状態が十分かどうか、報酬に抜け道がないかを確かめ、行動制約や評価環境と本番の差も見ておきます。平均報酬だけで導入を判断せず、業務指標や安全性を含めてMDPの設計を見直します。あわせて、再現性と停止・復旧の手順も押さえます。
よくある質問(FAQ)
検討の初めによく出る疑問に、順に答えます。
Q. マルコフ決定過程とは何ですか?
結果が不確実な逐次意思決定を表す数学モデルです。状態や行動、報酬などの5つの要素で組み立てます。
Q. MDPの構成要素は何ですか?
基本要素は5つで、状態と行動、遷移確率に、報酬と割引率を加えたものです。観測できる情報と終了条件も合わせて定義します。
Q. マルコフ性が崩れるとどうなりますか?
現在の状態だけでは次の遷移や報酬を説明できなくなります。そのため、履歴の特徴を加えるか、部分観測問題として扱います。
Q. MDPと強化学習は同じものですか?
MDPは意思決定問題のモデルで、強化学習は遷移や報酬が未知でも経験から方策を学ぶ方法です。このように、両者は役割が異なります。
Q. 状態をすべて観測できない場合はどうしますか?
部分観測マルコフ決定過程(POMDP)として信念状態や履歴を使って扱うか、観測から必要な履歴特徴を作って状態を拡張します。
参考資料
本文の内容は、次の資料を参照して確認しました。
- OpenAI Spinning Up「Key Concepts in RL」
- OpenAI Spinning Up「Kinds of RL Algorithms」
- MathWorks「Create Markov decision process object」
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブックをダウンロードできます。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。