
議事録作成システムの開発は、5つのフェーズで進みます。要件定義から始まり、リリース・運用へと続きます。会議記録の正確性・検索性・セキュリティを要件として最初に整理し、音声認識の検証を含めて段階的に進めるのが基本です。
- 利用する会議と利用者を整理し、記録項目、権限、精度を決める
- 録音から共有までの流れを設計する
- テストから移行、教育、保守、改善までを計画する
▼全体ガイドの記事
・議事録作成システム開発の完全ガイドをご覧ください。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
議事録作成システム開発の全体像
議事録作成システムは、会議の音声をリアルタイムで、または録音後に自動でテキスト化し、要点を整理して議事録として出力するシステムです。近年はAI技術の進化により、精度90%以上の音声認識が実現しており、話者識別や要約、アクションアイテム抽出といった高度な機能も実装できます。
開発形態は大きく3種類に分かれ、「スクラッチ開発」「パッケージカスタマイズ」「SaaS連携型開発」があります。
開発形態の種類と特徴
スクラッチ開発は、自社の業務フローや既存システムとの連携要件を完全に満たすシステムを、ゼロから構築する方法です。初期投資は大きくなりますが、独自の機能追加や社内の情報セキュリティポリシーへの対応、データの完全内製化が可能になります。
100名以上の企業で月間の会議数が多く、専用の管理機能やセキュリティ要件が厳しい場合に、スクラッチ開発が選ばれます。
一方、パッケージカスタマイズは、既存の議事録ツール(Notta・スマート書記・Otter.aiなど)のAPIを活用しながら独自の機能を追加する手法で、開発期間を短縮できるメリットがあります。また、SaaS連携型は、既存のWeb会議ツール(Zoom・Microsoft Teams・Google Meet)と音声認識APIを組み合わせる形が一般的です。
議事録作成システムの主要機能と技術スタック
中核となる機能は、音声の録音・収録、音声認識・文字起こし、話者識別(スピーカーダイアライゼーション)です。加えて、自動要約・アクションアイテム抽出、議事録テンプレート適用、承認ワークフローがあります。そのほか、検索・管理機能も備えます。
音声認識エンジンには、OpenAI Whisper API・Azure Cognitive Services Speech to Text・Amazon Transcribeのいずれかを活用するケースが多くなっています。要約・抽出処理には、GPT-4o・Claude 3.5などのLLMを組み合わせます。
フロントエンドはReact・Vue.jsが主流で、バックエンドはPython(FastAPI/Django)またはNode.js(Express)が選ばれることが多い傾向です。データストアは、PostgreSQL・MySQLなどのRDBMSに加えて、音声ファイルの保管にAWSのS3やAzure Blob Storageが活用されます。
フェーズ1:要件定義・企画フェーズ
要件定義フェーズは、開発プロジェクト全体の方向性と品質を決める、最も重要な工程です。このフェーズで目的とユーザーを明確にし、機能要件と非機能要件を定めておかないと、設計や開発の段階で手戻りが多発し、コストと工期が大きく膨らむおそれがあります。
業務ヒアリングから要件定義書の完成まで、一般的に2〜4週間を見込む必要があります。
業務ヒアリングと課題整理
要件定義の出発点は、現状の業務フローと課題を徹底的にヒアリングすることです。会議の件数と平均時間、議事録作成の工数、現在の配布方法と承認フローを聞き取ります。
例えば、月50件の会議があり1件あたり60分の議事録作成時間がかかっているとすれば、年間600時間(1名以上の人件費相当)が削減対象となります。この数字を根拠に開発投資対効果(ROI)を計算すると、経営層への承認を得やすくなります。
ヒアリングでは、総務・法務・IT部門など複数の利害関係者を集めることが望ましいです。そのうえで、既存システム(グループウェア・CRM・プロジェクト管理ツール)との連携要件、セキュリティ・コンプライアンス要件(社外持ち出し禁止・暗号化要件)、保管ポリシー(何年間保存するか)を確認します。
機能要件・非機能要件の定義
機能要件は「システムが何をするか」を、非機能要件は「どの程度の品質で動くか」を定めるものです。機能要件の代表例は、音声の録音・アップロードとリアルタイムの文字起こし、話者識別(複数話者の発言を自動識別)です。
そのほかに、AI要約・アクションアイテム抽出、テンプレートによる議事録の自動生成、承認ワークフローがあります。PC・スマートフォン・タブレットに対応するマルチデバイス対応や、全文検索・タグ管理も含まれます。
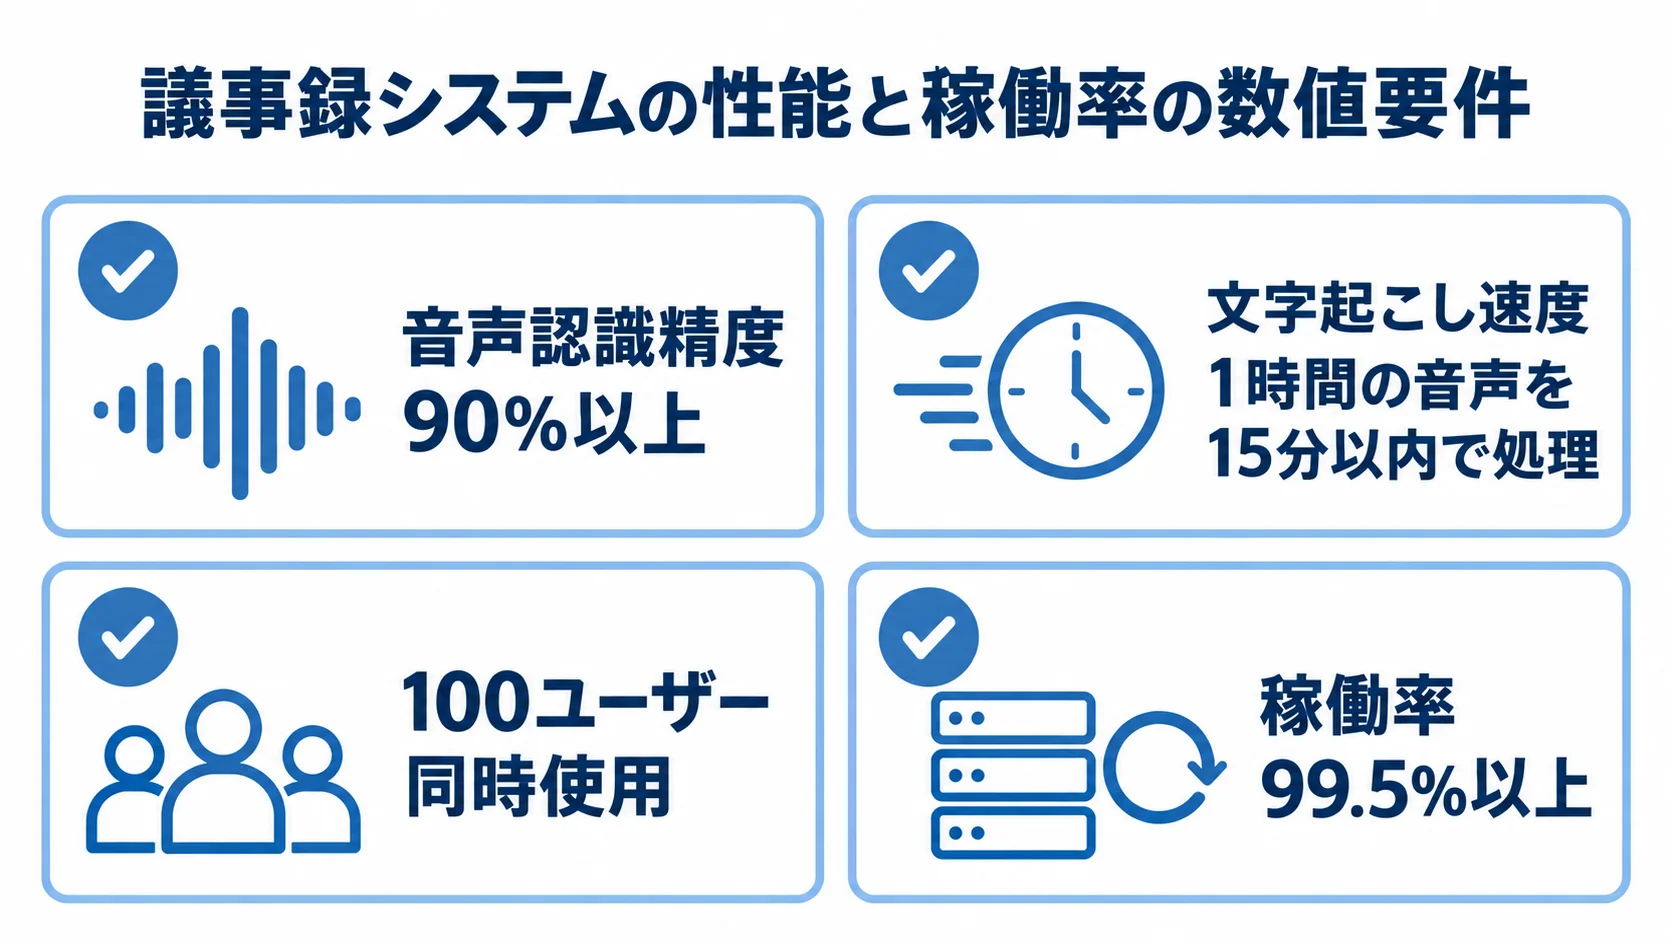
非機能要件では、音声認識精度90%以上、文字起こし速度(1時間の音声を15分以内で処理)、同時接続数(例:100ユーザー同時使用に対応)を数値で明記します。稼働率99.5%以上やデータ暗号化(AES-256)も、具体的な値で書いておきます。曖昧な表現(「高速に処理する」「十分なセキュリティ」)は後の品質トラブルの原因になるため、必ず定量的な指標に変換してください。
開発方針とスコープの決定
要件の整理が終わったら、開発方針(スクラッチ・カスタマイズ・SaaS連携)と、フェーズ分けを決めます。すべての機能を一度に作ろうとすると、期間とコストが膨らみやすくなります。そこで、MVP(Minimum Viable Product:実用最小限のプロダクト)の考え方でフェーズを分けることをおすすめします。
たとえば、フェーズ1では音声録音・文字起こし・基本的な議事録出力の核心機能に絞ります。フェーズ2では話者識別・承認ワークフロー・他システム連携を加えます。フェーズ3でAI要約・高度な検索・分析機能を実装する、段階的なロードマップが現実的です。
フェーズ分割により、早期に実際のユーザーのフィードバックを得て開発方針を調整でき、最終的な品質と費用対効果が高まります。
フェーズ2:設計フェーズ
設計フェーズでは、承認を得た要件定義書をもとに、システムの全体構造を決めたうえで、画面やデータ、連携仕様を詳しく設計します。設計の品質は開発の速さと最終的なシステムの品質に直結するため、妥協できない工程です。
基本設計と詳細設計の2段階に分けて進めることが一般的で、全体では3〜6週間を要します。
基本設計(外部設計)
基本設計では、システム全体のアーキテクチャを描き、画面設計(ワイヤーフレーム・UIモックアップ)やデータベース設計(ER図・テーブル定義)を作成します。外部システムとの連携仕様(API仕様書)も、この段階で作ります。
議事録作成システム特有のアーキテクチャ設計として特に重要なのは、音声処理パイプラインの設計です。その流れは、録音・アップロード → 音声前処理(ノイズ除去・正規化) → 音声認識API呼び出し → 話者識別処理 → LLMによる要約・構造化 → 議事録テンプレート適用 → 保存・配信の順です。
長時間の音声ファイルは処理に時間がかかるため、キューイングシステム(Amazon SQSやRabbitMQ)を活用した非同期アーキテクチャが標準的なアプローチです。また、1時間の会議で音声ファイルが100MB〜300MBになることがあるため、ストレージ設計とコスト試算も重要な設計項目です。
データベース設計とセキュリティ設計
議事録作成システムのデータベース設計では、会議情報、音声ファイル管理、文字起こしテキストのテーブルが中心的なエンティティとなります。また、議事録、参加者、承認履歴のテーブルも、主要な構成要素になります。
特に注意が必要なのがセキュリティ設計です。議事録には経営の機密情報、個人情報、顧客情報が含まれることが多く、アクセス制御(ロールベースアクセス制御:RBAC)の設計が必須です。具体的には、管理者、議事録作成者、閲覧者、承認者の役割を定義し、役割ごとに参照・編集・削除・承認できる範囲を設計します。
通信の暗号化(TLS 1.3)、保存データの暗号化(AES-256)、ログ管理(操作ログの6ヶ月以上保存)も、設計段階で仕様にします。金融・医療・公共機関など機密性の高い業界では、クラウドへのデータ送信そのものを禁止し、完全オンプレミスでの構築を検討する必要があります。
詳細設計(内部設計)
詳細設計では、基本設計で決めたアーキテクチャをもとに、各モジュールやクラス、関数ごとの処理フローを定めます。あわせて、入出力の詳細仕様とエラーハンドリングの方針も決めます。
音声認識APIとの連携では、APIのタイムアウト処理、リトライロジック、エラー時のフォールバック処理を詳しく設計します。たとえば、Whisper APIが応答しない場合にAzure Speech to Textへ自動で切り替える冗長構成や、処理失敗時にユーザーへ通知してリトライを促すフローなどがあります。
詳細設計書は、開発者がそのまま実装に取りかかれる詳しさが求められ、後のテスト仕様書の元にもなります。この工程を丁寧に進めると、開発中の仕様の解釈のズレを防ぎ、手戻りの工数を大きく減らせます。
フェーズ3:実装・開発フェーズ
設計書が承認されたら、いよいよ実装フェーズに入ります。開発は5つの領域に分かれ、環境構築とインフラ整備、バックエンド開発(API・音声処理パイプライン)が含まれます。
残りは、フロントエンド開発(管理画面・議事録編集UI)、AI/ML連携実装、外部システム連携です。
スクラッチ開発の場合、経験豊富なエンジニア3〜5名で2〜4ヶ月かかることが多く、フェーズ分割開発であれば最初のMVPを2ヶ月で完成させるケースもあります。
環境構築とバックエンド開発
開発環境の構築では、Dockerによるコンテナ化を採用するのが現在の標準です。開発・ステージング・本番の各環境を揃えることで、「開発環境では動いたのに本番で動かない」というトラブルを防げます。
中核となる音声処理パイプラインは、まず音声ファイルの受信・保存APIを作り、次にWhisper APIまたはAzure Speech to Textとの連携処理を組みます。続いて話者識別モジュール(pyannote.audioやAzureの話者認識機能を活用)を加え、そのうえでGPT-4oやClaude APIを用いた要約・アクションアイテム抽出処理を実装します。
非同期処理のキューシステムを適切に設計することは、スケーラビリティと安定性の確保に直結します。また、外部APIの利用コストを監視する仕組みを早期に作っておくと、コスト超過のリスクを管理できます。
フロントエンド開発とUI/UX設計
利用頻度が最も高いのは、「会議一覧画面」「議事録閲覧・編集画面」「音声アップロード画面」「承認ワークフロー画面」で、これらの使いやすさが定着率を左右します。さらに、スマートフォンからの利用を考えると、レスポンシブデザインも欠かせません。会議室でのスマートフォン録音や移動中の確認・承認を想定した、モバイルファーストのUI設計が、現場で使われ続けるための鍵になります。
フロントエンドは、React・Vue.jsを用いたSPA(Single Page Application)で構築するのが主流です。リアルタイム文字起こしを実現する場合は、WebSocket接続によるライブ更新機能が必要になります。テキストエディタには、文字起こし結果を人が自然に編集できるリッチテキスト形式が望ましく、TiptapやQuillなどのオープンソースエディタライブラリが活用されます。
AI・音声認識エンジンの選定と実装
音声認識エンジンは、コスト・精度・日本語対応・リアルタイム処理の可否の4つの観点から比較検討します。録音後にまとめて文字にするか、会議中にリアルタイムで出すかによって、向くエンジンが変わります。代表的な3つのエンジンは、それぞれ得意な場面が異なります。
- OpenAI Whisper API:日本語の認識精度が高く、バッチ処理(録音後の文字起こし)の場面で活用しやすいです。
- Azure Cognitive Services Speech to Text:リアルタイム文字起こしに対応し、話者識別機能も統合されて、ライブ会議に向きます。
- Amazon Transcribe:アマゾンのエコシステムを活用している企業との相性がよく、カスタム語彙(社内用語・製品名)の登録機能が充実しています。
Whisper APIの費用は1分あたり約0.006ドル(2026年時点)で、月100時間の会議を処理しても3,600円程度と低コストです。
要約・構造化処理では、指示(プロンプト)を工夫して、アクションアイテム・決定事項・懸案事項を自動で抽出・分類する仕組みを作ります。議事録の完成度は、プロンプトエンジニアリングの品質で大きく変わるため、実際の会議録を使った反復検証が欠かせません。
フェーズ4:テスト・品質検証フェーズ
テストフェーズは、開発したシステムが要件定義書と設計書どおりに動くかを検証する工程です。議事録作成システムでは、音声認識精度とAI処理の品質を確かめる必要があります。
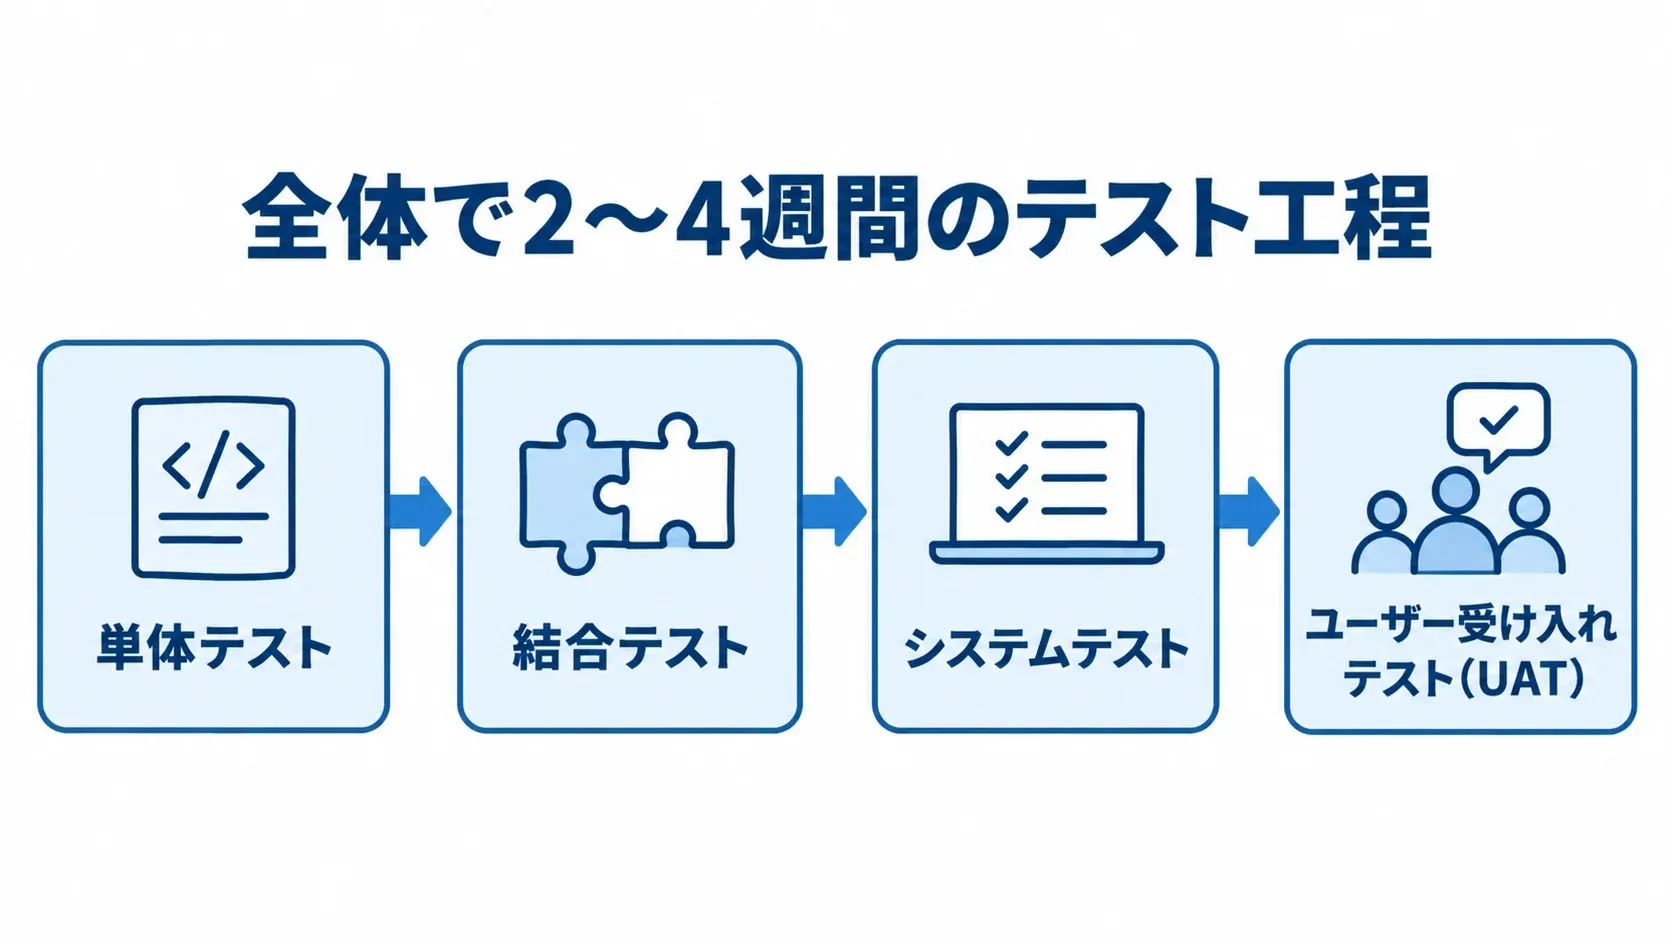
加えて、セキュリティやパフォーマンスも検証するため、通常のビジネスシステムよりもテスト設計が複雑になります。単体テスト → 結合テスト → システムテスト → ユーザー受け入れテスト(UAT)の順番で実施し、全体で2〜4週間かけるのが一般的です。
テストの種類と実施方針
単体テストでは、各APIエンドポイント、音声処理モジュール、データベース操作の動作を個別に検証します。自動テストフレームワーク(Pythonの場合はpytest・JavaScriptの場合はJest)を活用し、コードカバレッジ80%以上を目標にします。結合テストでは、音声ファイルのアップロードから議事録の完成・配信までの一連のフローが正常に動くかを検証します。
実際の会議音声サンプルを用意して、精度を測定することが大切です。サンプルには、様々な話者数や音質、会議室の環境音を含めます。さらに、方言や専門用語も入れます。
システムテストでは、負荷テスト、セキュリティテスト、障害テストを実施します。負荷テストでは100ユーザーが同時にアップロードした場合のシステム応答性を、セキュリティテストではSQLインジェクション・XSS・不正アクセスへの耐性を確かめ、障害テストでは外部API障害時の動作を見ます。最後のUATでは、実際のエンドユーザーに操作してもらい、使い勝手・操作ミス・要件との乖離がないかを確認します。
音声認識精度の検証と改善
議事録作成システム特有のテスト項目として、音声認識精度の系統的な検証があります。Word Error Rate(WER:誤り語率)を指標に、様々な条件下での精度を測定します。
具体的には、対面会議とWeb会議の音質の違い、複数話者が同時に発言する場面を検証対象にします。さらに、業界専門用語・製品名・人名の認識精度や、方言・外国語アクセントへの対応も含めます。
WERが目標値(例:10%以下)を達成できない場合は、カスタム語彙辞書の拡充、音声前処理(ノイズ除去・音量正規化)の改善、別のAPIへの切り替えなどの対策を施します。テスト用音声サンプルは20件以上、総時間10時間以上を用意することで、精度の統計的な信頼性を確保できます。
フェーズ5:リリース・運用フェーズ
テストが完了し品質を確かめられたら、本番環境へのリリースに進みます。リリース直後は想定外の問題が起きることがあるため、パイロット部門から始めて全社展開へ広げる段階的リリースと、監視の強化が大切です。
リリース後は運用・保守フェーズに移り、継続的な改善を続けます。
リリース計画と移行手順
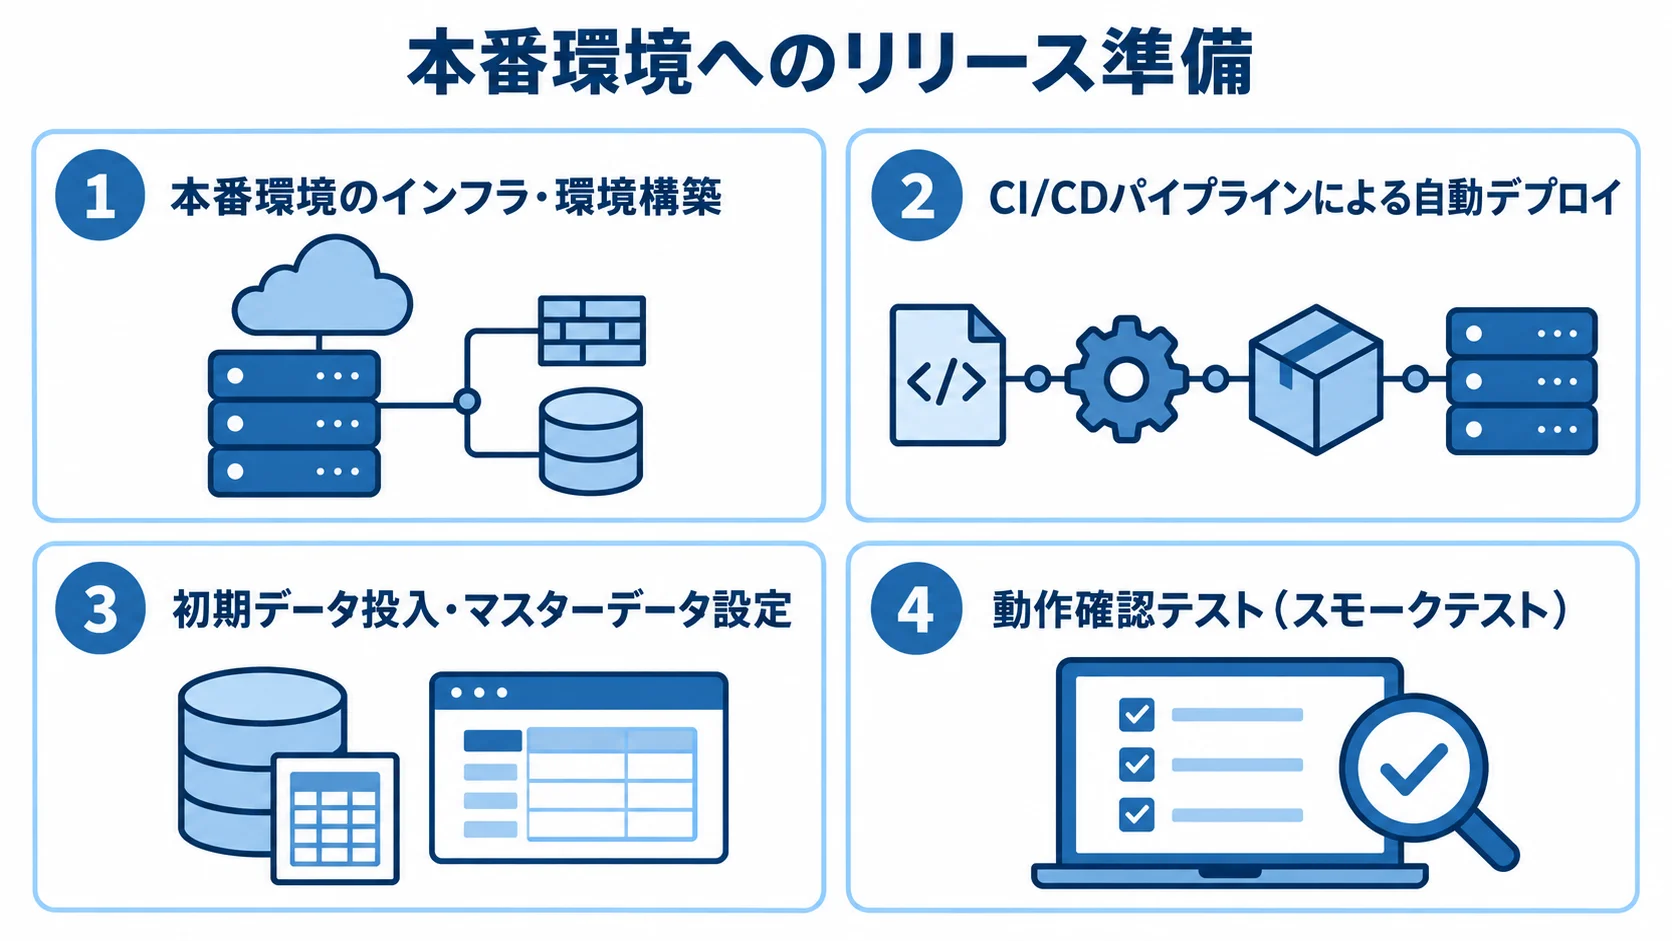
本番リリースは、サーバー・データベース・ストレージの本番設定を含むインフラ・環境構築から始めます。続いて、CI/CDパイプラインによる自動デプロイと、初期データ投入・マスターデータ設定を行います。最後に、動作確認テスト(スモークテスト)で全体の動作を確かめます。
段階的リリースを採用する場合、最初の1〜2週間は特定の部門・チームのみに開放し、問題がなければ全社展開に移行します。この方法は、リスクを最小化しながら実際の利用フィードバックを早期に得られる利点があります。
リリース当日は開発チームと運用チームが監視を強化し、エラーログ・パフォーマンスメトリクス・ユーザーからの問い合わせに即時対応できる体制を整えてください。また、ユーザー向けの操作マニュアル・FAQ・サポート窓口の準備も、リリース前に完了させておくことが定着率向上の鍵です。
運用・保守と継続的改善
リリース後の運用では、システムの稼働率を監視します(CloudWatch・Datadogなどの監視ツールを活用)。外部APIの利用コスト管理と定期的なセキュリティパッチ適用も含め、これらが基本的な保守業務となります。
議事録作成システムは外部AI APIの進化が速い分野であるため、新しいモデルへの切り替えによる精度向上も継続的に検討が必要です。例えば、2025年時点ではGPT-4oを使用していたとしても、2026年以降により精度・コスト効率に優れたモデルが登場した場合に切り替えられる設計にしておくことが重要です。
運用フェーズでは、月次や四半期ごとにユーザーからのフィードバックを収集し、機能改善と精度向上のロードマップを更新し続けます。この継続が、長期的なシステム価値の維持に直結します。
開発費用の相場とコスト管理
議事録作成システムの開発費用は、機能の範囲、開発形態、委託先によって大きく変わります。そのため、概算の相場を把握したうえで、自社に必要な機能と予算のバランスを検討することが大切です。
開発費用の内訳と規模別相場
スクラッチ開発の場合、小規模(音声文字起こしと基本的な議事録出力のみ)は300万〜500万円が目安です。中規模(話者識別・承認ワークフロー・外部システム連携を含む)は500万〜1,200万円、大規模(AI要約・分析機能・高度なセキュリティ・複数拠点対応)は1,500万〜3,000万円が目安です。
費用の大部分はエンジニアの人件費で、人月単価80万〜120万円のエンジニアが3〜5名で3〜6ヶ月稼働する計算です。外注費のほかに、インフラコスト(AWS・Azureの月額費用:月5万〜20万円程度)と、外部API利用コスト(音声認識API・LLM API:月1万〜10万円程度)が必要です。ライセンス費用も、あわせて考えておく必要があります。
パッケージカスタマイズ型であれば、初期費用を100万〜300万円に抑えられる場合があります。
費用を抑えるためのポイント
まず挙げられるのは、フェーズ分割によるMVPの先行リリースです。すべての機能を一気に作らず、核心機能に絞った最初のバージョンを短期間・低予算でリリースし、ユーザーのフィードバックを得ながら機能を拡充します。これにより、総投資額のリスクを分散できます。
続いて、既存のAPIとOSSを積極的に活用する方法があります。音声認識・AI要約にはOpenAI API・Azure APIなどを利用し、フロントエンドフレームワーク・テキストエディタはOSSを使うことで、ゼロからの実装コストを削減できます。
また、内製化と外注のハイブリッドも取り入れられます。コア機能の設計と実装は外注し、UI調整や管理機能は社内の内製チームが担当するなど、得意な領域を分担することでコスト効率が高まります。そのうえで、見積もりは最低3社以上から比べ、機能の範囲と品質保証の内容を確かめて判断するのがおすすめです。
外注・発注時の選び方と注意点
議事録作成システムを外注する際は、開発会社の技術力に加えて、AI・音声認識領域の実績を確かめます。プロジェクト管理体制や保守・運用サポートの充実度も含め、総合的に評価することが大切です。
単純に見積金額の安さだけで選ぶと、品質トラブルや仕様変更への対応の遅れにより、結果的に費用が膨らむことがあります。
開発会社の選定基準
開発会社を選ぶ主な基準は5つあります。1つ目は「AI・音声認識システムの開発実績」で、類似プロジェクトの事例を2〜3件以上確認し、実際の精度と稼働実績を聞いておきます。
2つ目は「提案力とヒアリング姿勢」です。初回提案の段階から「こういう場合はどうするか」「リスクはないか」と深く考えてくれる会社は、信頼できます。3つ目は「エンジニアの技術スタック」で、Python・クラウドインフラ・LLM API連携の経験者が在籍しているかを具体的に確認します。
4つ目は「プロジェクト管理体制」で、週次の進捗報告・課題管理・仕様変更への対応方針が明確かを見ます。5つ目は「保守・運用サポートの内容と費用」で、リリース後の対応時間・対応範囲・月額費用を契約前に詳しく確かめます。SLAの設定も重要です。
開発で起きやすい失敗とリスク対策
よく起きる失敗は3つあります。1つ目は「音声認識精度への過信」です。デモ環境では高精度でも、実際の会議室の環境音や複数人の発言、専門用語が加わると、精度が大きく低下するケースがあります。そのため、要件定義の段階から実際の会議音声サンプルを使ったPoC(概念実証)を行い、目標精度に届くかを事前に確かめることを強く推奨します。
2つ目は「スコープクリープ(機能追加の際限ない拡大)」です。開発途中で「あれもこれも欲しい」と機能追加が増え続けると、工期や費用が膨らみます。変更管理のプロセスを設けて、追加機能はフェーズ2以降に持ち越す規律が必要です。
3つ目は「セキュリティ後回し問題」です。議事録は機密性が高いため、後からセキュリティ対策を加えようとすると、設計の根本から修正が必要になることがあります。セキュリティ設計は、要件定義や設計のフェーズから織り込んでおくことが原則です。
まとめ
議事録作成システムの開発は、要件定義(2〜4週間)→ 設計(3〜6週間)→ 実装(2〜4ヶ月)→ テスト(2〜4週間)→ リリース・運用という5つのフェーズで進みます。
各フェーズを丁寧に進め、前のフェーズの結果を確認してから次に進むことが、プロジェクト成功の鍵です。
AI音声認識エンジンの選定(Whisper API・Azure Speech to Text・Amazon Transcribeなど)と、LLMを用いた要約・構造化処理の品質が、システムの価値を大きく左右します。
開発費用は、スクラッチ開発の場合で小規模が300万〜500万円、中規模が500万〜1,200万円が目安です。ただし、フェーズ分割開発や既存APIの活用によって、コストを抑えることができます。
外注先を選ぶ際は、AI・音声認識の開発実績、提案力、保守サポート体制を総合的に評価してください。
riplaは、コンサルティングから開発・運用まで一貫して支援できる体制を持ち、AI活用の議事録システム開発についてもお気軽にご相談ください。
▼全体ガイドの記事
・議事録作成システム開発の完全ガイドをご覧ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。