
メタデータ管理システム開発は、6つのフェーズで進みます。前半の要件整理と方式選定で目的と対象、導入方式を決め、設計・開発とテストを経て稼働と定着へ進みます。各フェーズで成果物と判断基準を確認しながら次へ進むと、データを安全に探して再利用できる基盤につながります。
▼全体ガイドの記事
・メタデータ管理システム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
メタデータ管理システム開発の全体像
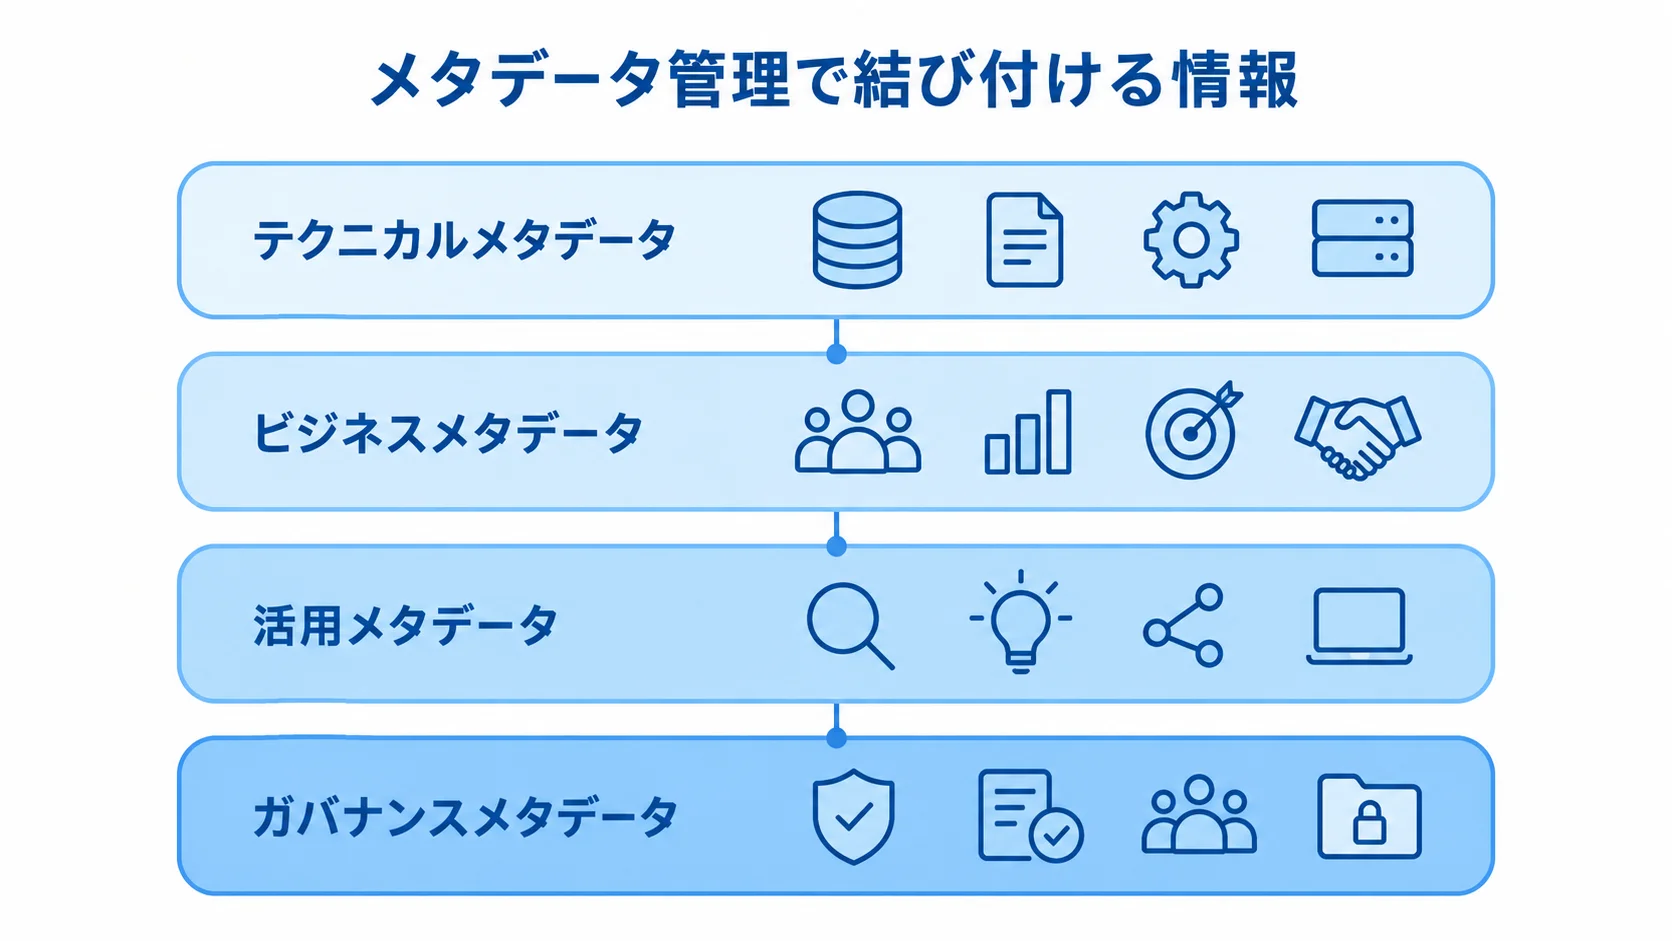
メタデータ管理システムは、データの意味や所在、品質、権限を結び付け、検索と利用判断を支える仕組みです。管理の対象には、技術情報、業務用語、データオーナーがあります。
加えて、更新頻度や利用目的、個人情報区分も含まれます。さらに、アクセス履歴やデータの流れも対象になります。
特に、機能一覧より先に、誰がどのデータを何の判断に使うかを明確にしておく必要があります。これが導入範囲を定める出発点です。
メタデータ管理システムの概要
メタデータ管理システムは、データの意味・構造・所在・利用状況・品質・権限をまとめて扱います。ファイル台帳とは役割が異なります。
たとえば「売上」が税込か税抜か、受注日と計上日のどちらを使うかを記録できます。正とするテーブルや、定義を承認する担当者も管理できます。
実際には、データカタログやデータ辞書に、データガバナンス基盤やデータインテリジェンス基盤の機能を組み合わせて提供されることが多いです。管理対象は、メタデータの種類ごとに分けると整理しやすくなります。
- テクニカルメタデータ:テーブル、カラム、データ型、更新日時、連携元
- ビジネスメタデータ:業務用語やデータの責任者
- 活用メタデータ:アクセス履歴や利用頻度
- ガバナンスメタデータ:個人情報区分や承認状況
NTTデータの「さらなるデータ民主化の実現へ」(2025年)も、業務上の意味付けの重要性を説明しています。そのため、検索できても意味が分からない状態を残さないことが、導入の前提です。
主要機能とシステム構成
主要機能は、データ収集や検索、用語管理を中心に、リネージや品質管理、権限、監査などへ広がります。ただし、初期段階ですべてを実装する必要はありません。
- 収集・検索:DB・DWH・データレイク・SaaS・BI・ETLから自動で収集します。全文検索やタグで絞り込めます。
- 理解・品質:用語集、データ辞書、リネージ、プロファイリング、品質チェックを扱います。
- 保護・運用:個人情報の自動分類、権限、マスキングを備えます。変更影響分析や承認、API、監査ログも含みます。
将来必要になる機能を後から足せるよう、拡張性は初期要件に含めておきます。
典型的な構成は、データソース用コネクタとメタデータリポジトリ、検索インデックスを核に、リネージのグラフや用語集・品質ルール、Web画面・APIが加わります。また、認証認可と監査ログも構成に含めます。
基盤がAWS中心であればGlue Data CatalogとLake Formation、Microsoft中心であればPurviewが候補になります。一方で、マルチクラウドや独自要件がある場合は、専門SaaSやOSS、SI開発を組み合わせる方法があります。
複数のツールを連携させる場合は、標準APIへの対応を確認します。たとえば、OpenLineage公式(2026年確認)が示す標準APIに対応していると、連携を追加するときの専用の変換を減らしやすいとされています。
メタデータ管理システム開発の進め方
開発は6フェーズで進みます。要件整理と方式選定で目的と導入方式を決め、設計・開発とテストを経て、稼働と定着へ進みます。各フェーズでは、成果物と判断基準を確認してから次へ進みます。作った機能だけでなく、利用者が業務上の判断に使えるかも確かめます。各段階の役割と次の判断も、あらかじめ明確にしておきます。
1. 要件整理:目的・対象範囲・責任者の決定
「データを管理する」という目的は、業務の成果に置き換えて考えます。たとえば、検索時間を30分以内にするなど、測定できる目標を設定します。ほかにも、個人情報を含むテーブルの棚卸しを月次で終える、定義確認の問い合わせを半減するといった目標が考えられます。
成果指標は1〜2個に絞ります。また、対象部門を広げる前に代表業務で効果を確かめられるよう、対象利用者も定めます。
対象や担当が曖昧なまま製品を比べると、使わない機能にまで費用がかかりがちです。そのため、要件整理では、成果物と確認項目を次のとおりそろえます。
- 目的・対象:目的とKPI、対象データソース一覧、概算スケジュール
- 利用・管理:利用者と権限区分、現行台帳、業務用語のサンプル
- セキュリティ:個人情報や機密情報の区分、データオーナーとスチュワード候補
- 現状値:対象DB・DWH・SaaS、テーブル数、更新頻度、検索時間、問い合わせ数
2. 選定:パッケージ・クラウド・OSS・スクラッチの比較
方式は、対応データソースと運用体制との適合性で比べます。そのうえで、方式ごとに保守担当も確認します。
- 専門SaaS:短期導入や日本語の用語集運用に向く方式です。
- クラウド標準:既存のID・監査・データ基盤と接続しやすい点が特徴です。
- OSS:ライセンス費を抑えられる可能性がありますが、保守担当が必要です。
- SI開発:閉域網や特殊な承認がある場合に候補となります。
OSSでは、コネクタ保守、脆弱性対応、更新の担当を評価します。SI開発では、標準機能を作り直さない範囲を先に決めます。
RFPには、対応コネクタの実績、初回収集項目、差分更新方式を書いておきます。また、用語集やリネージの粒度、個人情報分類の精度測定方法も含めます。
実データを使った評価で、デモでは見えない差を確認します。認証と権限の条件として、OIDC・SAML・RBAC、列・行レベル制御を記載します。監査ログやAPI、データと設定のエクスポート条件も書き添えます。
代表的な20〜50件程度の用語やテーブルを使い、検索性と分類精度を試します。合格基準は、対象部門が自ら探して意味を確かめ、権限に沿って申請できることにします。
3. 設計・開発:収集・検索・権限・ワークフローの構築
設計では、検索を始めるのに必要な項目と、承認・公開に必要な項目を段階を分けて定義します。すべてを必須にすると登録が進まなくなるため、利用目的に応じて必須にする項目を決めます。
- 項目設計:標準項目は資産名、説明、所有者、更新日時、所在、スキーマ、機密区分です。拡張項目は業界固有指標、申請番号、保存期限、品質スコア、契約情報です。
- コネクタ:初回・差分スキャン、失敗時の再実行、レート制限、資格情報、対象外資産の除外を決めます。
- リネージと承認:業務影響分析に応じて、テーブル単位かカラム単位かを選びます。AIのタグ候補や自然言語検索にも、人の承認を残します。
- 運用機能:個人情報区分や重要用語の承認に加えて、API・監査ログ・バックアップ・削除依頼の扱いを設計します。
4. テスト:実データによる精度・性能・権限の検証
テストでは、画面の表示だけでなく中身の正しさを確かめます。収集漏れや誤分類、古い定義の公開、権限の過剰付与は、いずれも業務リスクになるためです。
機能テストでは、データソースごとの収集件数と更新の遅延を確認します。検索結果の妥当性や用語と資産の関連に加えて、リネージの再現性と分類精度も確かめます。
アクセス拒否や操作ログの記録も検証します。受け入れテストでは、実際の利用者が業務シナリオを実行します。
- データ探索:「顧客の最新データを探す」
- 情報確認:「個人情報を含む項目を確認する」
- 定義確認:「定義が違う指標を見分ける」
- 影響調査:「上流変更の影響を調べる」
合格条件には、検索結果が出ることに加えて、説明・所有者・品質・権限から利用可否を判断できることを含めます。未承認の個人情報資産が一般利用者に公開されないことや、失敗したスキャンを翌営業日までに検知できることを、数値で合意します。
5. 稼働:段階展開と安全な切り替え
本番稼働は段階的に進め、初期の登録数より業務での再利用を確認します。切り替え後も、設計との差分を追います。
- 展開範囲:全社一斉を避け、1〜3個のデータソースまたは1部門から始めて、利用者による再利用例を作ります。
- 稼働前確認:接続権限、個人情報の公開範囲、バックアップを確かめます。加えて、障害連絡先、スキャン時刻、変更通知、削除・保持期限を決めます。
- 切り替え準備:旧台帳や部門辞書の重複・廃止・所有者不明項目を洗い出します。参照専用で残す期間、問い合わせ窓口、手動確認方法、ロールバック条件も定めます。
- 稼働後の確認:30日程度、スキャン失敗、誤タグ、申請滞留、未検索資産を日次または週次で確認し、想定との差分を記録します。
6. 定着:役割・ルール・KPIの運用への組み込み
役割、承認ルール、KPIを決めておくと、利用状況に応じて運用を見直せます。棚卸し日は、月次または四半期で設定します。
- 役割分担:オーナーは定義と公開可否を担います。スチュワードは説明文やタグ、品質ルールを受け持ちます。管理者は接続、権限、障害を担当します。
- 用語の運用:利用者を含む申請・レビュー・承認・変更通知・廃止の流れをワークフローにします。
- KPI:検索到達時間、定義確認の問い合わせ、重複作成数、品質障害の調査時間を見ます。監査対応時間、承認待ち件数、月間アクティブ利用者数も対象です。
- 改善:利用されない場合は、用語検索、所有者の回答、権限申請、品質表示を調べます。利用ログと問い合わせをもとに、対象ソースや自動化範囲を広げます。
メタデータ管理システムの費用相場とコストの内訳
費用には利用料のほか、連携設定や棚卸し、用語整備が含まれます。権限・ID連携、品質ルール、追加開発、教育、保守運用も費用の対象です。
費用は、データソースや資産、利用者の数によって変わり、スキャン頻度も影響します。さらに、リネージの深さや個人情報分類、オンプレミス接続も関わります。
個別の見積もりで確定するまでは、幅があります。そこで、公開情報と一般的な導入工程を組み合わせた概算レンジで全体の目安をつかみます。
規模別の初期費用の目安
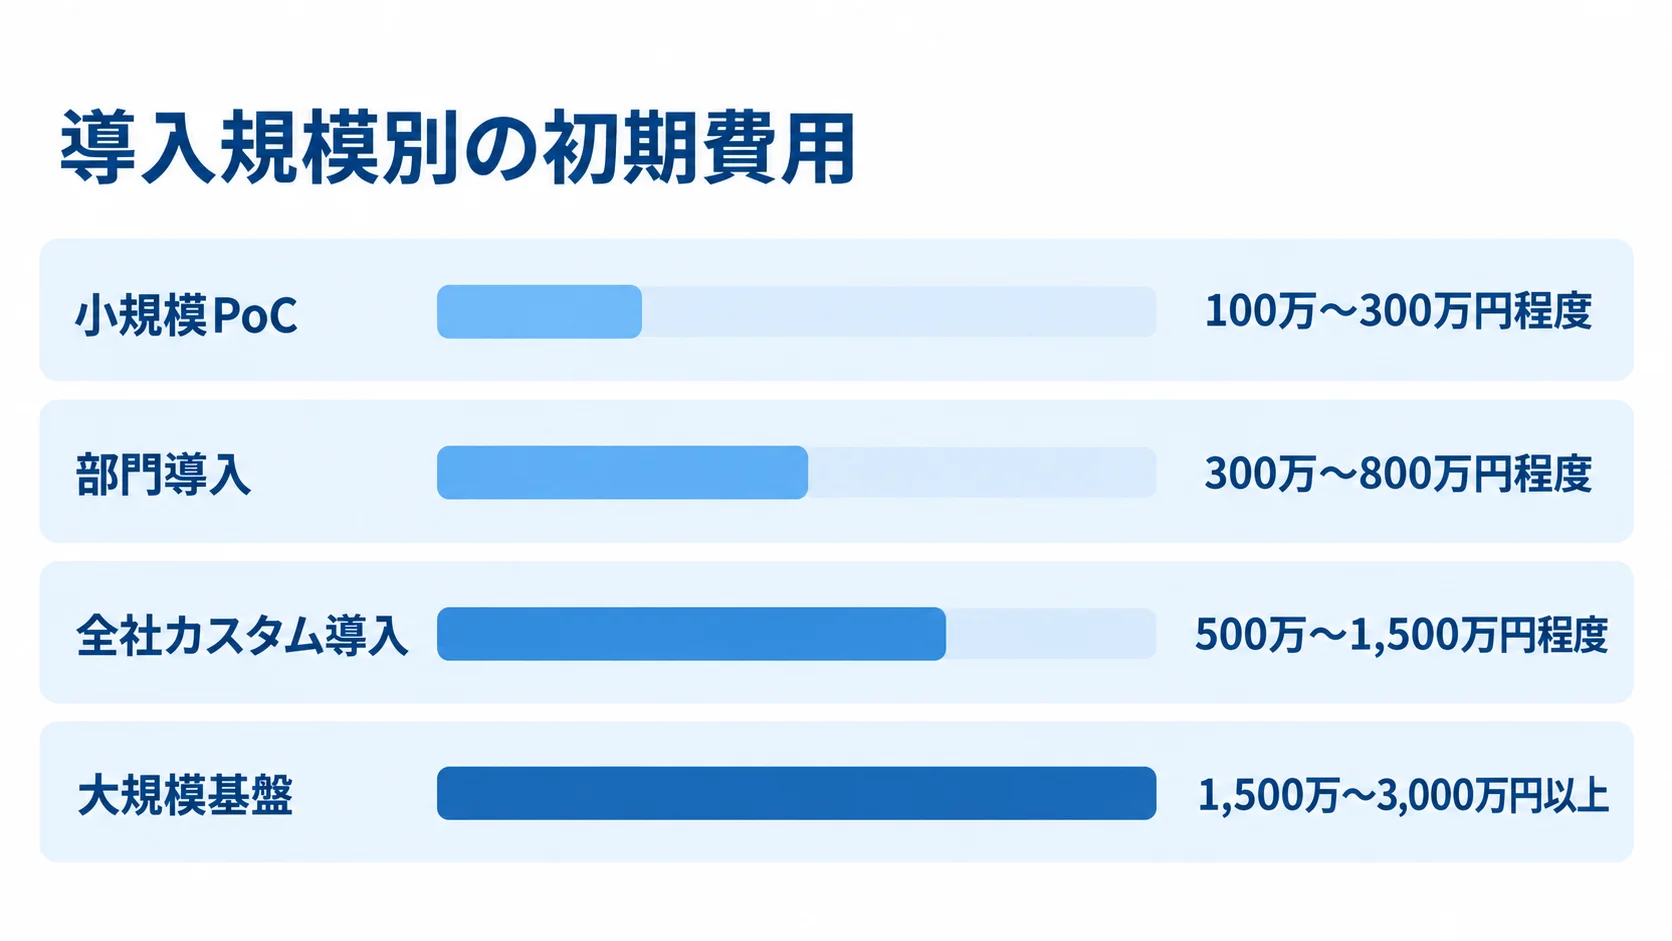
初期費用は、導入規模と連携範囲によって変わります。下の一覧は、要件に基づく推定レンジで、費用と期間の目安を示したものです。
- 小規模PoC:100万〜300万円程度、1〜2か月。
- 部門導入:300万〜800万円程度、3〜5か月。
- 全社カスタム導入:500万〜1,500万円程度、6〜12か月。
- 大規模基盤:1,500万〜3,000万円以上となる可能性があります。
小規模PoCでは、1〜3個の接続先を使い、実データで検索と用語集を検証します。所有者、基本権限、簡易リネージも試します。
部門導入では、複数DB・DWHや用語集を扱い、承認や個人情報タグ、利用教育も想定します。なお、既存のクラウド機能や無償枠を使うと、費用が下がる場合もあります。
全社導入では、複数クラウドやオンプレミス、BI・ETLとの連携が範囲に入ります。さらに、品質管理や承認・監査、既存ID基盤との連携も加わります。
全社データモデルや複雑なリネージ、マスキングを加えると、大規模化します。複数地域、移行、教育、運用設計まで含めると、大きくなります。
GXO「データカタログ構築の費用相場」(2026年)は、SaaS型を月額10万〜50万円、カスタム開発を500万〜1,500万円としています。ただし、個別案件の確定価格ではありません。
ランニングコストの内訳
ランニング費は、月額利用料に加えて、資産数や処理量に応じた追加費用も含めて見積もります。方式ごとに課金単位を確認します。
- SaaS:公開目安は月額10万〜50万円、年換算で120万〜600万円程度です。
- AWS Glue Data Catalog:メタデータオブジェクト100万件・アクセス100万回まで無料。
- Microsoft Purview:Data Mapの1容量単位は毎秒25操作・10GBの容量です。
ユーザー数、資産数、スキャン回数が課金の対象になる場合があります。API、転送、サポート、追加コネクタ、導入支援も、別料金となることがあります。
クラウド標準サービスでは、クローラや品質計算、検索の費用も積み上がります。さらに、ストレージやネットワーク、ログ保管、監視も費用に加わります。
AWS Glue Data Catalogの超過分は10万オブジェクトあたり月1米ドルです(AWS公式「AWS Glue Pricing」、2026年確認)。クローラやETL、統計計算、品質処理は別料金になります。加えて、リージョンによっても価格が変わります。
Microsoft Purviewも、管理対象のアセットや処理量に応じて課金されます。容量条件は、Microsoft Learn「Learn about Microsoft Purview Data Map」(2025年更新)に示されています。
そのため、資産数・スキャン頻度・処理量を分けて見積書に記載してもらいます。
メタデータ管理システムの見積もりを取る際のポイント
見積もりの精度は、対象範囲と運用条件をどこまで共有できるかで決まります。要望が曖昧だと、連携や定義整理、権限、教育が後から追加されます。
各社の見積もりを比べられるよう、候補会社には同じ前提のRFPとサンプルデータを渡します。初期費用、利用料、追加開発、移行、保守は分けて提示してもらいます。
要件定義とRFPの記載項目
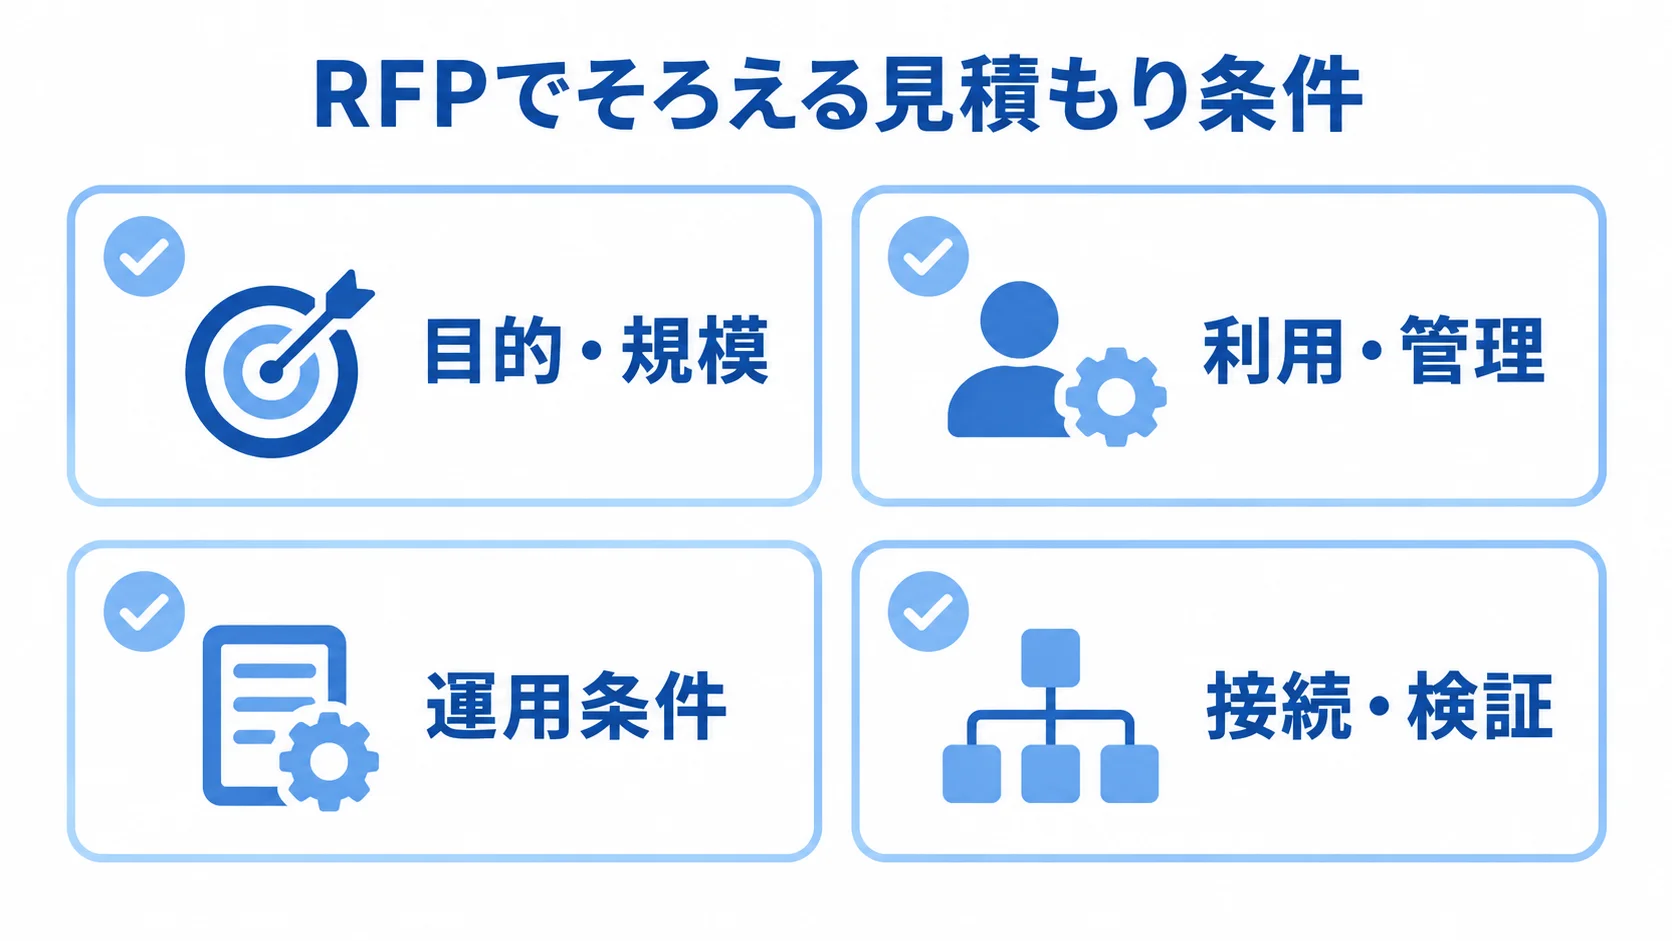
RFPは、各社が同じ前提で見積もれるように作ります。数値は、確定値・概算値・未確認に分けて示します。
- 目的・規模:目的とKPI、対象部門、データソースを記します。DB・テーブル・カラム数、更新頻度、データ量、ネットワーク経路も含めます。
- 利用・管理:個人情報の有無、用語辞書、所有者、ID基盤を示します。利用者数、リネージ粒度、品質ルール、承認フローも書き添えます。
- 運用条件:監査保存期間、希望稼働時期を記します。未確定の値も明示し、各社の前提をそろえます。
- 接続・検証:接続条件、用語集、PoC時のデータ管理条件
コネクタは、製品上の「対応」と自社環境で動くことを分けて確認します。認証方式、ネットワーク制限、対象バージョンも確かめます。取得項目、差分更新、失敗通知も調べます。
用語集は、CSV取込に加えて、申請者・承認者、改訂履歴、関連資産、公開範囲も確認します。PoCで使う実データの匿名化の方法と、検証後の削除責任も、RFPに含めます。
複数社比較の判断基準
比較では、価格に加えて、製品・実装・運用支援の役割を分けて見ます。製品ベンダーがライセンスを提供し、SIerなどが接続・移行・カスタマイズを担う場合もあります。そのため、契約先と責任範囲を確認します。
- 体制・実績:製品ベンダー、SIer、導入パートナーの担当範囲、類似要件の実績、PoC後の支援を確認します。
- 機能・条件:データソース、検索・用語集、リネージ、分類精度、権限・監査、マルチクラウド、API、期間、教育、保守窓口、データ・設定の出力可否を比べます。
- 実演・総額:複数定義の用語、アクセス不可資産、上流変更によるBI影響を試し、追加コネクタや専門人材も含めて3年程度のTCO(総所有コスト)で比べます。
月額が安くても、追加コネクタや専門人材が必要になれば、総額は変わります。
見積もりで見落としやすいリスクと対策
見積もりでは、作業範囲と追加費用の条件を明確にします。「一式」と書かれた項目も、内訳を確認します。
- 作業範囲:既存連携、定義整理、ID連携、閉域網・プロキシを確かめます。初回スキャン、教育、問い合わせ、保守対象の境界を線引きします。
- 追加費用:作業単位、対象数、成果物、前提条件を明示します。テーブル数・スキャン回数の従量課金、API・ストレージ上限、時間外サポート料金も明らかにします。
- データの持ち出し:メタデータ・用語の所有権、出力形式、API仕様書、設定を確認します。リネージ・監査ログの保持、終了時の返却・削除証明の扱いも決めます。
- 個人情報・運用:委託先・再委託先、保管リージョン、暗号化を押さえます。アクセスログ、事故報告、削除依頼、人員計画も含みます。
社内のデータオーナーが毎月運用できる人員計画は、予算超過と形骸化を防ぐために必要です。また、個人情報の取り扱い条件は、契約と設計の両方に反映します。
メタデータ管理システム開発でよくある質問(FAQ)
効果を出すには、製品の導入に加えて、対象範囲と用語の責任者を先に決めておくことが欠かせません。公開ルールや課金単位も整理しておくと、手戻りを減らせます。
メタデータ管理システムはパッケージとスクラッチのどちらがよいですか?
短期導入や標準的な検索・用語集・権限で始めるなら、専門SaaSやクラウド標準サービスが候補です。
独自のデータモデルや特殊な承認、厳格な閉域網、既存業務システムとの深い連携がある場合は、標準製品とSI開発の組み合わせが現実的です。
全面スクラッチは避け、差別化機能だけを開発します。収集・検索・認証に標準機能を使うと、期間と保守負担を抑えやすくなります。
開発期間はどのくらいかかりますか?
開発期間は、規模や要件整理、社内承認の進み方によって変わります。PoCから部門導入、全社展開へと対象が広がるほど、期間も長くなります。
- 小規模PoC:1〜3個のデータソースを使い、1〜2か月程度。
- 部門導入:複数DB・DWH、用語集、ワークフローを含み、3〜5か月程度。
- 全社展開:複雑な権限・リネージ・移行を含み、6〜12か月程度。
定義整理や社内承認が遅れると、製品の設定が終わっていても稼働できません。短縮するには、PoC前に対象部門、KPI、接続先、受け入れ条件を絞ります。全社の要件を一度に解決しようとしないことが大切です。
AIでメタデータの登録や分類を自動化できますか?
AIは、説明文の生成やタグ候補、自然言語検索、類似用語の提示に使えます。登録や探索を効率化するのに役立ちます。
個人情報・機密情報の分類や正式な業務用語を、AIだけで確定するのは危険です。そのため、AIの候補はデータオーナーが承認します。
承認者、根拠、変更履歴を記録しておくと、後から確認できます。PoCでは、自動化率に加えて、誤分類率や確認時間、誤公開の有無を評価します。
個人情報を含むデータでも導入できますか?
導入できますが、メタデータ自体に機微情報を載せすぎない設計が必要です。そのため、分類、最小権限、暗号化、マスキングを要件に加えます。
操作ログ、承認済み利用者への表示、委託先・再委託先、保管場所、事故報告も定めます。また、個人情報保護委員会のガイドラインや社内基準を参照します。
AIの自動分類結果も、人が確認します。PoCでは、本番データを匿名化するか限定環境で扱い、安全性を確かめます。
まとめ
メタデータ管理システム開発は、意味・責任者・品質・権限・変更影響を結び、データを安全に再利用する基盤づくりです。まずは、検索時間の短縮や個人情報の所在把握など、1〜2個の成果指標と対象範囲を定めます。
6フェーズでの成果物と判断基準の確認
要件整理で目的・対象・責任者を決め、方式選定で製品と開発方法を比べます。設計開発では、収集・検索・権限・ワークフローの仕組みを作り込みます。
実データで精度・性能・安全性を試し、限定した範囲から稼働します。最後に、オーナーやスチュワード、KPIを運用へ組み込みます。各段階で成果物を承認してから次へ進むと、機能の作り直しや導入後の形骸化を防ぎやすくなります。
最初の一歩は90日程度のPoC計画
最初のPoCでは、全社展開の前に対象と効果、費用、支援条件を確かめます。
- 対象設定:全社のデータを一度に登録するのは避け、代表的な1〜3データソース、利用者、用語、権限シナリオを選び、90日程度の計画を立てます。
- 費用確認:初期構築、利用料、コネクタ、用語・品質整備を切り分けます。教育や保守も分けたうえで、資産数やスキャン頻度による変動条件を明記します。
- 効果測定:検索から利用までの時間、問い合わせ数、品質調査時間を導入前後で比べ、効果が見えた領域から広げます。
- 会社選定:既存環境との連携、用語整備、権限・監査、PoC後の支援、データ持ち出し条件を確認します。
導入効果を保つには、社内のデータオーナーが継続して判断できる運用体制が欠かせません。
▼全体ガイドの記事
・メタデータ管理システム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。