
マイクロサービス基盤開発は、業務を整理して基盤を選び、小さく検証してから、設計とテストを経て段階的に稼働させ、運用で改善していく流れで進みます。この順に進めると、安全な変更につながります。
基盤の全体像、開発の6フェーズ、費用相場、見積もりの確認事項を、発注側の視点で扱います。全体像は完全ガイドでも詳しく説明しています。
▼全体ガイドの記事
・マイクロサービス基盤開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
マイクロサービス基盤開発の全体像
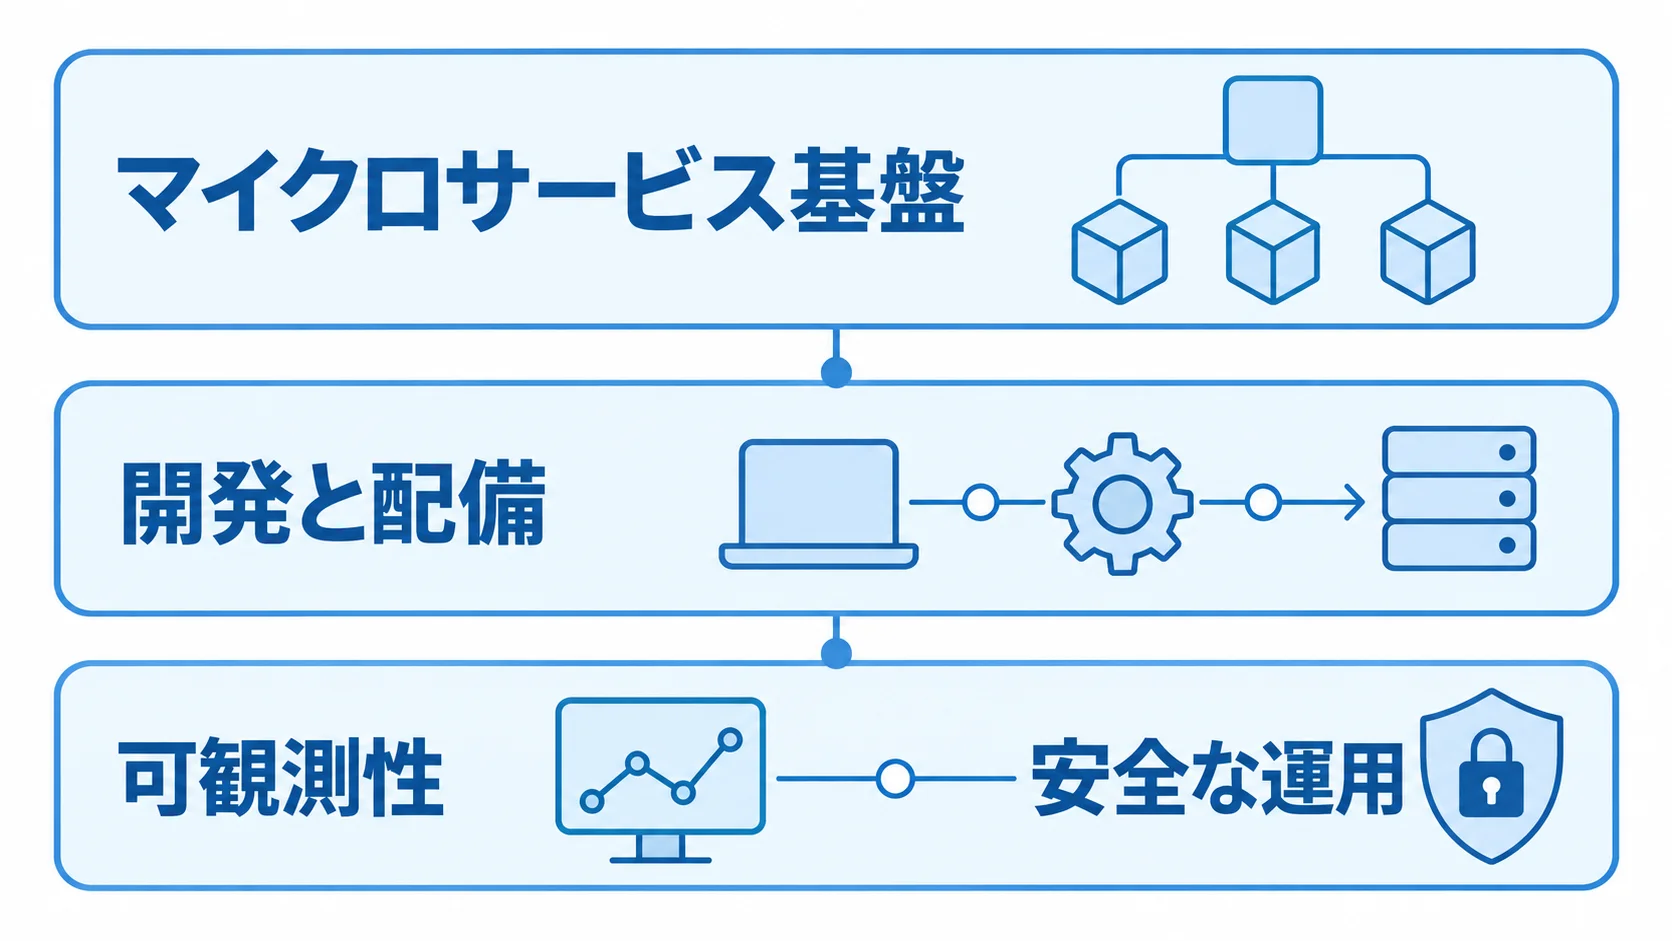
マイクロサービス基盤は、受注、顧客、商品、在庫、請求などを独立したサービスとして運用するための共通環境です。
サービスを分けただけでは完成せず、API、認証、データの共通ルールに加え、デプロイ、監視、障害対応まで整えて、はじめて事業に役立つ基盤になります。
マイクロサービス基盤の定義
マイクロサービス基盤は、複数の業務サービスを安全かつ継続的に動かすための、開発・実行・運用の土台です。外部の入口をまとめるAPIゲートウェイやBFFのほか、コンテナ環境と、サービス間の通信やデータ管理も含みます。
- 開発と配備:CI/CD、IaC、コンテナ実行環境
- 可観測性:集中ログ、メトリクス、分散トレーシング
- 安全な運用:認証、シークレット管理、障害対応の標準化
注文サービスが在庫サービスのデータベースへ直接接続すると、片方の変更が他方の障害につながります。
そこで、注文データは注文サービスが所有し、在庫サービスとはAPIやイベントで連携させます。責任の範囲を明確にすることが基本です。
たとえば、在庫引当の完了や請求の確定はメッセージで通知します。数秒程度の遅延を許容できる業務は非同期化すると、障害の連鎖を抑えやすくなります。
向いているケースと向いていないケース
向いているのは、複数チームが同時に開発し、機能ごとに変更の頻度や負荷が異なり、障害の影響を分けたいケースです。
- ピーク負荷が異なる:商品検索のように、特定の機能だけを独立して拡張する必要がある
- 変更周期が異なる:顧客向けアプリと社内業務を、別々のペースで改善する
少人数の単純なCRUD処理や変更の少ない業務では、分割の効果が限られる場合があります。
サービス間の一貫したトランザクションがほとんどの処理で必要な場合は、モジュラーモノリスやマネージドPaaSも候補になります。
判断の際は、変更の単位やチーム数、障害の分離の要否、ピーク負荷を見ます。加えて、運用を担う人材と、5年間の総保有コストも比べます。
マイクロサービス基盤開発の進め方
全社のシステムを一度に分割せず、まず業務と制約を整理したうえで、小さな領域から仮説を検証します。
各フェーズには終了条件を決めておき、技術面だけでなく運用担当者が扱えるかも確かめてから、範囲を広げます。
(1) 要件整理:分ける理由と成功条件
受注、出荷、請求などの業務フローを一覧にして、機能ごとの変更頻度や障害時の影響を洗い出します。
- 業務と連携:対象業務と対象外業務、現行システムとの連携先
- 性能と継続性:処理量、許容できる停止時間、RTO・RPO、SLO
- データと運用:データの所有者、個人情報、決済情報、内製の範囲を確かめる
- 初回範囲:MUSTとWANTを分けたうえで、3〜5領域程度に絞る
ピーク時のリクエスト数や、移行時に停止できる時間も要件に含めます。これらをそろえておくと、PoCの結果を評価しやすくなります。
分ける理由は、独立してデプロイする必要があるかを基準に、業務責任者と合意しておきます。
「将来拡張したい」という期待は、それだけでは分割の理由になりません。
(2) 基盤選定:運用できる自由度
AWSやGoogle Cloud、Azure、オンプレミス、ハイブリッドなどの基盤を比べる際は、機能の多さだけでなく、自社が運用できるかを見ます。
- 自社の条件:運用人数、認証、ネットワーク、データの所在
- 外部要件:監査、ベンダー支援、将来の移行のしやすさ
- 少人数での開始:Cloud Run、Azure Container Apps、AWS Fargateなどを候補に入れる
マネージド実行環境は、少人数チームのクラスタ運用負担を抑えやすい選択肢です。
一方でKubernetesは、複数チームに共通の実行標準を提供したいとき、複雑なネットワーク制御が必要なとき、ワークロードの種類が多いときに候補になります。その前提は、ノード更新や権限、費用、障害対応を自社で説明できる体制があることです。
CNCFは、2026年公表の「2025 Annual Cloud Native Survey」で利用状況を報告しており、コンテナ利用組織の82%が本番でKubernetesを利用しています(出典: CNCF、2026年)。ただし、この普及率から、自社にKubernetesが必要かまでは判断できません。
(3) 設計・開発:共通ルールの先行整備
開発に入る前に、サービスごとの責任範囲とAPI契約、データの所有権を決めておきます。エラー形式やタイムアウト、リトライの扱いも、同じ基準でそろえます。
- 同期処理:すぐに結果が必要な業務で使う
- 非同期処理:数秒から数分の遅延を許せる業務で、キューやイベントバスの利用を検討
- 共通ルール:認証・認可、バージョン管理、ログ形式をそろえる
同期APIが増えすぎると、遅延が呼び出し元へと連鎖します。そのため、処理の即時性に応じて連携方式を選びます。
開発を始める前に、リポジトリのテンプレートとCI/CD、IaCを共通化しておきます。
トレースIDやメトリクス、アラートの通知先も、サービス間で同じ形にそろえます。
シークレットの保管方法も同じ方法に決めておきます。こうした共通化は、品質と障害対応を一定に保つための仕組みです。
最初の1サービスで、デプロイ、ロールバック、負荷試験、アラート確認を一通り試します。その結果をもとにテンプレートを改善してから、ほかのサービスへ横展開します。
(4) テスト:分散システムの失敗の再現
品質を判断するには、単体テストに加えて、サービス間の連携や障害時の挙動も確かめる必要があります。
- 機能とデータ:API契約、結合、データの整合性
- 性能と権限:負荷や性能、アクセス権の確認
- 障害と復旧:障害注入、バックアップからの復旧
具体的には、タイムアウトや、重複・順序違いのイベントを再現します。加えて、キューの滞留やDB接続の枯渇、外部APIの停止も試します。
受入条件には、SLOと運用手順を含めます。たとえば、注文APIの成功率やp95レイテンシーを数値で定めます。在庫連携の遅延や、重大アラートの検知時間、ロールバックの完了時間も、判定項目にします。
テスト環境と本番環境の差が大きいと、問題がリリース後になって表面化しがちです。そこで、構成の差分をIaCで管理し、本番に近い環境でリリース候補を確かめます。
(5) 稼働:段階リリースと切り戻しの準備
既存モノリスの外側にAPIや新サービスを置き、変更頻度の高い機能から順に切り出します。
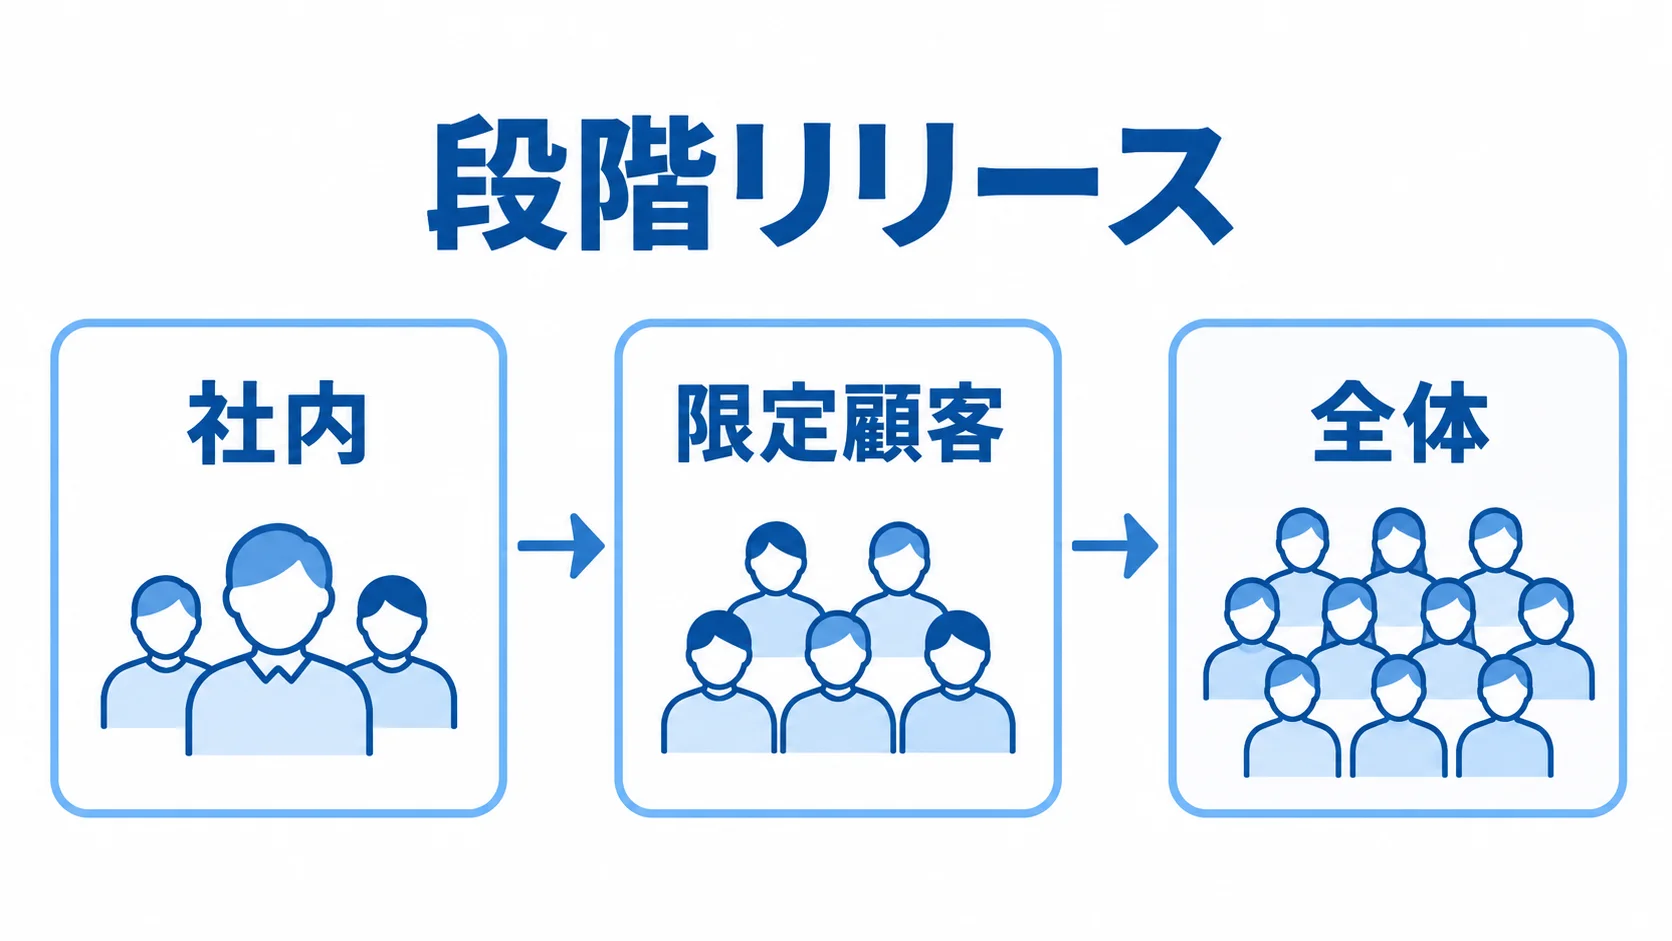
- 対象を広げる:社内、限定顧客、全体の順にカナリアリリース
- 比較して確かめる:新旧の結果を比べるシャドートラフィックの検討
この段階移行は、ストラングラーパターンのように進めます。一度に全ユーザーを新サービスへ送らず、少しずつ切り替えていく方法です。
稼働の判定では、切り替えの条件と監視画面を決めておきます。そのうえで、オンコール担当と障害時の連絡網も定めます。さらに、データ同期をやり直す方法、切り戻しの期限、旧システムを止める条件も確かめます。
旧システムへ戻す可能性があるなら、双方向の同期と差分データの扱いを、先に決めておきます。
切り戻せない状態でリリースすると、障害対応がそのまま業務停止の判断に直結します。
(6) 定着:KPIと運用体制の改善
成果は、変更と運用の結果を継続的に測って判断します。サービス数やコンテナ数を成果の指標にはしません。
- 開発の流れ:デプロイ頻度、変更リードタイム、変更失敗率
- 信頼性と費用:平均復旧時間、SLO達成率、クラウド費用を見る
- 運用負荷:対応が必要だったアラートの割合を調べます
チームが増えるほど、共通基盤チームは標準ランタイムや権限申請の手順を改善していきます。
テンプレートや監視、脆弱性対応も、ひとつのプロダクトとして継続的に育てていきます。
運用手順書は、納品で終わらせず、障害訓練で使いながら更新します。そのうえで、月次で費用とSLOを確かめます。
四半期ごとに、サービスの境界や不要な連携を見直します。
調整や監視の負担が増えてきたら、サービスの統合も検討します。
モジュラーモノリスへ戻す選択肢もあります。どの形を選ぶ場合でも、目的は事業の変更を安全かつ速く届けることです。
マイクロサービス基盤開発の費用相場とコストの内訳
費用は、開発と基盤、移行と安全、継続費に分けて考えます。開発と基盤には、アプリ開発と基盤構築が入ります。移行と安全には、既存連携と移行、セキュリティ、監視・テストが入ります。継続費には、保守とクラウド費が入ります。
ここで示す金額は、リサーチノートの業務システム開発単価と公開料金をもとにした推定で、日本市場の標準価格ではありません。金額は、サービス数や可用性、ピーク負荷によって大きく変わります。移行の難しさや運用時間も、金額を左右します。
規模別の初期開発費の目安
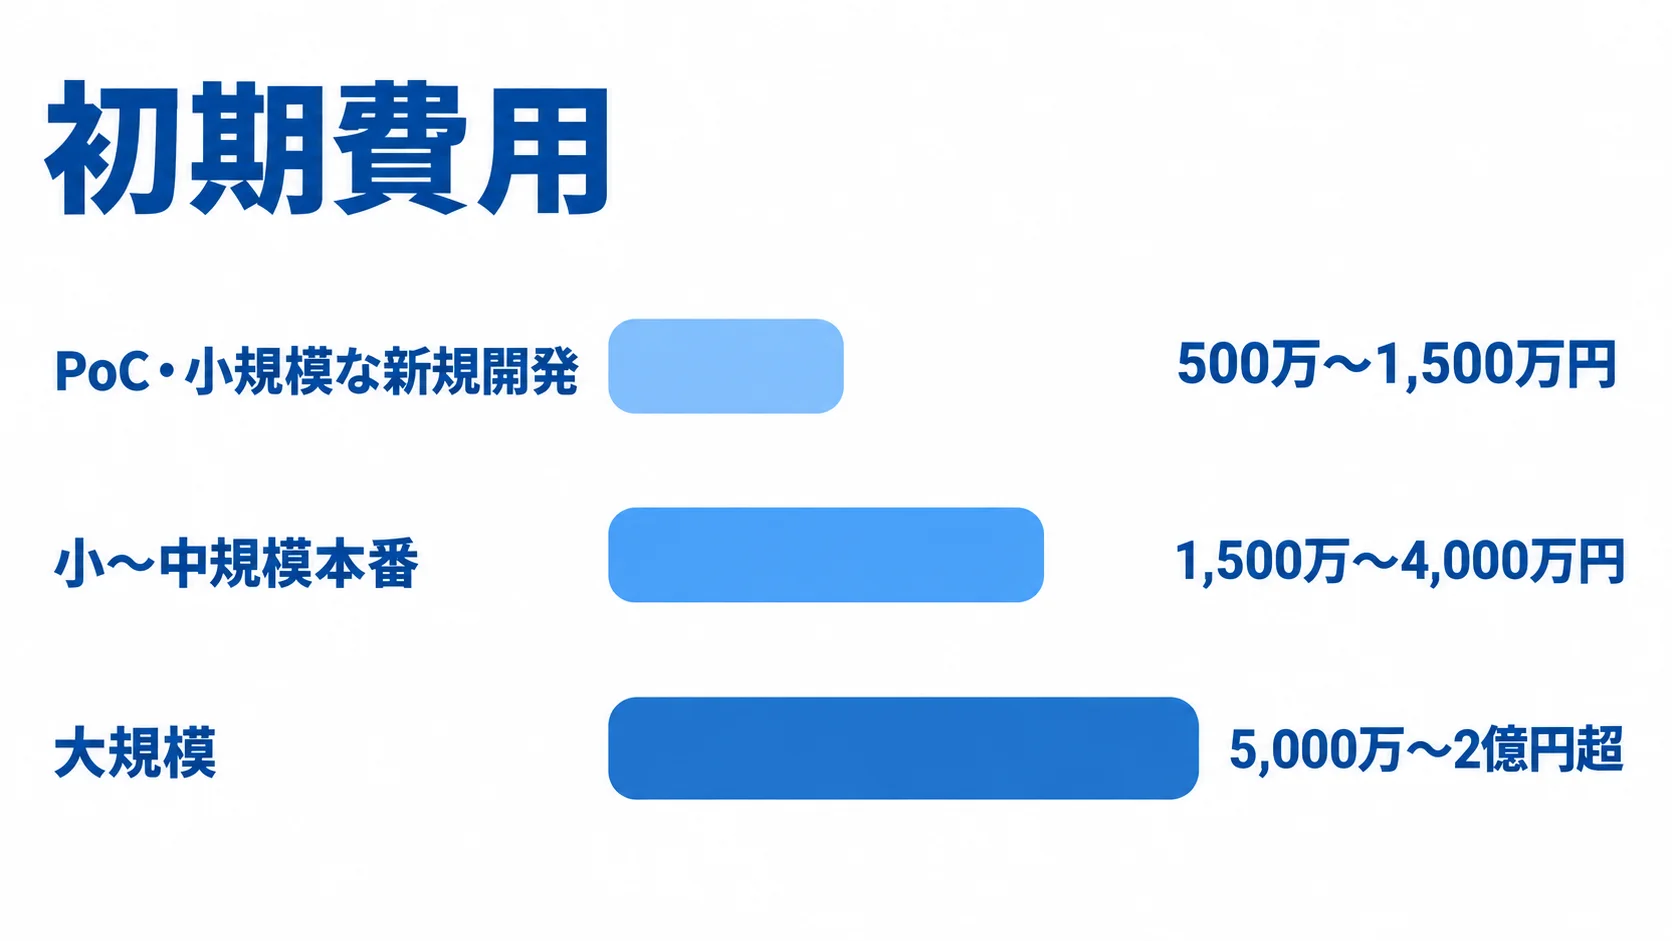
初期開発・移行費は、サービス数と含める機能によって幅が出ます。PoCから大規模まで、規模が一段上がるごとに、費用と期間の推定レンジも大きくなります。
- PoC・小規模な新規開発:3〜5サービス、マネージドPaaS、CI/CD、基本監視で初期開発・移行費は500万〜1,500万円、期間は1〜3か月程度です。
- 小〜中規模本番:5〜15サービス、API管理、RDB、非同期処理、検証・本番環境で1,500万〜4,000万円、3〜6か月程度です。
- 大規模:15〜50サービス、複数AZ、サービス別DB、災害復旧、厳格な監査、基幹移行で5,000万〜2億円超、9〜18か月程度となる可能性があります。
たとえば、エンジニア4〜6人を4〜6か月配置すると、人月費だけで約1,280万〜4,320万円になります。
人月費のほかにも、PMやQA、セキュリティ、設計レビューに加え、移行リハーサルや予備費も加わります。そのため、金額はサービス数だけで判断しないようにします。
クラウド費用と運用費が増えやすい理由
試算には、CPUやメモリだけでなく、実行環境を支える周辺サービスの費用も含めます。
- 実行と通信:ロードバランサー、データ転送、固定IP
- データ:RDB、キャッシュ、ストレージ、バックアップの見積もり
- 運用:ログや監視、秘密情報の管理
AWSのEKS料金は標準サポート中が1クラスターあたり0.10米ドル/時間、拡張サポート中が0.60米ドル/時間です(出典: AWS「Amazon EKSの料金」、2026年確認)。
この金額はコントロールプレーン分です。EC2やEBS、ロードバランサーなどは別途かかり、IPv4やログの費用も加わります。
Cloud Runなどは、使用したリソースを100ミリ秒単位で課金します。さらに、同一リージョン内のGoogle Cloudリソースへのデータ転送が無料となる条件もあります(出典: Google Cloud「Cloud Run pricing」、2026年確認)。
常時稼働、外部通信、VPC接続に加え、データベースやログも、利用の形態によって費用が変わります。そのため、別に確認します。
検証、本番、災害復旧の各環境を分け、平常時とピーク時の月額を試算すれば、予算の差異を抑えやすくなります。
費用を比較するときの分け方
見積書を同じ区分でそろえると、仕様変更やサービス追加による影響を比べられます。
- 開発と基盤:アプリ・API、コンテナ、ネットワーク、CI/CD。
- 移行と安全:ERP・販売管理との連携、データ移行、並行稼働、セキュリティ、監視、テスト。
- 継続費:保守・SRE、クラウド従量費。
請負契約と準委任契約では、仕様変更のリスクの持ち方が異なります。そのため、フェーズごとに契約を検討します。
成果物と範囲が明確な部分は請負、境界や運用を検証する部分は準委任が候補です。
契約方式による価格差は、案件ごとに異なります。一般的な目安は当てはめず、責任の分け方や変更の手続きと合わせて確かめます。
見積もりを取る際のポイント
見積もりは、単価の安さより前提条件と未確定事項が見えるかで比べるのが基本です。
全仕様を決め切らなくても、業務範囲と非機能要件、既存連携、運用体制は、そろえておきます。
候補会社には同じ条件で概算を依頼し、金額の差が生じた理由を説明してもらいます。
発注前に準備する情報
依頼資料には、対象業務の目的や現行システムの構成図を記載します。そのうえで、業務範囲と制約を候補会社に共有します。
- 業務と規模:利用者数、ピーク処理量、主要画面・API、連携先。
- データと移行:データ量、保存期間、個人情報、移行期限、停止可能時間。
- 運用条件:24時間365日監視か平日日中対応か、一次対応を自社が担うか、クラウドアカウントの所有者。
- 納品と委託:ソースコード・IaCの引き渡し、再委託の可否。
絶対に止められない業務と、数分の遅延を許容できる処理を分けて伝えると、境界や費用の見積もりの精度が上がります。
個人情報を扱う場合は、委託先と再委託先の管理、アクセス権、ログの保存を明記します。
国外での取り扱いや、事故が起きたときの報告も、契約と運用手順に定めておきます。
開発会社を比較するときの質問
候補会社には、設計判断や障害時の対応範囲を具体的に質問します。
- サービス境界:最初に切り出す業務と理由、共有DBを避ける方法は何か。
- 連携方式:同期APIとイベント連携をどう使い分けるか。
- 障害対応:どこまで切り戻せるか。SLOと監視項目は何か。
- Kubernetes運用:更新、権限、脆弱性、夜間障害、費用、引き継ぎを誰が担うか。
実績は、導入社数やサービス数よりも、移行と運用の経験で確かめます。
既存モノリスからの段階移行や、ERP・WMS・会計との連携、データ移行の経験を見ます。
24時間運用や障害訓練、内製化の支援についても、実績を比べます。
SIerとクラウドベンダーは役割が異なります。そのため、設計・開発・運用の担当を別々に選ぶか、一括で依頼するかも検討します。
AWS、Google Cloud、Azureの選定後に、各工程を担うパートナーを決めます。
見積もりの抜け漏れを防ぐチェックリスト
費用項目は分けたうえで、開発環境の構成や料金の前提も見積もりに明記します。
- 開発・運用:初期費用、月額クラウド費、保守費、監視・オンコール費、ライセンス費。
- 基盤・データ:データ転送費、バックアップ・DR費、データ移行費。
- 安全対策:セキュリティ診断費。
検証環境を本番と同じ構成にするか、停止できる時間を設けるかで、費用は変わります。
為替の影響を受けるクラウド料金は、見積時の換算レートと予算上限を、見積書に示してもらいます。
見積もりでは、APIの認証・認可、オブジェクト単位の権限、レート制限、入力検証も確かめます。シークレットの管理や脆弱性スキャン、監査ログも対象に含まれます。さらに、依存ライブラリや第三者APIの安全な利用も含めます。
OWASP API Security Top 10 2023では、上位項目に認可リスクが複数含まれます(出典: OWASP API Security Project、2023年)。さらに、機密性の高い業務フローへの無制限アクセスや、安全でないAPI利用も扱われています。
APIを増やす場合は、エンドポイントの台帳と廃止手順も見積もりに含めます。
よくある質問(FAQ)
検討の途中では、技術選定や費用、移行、運用体制について疑問が出てきます。発注前によくある疑問を、順に答えていきます。
マイクロサービス基盤にはKubernetesが必須ですか?
運用人員やサービス数が限られる場合は、マネージドサービスが候補になります。Kubernetesを採るかどうかは、運用の必要性を見て決めます。
標準的なコンテナ実行と自動スケールが目的なら、Cloud Run、Azure Container Apps、AWS Fargateが適する場合があります。
Kubernetesは、複数チームで運用標準を共有する必要性や、複雑な制御要件が、費用と運用負担を上回ると判断したときに選びます。
既存システムを止めずにマイクロサービスへ移行できますか?
段階移行なら、停止を避けられる可能性があります。ただし、無停止を保証できるとは限りません。
具体的には、ストラングラーパターンで変更頻度の高い機能を切り出し、データ同期、並行稼働、段階リリースを検証します。
監視と切り戻しも、事前に試しておきます。停止できる時間が短い業務では、移行リハーサルを複数回行い、差分データの再処理方法も受入条件に含めます。
マイクロサービス基盤の予算はどのように決めればよいですか?
予算を決める際は、開発費だけでなく継続費と規模別の目安も合わせて確かめます。
- 費用項目:初期開発、移行、クラウド、監視・保守、セキュリティを分けます。
- 総保有コスト:平常時とピーク時の2通りで5年間のTCO(総保有コスト)を試算します。
- 推定レンジ:小規模PoCは500万〜1,500万円、小〜中規模本番は1,500万〜4,000万円程度です。確定価格ではありません。
- 予算調整:サービス数の見直しに加え、マネージドサービス、段階導入、運用時間帯の見直しを組み合わせます。
まとめ
業務上の変更単位や障害の単位、責任の単位を明確にしてから、技術を選ぶことが大切です。
要件整理で目的と制約を固め、運用能力に合う基盤を選びます。そのうえで、API、データ、監視の共通ルールを設計します。
分散システム特有の障害をテストし、段階リリースと切り戻しを備えたうえで稼働させます。
着手前に確認する5つの判断軸
着手前に確認したい判断軸は、次の5つです。
- 独立した変更:独立して変更したい業務領域の有無
- 障害の分離:障害を分離する必要の有無
- チームと負荷:複数チームや負荷の変動への対応が必要かどうか
- 運用体制:監視、セキュリティ、オンコールを回せる体制があるか
- 総費用:初期費用に加えて、クラウド、保守、移行を含むTCOを負担できるかどうか
一つでも未整理の項目があるなら、全体導入よりも、モジュラーモノリスや小規模PoCから始める判断が有効です。
最初の一歩となる小さな対象領域の選定
対象の選び方から定着後の評価まで、確かめる観点は4つあります。
- 対象領域:変更頻度が高く、障害影響を切り離しやすく、成果を測れる業務を選びます。
- 相談の準備:現行構成、ピーク負荷、データ所有者、移行期限、SLOを、あらかじめ整理しておく
- 見積もり比較:同じ前提で複数社へ相談し、過剰なKubernetes構成や運用費を含まない見積もりを見分けます。
- 定着後の評価:事業の改善速度と安全性が高まっているかを、継続的に確かめる
▼全体ガイドの記事
・マイクロサービス基盤開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。