
欠損値補完とは、データ表の空欄や未観測の値を、分析や機械学習で扱える値に置き換える処理です。
欠損行をすべて削除すると標本数が減り、欠損しやすい対象に偏りが生じることがあります。そこで、データの性質に合った方法で値を補います。補完値は実測値とは限らないため、欠損の意味と不確実性を残して判断します。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」をダウンロードできます。で詳しく解説しています。
欠損値補完とは?空欄を推定値に置き換える前処理
欠損値は、値が観測されていない状態を指します。データベースのNULLやCSVの空文字、NaNがその例で、入力されていないアンケート回答も欠損値に当たります。
欠損は数値列だけでなく、カテゴリ列、日時列、テキストのメタデータにも起きます。欠損値補完は、この未観測の状態を一定のルールで埋め、集計・可視化・モデル学習で扱える形に整える工程です。
ただし、補完した値は実測値ではありません。たとえば年収が未回答の人に全体の中央値を入れても、その人の本当の年収が中央値だったとは証明できません。
補完後の値には推定誤差が含まれます。そのため、補完方法と補完件数に加えて、対象期間と対象列も記録し、実測値と区別できるようにしておきます。
欠損が起きる理由|補完前のデータ生成過程の確認
完全にランダムとは限らない欠損
欠損がランダムに発生しているなら、単純な代表値補完でも大きな偏りが生じにくい場合があります。しかし実務データでは、回答しにくい質問だけ未回答になる、計測器が高温時に停止する、売上が少ない店舗ほど報告を省略する、といった規則性があります。そこで、データを扱う担当者が欠損率を列別・期間別・顧客属性別に集計し、欠損フラグと目的変数の関係も確かめます。
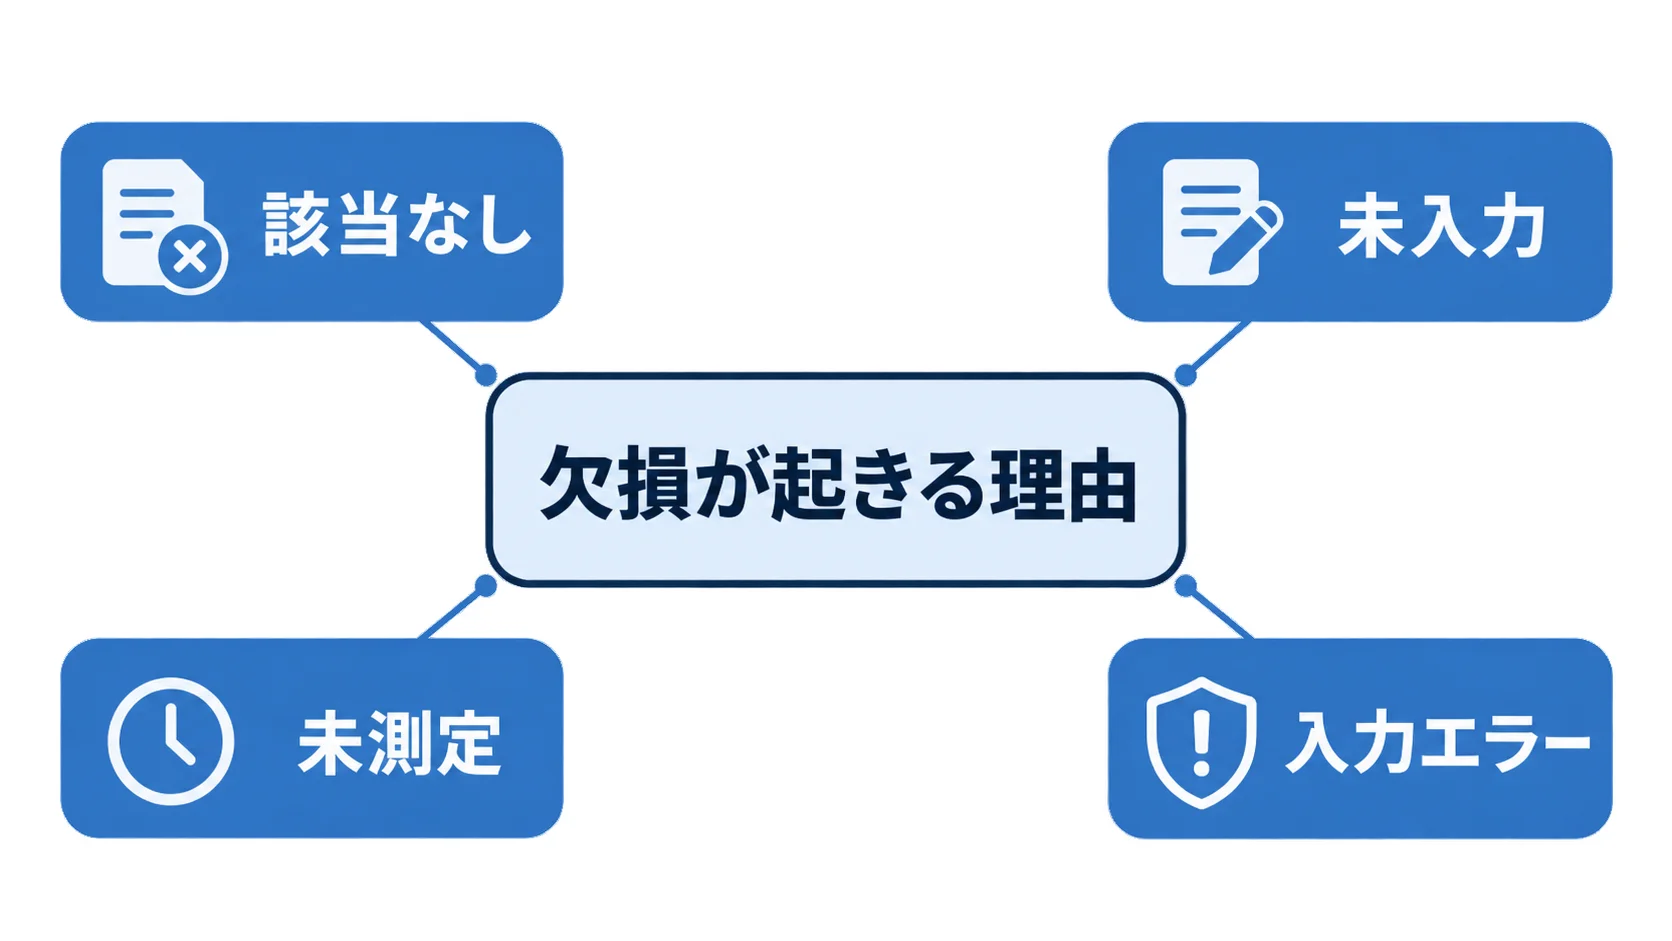
「該当なし」と「未入力」の区別
契約していないために利用回数がないケースと、契約しているのに入力を忘れたケースでは、意味が違います。両方を同じNaNとして扱うと、異なる状態が補完値に混ざってしまいます。
業務担当者に状態コードの意味を確認し、該当なし、未測定、入力エラーを区別できるか見ます。機器障害や秘匿などの状態も分けられるなら、元のコードを保持したうえで、分析用の欠損値に変換します。
欠損値を削除する方法と補完する方法の使い分け
欠損行を削除するリストワイズ削除は、実装が簡単で、推定値を混ぜないという利点があります。一方で、欠損率が高いとデータ量が減り、欠損が偏っている場合は母集団の代表性を損ないます。
特定の列だけを使う集計では、その列が欠損している行だけを除くペアワイズの考え方もあります。ただし、指標ごとに分母が変わるため、レポートで明示する必要があります。
補完はデータを残せる反面、分布を平らにしたり、ばらつきを過小評価したりします。そこで、削除と補完の両方で主要指標を算出し、結論が変わるかを感度分析で確かめるのが安全です。
また、欠損率が極めて高い列は、補完方法を工夫するより、業務上の利用目的を見直して列を除外したほうが、再現性を保てる場合もあります。
代表値による欠損値補完|平均・中央値・最頻値
平均値補完と外れ値・分布の歪み
平均値補完は、学習データで計算した平均を欠損セルへ入れる方法です。分布が左右対称で外れ値の少ない数値列であれば、基準値として説明しやすいでしょう。
しかし、売上や利用時間のように右に長い分布では、少数の大きな値に平均が引っ張られます。さらに、欠損行がすべて同じ平均値になるため、分散が小さく見えてしまう点にも注意が必要です。
中央値補完と外れ値への強さ
中央値補完は、観測値を並べたときの中央の値を利用します。住宅価格、請求額、滞在時間など外れ値が混ざりやすい列では、平均より安定した基準になることがあります。
ただし、中央値も欠損値の不確実性を表すものではありません。欠損が特定のグループに集中している場合は、全体の中央値よりも、学習データ内のグループ別の中央値を検討します。
カテゴリ列の最頻値と専用カテゴリ
性別、会員区分、都道府県などのカテゴリ列は、最も多いカテゴリで埋める方法が基本です。ただし、最頻値を入れると欠損行が多数派のカテゴリに偽装されてしまいます。
欠損が業務上意味を持つなら、「不明」「未回答」といった専用カテゴリを追加し、モデルが欠損の状態を区別できるようにします。その前に、カテゴリの表記ゆれを統一し、大小文字や全角半角の違いを残さないことも大切です。
推定モデルを使う欠損値補完|KNNと反復補完
K近傍法補完と似た行の値の利用
K近傍法補完では、欠損している列以外の特徴量が似ている行を探し、その近傍の観測値から値を推定します。たとえば、年齢、地域、利用頻度が似た顧客の購入額を参考にするイメージです。
距離を計算するため、特徴量の尺度をそろえておかないと、単位の大きい列だけで近さが決まってしまいます。標準化や距離計算に使う列の選定は、学習データの中で行ってください。
反復補完と、ほかの列からの推定
反復補完は、欠損のある列を目的変数とみなし、ほかの列から回帰モデルなどで予測して埋めます。1列を補完したら、その補完値を使って次の列を補完し、複数回繰り返して安定させます。
列同士の関係を利用できる反面、データ量が少ない、欠損率が高い、外れ値が多いといった場合には、推定が不安定になります。そこで、補完モデルの種類、反復回数、乱数を記録し、代表値補完との比較を行います。
欠損指標の追加と「欠損した事実」の保持
補完値だけでは、元のセルが欠損していたかどうか分からなくなります。そこで、列ごとに欠損フラグを追加し、欠損の有無を別の特徴量としてモデルに渡す方法があります。
欠損が目的変数と関係する場合に有効です。ただし、欠損フラグ自体が将来の情報を含んでいないかを確認します。予測時点で取得できないフラグを学習に使うと、運用で再現できないモデルになります。
欠損値補完の実装|学習データ内での統計量の計算
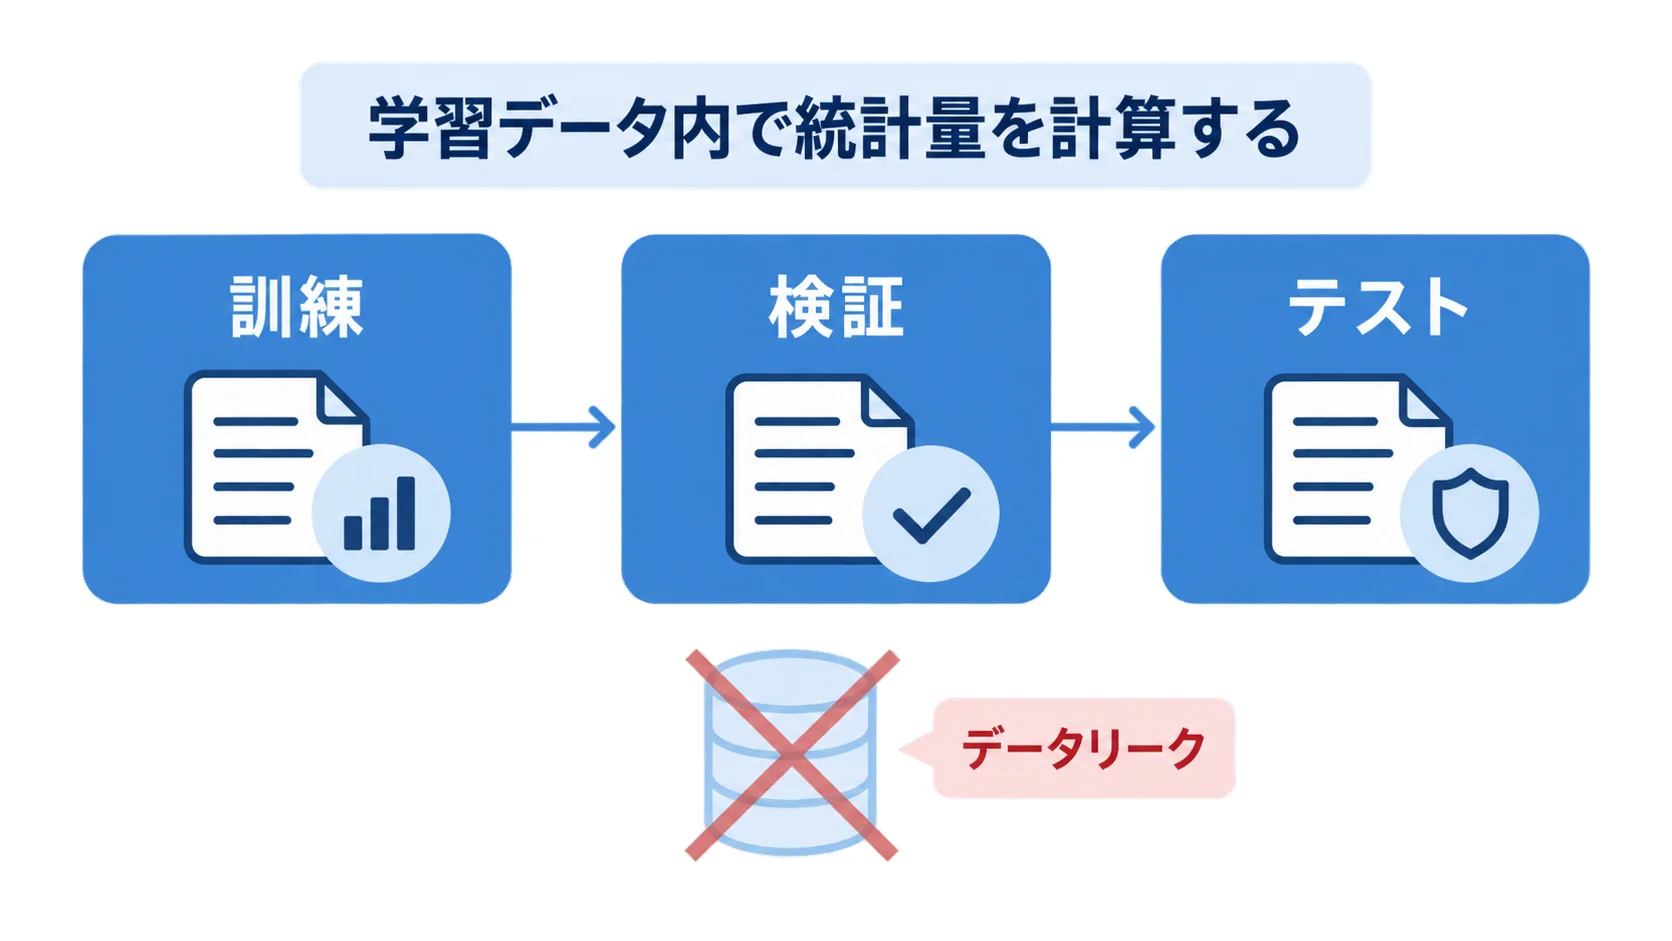
実装で大切なのは、平均や中央値などの補完統計量を全データから計算しないことです。まず訓練・検証・テストに分割し、訓練データだけで補完器を適合させます。
検証やテストには、訓練データから得た統計量を適用します。全データの中央値を使うと、評価データの分布を学習側に見せることになり、データリークにつながります。
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder

numeric_pipe = Pipeline([
    ("imputer", SimpleImputer(strategy="median", add_indicator=True)),
])
category_pipe = Pipeline([
    ("imputer", SimpleImputer(strategy="most_frequent")),
    ("encoder", OneHotEncoder(handle_unknown="ignore")),
])
preprocess = ColumnTransformer([
    ("num", numeric_pipe, numeric_columns),
    ("cat", category_pipe, category_columns),
])
上のコードは、scikit-learnのパイプラインに数値列とカテゴリ列の補完を組み込む例です。実際には、この前処理器を推定器と一緒にパイプラインへ入れ、交差検証の各学習分割で適合させます。
テストでは、カテゴリ列の最頻値が存在しない場合や、予測時に未知のカテゴリを受け取る場合の動作も確かめます。あわせて、列名、列順、欠損を表す記号を入力契約として固定しておきます。
補完方法の評価|人工欠損と業務指標の組み合わせ
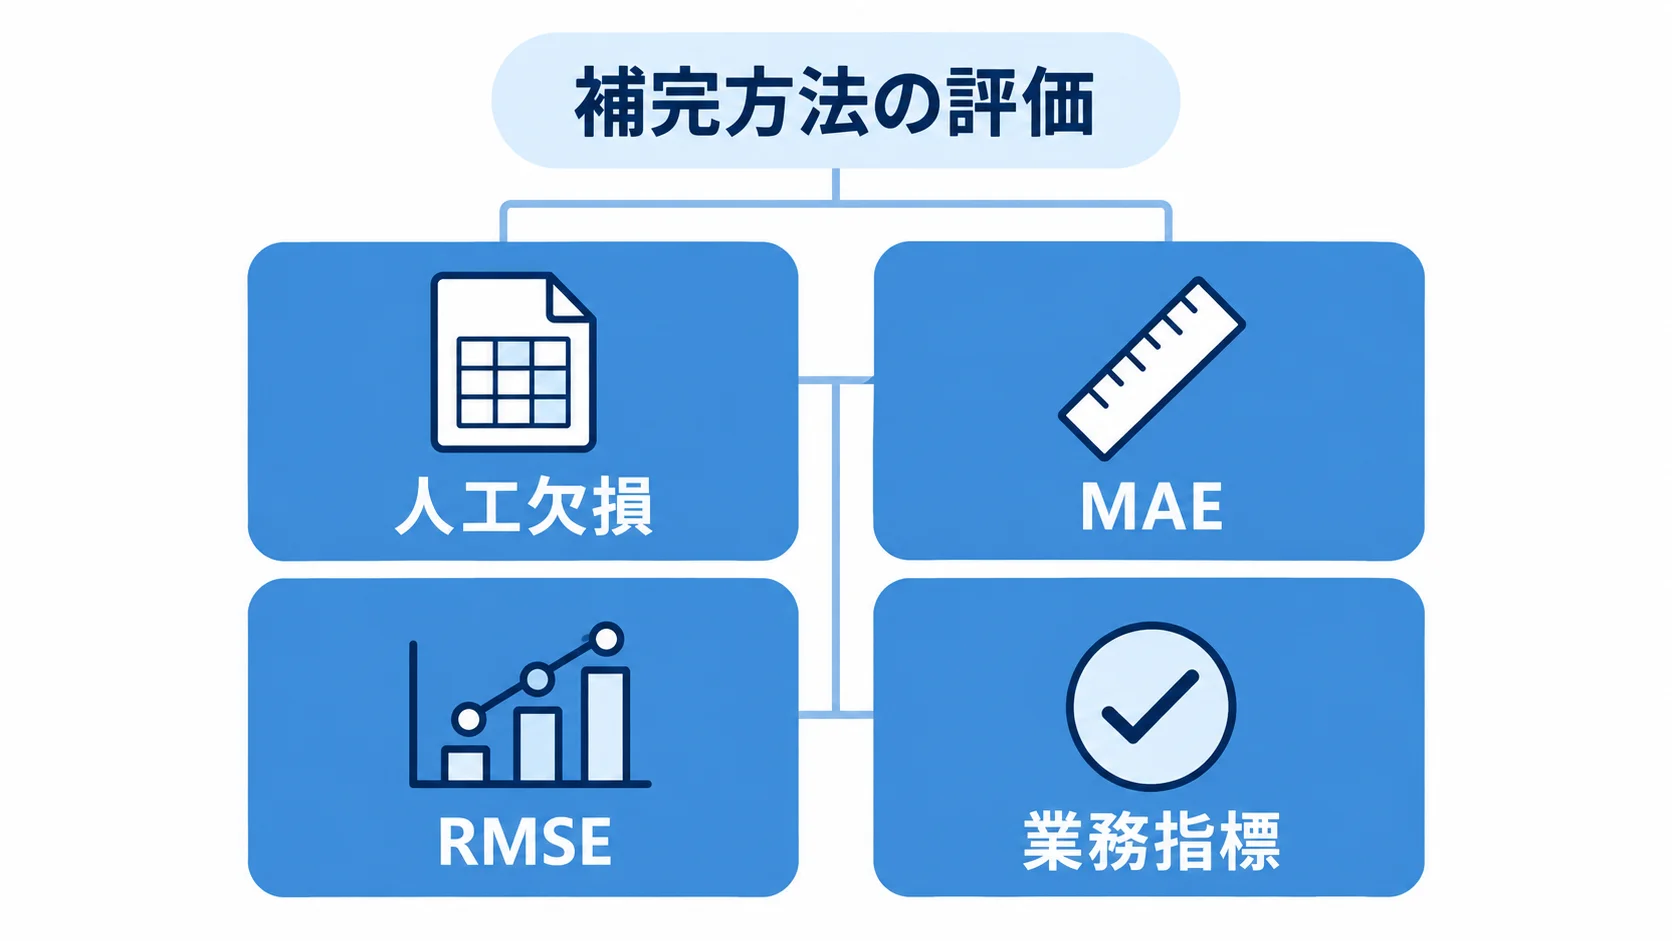
真の値が分からない欠損は、そのままでは採点できません。そこで、観測済みの値の一部を隠して人工的な欠損を作り、補完値と元の値を比べる方法があります。
数値の誤差はMAEやRMSEで測り、カテゴリでは正解率やF1などを使います。ただし、人工欠損が実際の欠損の仕組みを再現しているとは限らないため、欠損率や属性別のパターンを変えた複数の条件で評価します。
補完の誤差だけでなく、最終的な目的への影響も確認します。具体的には、補完後に作る予測モデルの検証指標と集計値の差を比べます。さらに、意思決定の誤りや、担当者が確認できる件数も比較します。
中央値補完の誤差が小さくても、顧客ランクの境界を誤るなら業務上は不適切です。モデル性能と業務指標を併記し、採用理由を説明できるようにしておきます。
欠損値補完の運用|分布の変化の監視と再学習
本番では、欠損率が変わるだけでモデルの入力分布が変わります。そのため、列ごとの欠損率と欠損フラグの割合を、日次や週次で監視します。あわせて、補完後の値の分布やカテゴリの未知値件数も見ておきます。
たとえば、あるセンサーが停止したり入力画面が変わったりして欠損が急増した場合は、補完器を更新する前に、データ取得の原因を直すほうが効果的です。
再学習のときは、補完器と予測モデルを同じバージョンで保存します。とくに、補完統計量だけを別に更新すると、過去の予測を再現できなくなるおそれがあります。
実験記録には、学習期間と除外条件を残します。欠損率、補完戦略、評価結果もあわせて記録しておきます。これにより、担当者が変わっても処理を追跡できます。
欠損値補完まとめ|埋める前に決めておくこと
欠損値補完では、欠損の原因と業務上の意味を確かめたうえで、削除、代表値、K近傍法、反復推定、専用カテゴリなどを比べて選びます。空欄を機械的に埋める作業とは違います。
数値列では分布と外れ値、カテゴリ列では最頻値への偏り、補完によって失われる欠損情報を考慮する必要があります。
実装では訓練データだけで補完器を適合させ、検証・テストへ情報が漏れないパイプラインを作ります。人工欠損による誤差評価と、最終モデルや業務指標への影響を併用し、本番では欠損率と補完値の分布を監視します。
補完値を実測値と同じように扱わず、推定であることを記録に残すことが、再現性と説明責任につながります。
よくある質問(FAQ)
Q. 欠損値補完とは何ですか?
欠損値補完とは、未観測の空欄を平均、中央値、最頻値、推定モデルなどで置き換え、分析や機械学習で扱える形にする処理です。補完値は実測値ではないため、方法と件数を記録します。
Q. 平均値と中央値はどちらを使うべきですか?
外れ値が少なく分布が対称なら平均値、外れ値や歪みがあるなら中央値を出発点にします。最終的には、人工欠損による誤差と補完後の業務指標を比べて決めます。
Q. 欠損値補完でデータリークを防ぐには?
訓練データだけで平均や中央値などの統計量を計算し、検証・テストにはその統計量を適用します。前処理器をモデルのパイプラインに含めると、分割ごとの適合を管理しやすくなります。
Q. 欠損フラグは追加したほうがよいですか?
欠損した事実に予測上の意味がある場合は、欠損フラグを追加すると情報を残せます。ただし、予測時点で取得できない情報をフラグに含めないことと、フラグ追加の有無を検証データで比較することが必要です。
Q. 欠損行を削除してはいけませんか?
欠損率が低く、欠損が結果に偏っていないなら、削除が適切な場合もあります。欠損率や属性別の偏りを確認し、削除と補完の両方で結論が変わらないか感度分析を行って判断します。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブックをダウンロードできます。
参考資料
本文の内容を確認するために参照した資料を挙げます。
- scikit-learn User Guide「7.4. Imputation」
公式ページ - scikit-learn「SimpleImputer」
公式ページ - scikit-learn「KNNImputer」
公式ページ - scikit-learn「IterativeImputer」
公式ページ - scikit-learn「Pipeline」
公式ページ
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。