
モンテカルロ木探索(MCTS)は、意思決定を木構造で調べ、シミュレーションで将来の報酬を見積もって有望な行動を選ぶ方法です。MCTSは、すべての未来を列挙する代わりに、限られた計算時間を有望な枝へ配分します。囲碁や将棋のほか、計画や組合せ最適化にも応用されます。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」をダウンロードできます。で詳しく解説しています。
木の部分探索で次の行動を選ぶMCTSの仕組み
探索では、根ノードを現在の状態とし、エッジを行動、子ノードを行動後の状態とする木を作ります。各ノードには訪問回数と価値の統計を保存し、計算予算の範囲で探索を繰り返します。そのうえで、訪問回数が多い行動や、推定価値が高い行動を根から選びます。
4段階の繰り返しによる探索の深まり
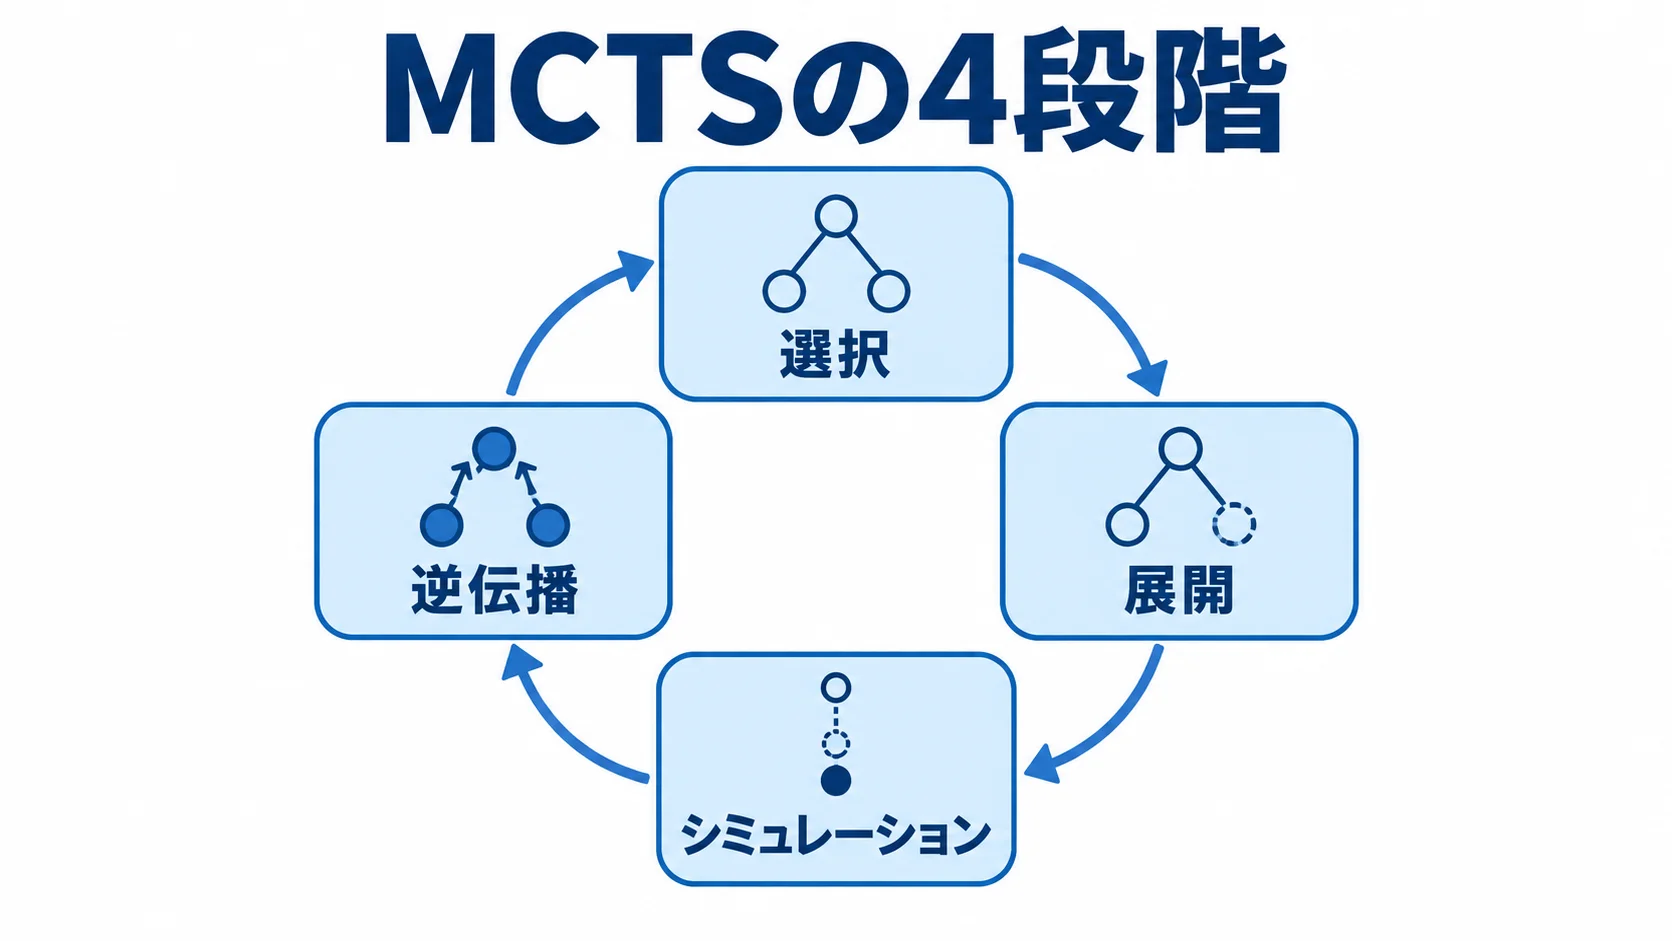
探索は、次の4段階を繰り返して進みます。このうち、選択、展開、シミュレーションの3段階は、確認したい観点です。
- 選択:根から探索指標の高い子をたどり、未展開のノードまで進みます。
- 展開:可能な行動の一部またはすべてを、子ノードとして追加します。
- シミュレーション:終端または一定の深さまで進め、報酬や価値を得ます。
- 逆伝播:得た価値を経路上のノードへ戻し、統計を更新します。
シミュレーションはランダムな行動でも行えますが、ドメイン知識や方策ネットワークを使うと、有望な枝を見つけやすくなります。
終端の判定や引き分け、無効行動、割引率の扱いは、探索全体で一貫させます。
UCTによる探索と活用のバランス
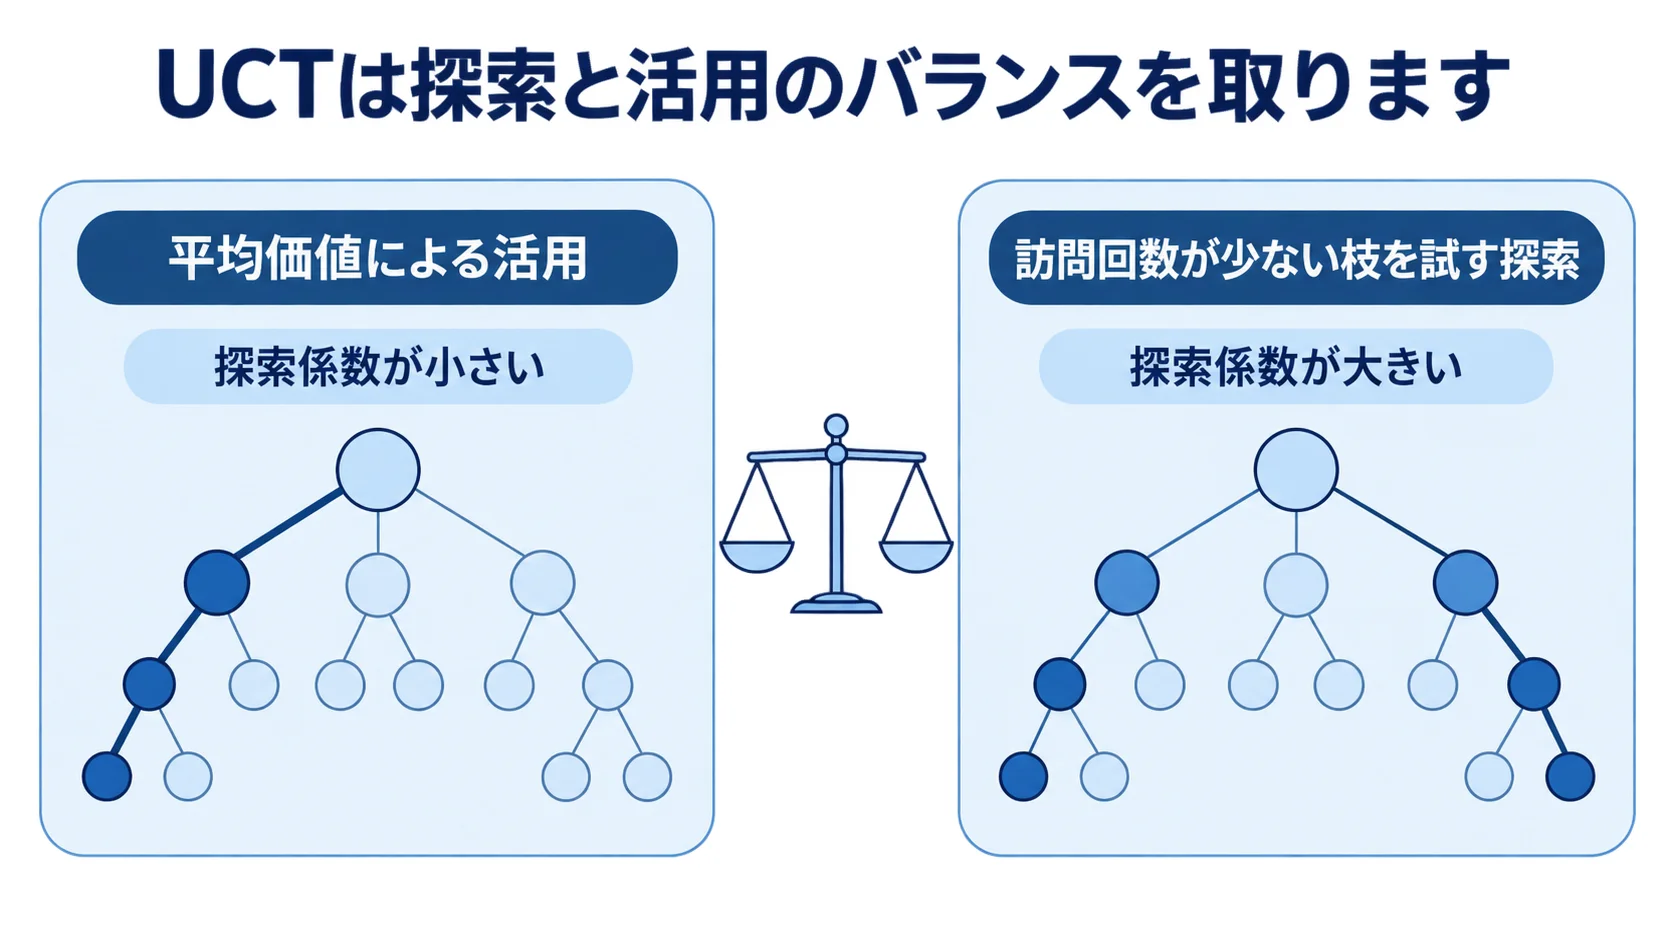
既に価値が高いと分かっている枝だけを選び続けると、未知の有望な枝を見落とします。そこで、UCTは平均価値による活用と、訪問回数が少ない枝を試す探索項を組み合わせます。
探索係数が大きいほど広く試し、小さいほど既知の高価値な枝へ集中します。
未訪問の行動の扱い
訪問回数がゼロの行動には探索ボーナスを与え、少なくとも一度は評価します。ただし、行動数が非常に多い場合は、候補の生成、進行性のある幅制限、方策の事前分布を使って計算を配分します。
ニューラルネットワークによるMCTSの効率化
AlphaZero系の方法では、ニューラルネットワークが各状態の行動事前分布と価値を予測し、MCTSの展開と評価を支援します。また、完全なランダムプレイアウトによるシミュレーションを置き換え、探索の結果を学習データとして、方策と価値を更新します。
実装の例には、Google DeepMindのmctxがあります。AlphaZeroやMuZeroなどのMCTSアルゴリズムをJAXで実装するライブラリです。
ネットワークの予測が偏ると、探索もその偏りを強めます。
そこで、ネットワークなしのMCTSや、方策だけ、価値だけの条件でアブレーションを行い、探索回数と性能の関係を比べます。
MCTS導入時の計算予算と環境モデルの定義
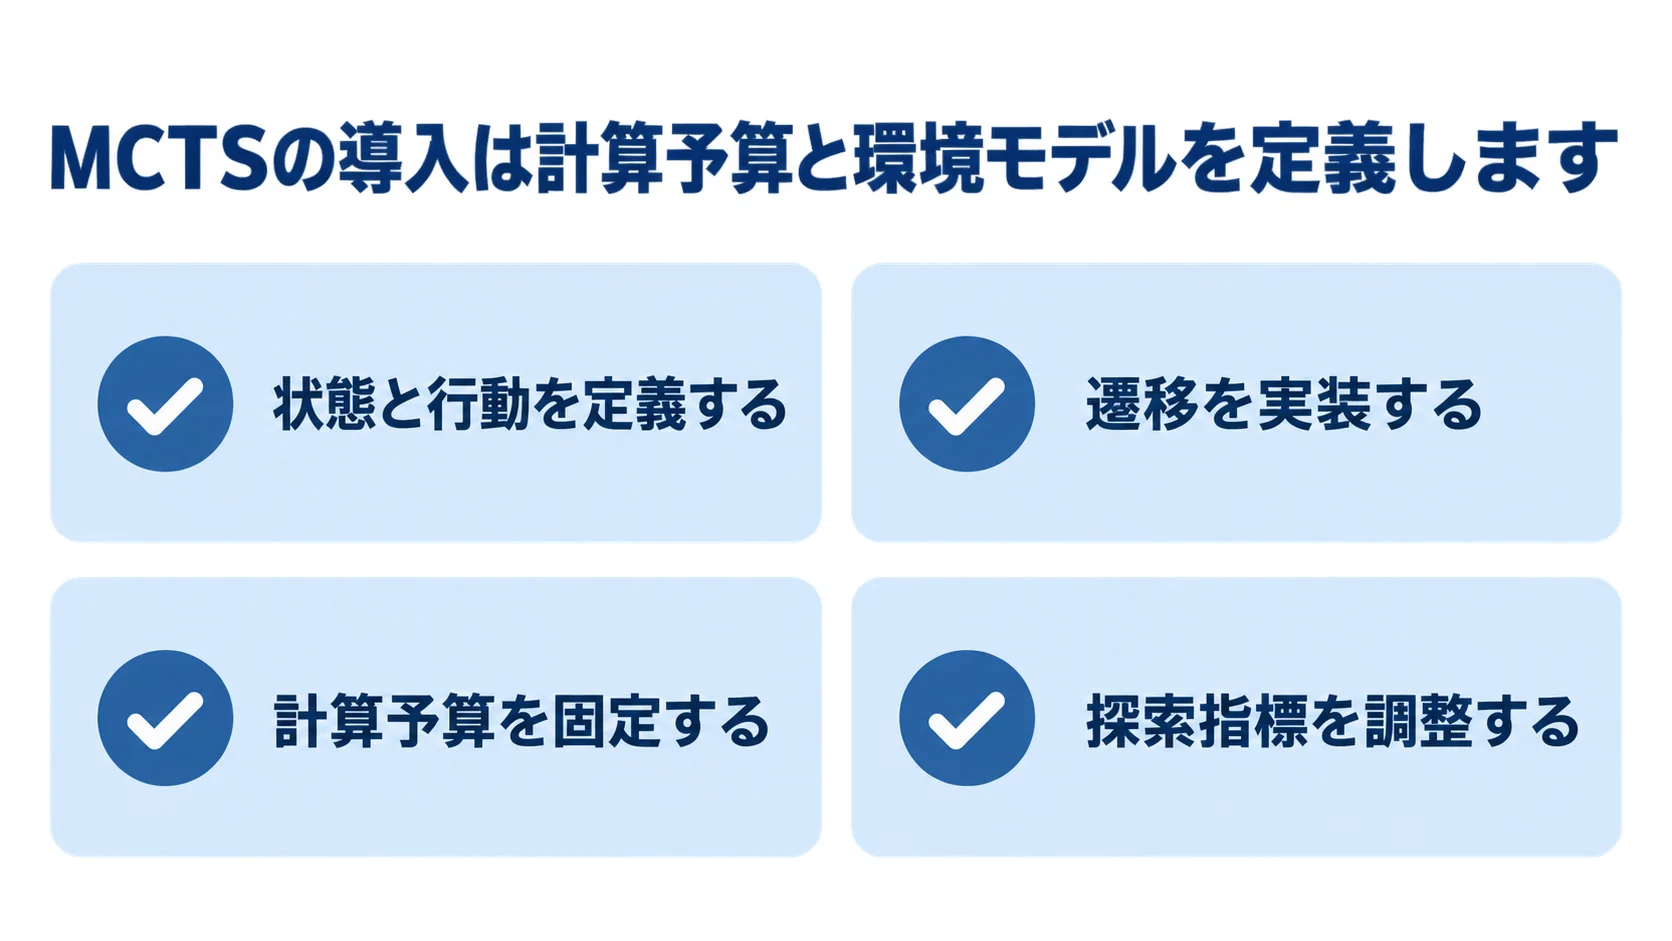
導入では、次のことを順に確認します。
- 状態と行動を定義する:木のノードとエッジに対応する情報と、無効な行動を決めます。
- 遷移を実装する:実環境かシミュレーターで、次の状態を再現します。
- 計算予算を固定する:シミュレーション回数、時間、深さ、メモリを決めておきます。
- 探索指標を調整する:UCTの係数、事前分布、枝刈りの条件を比べます。
- ベースラインと比較する:貪欲法、ランダム、深さ固定の探索と並べて評価します。
導入後は、本番環境での動きも確かめます。
- 本番制約を監視する:時間超過、無効行動、シミュレーターと現実の差に、それぞれ対応します。
勝率と計算効率の両面からの評価
ゲームなら勝率、到達率、相手の強さ別の性能を測ります。一方で、業務計画なら、目的値や制約違反を見るほか、解の安定性や計画の生成時間も測ります。そのうえで、シミュレーション回数や制限時間を変え、計算予算あたりの改善を比べます。
探索木は状態数が増えると急速に大きくなります。そのため、重複状態の検出や転置表、枝刈り、並列化の効果を評価します。また、メモリ上限と遅延上限を監視します。さらに、シミュレーターに誤差がある場合は、現実のログや人手によるレビューで候補を確かめます。
MCTSで起きやすい失敗と対策
シミュレーターの誤差への対策
遷移と遅延を現実に合わせ、相手の振る舞いやコストも見直したうえで、現実のログで候補を検証します。
計算時間の超過への対策
計算時間の超過を防ぐには、時間とメモリの上限を設けます。そのうえで、早期終了や前回の木の再利用、候補の制限を実装します。
事前方策の偏りへの対策
ネットワークなしのベースラインや別の初期化と比べて、探索指標と事前分布を点検します。
限られた計算で有望な未来を探すモンテカルロ木探索
MCTSは、選択と展開、シミュレーション、逆伝播の4段階を繰り返し、探索と活用のバランスを取りながら次の行動を決めます。UCTや方策・価値ネットワーク、枝刈りを使えば、計算を効率化できます。
導入では、環境モデルと計算予算、無効行動を先に定め、時間とメモリの上限も決めておきます。次に、勝率や目的値だけでなく、計算効率、シミュレーターとの差、探索の偏りも評価し、段階的に本番へ移します。
よくある質問(FAQ)
モンテカルロ木探索について、よく聞かれる疑問への答えを、質問ごとに短くまとめます。
Q. モンテカルロ木探索とは何ですか?
候補を木構造で展開し、シミュレーションを繰り返して将来価値が高い行動を選ぶ探索アルゴリズムです。
Q. MCTSの4段階は何ですか?
選択、展開、シミュレーション、逆伝播を繰り返し、ノードの訪問回数と価値を更新します。
Q. UCTは何のために使いますか?
既知の高価値な枝を使う活用と、未探索の枝を試す探索のバランスを取るために使います。
Q. ニューラルネットワークと組み合わせられますか?
組み合わせられます。行動の事前分布と状態価値を予測し、MCTSの展開・評価を効率化します。
Q. 導入時に何を評価しますか?
勝率や目的値に加え、計算時間、メモリ、シミュレーターと現実の差、制約違反を評価します。
参考資料
本文の確認に用いた資料です。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブックをダウンロードできます。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。