
マルチエージェント強化学習(MARL)は、複数のエージェントが同じ環境で行動し、協調・競争・混合の関係を保ちながら方策を学ぶ強化学習です。
協調と競争の仕組み、学習方式、環境設計、評価と導入時の注意点を押さえると、複数の意思決定主体を扱う基本と課題が見えてきます。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
MARLで同時に扱う複数の意思決定主体
各エージェントは観測を受け取り、行動を選び、その結果として報酬と次の観測を受け取ります。
MARLは報酬の関係によって、全員が同じ報酬を最大化する協調型、利得が対立する競争型、個別報酬と共通報酬が混ざる混合型に分けて考えます。
MARLの仕組みは、自動運転、ロボット群、ゲーム、物流、電力、交渉などで利用できます。
PettingZooは、一般的なMARL問題を表現するAPIを提供しています。
順番に行動するAEC APIと、同時行動のParallel APIの2種類があります。
集中学習と分散実行の使い分け
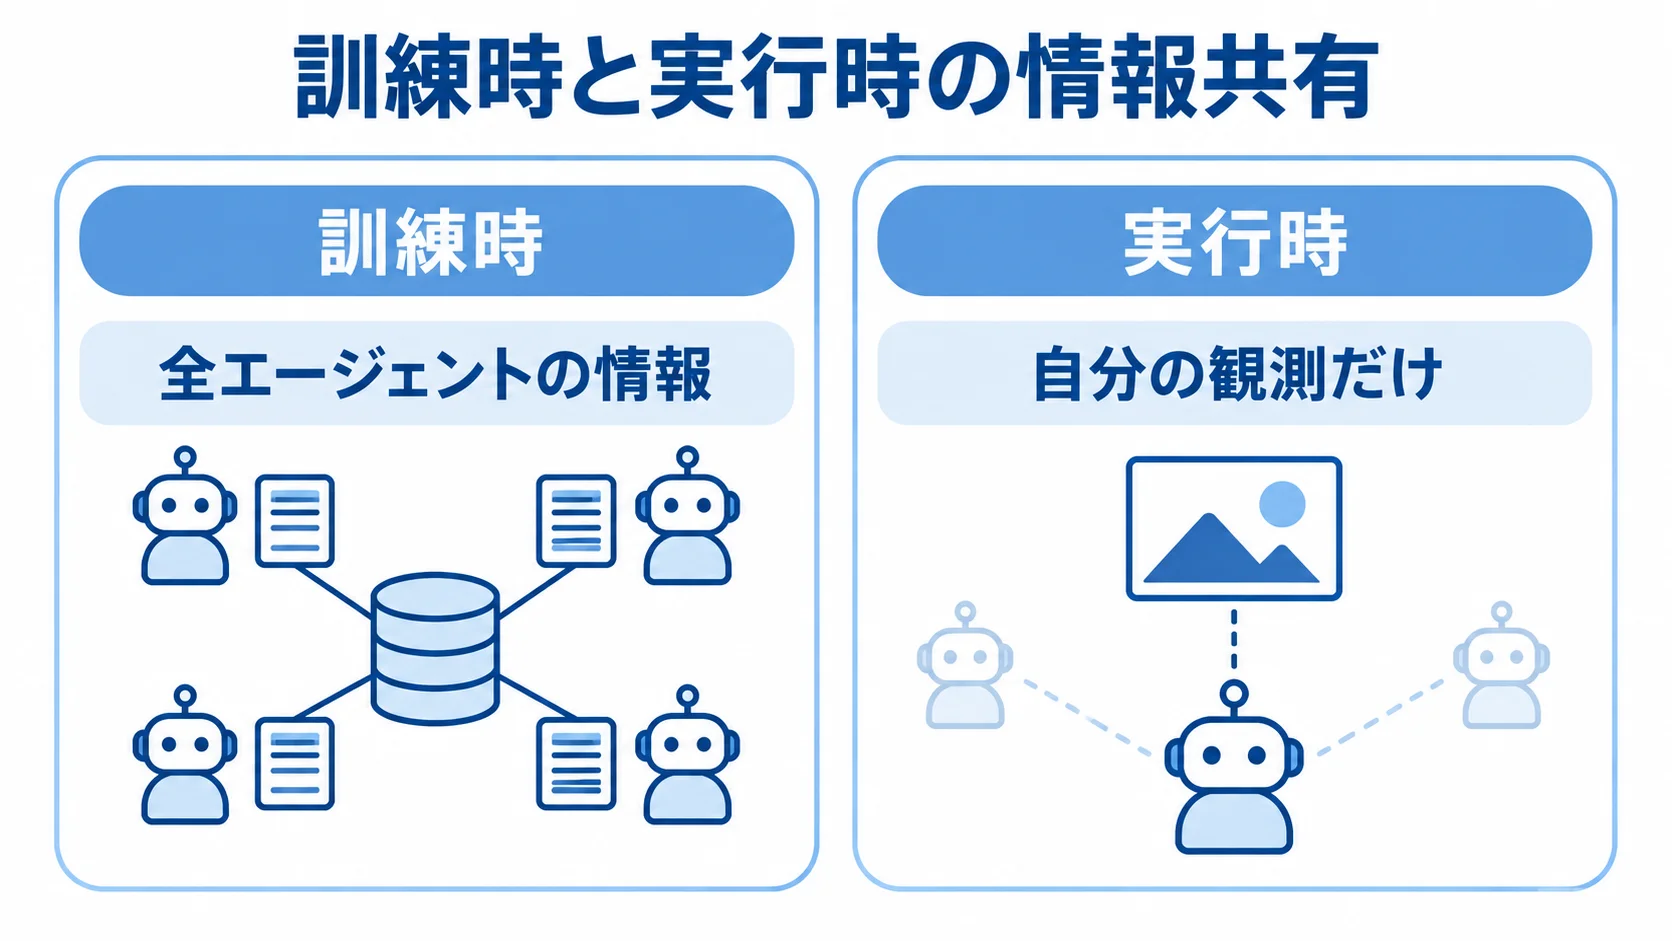
集中学習・分散実行(CTDE)では、訓練のときだけ全エージェントの情報を批評家に渡します。
実行時は、各エージェントが自分の観測だけを使って行動します。
この構成は学習を安定させやすい一方で、本番では使えない情報を実行時に混ぜない設計が必要です。
他エージェントの学習による環境の非定常性
単一エージェントでは環境の分布を固定しやすい一方、MARLでは他エージェントの方策が更新されるたびに、同じ行動の結果が変わります。
経験再生で蓄えた古いデータが、現在の環境と合わなくなることがあります。
この問題には、更新の同期、相手方策の記録、集中批評家などの対策を検討します。
MARLの学習方式と情報共有の違い
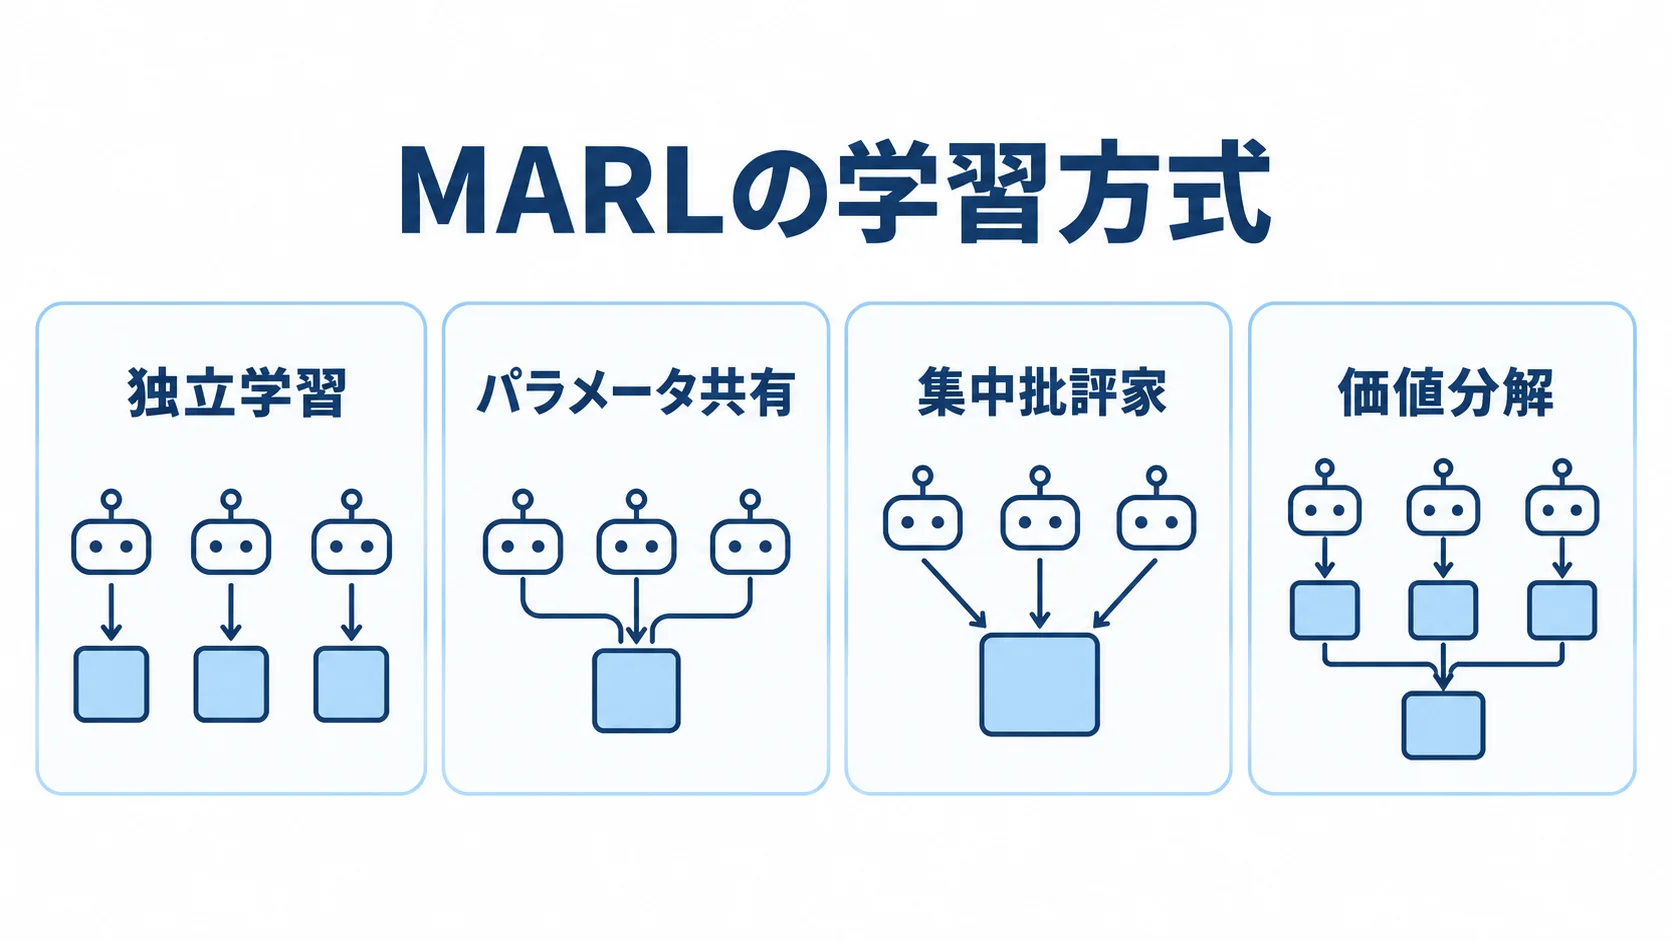
MARLの学習方式は、情報や方策の共有方法によって異なります。方式ごとの特徴を比べると、環境条件に合う構成を選びやすくなります。
- 独立学習:各エージェントが個別に、単一エージェント向けのアルゴリズムで学ぶ方式
- パラメータ共有:同じ役割のエージェントどうしで方策ネットワークを共有する形
- 集中批評家:訓練中は全体情報で価値を評価し、実行時の方策は分散させる仕組み
- 価値分解:チーム価値を個別価値の組み合わせに分解する考え方
- 自己対戦:過去の方策や相手との対戦で、競争環境を作る進め方
方式を選ぶときは、エージェントの同質性と通信の可否、共有報酬を確認します。役割が変わるかどうかも、あわせて見ておきます。
とくに、学習時に全情報を使えても、本番で同じ情報を取得できるとは限らない点に注意が必要です。
環境APIと報酬設計の事前設定
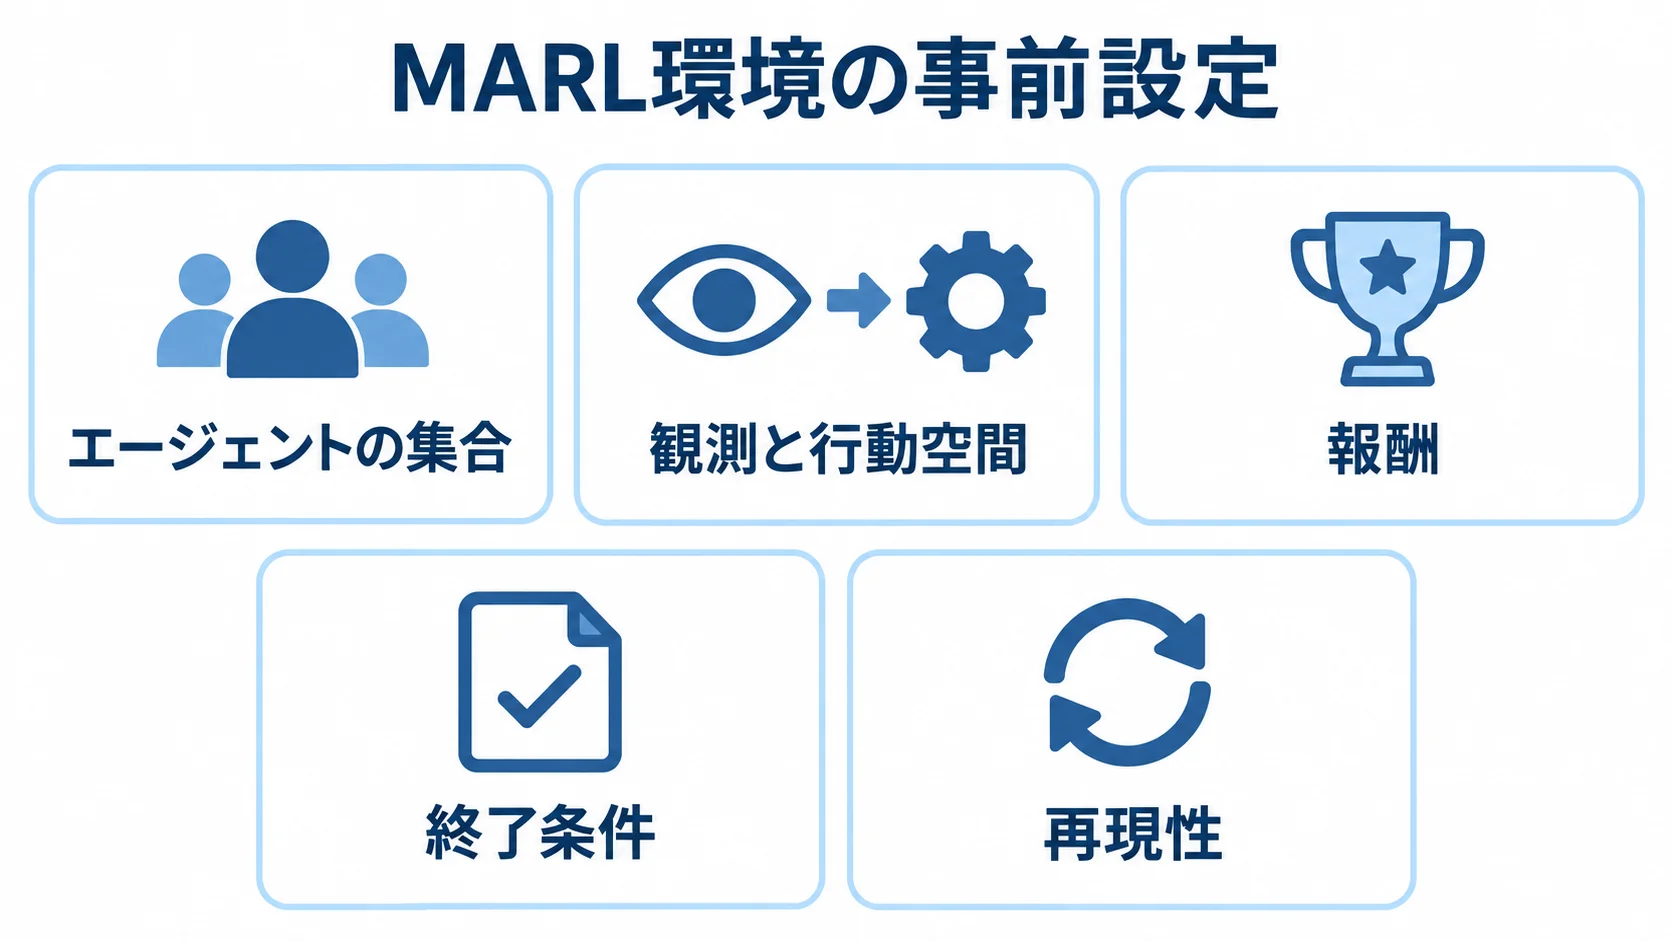
MARL環境では、エージェントの行動順や観測範囲、報酬の与え方をそろえておく必要があります。再現性を保つため、次の設定を先に決めておきます。
- エージェントの集合:参加と離脱、行動の順番、同時行動の扱い、役割
- 観測と行動空間:各エージェントが見られる情報と、実行できる操作の区別
- 報酬:個別報酬と共有報酬、制約違反、協調の成果の扱い
- 終了条件:成功、失敗、時間切れ、エージェント脱落の扱い
- 再現性:環境バージョン、乱数、初期配置の保存
PettingZooのような標準APIを使うと、AECとParallelの違い、終了と打ち切り、エージェントごとの観測を検証しやすくなります。
独自環境では、行動の順序、報酬の帰属、無効な行動、脱落したエージェントの処理を単体テストで確かめる必要があります。
チーム成果と個別行動を分けた評価
評価では、協調・競争の成果と、条件を変えたときの頑健性を分けて見ます。問題の種類ごとに、次の指標を使い分けます。
- 協調問題:チーム報酬と成功率、完了時間、資源利用の状況
- 競争問題:勝率に加えて、相手の方策が変わったときの頑健性
- 個別の影響:個々の貢献度と負荷、公平性、安全、資源配分
エージェント数や初期配置、相手、通信条件を変えたうえで、複数のシードで評価します。
平均値が高くても、一部のエージェントが極端な不利益を受けることがあります。特定の相手にだけ勝つ場合もあるため、個別の制約は業務指標として別に監視します。
MARLで起きやすい失敗と対策
成果への寄与の特定が難しいこと
共有報酬だけでは、信用割当が難しくなります。そのため、個別報酬や差分報酬を用いたり、集中批評家や行動を記録した軌跡と組み合わせたりします。
通信への依存による本番での動作不良
遅延や欠損、帯域制限を、訓練の条件に組み込んでおきます。そのうえで、通信がなくても安全に動く方策や停止条件を用意します。
相手の変化への過剰適応
評価には、過去の方策や複数の相手、未知の初期条件を含めます。特定の相手を覚え込んでいないかも、あわせて確かめます。
マルチエージェント強化学習の要点
MARLは、複数のエージェントが相互作用する環境で、協調・競争・混合の成果を最大化する方法です。集中学習・分散実行や独立学習、価値分解などは、観測と通信の条件を見て選びます。報酬と役割も、選ぶときの条件になります。
評価では、非定常性と信用割当を含めます。通信制約や個別の安全性も、評価の対象に加えます。そのうえで、標準APIと再現可能な環境で検証し、本番では通信断やエージェント脱落、停止・承認を想定した運用を用意します。
よくある質問(FAQ)
マルチエージェント強化学習について、よく寄せられる疑問に短く答えます。
Q. マルチエージェント強化学習とは何ですか?
複数のエージェントが同じ環境で相互作用し、協調や競争を含む方策を学ぶ強化学習です。
Q. 集中学習・分散実行とは何ですか?
訓練時は全体情報を使い、実行時は各エージェントが自分の観測だけで行動する方式です。
Q. PettingZooは何に使いますか?
MARL環境を標準的なAPIで実装・検証するために使います。順番行動と同時行動のAPIを提供します。
Q. 何を評価すればよいですか?
チーム報酬と成功率、個別の負荷に加えて、条件が変わったときの結果も測ります。その対象を、次の項目に示します。
- 公平性
- 通信条件
- 相手や初期状態の変化
- 複数シードのばらつき
Q. 本番導入で注意することは何ですか?
通信断やエージェント脱落、安全制約、停止・承認、旧方式への切り戻しを設計して段階的に導入します。
参考資料
MARL環境のAPIや強化学習の基本を確かめるときは、次の資料が役立ちます。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。