
マルチタスク学習は、一つのモデルで関連する複数のタスクを同時に学習し、共有する表現とタスクごとの出力を組み合わせる方法です。
たとえば、画像からカテゴリと属性を同時に予測したり、推薦でクリックと購入を同時に推定したりします。データの多いタスクの表現を少量データのタスクに生かせる一方、タスク間の競合や損失の重み、ラベル欠損、評価指標の違いが課題です。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」をダウンロードできます。で詳しく解説しています。
マルチタスク学習の基本構成:共有表現と複数の出力
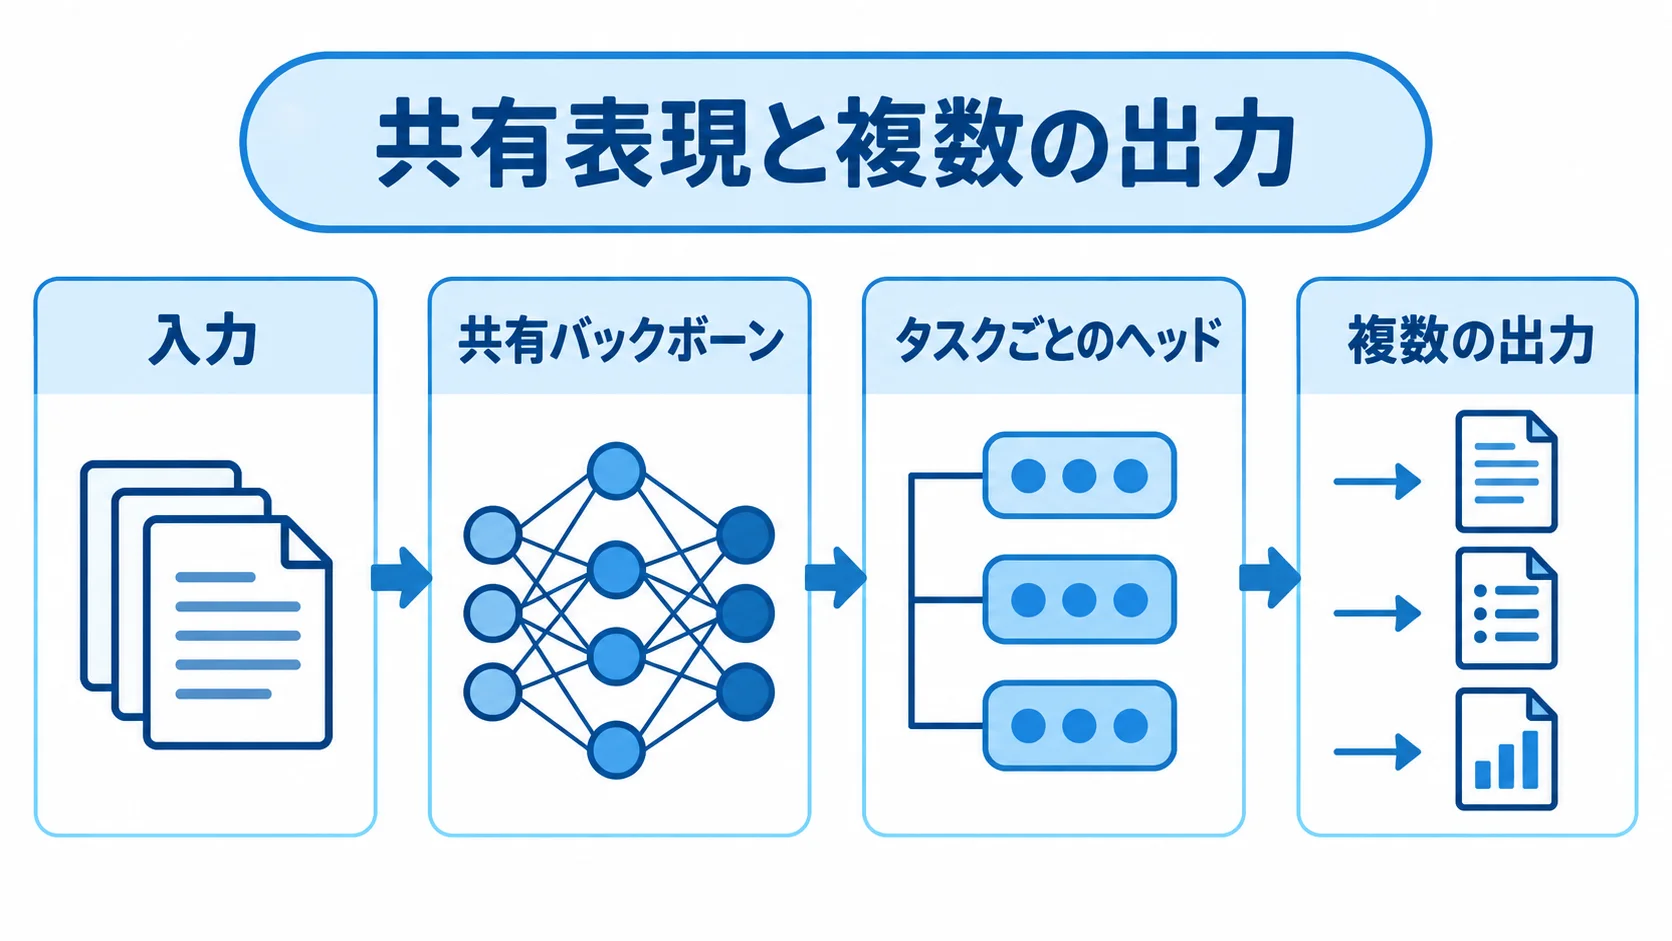
入力は共有バックボーンを通り、タスクごとのヘッドで予測されます。損失は、L=λ1L1+λ2L2のように重み付けした合計で学習します。さらに、Kerasの複数出力モデルでは、出力ごとに損失・指標・重みを指定できます。
共有の強さの設計
ハード共有では、下位層を共有し、上位にタスク別のヘッドを置きます。一方、ソフト共有はタスクごとにネットワークを持ち、重みや表現の距離を正則化します。ただし、関連性の弱いタスクまで共有すると、表現が競合して性能が下がる場合があります。
損失設計:スケールと勾配のそろえ方
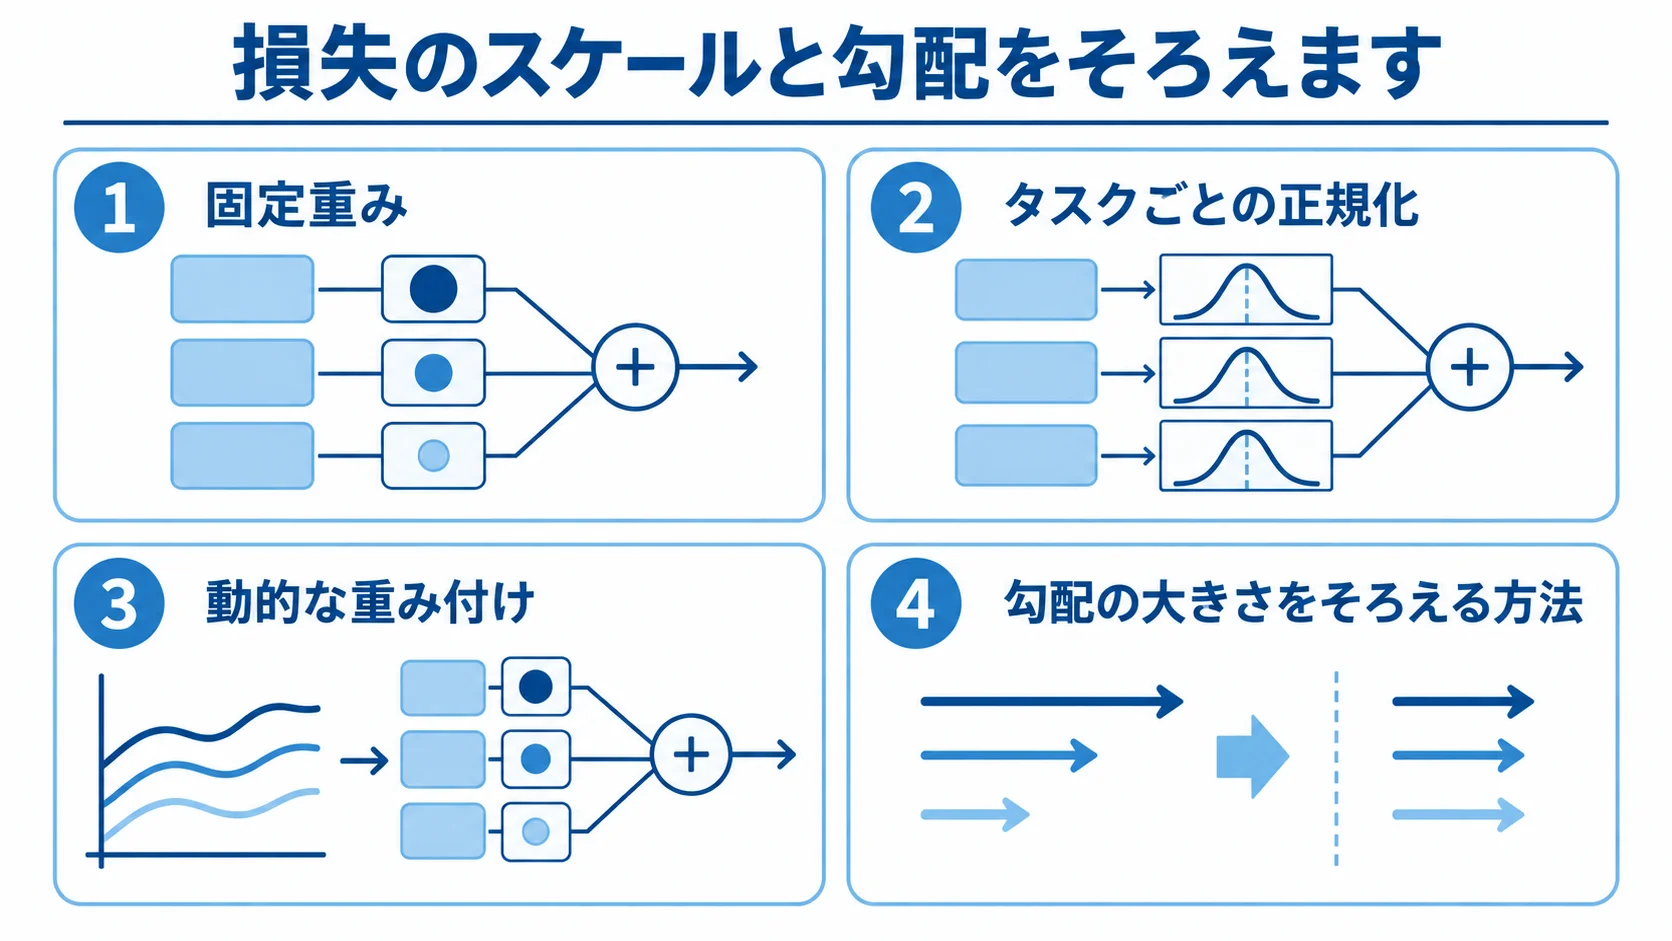
分類の交差エントロピーと回帰の平均二乗誤差では、値のスケールが違います。そのまま合計すると、値の大きいタスクに学習が偏ることがあります。そのため、固定重みやタスクごとの正規化、動的な重み付けを比べ、勾配の大きさをそろえる方法も合わせて見ます。
重みを大きくすると、そのタスクだけが改善して他のタスクが悪化することがあります。そこで、開発会社は、他のタスクが悪化していないかを各タスクの指標で確かめます。
ラベルが欠けているタスクでは、欠損ラベルを誤って負例として扱うと、タスク間の学習が歪みます。そのため、該当するサンプルの損失だけをマスクします。さらに、Kerasの複数出力モデルでも、出力名と損失の対応を明示しておきます。
マルチタスク学習の導入手順
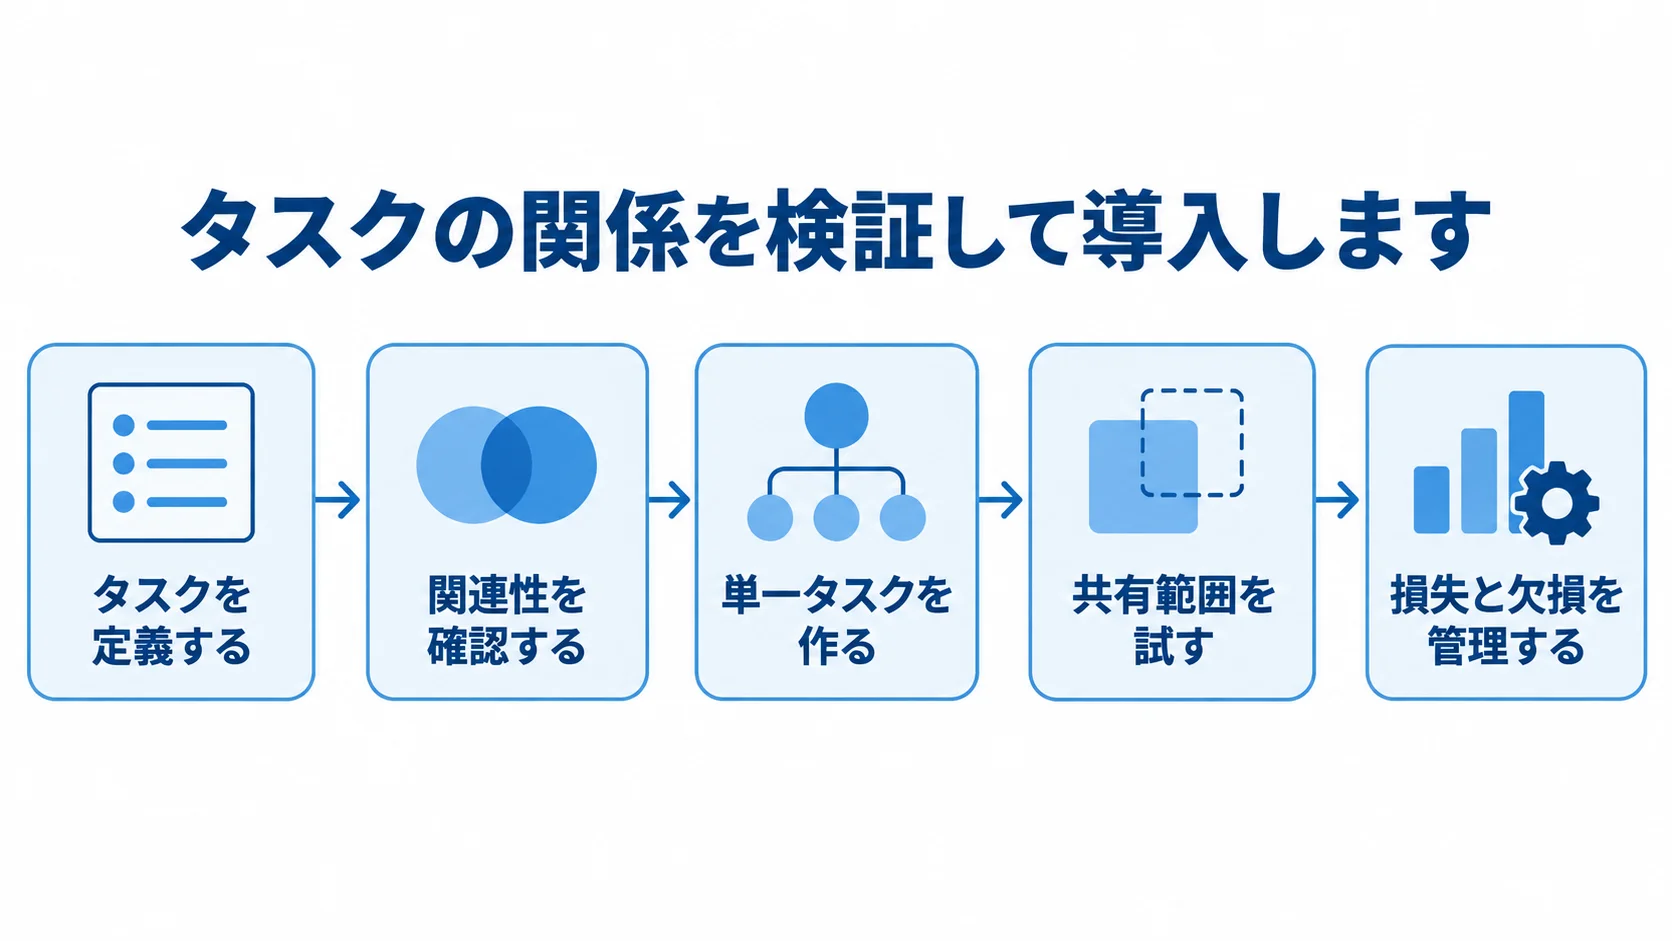
導入を進める前に、タスクを定義し、関連性を確認し、単一タスクを作る順に確認事項を整理します。
- タスクを定義する:目的とラベル、予測時点、業務上の優先度を書き出す。
- 関連性を確認する:入力と誤り、ラベル相関、利用者を比べる。
- 単一タスクを作る:各タスクを単独で学習させたベースライン。
- 共有範囲を試す:共有層、タスク別層、正則化の組み合わせ。
- 損失と欠損を管理する:損失の重みとマスク、勾配、更新頻度の記録。
タスク別と全体の両方での評価
全体の損失だけを見ると、重要なタスクの悪化を見落とすおそれがあります。そのため、各タスクの精度や再現率、MAEなどを、単一タスクのベースラインと比べます。さらに、顧客や期間、少数クラスごとに評価し、ラベル欠損に偏りがないかも確かめます。
マルチタスク学習で起きやすい失敗と対策
タスクの勾配の競合
タスクの勾配が競合すると、性能が下がる場合があります。そこで、開発会社は、タスク別の勾配と指標を確かめ、共有範囲や損失の重みを見直します。
損失の大きいタスクへの偏り
損失の大きいタスクに学習が偏るおそれがあります。そのため、開発会社は、損失の正規化、重み、更新頻度を比べ、業務上の優先度に反映させます。
欠損ラベルの誤った学習
欠損ラベルを誤って学習すると、タスク間の学習が歪みます。そのため、開発会社は、タスクごとのマスクを実装し、ラベルの収集過程と偏りを監査します。
マルチタスク学習の要点:関連タスクの表現の共有
マルチタスク学習は、共有バックボーンとタスク別ヘッドで複数の目的を同時に学習する方法です。データの少ないタスクへ表現を移せる一方で、タスクの競合と損失設計が重要です。
共有する価値があるかは、単一タスクのベースラインとの比較で判断します。タスク別の指標や損失の重みを見るほか、勾配や欠損ラベル、業務上の優先度も確認します。
よくある質問(FAQ)
マルチタスク学習について、よくある疑問に答えます。
Q. マルチタスク学習とは何ですか?
一つのモデルで関連する複数のタスクを同時に学習し、表現やデータを共有する方法です。
Q. どの層を共有しますか?
基本は、下位層を共有して上位にタスク別のヘッドを置く方法です。ただし、共有する範囲は、タスクの関連性を見て比べます。
Q. 損失の重みはどう決めますか?
開発会社は、損失のスケールや勾配を比べ、業務上の優先度と検証指標も踏まえて決めます。
Q. タスクごとにラベル数が違っても使えますか?
使えます。欠損ラベルの損失はマスクして学習から外し、タスクごとのデータ量と偏りを評価します。
Q. 単一タスクより必ず良くなりますか?
良くなる場合もあれば、タスクの競合で悪化する場合もあります。そのため、単一タスクのベースラインと比べて確かめます。
参考資料
本文の内容を確かめるために参照した資料です。
- Keras「Training & evaluation with the built-in methods」
- Keras RS「Multi-task recommenders」
- Keras「The Functional API」
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブックをダウンロードできます。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。