
Nagiosのシステム開発は、業務への影響を整理し、製品と監視範囲を選んだうえで、設計、試験、段階的な導入、運用定着の順に進めます。この順で進めると、監視を業務に活かせる状態になります。
▼全体ガイドの記事
・Nagiosのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Nagiosのシステムの全体像
Nagiosは、機器からアプリまでの状態を定期的に確認し、異常を知らせるITインフラ監視システムです。確認の対象は、サーバーやネットワーク機器、Webサイト、データベース、ミドルウェア、業務アプリなどです。
Nagiosの役割は、業務システムを支える基盤の可用性と障害の兆候を見張ることです。ERPや販売管理のように業務データを扱う製品とは役割が異なるため、開発の範囲を整理しやすくなります。
Nagios CoreとNagios XIの役割と運用負担の違い
CoreとXIは、監視の作り方も運用の負担も異なります。利用範囲と担当体制に合わせて、次の違いを見比べます。
- Coreの監視:無償のオープンソース監視エンジンで、Linux上に配置し、プラグインでホストやサービスを確かめます。
- Coreの確認範囲:Ping・HTTP・TCP・SSH・SNMPなどを確認。
- XIの機能:Web GUI、設定ウィザード、ダッシュボード、レポート、API、ユーザー管理を備えた商用版です。
- XIのFree版:7ノードまたは100サービスのうち、どちらか早い方まで。
Coreでは、シェル、Python、Perlで独自プラグインを作れば、業務バッチやAPIも監視できます。ただし、設定ファイルや権限、通知ルールは自社か委託先が維持します。さらに、バックアップとアップデートも維持の対象です。
2026年の価格は、Standardが100ノードで2,595ドル、300ノードで6,195ドル、1,000ノードで14,995ドルです。また、Enterpriseは100ノードで4,690ドル、1,000ノードで17,090ドルです(出典: Nagios Enterprises「Nagios XI」、2026年確認)。
価格は為替や税、販売経路によって変わります。そのため、見積もりではライセンスと導入作業を分けて見ます。
監視対象から通知までの責任範囲
状態判定から通知・復旧までの構成と、導入効果を測る指標を、順に並べて考えます。
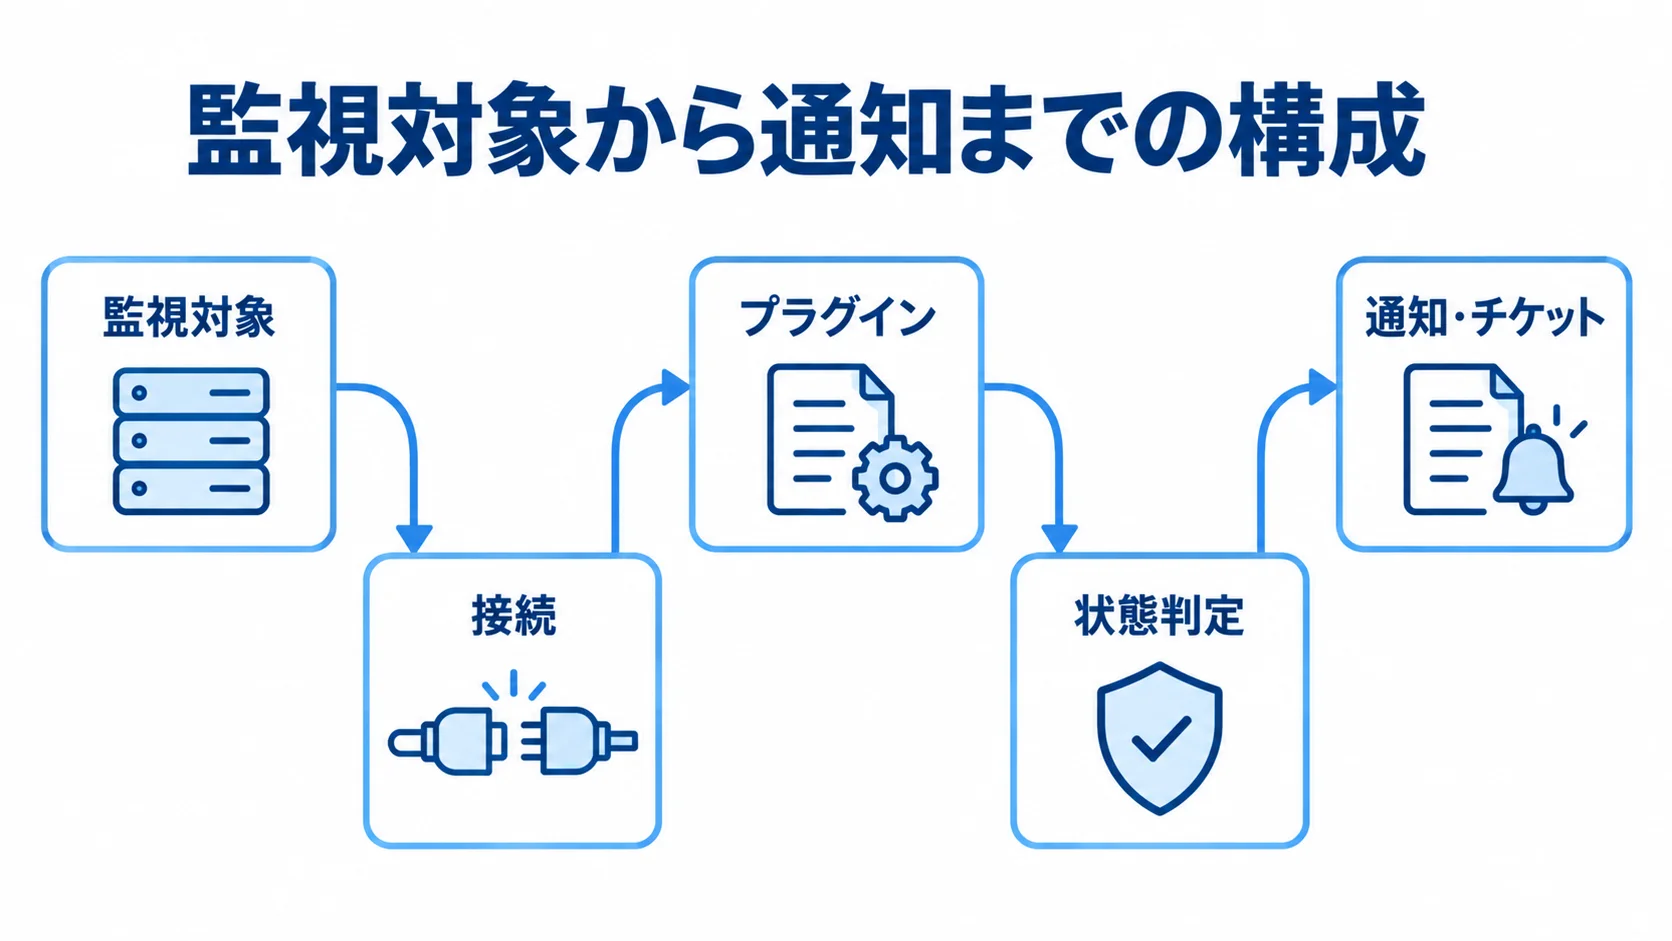
- 基本構成:監視対象、接続(エージェントやSNMP・HTTPなど)、プラグイン、Nagios、状態判定、通知・チケット、画面やレポート。
- 接続と判定:エージェントやSNMP・HTTPで接続し、OK・WARNING・CRITICAL・UNKNOWNのいずれかで判定します。
- 通知設計:何回連続で異常なら通知するか、復旧時に誰へ連絡するかを定めます。
- 分散構成:多拠点やクラウド・オンプレミス混在では、拠点ごとに監視ノードを置き、NRDPやリモートワーカーなどで結果を中央に集約。
- 効果測定:障害検知までの時間、誤検知率、通知から一次対応までの時間、MTTR、SLA違反件数、設定変更リードタイム、監視基盤自身の可用性で測ります。
Nagiosのシステム開発の進め方
Nagiosは、要件整理、選定、設計開発、テスト、稼働、定着の6フェーズで進めます。段階ごとに区切って進めると、製品選びや運用設計の抜けを抑えられます。
各段階では、成果物と終了条件を決め、次の段階へ進む状態を発注側と開発会社で合意します。全台を一括で登録せず、5〜20台程度のPoCから始めて、重要業務、全社環境へと広げていきます。
フェーズ1:監視対象と業務影響の洗い出し
まず、停止したときにどの業務が何分止まるか、誰が一次対応するか、時間外に通知する必要があるか、目標とする復旧時間を確かめます。次に、監視対象の重要度も分けて洗い出します。
- 対象:サーバー、機器、DB、バッチ、API、クラウド、重要画面の一覧。
- 影響と対応:停止時の業務と時間、一次対応者、時間外通知、目標復旧時間。
- 重要度と成果物:即時連絡、予兆検知、日次レポートに分け、対象一覧、業務影響マップ、通知先一覧、夜間当番表を作成。
- 監視条件:確認方法、閾値、再試行、通知、保守時間、保持期間、責任者の記録。
- 運用上の確認:現行監視との重複、MUST・WANT、監視基盤のバックアップ、障害時の連絡経路、ログに個人情報や秘密情報が含まれる可能性。
台数だけで決めると、重要な業務APIが漏れたり、不要なアラートが増えたりします。一方で、早い段階でこれらを確認しておけば、後工程の手戻りも抑えられます。
フェーズ2:運用体制から見るCore・XI・代替製品の選定
無料か有料かだけで決めず、設定変更、脆弱性対応、夜間アラートを誰が担当するかまで比べます。そのうえで、運用担当と設置環境に照らして候補を選びます。
- Core:CLI、Linux、スクリプトに慣れ、監視ロジックを細かく作りたい場合。
- XI:複数担当者でGUI、ダッシュボード、権限管理、レポートや公式サポートを使いたい場合。
- 代替製品:自動検出やメトリクス管理、クラウドネイティブな時系列データなどの要件で比べる候補。
- 運用形態:自社クラウドやオンプレミスへの設置と、マネージド監視の比較。
たとえば、Zabbixは自動ディスカバリーや広いメトリクス管理を重視する場合、PrometheusとGrafanaはクラウドネイティブな時系列データや可観測性を重視する場合に候補になります。
Nagiosを選ぶ場合は、既存プラグインや独自チェック、オンプレミスやデータ主権の要件に合うことを採用理由にします。さらに、PoCでは実データに近い負荷、通知連携、設定変更、バックアップ復元を確かめます。
フェーズ3:設計開発でのチェックと通知のルール実装
監視条件、実装仕様、安全策、変更管理は、セットで決めておきます。
- 監視条件:項目、閾値、再試行、依存関係、通知抑制、エスカレーション、保守時間、SLA、保持期間。
- 通知の調整:ネットワーク機器の停止時に配下のサーバーまで一斉に障害扱いしないよう、親子関係や依存関係を設計。CPU上昇は連続回数と時間帯で判定。
- 独自プラグイン:終了コード、出力メッセージ、タイムアウト、認証方式、入力値を仕様化してから開発。
- 実行時の安全:root権限で実行せず、秘密情報を設定ファイルやログへ平文で出さず、外部コマンドの許可範囲を制限。
- 変更管理:権限、暗号化、連絡先を具体化し、設定変更やロールバックの手順を定める。
Infrastructure as Codeやテンプレートを使う場合は、設定ファイルやコードに加えて、レビュー履歴とロールバック手順も成果物として残します。
フェーズ4:異常・復旧・通知停止まで再現するテスト
画面に表示されるかどうかだけでなく、異常の検知から復旧通知まで確認します。試験では、次の障害を再現します。
- 接続・認証:通信断、認証失敗、監視対象の時刻ずれ。
- 資源・プロセス:ディスク逼迫、CPU高負荷、プロセス停止。
- 業務サービス:DB接続失敗、業務APIの異常応答。
検知から通知、一次対応、復旧通知までの流れを追います。通知経路が複数ある場合は、メール、チャット、チケット管理、PagerDutyなどを対象に、重複通知や通知の順番も試験します。
試験では、監視サーバーやネットワーク、通知先が止まった場合、設定文法のエラー、バックアップからの復元、対象の計画停止についても確認します。
監視基盤が止まったときに気づけるよう、別のインスタンスや別拠点から基盤自身を監視する設計も検証します。
受入条件は、検知時間、誤検知率、通知到達率、復旧通知の到達、復旧手順の完了時間などを数値で定めておきます。登録の完了だけでは、検知や通知の良否は分からないためです。
フェーズ5:小さく始める段階的な稼働
本番は、代表的な環境や重要業務から始めます。PoCで使ったテンプレートを活用し、次の順で広げていくと、アラート疲れや設定漏れを見つけやすくなります。
- 重要業務の監視
- 周辺システムへの拡大
- 全社・全顧客の環境への展開
既存の監視から移す場合は、旧監視をすぐには止めません。一定期間は並行して稼働させ、検知結果と通知の差を比べます。
Nagios公式が紹介するRedpanda Systemsの事例では、異なる5社の環境でパイロットを行いました。チケット、Slack、ダッシュボードとの連携や社内教育を進め、90日かけて段階的に展開したと説明されています。
この事例では、ダウンタイムが38%減ったことや、インシデント対応が45%高速化したことなどが示されています。これは同社の環境での結果で、どの案件にもそのまま当てはまる数値ではありません(出典: Nagios Library「Redpanda Systems」、2025年)。
自社でも、同じ指標を稼働の前後で測り、効果を検証します。
フェーズ6:定着に向けたチューニングと引き継ぎ
運用の見直しと引き継ぎを続け、担当者が替わっても対応できる体制を保ちます。
- 月次確認:検知から一次対応までの時間、MTTR、誤検知率、通知未達、SLA違反、設定変更のリードタイム。
- 監視の調整:閾値と依存関係を見直し、各チェックが業務判断に結びつくかを確かめる。
- 運用資料:手順書、障害対応、監視項目、変更、バックアップ復元、脆弱性対応、教育記録。
- 構築物の引き継ぎ:設定、プラグインのソース、IaC、ライセンス、管理者アカウント。
- 体制と契約:24時間365日対応のときは、内製・委託・共同運用の責任分界とSLAを明記。
Nagiosのシステム開発にかかる費用相場
Nagiosの費用は、監視対象の数やサービス・チェックの数によって変わります。拠点、通知経路、独自プラグインも費用を左右します。また、冗長化、移行、テスト、保守も費用に関わります。
以下に示す導入費は、公開されている設定代行の価格と一般的な開発の人月単価をもとにした、編集部の推定です。税、クラウド利用料、対象側の変更、24時間運用は含まれない場合があります。発注するときは、作業範囲ごとに分けて見積もります。
ライセンス費用の無料版と商用版の区別
Coreはライセンスが無料ですが、導入と運用には別の費用がかかります。一方、XIはノードを基準にした永続ライセンスです。
- Core:ライセンス無料。サーバー、設計、プラグイン、保守、運用工数が必要。
- XI永続ライセンス:Standard 100ノード2,595ドル、Enterprise 100ノード4,690ドル。
- Free版:検証や小規模向けで、ノードが増えた場合は移行費の確認が必要。
- 年次サポート:100ノード2,104ドル、300ノード4,955ドル、1,000ノード11,898ドル。
1ドル150円で換算すると、XIの100ノードは約39万〜70万円になります。ただし、為替や税、契約条件によって、実際の額は変わります。
年次のMaintenance & Supportには、2026年の価格で、製品アップデート、セキュリティパッチ、サポートケースなどが含まれます。価格は今後変わる可能性があります(出典: Nagios Enterprises「Maintenance & Support Plans」、2026年確認)。
なお、更新しない場合は、修正やパッチ、サポートの扱いが変わります。初年度だけでなく、2年目以降を含むTCOで比べます。
規模と連携数で広がる導入・開発費の幅
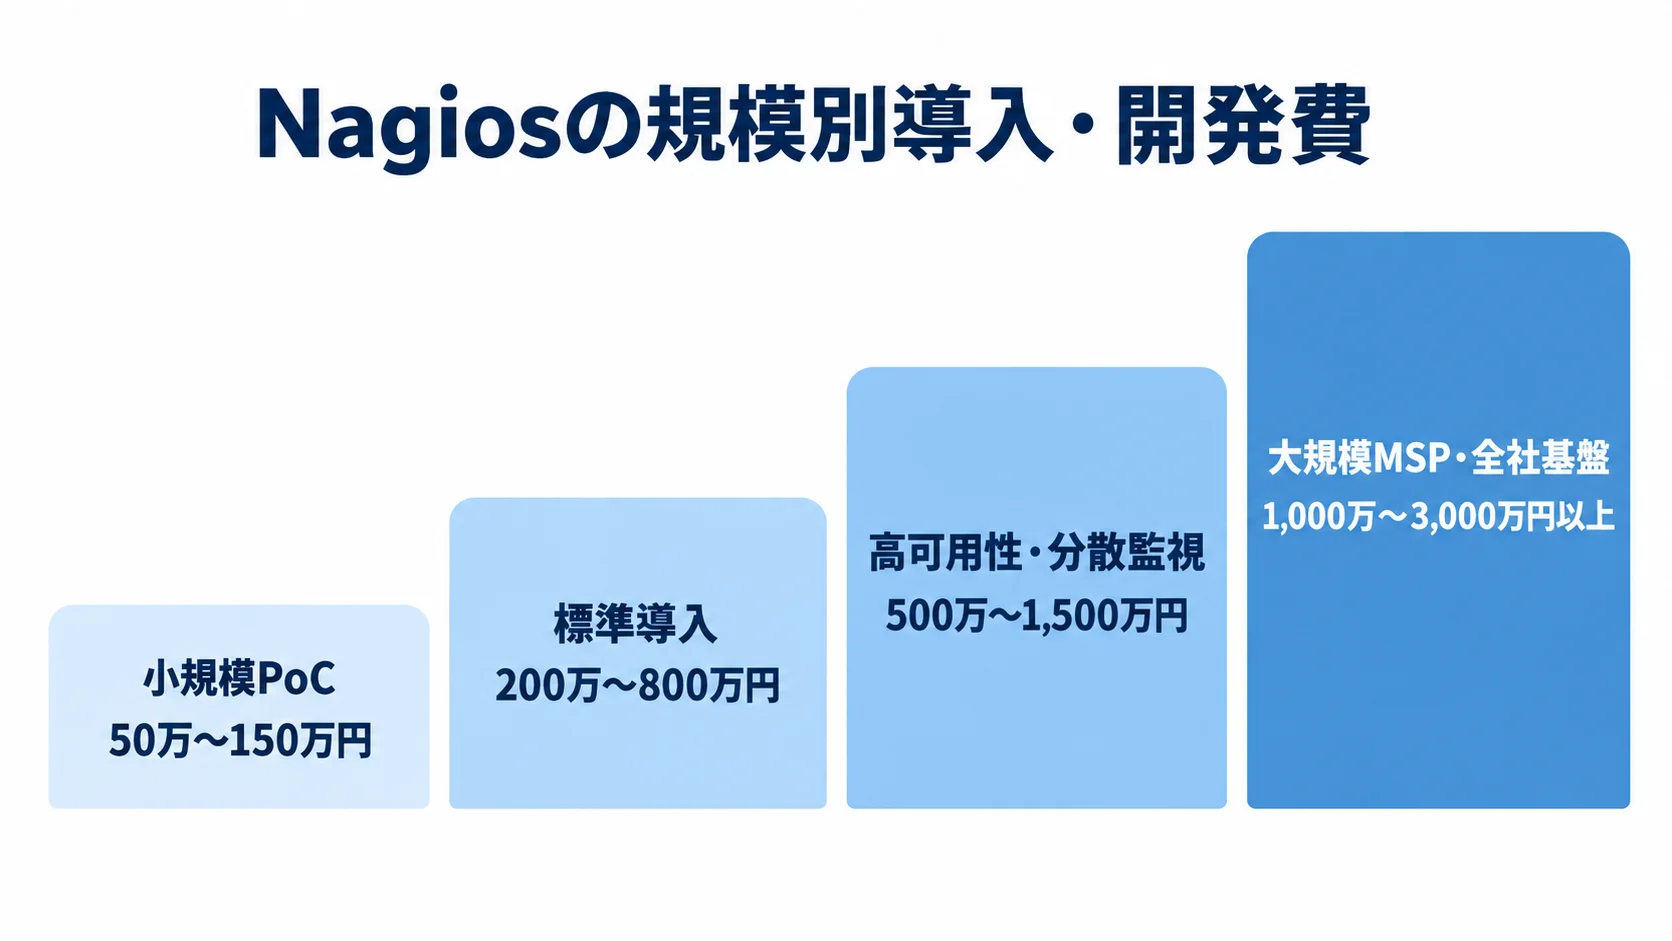
規模別の導入・開発費と期間は、次の推定が目安です。
- 小規模PoC:50万〜150万円、2〜6週間程度。
- 標準導入:200万〜800万円、1〜3か月程度。
- 高可用性・分散監視:500万〜1,500万円、3〜6か月程度。
- 大規模MSP・全社基盤:1,000万〜3,000万円以上、6〜12か月以上の場合あり。
小規模PoCでは、1台にCoreかXI Freeを導入し、10〜50ホストを対象にします。想定しているのは、Ping・HTTP・CPU・ディスクの監視、メール通知、簡易手順書です。
株式会社ロウテクの参考価格は、1台への導入と初期10監視の設定が5万円からです。10監視を超える設定は1監視2,000円から、プラグイン開発は10万円からです。この価格は古いページの参考値で、2026年の受注価格を保証するものではありません。
標準導入は100〜300ノードを想定し、Linux、Windows、ネットワーク機器を監視する構成です。SNMPやエージェント、Slackやチケットとの連携、テンプレート、閾値調整、運用の引き継ぎを含む目安です。
カスタムプラグイン、既存監視からの移行、DR、監査ログ、24時間365日対応まで含めると、費用は上限側へ広がります。
初期費用とは別に見積もる運用保守費
保守の内訳と担当を明らかにしたうえで、初期費用と年間費用を同じ条件で比べます。
- 基盤費:ライセンス更新、クラウド・サーバー、バックアップ、対象側エージェント。
- 運用費:通知、脆弱性対応、プラグイン改修、閾値調整、障害対応、教育。
- 見積もり条件:ホスト・サービス・プラグイン数、通知先、月次レビュー、対応時間、SLA、除外作業。
一般の業務システムでは、初期費用の15〜25%を年次の保守費の目安とする考え方があります。ただし、24時間365日の一次対応や多拠点の変更を委託する場合は、この比率だけで判断せず、対応時間と回数を明細にします。
Coreは初期ライセンス費がかからないため、設計、設定、更新の担当が見えにくくなりがちです。「監視設定一式」の見積もりなら、内訳を確認します。
Nagiosのシステム開発で見積もりを取る際のポイント
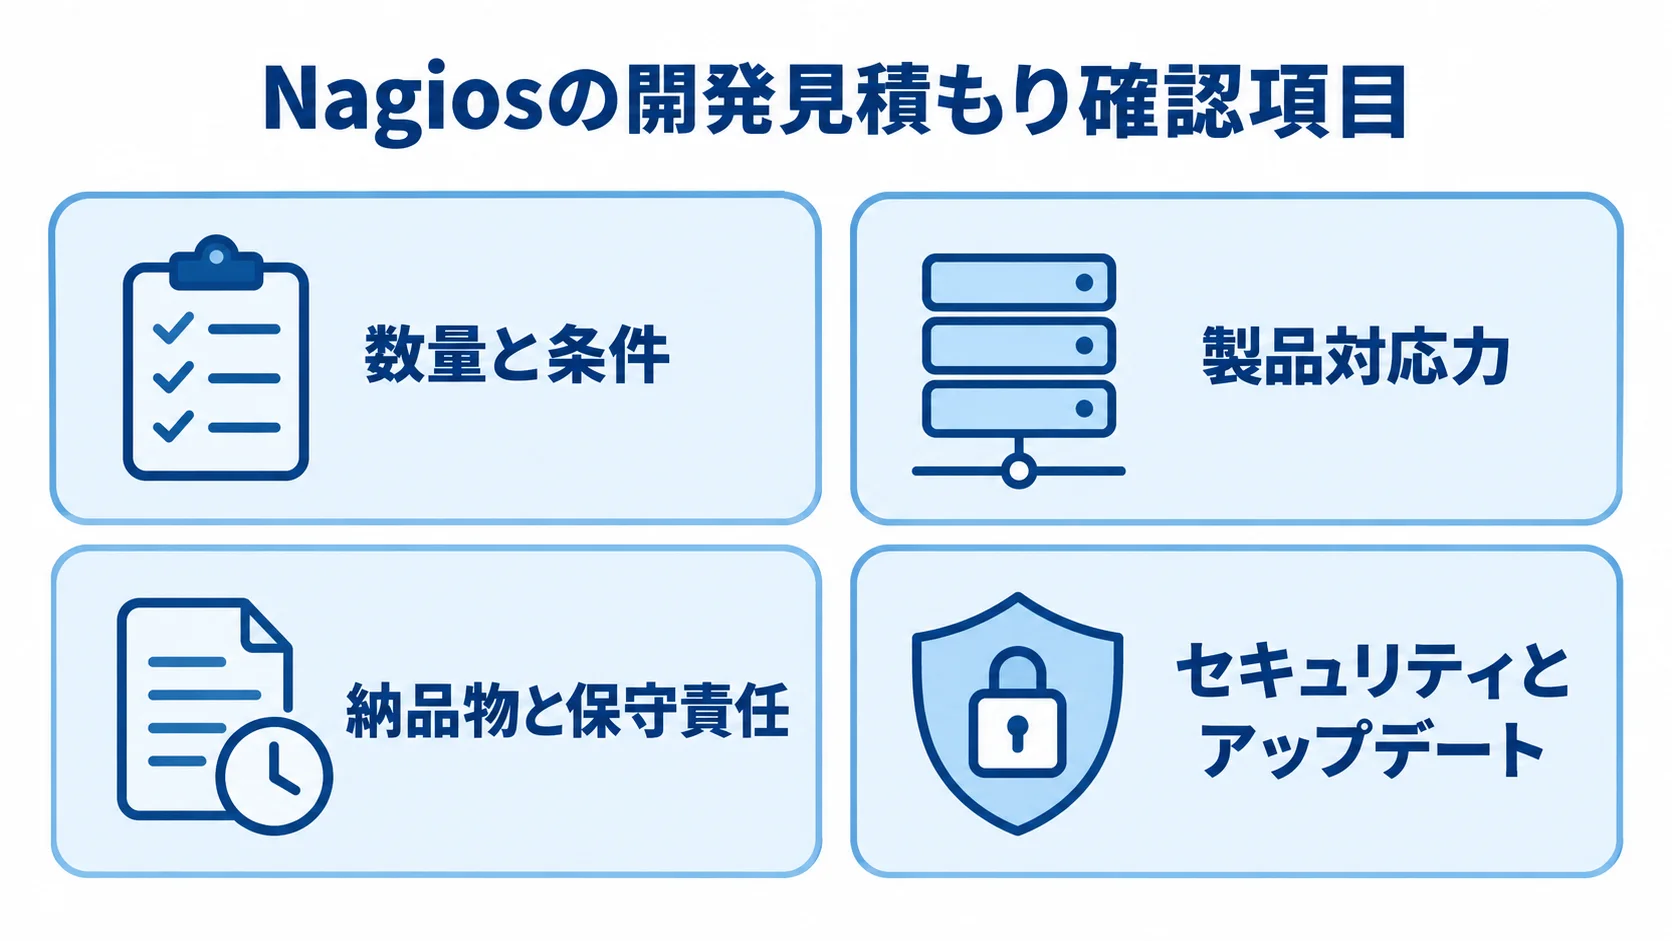
見積もりは、総額の安さよりも監視品質と責任分界を比べます。まず、同じRFPを候補会社へ渡し、作業範囲と各社の前提をそろえます。
監視対象からチェック、通知、連携までを、分けて提示してもらいます。冗長化、テスト、引き継ぎ、保守も、同じ区切りで示してもらいます。金額がホスト数だけを根拠にしているのか、サービス数や設計工数も含めているのかを確認します。
監視対象・チェック・通知の数量と条件
数量と条件をそろえて提示してもらえるよう、RFPに監視範囲を具体的に書きます。
- 数量:ホスト数とサービス数は分けて書く。100台でも、複数チェックで数は増える。
- 監視項目:CPU、メモリ、ディスク、プロセス、ログ、URL、DB接続。
- 環境と接続:開発・検証・本番、AWS・Azure、SNMP機器、拠点間通信、業務バッチ。
- 通知設定:経路、時間帯、担当、エスカレーション、復旧通知、メンテナンス抑制。
たとえば、CRITICALが3回続いたら当番へ通知し、15分応答がなければ責任者へ上げる、と指定しておくと、見積もりと試験の内容が明確になります。
ベンダーのNagios対応範囲と引き渡し条件
製品への対応力と担当者の実務経験を確かめ、構築後の運用を任せられるかを判断します。
- 製品・開発:Core・XI、標準外プラグインの実績。
- 技術範囲:Linux、Windows、ネットワーク、DB、AWS・Azure。
- 構成と連携:分散監視、冗長化、ITSM連携の経験。
- 担当者の実務:設計書、試験結果、変更手順、障害対応フローを作れるか。
公式パートナーに掲載されているだけでは、十分とは限りません。実際の担当体制や過去案件の規模も聞いておきます。
設定ファイル、プラグインのソース、IaC、ダッシュボード、文書、アカウントについて、所有権と引き渡しの時期を契約に明記します。
発注側は、再委託、データの所在地、ログの保存期間を確認します。個人情報、脆弱性パッチ、ライセンス更新の窓口、24時間対応の範囲も押さえておきます。
構築会社を変える条件をあらかじめ定めておくと、ベンダーロックインや運用停止のリスクを下げられます。
見積もりに含めるセキュリティとアップデート
監視の接続が攻撃の経路にならないよう、アクセス制限と認証、情報の保護を要件に含めます。
- 公開範囲:VPN、踏み台、IP許可リストで管理画面への接続を制限。
- 認証と権限:TLS、個別アカウント、最小権限、MFAやLDAP・AD、監査ログ。
- SNMPと秘密情報:可能な限りSNMPv3を使い、古いコミュニティ文字列を外部へ出さず、秘密情報を安全に保管。
Nagios公式は、2026年3月25日付のCore 4.5.12について、特定CGIのCSRF脆弱性を案内しています。そのため、4.5.12以降への更新を勧めています(出典: Nagios Enterprises「4.5.12」、2026年確認)。
見積もりには、脆弱性の確認、検証環境での更新、バックアップ、ロールバック、互換性試験を含めてください。導入時の版を固定したまま放置すると、保守費は抑えられても、将来の障害対応費が増える可能性があります。
Nagiosのシステム開発でよくある質問
無料で使える範囲、開発期間、既存監視からの移行、担当者の確保について、発注前の判断に役立つ回答をまとめています。
Nagiosは無料で導入できますか?
Nagios Coreはライセンスが無料ですが、導入まで無料になるわけではありません。サーバーや設計、設定、プラグインの準備が要ります。バックアップ、パッチ、試験、通知の準備も必要で、担当者の工数もかかります。
また、XI Freeも小規模向けの入口です。サポートやノード数の条件を確かめてから、本番利用を判断します。
Nagiosのシステム開発にはどのくらいの期間がかかりますか?
推定の目安は、小規模PoCが2〜6週間、標準導入が1〜3か月です。高可用性・分散監視は3〜6か月、大規模な全社基盤やMSPは6〜12か月以上になります。
既存監視の移行、独自プラグイン、通知連携があると、期間は延びます。ネットワーク変更、受入試験、教育、夜間の切り替えも、期間を延ばす要因になります。
現実的なのは、まず5〜20台でPoCを行い、検知精度と通知を確認してから本番に展開する方法です。
既存の監視ツールからNagiosへ移行できますか?
移行はできます。ただし、既存の監視項目は、不要なチェック、重複通知、古い閾値、責任者の分からない項目を整理してから移します。
旧ツールとNagiosを一定期間並行稼働させ、検知漏れ、誤検知、通知到達、障害対応時間を比べてから切り替えます。
設定やプラグインを再利用できるか、対象側エージェントの変更、切り戻しの方法も、見積もりに含めます。
Nagiosは内製と外注のどちらが向いていますか?
Linux、ネットワーク、スクリプト、障害対応の担当者がいて、監視範囲を絞れる場合は、Coreを内製するのも選択肢です。
複数拠点、独自プラグイン、冗長化、ITSM連携、24時間365日対応、引き継ぎが必要な場合は、初期の設計と構築を外注し、日常の運用は共同で引き継ぐ方法があります。
外注する場合も、設定ファイルやソースを受け取り、将来は自社か別の会社で変更できる条件にしておきます。
Nagiosのシステム開発の進め方まとめ
Nagiosの開発は、要件整理、選定、設計開発、試験、稼働、定着の6段階で進めます。監視対象は、業務への影響に応じて分類します。
CoreとXI、クラウドとオンプレミス、既存監視それぞれの役割を決めます。そのうえで、閾値や依存関係、通知、夜間対応を成果物と受入条件に落とし込みます。
最初は重要業務に絞ったPoC
全社のホストを一度に登録せず、停止時の影響が大きいサービスを選んで、5〜20台程度で検知精度と通知の流れを試します。
成功条件は、必要な担当者が適切な時間に動けるかどうかで見ます。次に、結果をもとに閾値、依存関係、通知抑制、運用分担を修正します。
調整をしてから段階的に展開すると、導入後のアラート疲れを抑えられます。
無料という言葉ではなく運用を含む総額での判断
導入の判断では、ライセンス以外の作業と継続的な運用費も含めて、総額を比べます。
- 初期・運用費:設計、サーバー、プラグイン、試験、保守、脆弱性対応、夜間一次対応。
- 見積もりの内訳:ホスト・サービス、通知、独自開発、冗長化、移行、教育、成果物、年次保守。
- 比較期間:初期費用と2年目以降のTCOを比べ、必要な監視の深さと体制は先に定めておく。
▼全体ガイドの記事
・Nagiosのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。