
オフライン強化学習とは、収集済みの固定データだけで、環境へ新たに試行せず方策を学ぶ強化学習です。医療やロボット制御、推薦、業務ログなどで、過去の記録を活用します。
オンライン強化学習と違い、探索で新たなデータを集めないため、探索のリスクとコストを抑えられます。仕組み、アルゴリズム、データ設計、評価と導入時の注意点を扱います。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
オフライン強化学習は固定ログから方策を学ぶ仕組み
学習に使うデータセットDには、状態s、行動a、報酬rなどを含む遷移が入ります。次状態s’や終了フラグも、その遷移の要素です。学習中は環境に行動を返さず、このDの範囲だけで価値関数や方策を更新します。
データを集めた方策は、行動方策と呼ばれます。また、学習後の方策が行動方策から大きく外れないように制約する設計が、基本になります。
オンライン強化学習との探索の有無による違い
オンライン強化学習は、現在の方策で環境を動かし、新しいデータを集めます。オフラインは探索のリスクとコストを抑えられる反面、データの偏りを後から解消できません。そのため、ログの偏りを見極めるには、収集時の状況を項目ごとに確認します。
- 収集時の方策:ログを集めた際に使った方策
- 収集期間:ログを集めた期間と時期
- 対象者:データに含まれる対象者の範囲
- 行動カバレッジ:ログに含まれる行動の範囲と偏り
分布外行動の価値の過大評価
学習方策がログにほとんどない行動を選ぶと、モデルはその価値を不確かに外挿します。たとえば、最大値を取るQ学習では、誤差を楽観的に拾うことがあります。この影響を捉えるには、ログとのずれを見る観点で監視します。
- 行動とデータの距離:選んだ行動と、ログとの隔たりの大きさ
- 価値推定の保守性:価値の見積もりが楽観的に偏っていないこと
- 方策間の近さ:学習方策と行動方策の距離の推移
保守性とデータ再利用で見るアルゴリズムの選び方
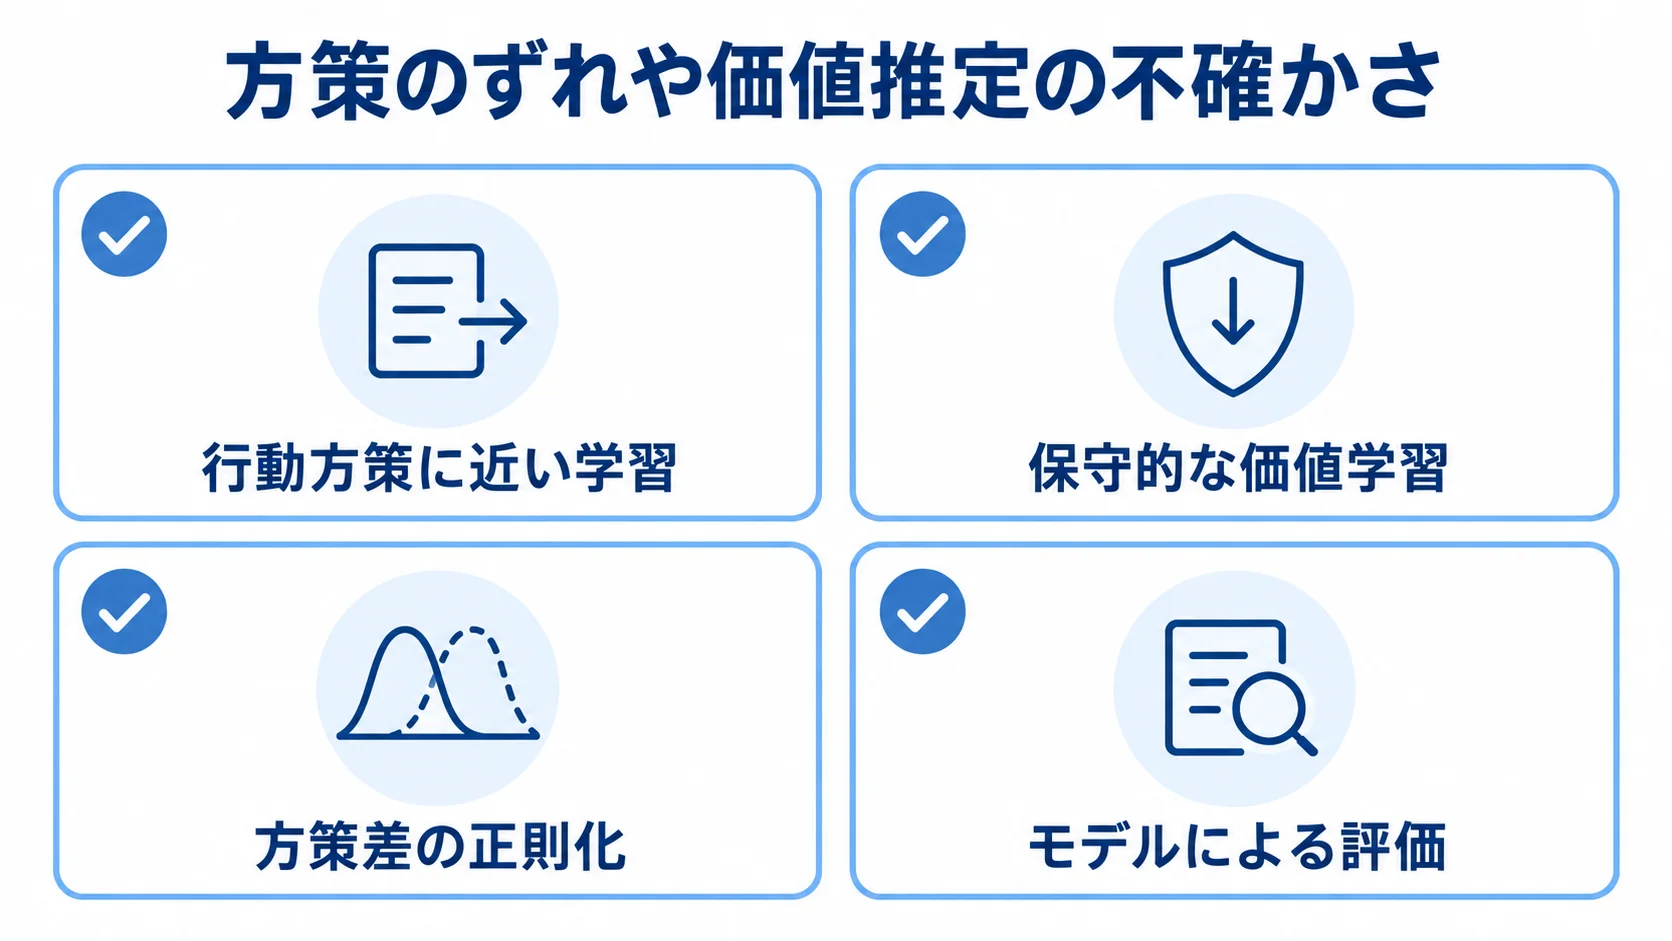
方策のずれや価値推定の不確かさの程度によって、適した手法が変わります。
- 行動方策に近い学習:BCQなどで、ログ内の行動に近い方策を学ぶ手法
- 保守的な価値学習:CQLなどで、価値推定を保守的に保つ手法
- 方策差の正則化:学習方策と行動方策の差を抑える仕組み
- モデルによる評価:モデルを学習して反実仮想を評価する方法
なお、d3rlpyは、固定データセットで学ぶオフライン深層強化学習のライブラリで、複数のアルゴリズムを提供しています。
候補を絞る際は、まずデータの質と行動の多様性を確認します。そのうえで、報酬の遅延や連続・離散行動の違い、安全制約、評価環境の有無も基準にします。最後に、小さなデータで方策がログから離れないかを確かめてから、複雑なモデルへ進みます。
オフライン強化学習を左右するデータセットの品質
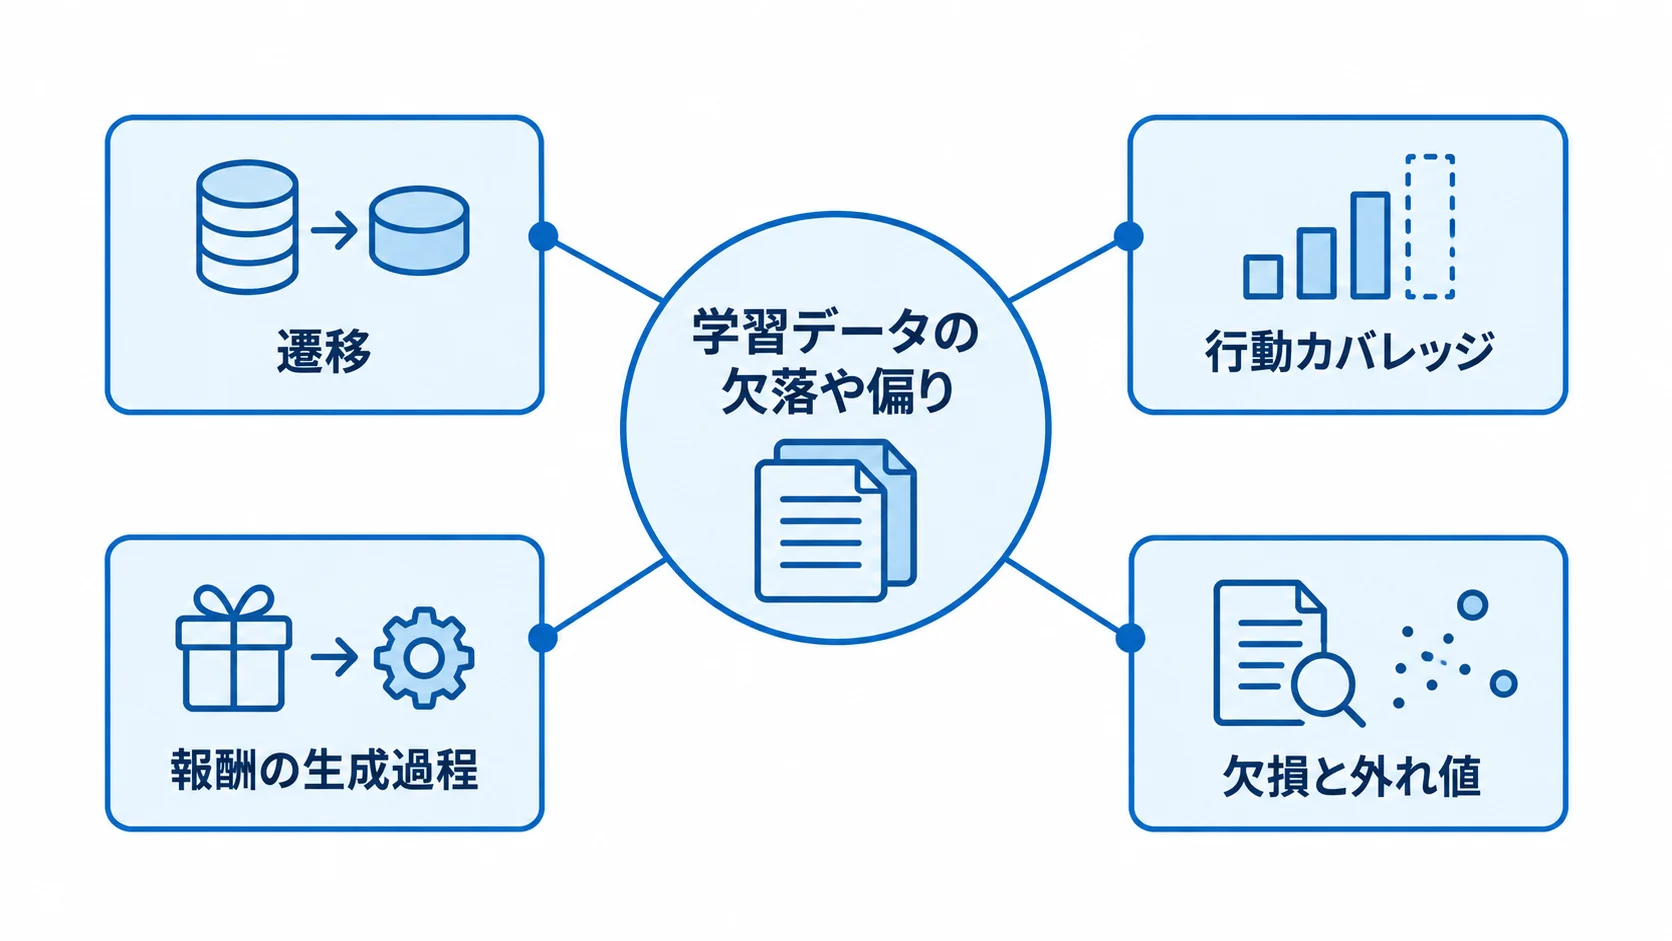
学習データの欠落や偏りを避けるには、収集の段階から記録と確認をする項目を決めておきます。
- 遷移を正しく保存する:状態・行動・報酬・次状態の保存と、終了と打ち切りの区別
- 行動カバレッジを調べる:状態ごとの行動数と頻度、成功と失敗の集計
- 時間・顧客で分割する:学習・検証・テストの重複や未来情報の混入の防止
- 報酬の生成過程を記録する:代理指標、遅延、後から変更された評価の明記
- 欠損と外れ値を扱う:センサー異常、未完了エピソード、異常な行動の確認
失敗時の価値を学ぶには、失敗の記録を含むログが要ります。また、別の行動を安全に評価したいときは、特定の方策に偏らないログが求められます。
偏りは後から解消できないため、データシートには、収集者と期間、業務条件を残します。利用権限も、あわせて書いておきます。
オフライン指標と段階的なオンライン検証による評価
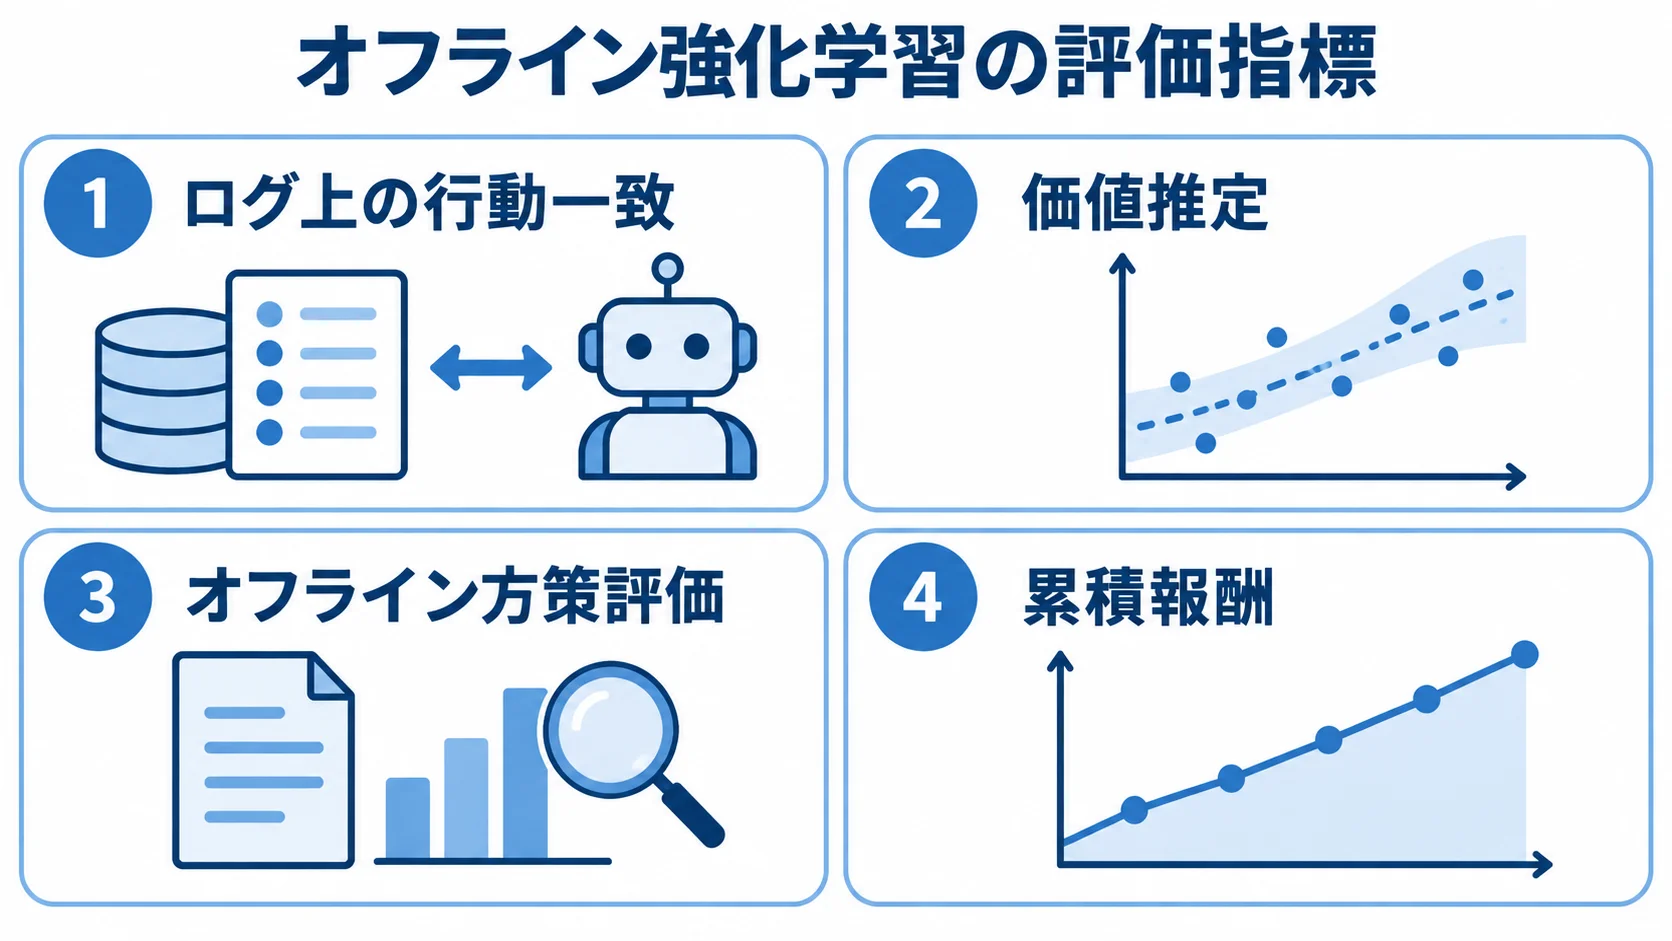
まず、ログ上の行動一致や価値推定、オフライン方策評価を測ります。シミュレーターを使う場合は、累積報酬も評価します。
ただし、ログにない行動の評価は不確かです。そのため、可能であれば下の順で段階を踏み、実環境の結果で評価を補正します。
- 安全なサンドボックスでの検証
- 対象を限定した試行
- 承認を得たうえでの試行
医療や設備制御などでは、平均報酬よりも危険な失敗の上限を重視します。さらに、制約違反や分位点、最悪ケースも監視します。また、方策とログの距離を追い、データ分布が変わった場合の挙動も確認します。
オフライン強化学習で起きやすい失敗と対策
ログにない行動の過信
ログにない行動を信じすぎないよう、行動カバレッジと方策間の距離を確認します。保守的なアルゴリズムや行動制約を使えば、分布外の推定を抑えられます。
未来情報の特徴への混入
特徴量の生成時刻を監査します。そのうえで、データを時系列・顧客単位で分割し、再評価します。
代理報酬と本来の目的の取り違え
報酬以外の品質や安全、顧客への影響は、別の指標で測ります。あわせて、軌跡は人がレビューします。
探索せず固定ログから方策を学ぶ、オフライン強化学習の要点
オフライン強化学習は、過去の遷移データだけで方策を学びます。そのため、危険で高価なオンライン探索を避けられます。一方で、ログにない行動の価値推定をどう扱うかが、主要な論点になります。
データカバレッジや保守的なアルゴリズムに加えて、オフライン評価と安全な段階導入を組み合わせます。平均報酬だけでなく、最悪ケースと制約違反も確認します。
よくある質問(FAQ)
オフライン強化学習について、導入を検討する際によく出る疑問に、Q&A形式で答えます。
Q. オフライン強化学習とは何ですか?
過去に収集した固定データセットだけを使い、環境へ新たに試行せずに方策を学ぶ強化学習です。
Q. オンライン強化学習との違いは何ですか?
オンラインは学習中に環境から新しいデータを集め、オフラインは固定ログだけを使います。オフラインは探索リスクを抑えられる反面、データの偏りを後から解消できない点が、トレードオフになります。
Q. 分布外行動とは何ですか?
学習方策がログにほとんど存在しない行動を選び、その価値を不確かに外挿してしまう問題です。
Q. どのようなログが必要ですか?
状態や行動、報酬を含む軌跡が必要で、次状態と終了条件も含まれます。あわせて、収集方策と期間、環境条件を把握しておく必要があります。
Q. すぐ本番で使えますか?
すぐには使わず、まずオフライン評価とサンドボックスでの検証を行います。そのうえで、制約と承認を設けながら、停止・ロールバックも備えて段階的に導入します。
参考資料
オフライン強化学習の実装や背景を確認できる資料を、次に掲載します。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。