
ワンホットエンコーディングは、色や曜日、会員プラン、都道府県のようなカテゴリ変数を、カテゴリごとの0と1の列に変換する前処理です。順序のないカテゴリに不要な大小関係を持たせないことが、その狙いです。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
ワンホットエンコーディングとは?カテゴリを0と1の列に変換する方法
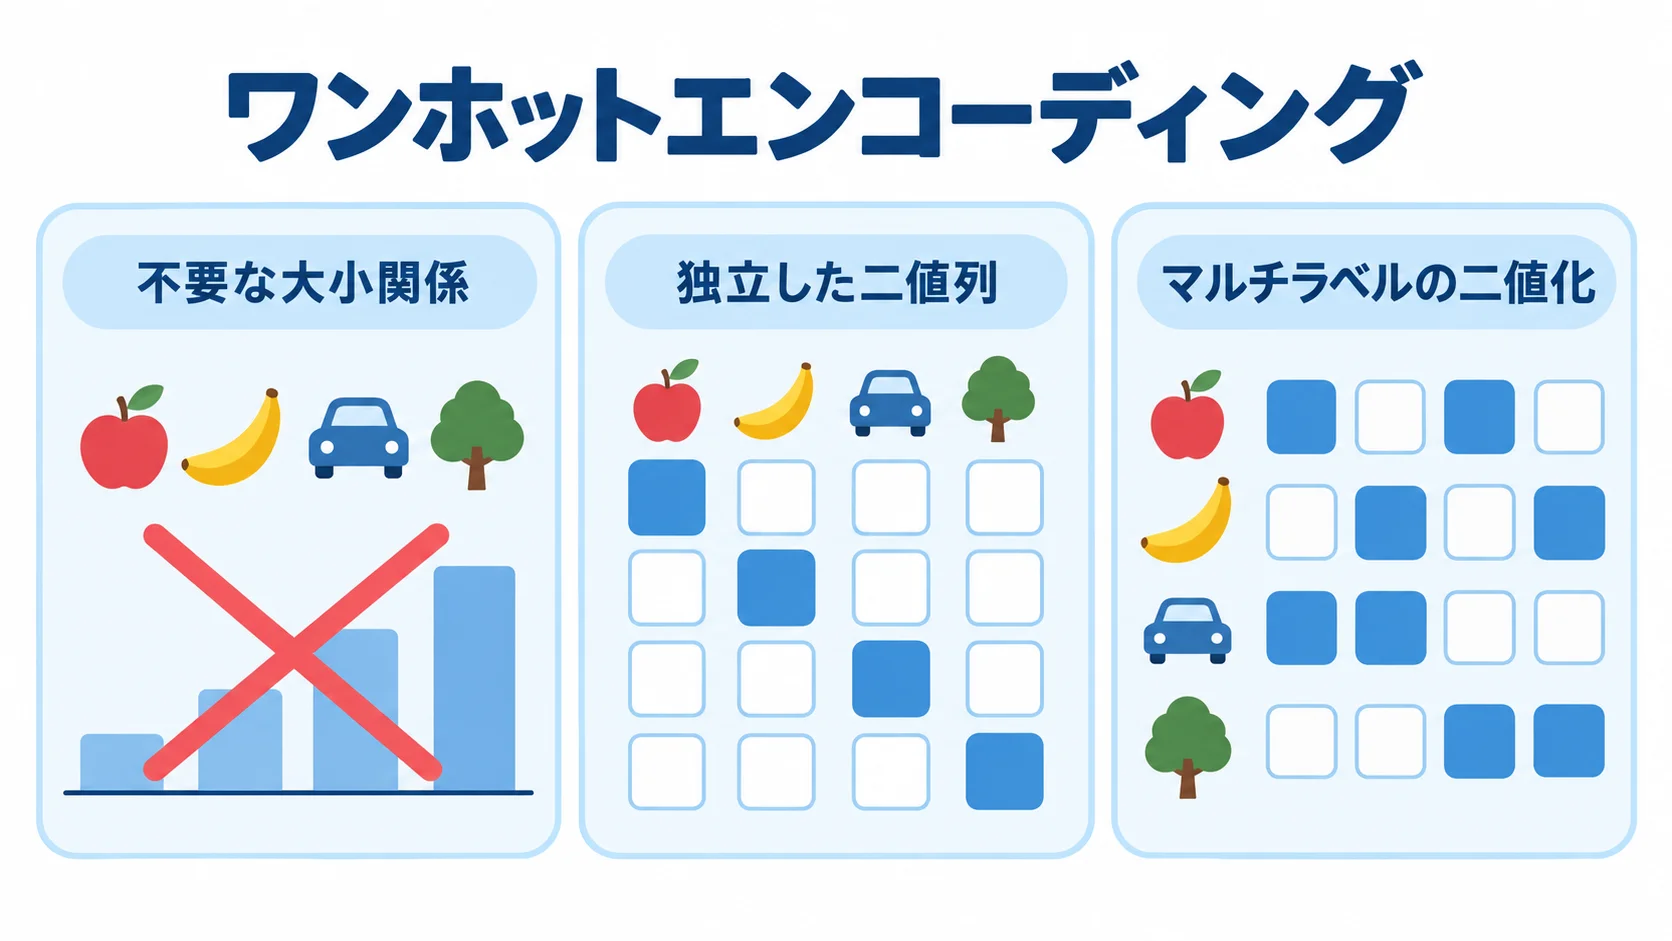
カテゴリ変数は、色、曜日、会員プラン、都道府県など、値の種類で意味を表す変数です。たとえば「赤」を1、「青」を2、「緑」を3と置き換えると、緑が青より大きいとモデルが誤って学習するおそれがあります。
そこでワンホットエンコーディングは、各カテゴリを独立した二値列にします。列が別々になるため、カテゴリ間に不要な大小関係は生まれません。
色が3種類なら、「色_赤」「色_青」「色_緑」の列を作ります。赤の行は1,0,0、青の行は0,1,0です。
1行で1になる列は原則1つだけなので、英語ではone-hotと呼ばれます。一方、複数のタグを同時に持つデータは、マルチラベルの二値化として扱います。
ワンホットエンコーディングを使う理由|数値化による誤解の回避
ラベルエンコーディングの注意点|順序のないカテゴリ
ラベルエンコーディングは、カテゴリを整数に置き換える方法です。二値カテゴリであれば、0と1で表しても問題が少ないことがあります。一方で、順序のない3種類以上のカテゴリを1,2,3へ変換すると、モデルによっては数値の距離や大小を意味として使ってしまいます。
決定木系の一部では、分割ルールによって影響が変わります。そのため、アルゴリズムの挙動を決めつけず、入力表現とモデルの前提を確かめます。
線形モデルや距離計算での使いやすさ
線形回帰、ロジスティック回帰、線形SVMは、各特徴量に係数を掛け合わせて予測するモデルです。そのため、ワンホット列ごとに異なる効果を学習できます。
最近傍法やクラスタリングのように距離を使う手法でも、カテゴリ間の順序ではなく、同じカテゴリかどうかを距離に反映させられます。ただし、ワンホット化すると列数が増えます。その対策として、正則化や疎行列を組み合わせます。
ダミー変数の列数|全列を残す設計と1列落とす設計
切片を含む線形モデルにKカテゴリの列をすべて入れると、各行の合計が必ず1になります。この完全な線形従属は、ダミー変数トラップと呼ばれます。
係数の一意性や数値計算の安定性を重視するなら、基準カテゴリを1つ落とします。残るK-1列は、基準カテゴリとの差として解釈します。
一方で、正則化モデル、木モデル、切片を使わないモデルでは、全列を残す設計が適する場合もあります。全列を落とすと未知カテゴリや基準カテゴリの解釈が変わるため、係数の読み方を文書化します。
scikit-learnのOneHotEncoderには、drop引数があります。これを使うと、先頭カテゴリや明示したカテゴリを落とす設定ができます。
カテゴリ数が多いときの課題|次元増加と疎な特徴量
商品ID、郵便番号、URLのパスなど、ほぼすべての行で値が異なる列は、ワンホット化すると列数が急増します。
行列のほとんどの要素は0になります。そのため、密な配列へ変換するとメモリを大量に消費します。そこでOneHotEncoderには、疎行列を返す設定があります。対応するモデルと組み合わせれば、保存容量と計算量を抑えられます。
低頻度カテゴリのまとめ方
低頻度カテゴリは、業務上の意味と出現状況を見て扱いを選びます。まとめ方は、意味の近さ、頻度、件数のどれで区切るかで分かれます。
- 意味が近い値を統合:「その他」へまとめる方法
- 頻度で統合:出現頻度に閾値を決めて、それより少ない値をまとめる
- 件数で制限:カテゴリを上位N件に絞る
低頻度の値は、学習データで偶然の係数が付きやすく、テスト時には未観測となる可能性も高いものです。そのため、統合ルールは訓練データだけで決め、予測時にも同じルールを適用します。
高カーディナリティでの別の表現との比較
カテゴリ数が非常に多い場合は、ワンホット以外の表現も比べます。
- 頻度エンコーディング
- ハッシュ化
- ターゲットエンコーディング
- 埋め込み表現
ターゲットエンコーディングは目的変数を使うため、検証データの情報が訓練側へ漏れやすくなります。そのため、交差検証の内側で計算する必要があります。
表現を選ぶときは、精度、説明しやすさ、メモリ、未知カテゴリへの対応を基準にします。ワンホットを避けること自体は目的ではありません。
未知カテゴリと欠損の扱い|訓練時と推論時の差の吸収
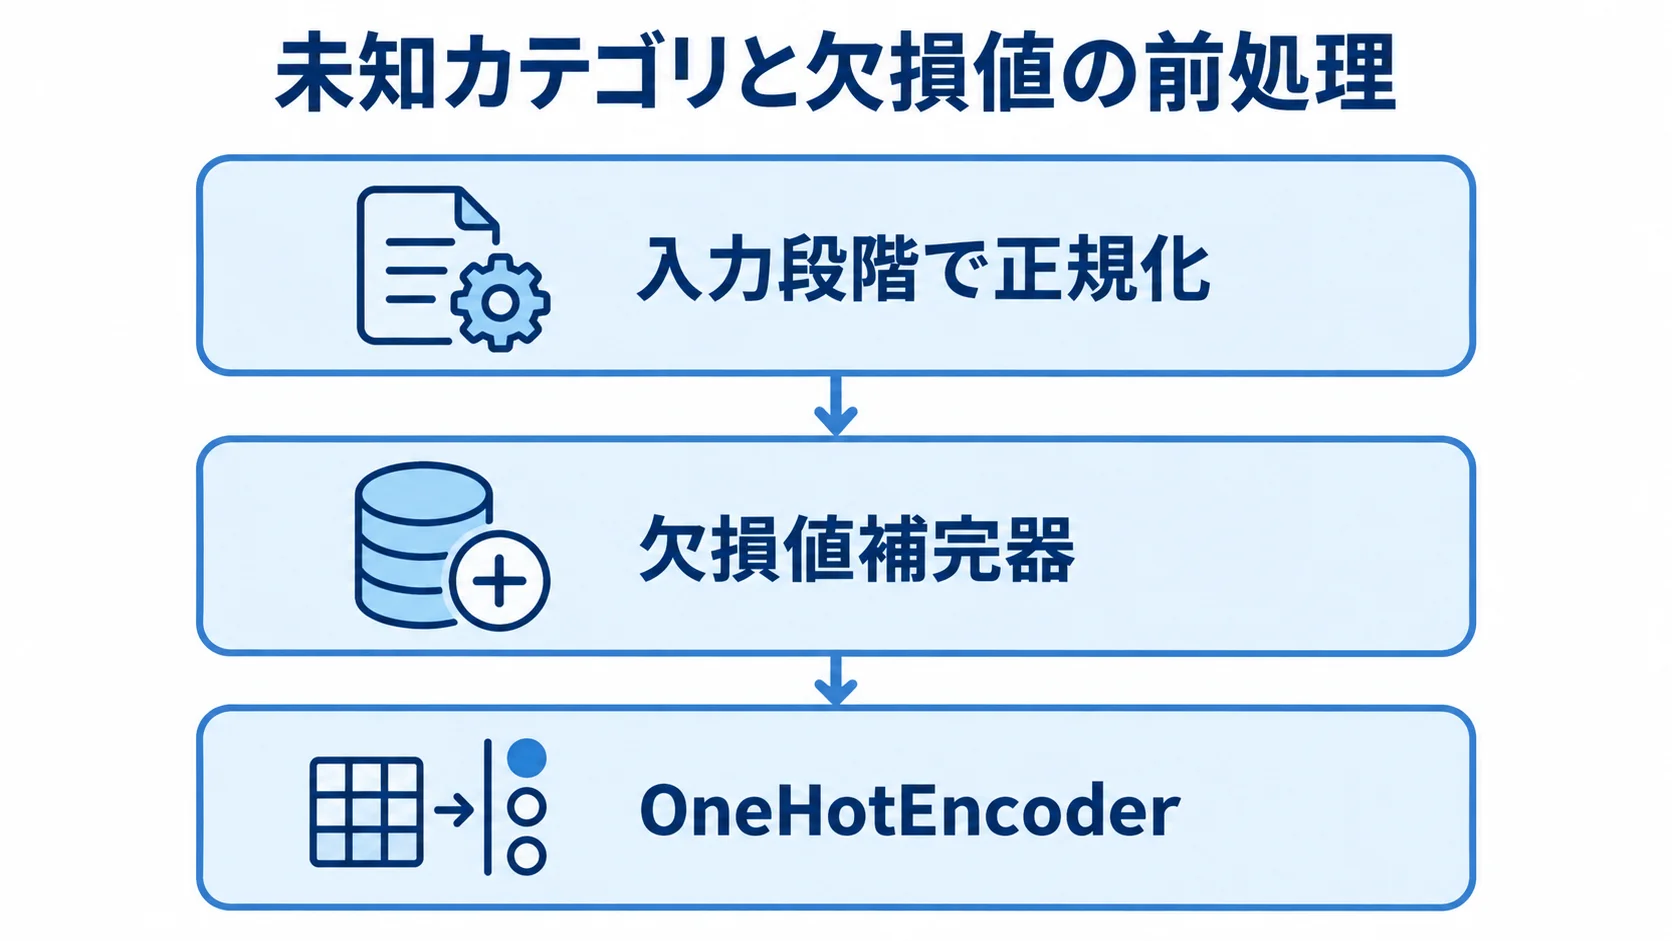
本番の入力には、訓練時には見なかったカテゴリが現れることがあります。新商品、海外の地域、追加されたプランなどが例です。
未知カテゴリでエラーになると、推論全体が止まってしまいます。そこでOneHotEncoderのhandle_unknownをignoreにすると、未知カテゴリを全列0として扱えます。
ただし、全列0では「どのカテゴリでもない」状態と欠損を区別できません。必要であれば、未知フラグを追加します。
欠損を専用のカテゴリに変換してからワンホット化する方法があります。また、欠損値補完器を先に置き、欠損フラグを残す設計も可能です。
訓練、検証、テスト、本番では、同じ前処理の順序を使います。空文字、文字列の「NaN」、PythonのNaNが混在すると別カテゴリとして扱われてしまうため、入力の段階で正規化します。
ワンホットエンコーディングの実装|ColumnTransformerによる列の管理
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from sklearn.impute import SimpleImputer

numeric_pipe = Pipeline([
    ("imputer", SimpleImputer(strategy="median")),
    ("scaler", StandardScaler()),
])
category_pipe = Pipeline([
    ("imputer", SimpleImputer(strategy="most_frequent")),
    ("onehot", OneHotEncoder(handle_unknown="ignore")),
])
preprocess = ColumnTransformer([
    ("num", numeric_pipe, numeric_columns),
    ("cat", category_pipe, category_columns),
])
この例では、数値列とカテゴリ列に別々の前処理をかけ、ColumnTransformerで結合しています。OneHotEncoderは訓練データからカテゴリ一覧を学習し、その列順を保存します。
推論時にエンコーダーを作り直してはいけません。カテゴリの並びが変わると、「色_赤」の列に本来とは別の列の値を読み込んでしまう危険があります。そのため、前処理とモデルは一つのPipelineとして保存し、バージョンを管理します。
pandas.get_dummiesの使い分け|探索用と本番用
pandasのget_dummiesは、データフレームをすばやく確かめる探索分析に便利です。ただし、訓練データとテストデータを別々に変換すると、列の集合や順序が食い違うことがあります。
訓練とテストを連結してから変換すると、テストのカテゴリを訓練の処理に見せてしまい、評価の境界が曖昧になります。そのため、本番の学習では、訓練データでfitしたエンコーダーで検証・テストをtransformする構成を優先します。
データリークを防ぐ設計|カテゴリ一覧の訓練データだけでの学習
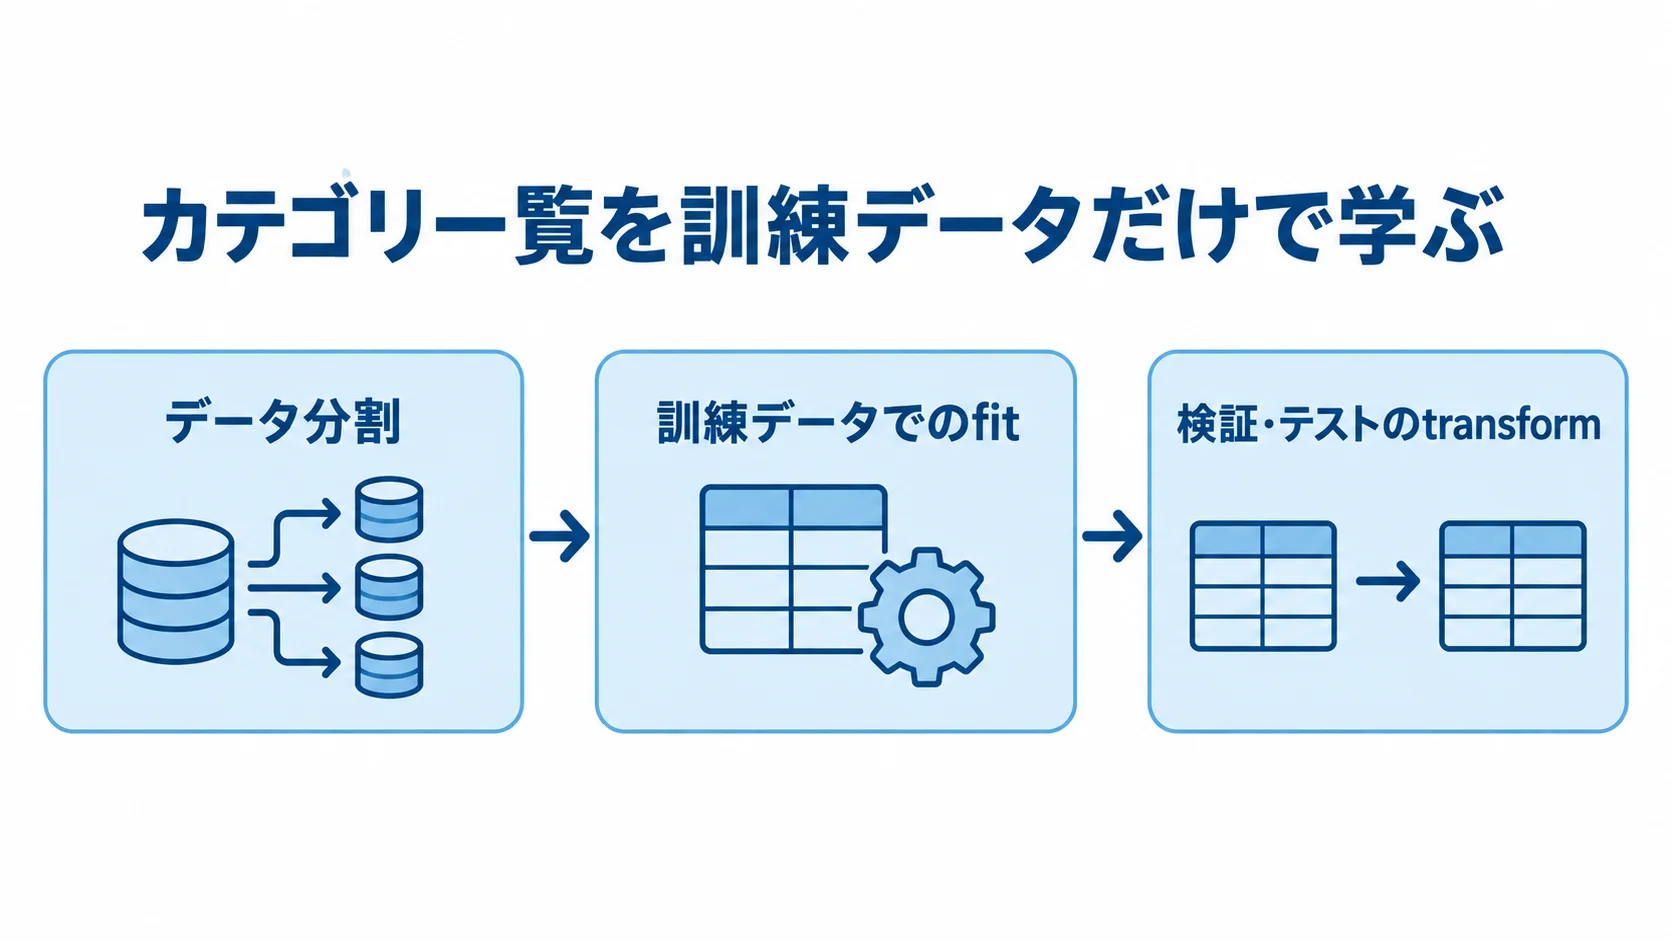
ワンホット化は0と1への置き換えに見えますが、列に採るカテゴリの一覧も学習します。全データで一覧を作ると、テスト期間にしか現れなかったカテゴリを、訓練の処理が知ってしまいます。
厳密に評価するには、データを分割した後に、訓練データでエンコーダーをfitします。検証・テストでは、transformだけを行います。
交差検証では、各foldの訓練部分でカテゴリ一覧を作ります。検証部分に未出現のカテゴリがあれば、未知カテゴリとしてignoreするか、設計どおりに「その他」へまとめます。
分割前後で列数が変わるのは自然なことです。評価コードで列を無理にそろえる代わりに、パイプラインが同じ特徴量空間へ変換しているかを確認します。
変換方法の評価|モデル性能と解釈性の比較
採用を判断するときは、ラベルエンコーディング、頻度エンコーディング、カテゴリ統合などを、同じ分割と指標で比べます。
分類では、業務上の損失に関わるF1、PR-AUC、再現率などを指標に選びます。回帰であればMAEやRMSEを使います。
検証分割を変えたときのばらつき、カテゴリ数、学習時間、推論メモリも記録しておきます。
係数を説明に使うモデルでは、カテゴリ列の係数を基準カテゴリとの差として読むのか、全列の係数として読むのかを明記します。
カテゴリを「その他」へまとめた場合は、そこに含まれる値をデータ辞書に残しておきます。現場が予測理由を確認できるかどうか、カテゴリが追加されるたびに再学習が必要かどうかも、採用の基準になります。
運用時の注意点|列順・未知値・スキーマの固定
ワンホット化の後は、元のカテゴリ名と列順の対応を固定して扱う必要があります。モデルファイルと一緒に、エンコーダー、カテゴリ一覧、drop設定を保存します。
未知値の扱いや欠損処理、出力列名も保存しておきます。バッチ処理とオンライン推論で前処理の実装が別々であれば、同じテストケースを両方に通して、同じ入力から同じベクトルができることを確認してください。
運用中は、カテゴリ別の出現頻度、未知カテゴリ率、全列0の行の割合、特徴量の列数を監視します。
新商品や制度変更で未知カテゴリ率が上がると、ignoreだけでは予測品質が落ちることがあります。そのため、一定の閾値を超えたらカテゴリ辞書を更新し、再学習と評価を行う手順を用意しておきます。
ワンホットエンコーディングまとめ|変換より一貫した前処理の設計
ワンホットエンコーディングは、順序のないカテゴリを独立した0と1の列に変換し、不要な大小関係をモデルに与えない方法です。
線形モデルや距離ベースの手法で使いやすい一方、カテゴリ数が増えると次元とメモリが膨らみます。
基準カテゴリを落とすか全列を残すかは、モデルと係数の解釈を踏まえて決めます。実装では、訓練データだけでカテゴリ一覧を学習し、未知カテゴリ、欠損、低頻度カテゴリの処理を定めます。
OneHotEncoderは、ColumnTransformerとPipelineに組み込みます。エンコーダーとモデルを同じバージョンで保存すれば、列順のずれによる事故を防ぎやすくなります。
性能、説明性、運用コスト、カテゴリ追加の頻度を比較します。必要であれば、別の表現も検証してください。
よくある質問(FAQ)
Q. ワンホットエンコーディングとは何ですか?
カテゴリごとに0と1の列を作り、該当するカテゴリの列だけを1にする変換です。これにより、順序のないカテゴリを数値の大小として誤解させずにモデルへ入力できます。
Q. ラベルエンコーディングとの違いは何ですか?
ラベルエンコーディングは、カテゴリを整数に置き換えます。一方、ワンホットはカテゴリごとに列を分けるため、順序のないカテゴリに不要な大小関係を持たせにくい点が異なります。
Q. 未知カテゴリが推論時に出たらどうしますか?
未知カテゴリをエラーにせず全列0として扱う方法や、「その他」へまとめる方法があります。未知率を監視し、増えた場合はカテゴリ辞書の更新と再学習を検討します。
Q. ダミー変数を1列落とすべきですか?
切片を含む線形モデルで係数の一意性を重視する場合は、基準カテゴリを1つ落とす設計があります。正則化や木モデルでは全列を残すこともあるため、モデルと係数の解釈に合わせて比べます。
Q. ワンホット化でデータリークを防ぐには?
訓練データだけでエンコーダーをfitし、検証・テストではtransformだけを行います。全データでカテゴリ一覧を作らず、交差検証では各foldの訓練部分でカテゴリを学習してください。
参考資料
実装やデータ前処理の詳細は、次の公式資料で確認できます。
scikit-learn「OneHotEncoder」https://scikit-learn.org/stable/modules/generated/sklearn.preprocessing.OneHotEncoder.html
scikit-learn User Guideの「Categorical Feature Support」は、カテゴリ特徴量の前処理資料です。
scikit-learn「ColumnTransformer」https://scikit-learn.org/stable/modules/generated/sklearn.compose.ColumnTransformer.html
scikit-learn「Pipeline」https://scikit-learn.org/stable/modules/generated/sklearn.pipeline.Pipeline.html
pandas「pandas.get_dummies」https://pandas.pydata.org/docs/reference/api/pandas.get_dummies.html
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。