
OpenTelemetryのシステム開発は、目的と観測対象を整理してから発注先を決め、PoCで効果と費用を確かめて本番化、運用移管へと進みます。
この流れを押さえると、障害時に原因を追える体制を段階的に整えられます。全体像は、OpenTelemetryのシステム開発の完全ガイドもご覧ください。
▼全体ガイドの記事
・OpenTelemetryのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
OpenTelemetryのシステム発注の全体像
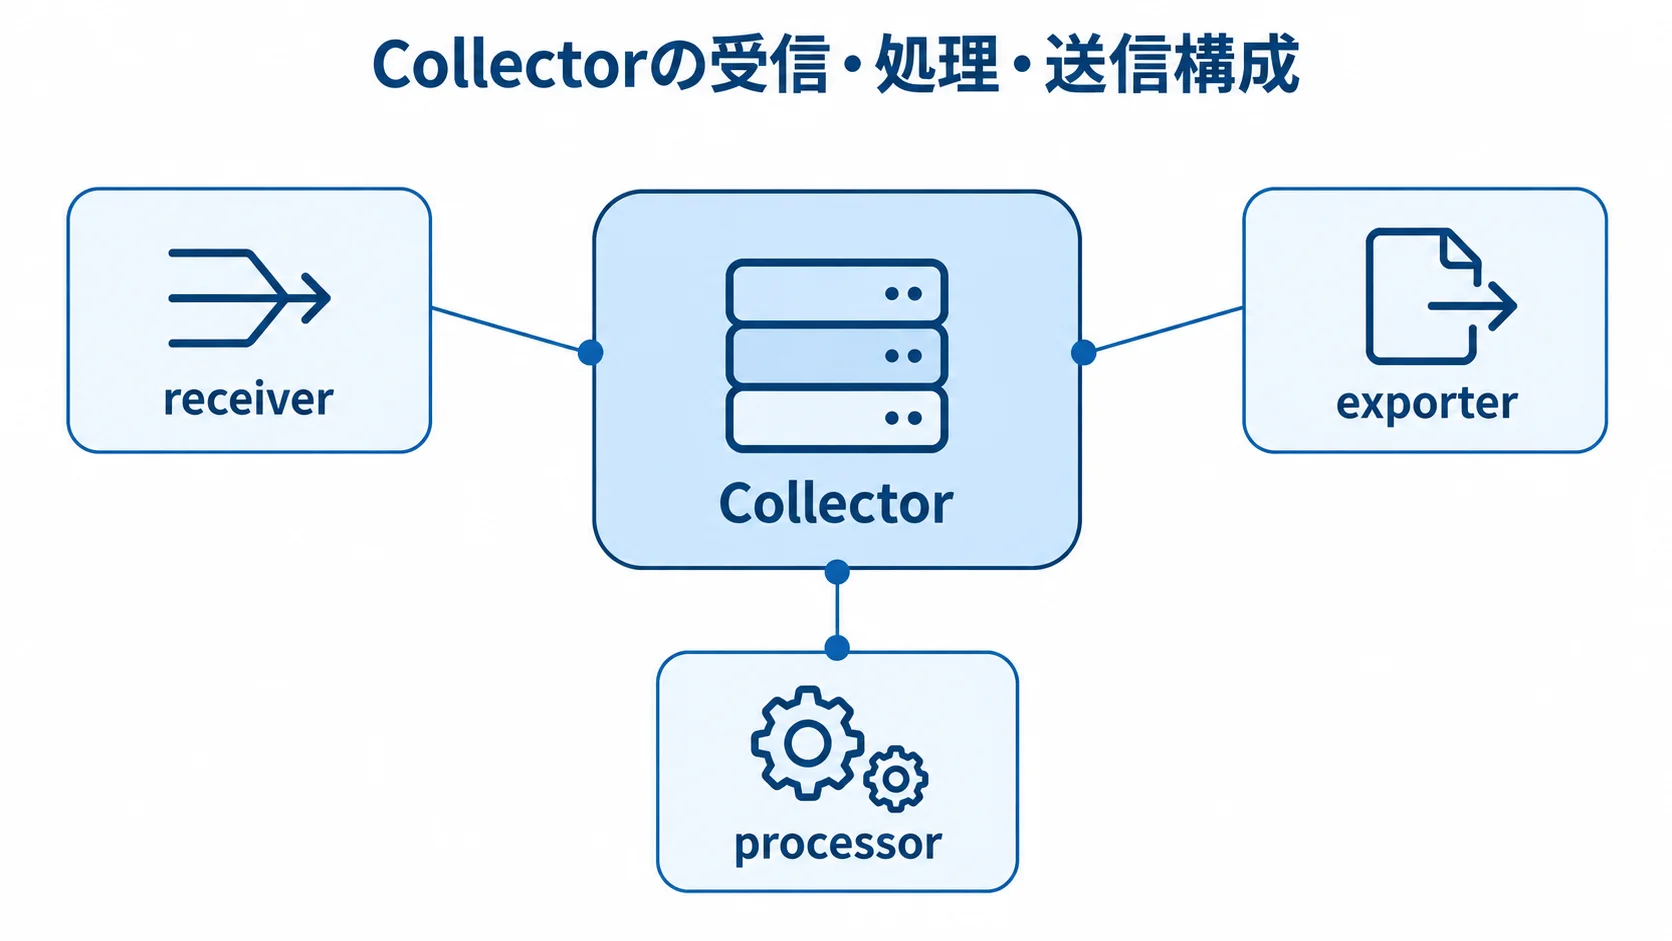
OpenTelemetryは、業務システムや完成済みの監視画面ではなく、観測データを集めて複数のバックエンドへ渡すための標準、API、SDK、Collectorなどのツール群です。
OpenTelemetry自体を監視製品として買うわけではないため、発注時は観測対象、データの流れ、保存先、運用責任に分けて要件を伝えます。
監視製品ではなく標準と収集基盤という位置づけ
発注範囲を決めるには、OpenTelemetryが扱う信号と、その送信先の役割を分けて考えることが欠かせません。
- メトリクス:CPU使用率、リクエスト数、エラー率
- ログ:アプリケーション内で起きた出来事
- トレース:1件のリクエストが複数サービスやDBを通る経路
SDKや自動計装エージェントで観測機能を加え、OTLPなどを使ってCollectorへ送ります。Collectorは、特定のベンダーに依らず、データの受信・処理・送信を担います(出典: OpenTelemetry公式「Components」、2026年確認)。
データはGrafana、Datadog、New Relic、Elastic、CloudWatchなどへ送ります。そのため、保存・検索・可視化を担うバックエンドも発注に含めるのか、既存製品を使うのかを決めておきます。
3つの信号の相関と障害原因の追跡
障害対応の成果を要件にするには、信号を組み合わせて何を特定したいのかを明確にします。
- メトリクス:レイテンシ上昇などの変化を把握
- トレース:APIからDBまでの処理経路を確認
- ログ:Trace IDやSpan IDで関連付け
たとえば注文処理が遅いとき、メトリクスだけでは「レイテンシが上がった」ことまでしか分からない場合があります。トレースでAPIゲートウェイから注文サービス、在庫DB、外部決済APIまでをたどれば、遅いSQLや外部API呼び出しに絞り込めます。
要件は、ダッシュボードを作ることではなく、成果で表します。成果の例としては、注文のP95レイテンシがSLOを下回ったとき、何分以内に原因候補へ到達できるかを定めます。
Collectorとバックエンドの役割分担
Collectorを置くかどうかは、データ処理と運用をどこで担うかで決まります。
- 構成要素:receiver、processor、exporterで受信・処理・送信
- 保護・制御:サンプリング、マスキング、暗号化、再送
- 振り分け:複数のバックエンドへデータを送信
小規模な検証であれば、アプリからバックエンドへ直接送る方法もあります。一方で、本番では各サービスの負荷を抑え、再送や機密情報の除去をまとめて担うCollectorを置く配置が有力です。
OpenTelemetryの発注形態の選び方
発注形態は、社内の技術力と対象サービス数を中心に決めます。障害対応の緊急度や将来の内製化方針も、判断材料になります。
いきなり全社導入を一括で発注するより、まず重要サービスで短期PoCを行い、前提を確かめてから本番展開へつなげる方法がおすすめです。社内にSREやクラウド運用の担当者がいない場合は、PoCの段階から運用設計と教育まで含めて委託する必要があります。
PoCだけを外注して発注判断を確かめる方法
社内に経験が少なく、必要な信号も分からない場合は、1〜3サービスを対象にPoCを行います。対象には、顧客体験に直結し、API、DB、外部サービスなど複数の依存先を持つ処理を選びます。
PoCの納品物は計装コードだけではなく、Collector設定、ダッシュボード、アラートも含みます。加えて、データ量の実測、セキュリティ確認、次段階の見積条件も求めます。
設計・導入・運用を一括で委託する方法
システムが複数クラウドやKubernetesにまたがり、24時間運用もある場合は、一括で委託するとどこまでを誰が受け持つかを明確にできます。
- 導入前後:現状調査、設計、実装、負荷試験
- 運用準備:アラート設計、手順整備、教育
- リリース後:改善と運用支援
Collectorの障害対応、SaaS料金超過の監視、アプリの再計装を誰が担うかは、RACIや運用分担表で示してもらいます。
内製と外注を組み合わせる方法
業務知識を持つ社内チームがサービス名や重要な取引を定義し、横断的な領域に強い外部のSIerと分担する方法です。この形なら、導入後も知識を社内に残りやすくなります。
- 社内:計装、サービス名、重要トランザクションの定義
- 外部のSIerや専門会社:Collector、クラウド基盤、セキュリティレビュー、運用設計
設定ファイル、ダッシュボード、テスト結果の所有権と引き渡し条件を明記します。教育資料も、引き渡しの条件を決めておきます。
RFP・要件整理で決めておく項目
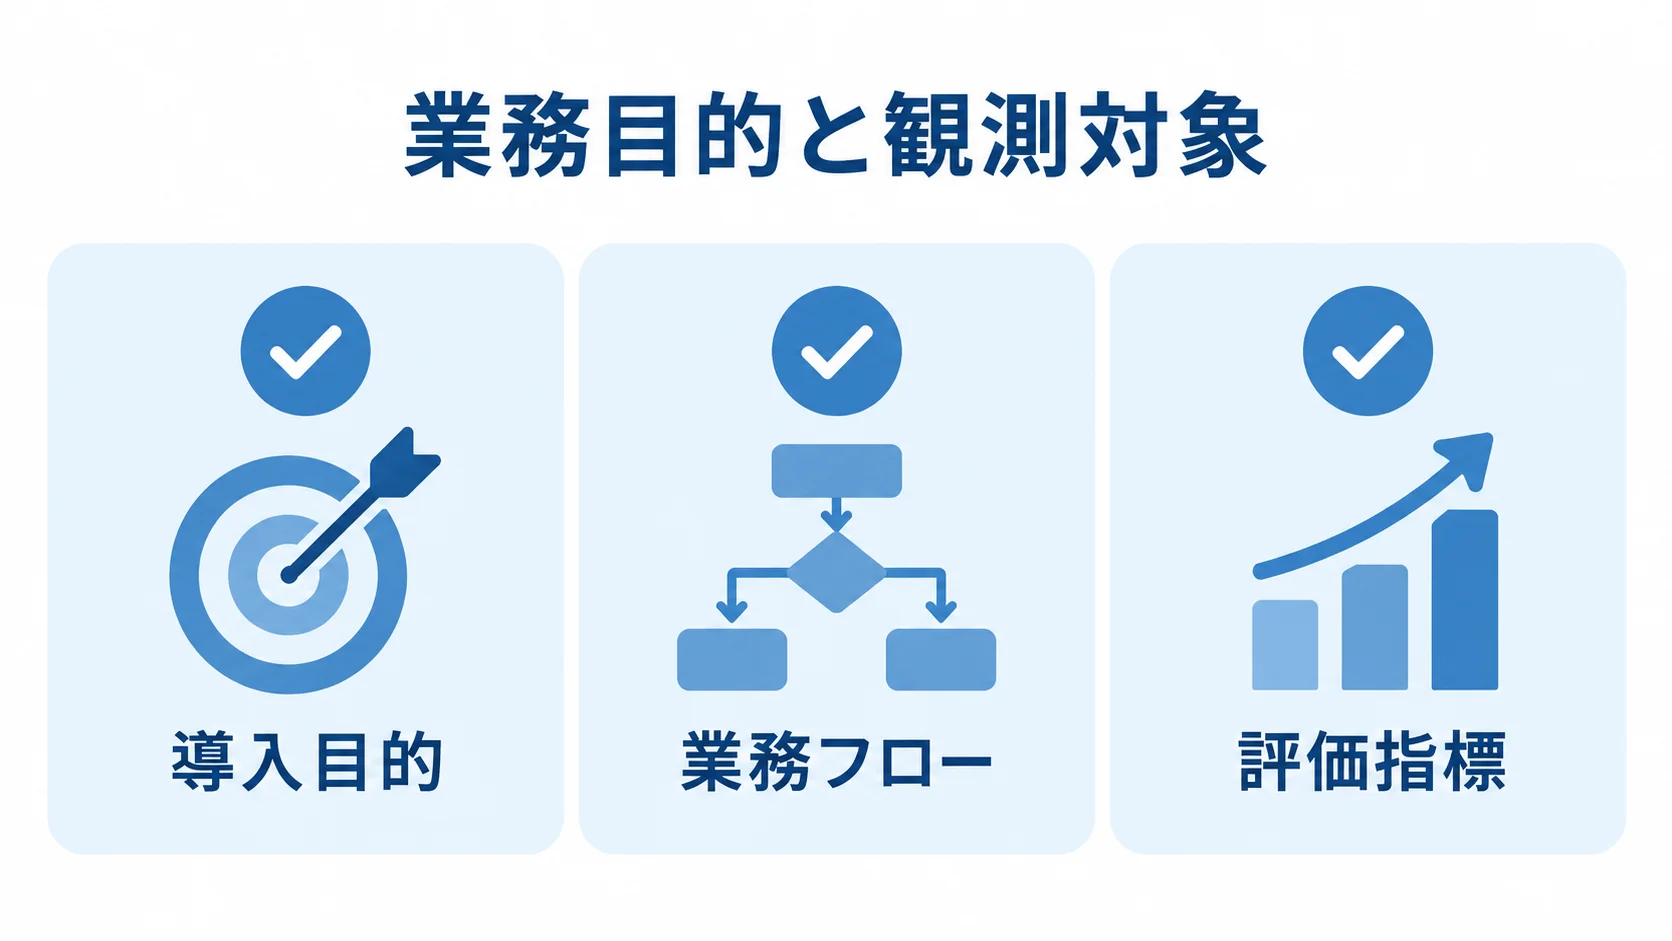
RFPには対象範囲と現状、業務効果を書き、そのうえで制約、納品物、評価方法もまとめます。テレメトリ量や保持期間が曖昧なままだと、見積もりとSaaS利用料の前提が変わってしまいます。そのため、候補会社による調査や試算を提案範囲に含めて、不明な項目を未確定のまま残さないようにします。
業務目的と観測対象の定義
目的と対象業務が定まると、保存するデータと費用の範囲を絞れます。
- 導入目的:原因調査の短縮、決済失敗の早期検知
- 業務フロー:ログイン、検索、注文、決済、出荷連携
- 評価指標:成功率、P95レイテンシ、エラー率
クラウド移行後の性能比較も、導入目的のひとつになります。あわせて、対象フローの外部依存先と許容停止時間を記載します。業務目的が明確であれば、不要なログを全量保存して費用が膨らむのを防げます。
技術要件(サービス・環境・データ量)の記載
見積りの条件をそろえるには、サービスの構成とテレメトリ量を具体的に示してもらいます。
- サービス情報:言語、環境、台数やPod数、依存先
- データ量:1日あたりのログGB、スパン数、系列数、保存期間
- Collector配置:Agent、DaemonSet、Gateway、複数クラウド
サービス一覧には、フレームワーク、デプロイ頻度、既存のログ・APM製品も書き添えます。Java、.NET、Go、Python、Node.jsなど複数の言語を使うなら、自動計装と手動計装の範囲を分けます。
データ量は、ピーク時の毎秒リクエスト数と検索対象期間も示します。配置案には、各ノード、Kubernetes、中央Gatewayの構成を書きます。複数クラウドを使う場合は、その構成も含めます。
PIIと秘密情報の扱い(非機能要件)
テレメトリに含めない情報と、収集後に守る方法をRFPに明記します。
- 対象情報:顧客ID、メール、Cookie、認証情報、SQL値
- 加工・通信:禁止属性、マスキング、redaction、TLS、認証
- 管理:保管、権限、保持、バックアップ、再委託
APIトークンや秘密鍵はSecret Storeなどで保管します。また、不要なコンポーネントを減らします(出典: OpenTelemetry公式「Collector configuration best practices」、2026年確認)。国外リージョンの扱いも定めます。
OpenTelemetryの外注に適した契約形態
調査のように仕様を固めきれない工程と、成果物を定められる構築の工程が混在します。そのため、工程に合わせて契約を分けます。企画、現状調査、PoCは準委任、本番構築や確定したダッシュボードの納品は請負が候補になります。
契約の名称より先に、作業範囲と指揮命令関係を確認します。そのうえで、成果物と検収、変更手続き、障害対応の責任も見ます。
調査・設計・改善に向く準委任
作業をしながら前提を確かめていく工程では、専門作業の遂行を重視する準委任が適しています。
- 現状調査:挙動を確かめながら観測対象を決定
- PoC:サンプリング率やCollector構成を検証
- 運用改善:ダッシュボードやアラートを見直す
契約では、月ごとの稼働時間や担当者の役割を定めます。定例会議と報告書、成果の確認方法も決めておきます。さらに、到達目標とレビュー項目を置き、稼働時間だけで判断しないようにします。
確定した構築・納品範囲に向く請負
仕様と受入基準を決められる範囲には、成果物の完成と引き渡しを重視する請負が適しています。
- 構築物:Collector本番構成、権限、ダッシュボード
- 運用成果物:アラート、運用手順書
- 受入基準:表示、発報、欠損、PIIの確認条件
受入条件には、指定したサービスのトレースが途切れずに表示されることを含めます。障害再現時の発報や、ピーク負荷時に許容するデータ欠損も、確認できる条件にします。
工程ごとの契約分けと変更管理の基準
工程を分けておくと、PoCの結果を本番化の判断と条件に反映できます。
- 現状調査、要件定義、PoC
- 対象や前提の再確認と本番展開
- 運用支援への移行
第一段階の終了時には、対象サービスとデータ量、バックエンドを再確認します。あわせて、セキュリティや残課題、本番化費用も見直します。
仕様変更の見積方法と追加作業の承認者は、契約書や発注書に記載します。緊急障害時の単価や、SaaS・クラウド料金の支払者も定めておきます。これらの条件を明記しておくと、予算超過や責任の押し付け合いを避けやすくなります。
OpenTelemetryのシステム開発を発注する進め方
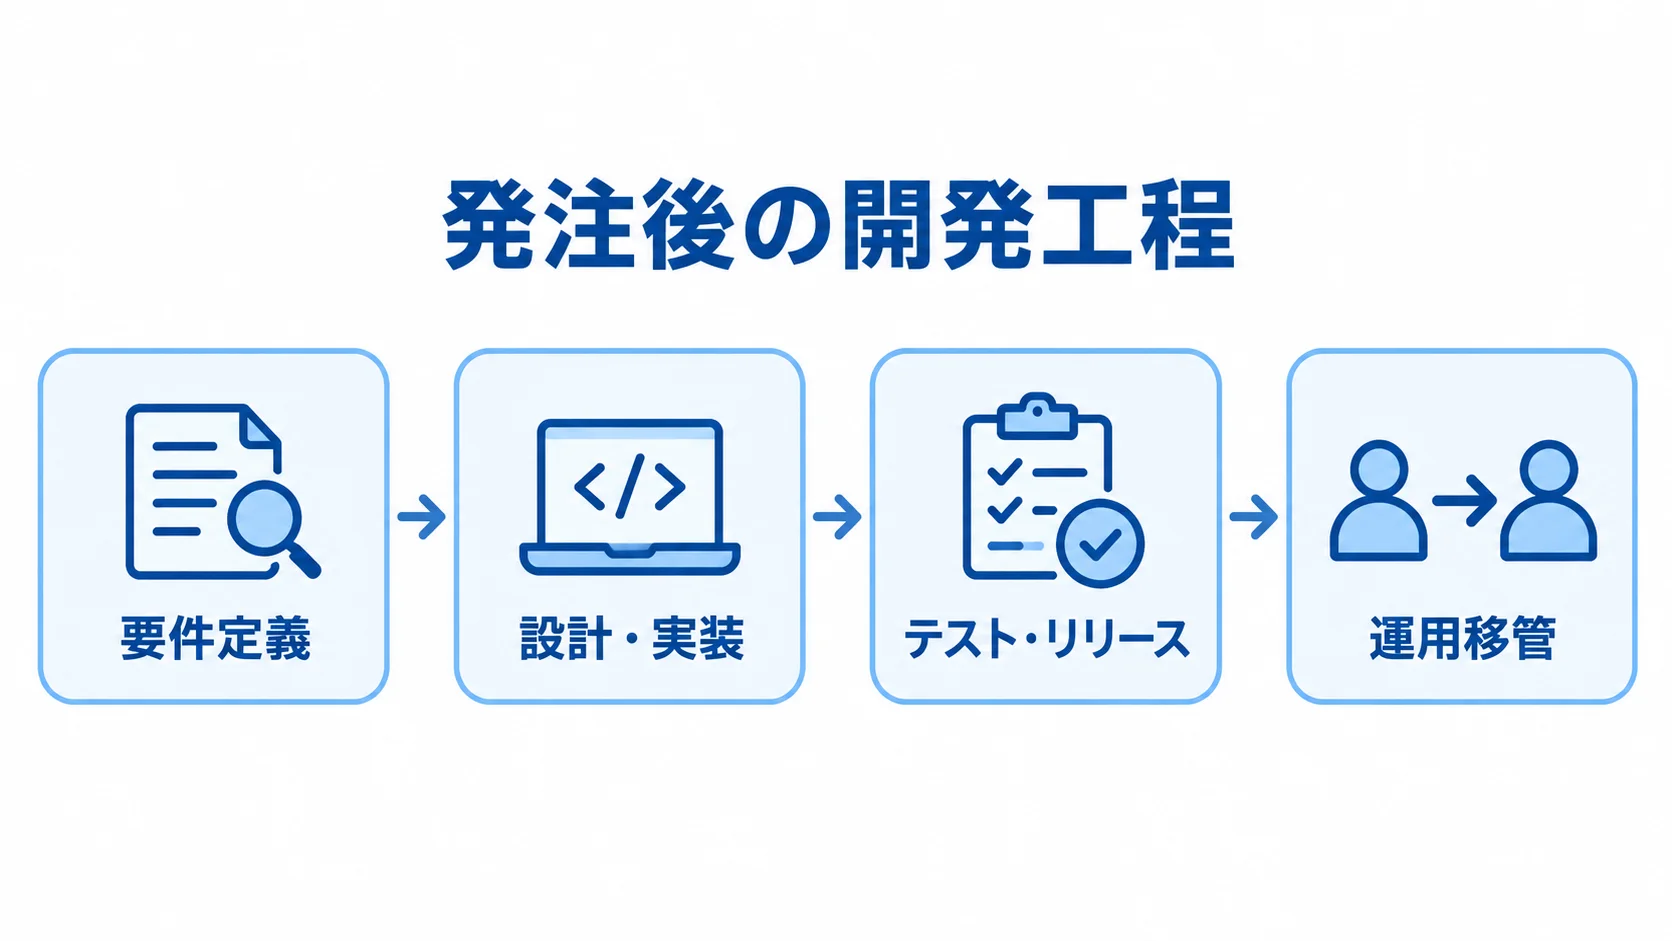
発注後は、要件定義、設計・実装、テスト・リリース、運用移管の順に進みます。計装だけを先に進めると、送信先や保持方針が決まらず、データを使えないことがあります。
各工程では、誰がどの画面を見て、どのアラートにどの手順で対応するかまで確かめておきます。
現状調査によるサービスと障害対応の洗い出し
現状把握では、サービス構成と障害対応の課題を合わせて整理します。
- 構成:サービス、言語、環境、既存監視、アラート
- 運用:オンコール体制、過去の障害記録
- 課題:照合作業、原因不明、外部遅延の判別
障害対応に同席して、現場で起きている困りごとを把握します。また、サービス名や環境名などの共通属性と、Semantic Conventionsの採用範囲も定めます。
小さなPoCによる効果・品質・費用の検証
PoCでは、重要な1〜3サービスに自動計装を加え、必要な箇所にだけ手動計装を足します。合格条件は、障害時に原因候補へ到達できることとします。
- 品質:通信遅延、API・DB遅延を安全な環境で再現
- データ量:ログGB、スパン数、メトリクス系列数
- 性能:CollectorのCPU・メモリ、検索速度
正常時の画面だけでなく、障害調査のシナリオも試します。計測したデータ量と検索性能は、本番化と費用を判断する材料にします。
本番化と運用移管の責任者
本番化では、データを途切れず取り続けられるかと、安全性を確かめたうえで、運用を担う人へ手順を引き継ぎます。
- 構成:Agent・Gateway、冗長化、TLS、認証
- 処理:キュー、memory limiter、バッチ、サンプリング
- 移管:一次切り分け、連絡、ロールバック、料金確認
バックエンド障害時の再送を設定します。あわせて、Collector自身のメトリクスも監視し、データ欠損や遅延を検知できるようにします。
リリース前には、負荷試験と権限試験を行います。マスキング試験や障害訓練も行います。
移管時には、アラート一覧と設定変更の手順書も渡します。そのうえで、一次対応とエスカレーションの責任者を明確にしておきます。
OpenTelemetryのシステム開発費用・相場
OpenTelemetryの日本向け受託開発相場を網羅した公的統計は確認できません。ここで示す金額は、人月単価とサービス数、計装対象から組み立てた推定です。Collector構成やセキュリティ、バックエンド利用量も前提に入れています。
アプリ本体の刷新費用は含めず、観測基盤の設計と計装を対象にし、可視化と運用設計も含めます。見積書にはデータ量や保持日数、サンプリング率を記載してもらい、対応時間も含めてもらいます。
規模別の初期費用とPoCの目安
規模ごとの推定は、対象サービス数や含める機能によって変わります。
- PoC:1〜3サービス、1言語で100万〜300万円
- 部門規模:5〜20サービスで300万〜800万円
- 全社規模:20〜100以上で800万〜2,000万円
PoCは、Collectorを1系統とし、基本的なダッシュボードと障害検証を想定します。部門規模は複数言語とKubernetesを含み、3信号と通知連携も扱います。
全社規模は、複数クラスタやGateway冗長化、tail samplingを含みます。さらに、PII対策やSLO、既存基盤からの移行も含みます。監査やDR、24時間運用まで含め、拠点横断も加わると、2,000万円超の可能性があります。これらは規模と前提から算出した推定で、固定価格の相場ではありません。
データ量と保持期間で変わるランニング費用
利用料は課金対象と保持条件で変わるため、各社の価格例を同じ単位で比較します。
- Datadog:APMホストは月31米ドルから
- Datadog取り込み:APMは1GBあたり0.10米ドル
- New Relic:月100GBまで無料、超過分は1GBあたり0.40米ドルから
費用を左右するのは、ホスト数やユーザー数、取り込むログやトレースのGB量です。加えて、Indexed Spansやメトリクス系列数、保存日数も影響します。Indexed Spansは保持期間ごとの課金です。
New Relicも、ユーザー数やプランに応じて課金します(出典: Datadog「Pricing Comparison」、New Relic「Transparent Pricing」、2026年確認)。実際の契約価格は、為替や割引によって異なります。そのため、公開価格から日本円の月額を断定できません。
収集と保存の方針による費用の抑え方
保存の粒度と期間を使い分けると、必要な調査能力を保ちながら費用を見直せます。
- トレース:成功した低価値データは低率でサンプリング
- 重要処理:エラー、高遅延、重要顧客はtail samplingで保持
- ログ:監査データは低コストストレージも検討
検索頻度の高い期間は、高速なインデックスに置きます。見積りを比べるときは、想定GBと保持日数をそろえ、インデックス率や超過単価、データ出力費も同じ条件にしてTCOを比較します。
OpenTelemetryの委託先選定と見積比較のポイント
委託先は、設定例の知識だけでなく、業務システムを止めずに計装して障害対応に定着させられるかで選びます。また、会社ごとに得意な範囲も異なります。
候補には同じRFPを渡し、技術力や導入方法、運用体制を同じ観点で確認します。料金前提とデータ移行性についても、同じ基準で見ます。
実績の確認(構成と成果)
実績は、自社の構成に近い経験があるか、導入後にどう変わったかを確かめます。
- 構成:サービス数、言語、Kubernetes、サーバーレス
- 基盤:Collector配置、バックエンド、既存監視との併用
- 成果:復旧・原因特定時間、通知数、欠損率、月額
データ量と運用移管の範囲も確認します。導入前後の数値は、開示できる範囲で示してもらいます。
業務アプリの設計とSREの経験を、同じチーム内で持っているかも判断材料です。クラウドやセキュリティの経験も含めて見ます。
作業・前提・除外範囲で分ける見積の比較
作業費と利用料を分け、各社の見積もりを同じ範囲で比較します。
- 作業:調査、要件定義、計装、構築、試験、教育、保守
- 前提:サービス数、担当ロール、工数、期間、納品物、検収
- 別費用:利用料、移行、24時間対応、追加改修
作業項目は、バックエンド設定とダッシュボード、アラートごとに分けてもらいます。負荷試験やセキュリティレビュー、リリースも別の項目として示してもらいます。
ライセンスや通信費の扱いを確認します。既存監視からの移行やアプリ改修が含まれるかも確かめ、削除やマスキングの作業も見ます。見積もりが「導入費」とひとまとめになっていると、比較しにくくなります。
提案内容と障害対応デモの比較
同じ障害シナリオを使うと、各社の調査手順と運用設計を比較できます。
- 再現条件:注文API、DBクエリ、決済APIの遅延
- 確認作業:信号の関連付け、PII削除、再送
- 担当確認:設定変更、PII削除、サンプリング、再送、サービス追加の担当
提案資料の見栄えよりも、実運用で迷わない手順と、質問への回答の具体性を評価します。
OpenTelemetryを外注するときのリスクと対策
設計を誤ると、データ量やセキュリティ、運用負荷が増える可能性があります。そこで、必要なデータを安全かつ継続的に使えることを納品条件にし、リスクは契約前に洗い出して、PoCや受入試験で確認します。
PIIや認証情報がテレメトリに混入するリスク
監視基盤に個人情報や認証情報が入り込まないよう、記録と収集の両方で対策します。
- 記録:アプリ側で不要な情報を出力しない
- 除去:Collectorのfilterやredactionも使う
- 保護:TLS、Secret Store、最小権限を適用
ログ本文やSpan属性には、顧客IDやメールアドレス、Cookieなどが意図せず入ることがあります。Authorizationヘッダーやリクエスト本文、SQLのバインド値が入る場合もあります。個人情報や決済情報、APIキーが入ると、監視基盤そのものが新たな情報管理の対象になります。
データ一覧とアクセス権は、契約や社内規程に合わせて決めます。保持期間や削除依頼、再委託も、契約で定めておきます。また、Collectorはrootで実行せず、トークンや証明書はSecret Storeで管理します。
ベンダーロックインとデータ移行のリスク
独自の属性やエージェントに依存すると、移行時の負担が大きくなります。検索クエリやダッシュボードへの依存も、移行の手間を増やします。
- 標準出力:OTLPとSemantic Conventionsを採用
- 設定管理:設定や成果物の保管場所を明確化
- 解約条件:データ取出し、返却、移行費を契約
ダッシュボードやアラートのエクスポート方法も、RFPに含めます。専用機能を使う場合は、標準のデータを別の基盤で再利用できる範囲を確かめます。解約時の作業費や返却条件は、契約の段階で確定させておきます。
アラート疲れと運用負荷が増えるリスク
すべての例外や低い閾値でアラートを設定すると、通知が多すぎて、本当に重要な障害が埋もれてしまいます。サービスごとに担当チームとSLOを決め、そのうえで一次対応とエスカレーションの条件も決めておきます。
- 体制:SLO、担当チーム、時間外連絡先を定義
- 対応:一次対応とエスカレーションを決定
- 通知:エラー率や顧客影響など行動につながるものに絞る
導入後1〜3か月は、通知の件数や対応時間を見直します。誤検知や未対応の通知も、同じ期間に確認します。運用契約に改善会を含めると定着しやすくなります。
よくある質問
OpenTelemetryは無料で導入できますか?
仕様や主要コンポーネントはOSSとして利用できますが、導入総額が無料になるわけではありません。計装・設計の人件費とCollectorのクラウド費が発生します。さらに、保存・検索・可視化のSaaSやDB費、保守費もかかります。無料枠を超えるGBや保持期間の従量課金も、見積もりに含めます。
OpenTelemetryの導入期間はどれくらいですか?
導入期間は、対象サービス数と含める工程の範囲で大きく変わります。PoC、部門規模、全社規模のそれぞれで、次の期間を目安にします。
- PoC:1〜3サービスで2〜6週間程度
- 部門規模:5〜20サービスで1〜3か月程度
- 全社規模:3〜6か月以上
部門規模には、複数言語やKubernetes、通知連携、運用設計が含まれます。期間は、サービス数のほか、アプリ改修の承認やテスト環境の準備によっても前後します。
セキュリティ審査やデータ量の試算、リリース可能な時間帯も期間に影響します。既存監視からの移行を含む場合は、3〜6か月以上を見込みます。
既存のDatadogやCloudWatchがあっても導入できますか?
導入できます。既存監視との連携では、次の方法を選べます。
- 既存製品へのOTLP送信
- Collectorから複数の保存先への送信
- 移行中の旧エージェントとの一時並行稼働
OpenTelemetryは、特定のバックエンドに固定されない設計を取りやすい点も特徴です。
二重計装では、データの重複や二重課金、属性名やアラートの重複に注意が必要です。移行期間や停止条件をRFPで決めておきます。データ量の上限や最終的な基盤も、あわせて決めます。
AWSでは、2026年にCloudWatchがOTLPメトリクスをパブリックプレビューで受け付ける動きもあります。利用リージョンと正式提供状況は、提案時点で確認します(出典: AWS「Amazon CloudWatch now supports OpenTelemetry metrics」、2026年4月)。
まとめ
OpenTelemetryの発注では、ツールを入れること自体ではなく、障害原因を追跡する観測・運用基盤として要件を整理します。PoCで効果とデータ量を確かめ、本番展開と運用支援へ段階的につなげます。
RFPには、対象サービスと3つの信号、Collector構成を書きます。バックエンドやSLO、PII対策も明記します。保持期間や運用分担、成果物、検収条件も含めます。
作業費とテレメトリ利用料を分けた費用の比較
推定レンジはPoCが100万〜300万円、部門規模が300万〜800万円、全社規模が800万〜2,000万円程度です。サービス数やデータ量、保持日数が前提になります。セキュリティや運用時間も、前提に含まれます。
初期費用と月額のSaaS・クラウド費を分けます。さらに、保守や超過単価、追加作業、解約時の移行費も分けて見ます。そのうえで、障害対応の短縮と運用負荷を含む総保有コストで判断します。
委託先の技術・安全性・運用移管の評価
OpenTelemetryの経験だけでなく、業務システムやクラウドの経験も確認します。Kubernetesやセキュリティ、障害訓練の経験もあわせて見ます。さらに、障害シナリオを示して、信号の相関方法を提案してもらいます。
成果物と運用責任は、契約に記載します。社内チームが自走できるよう、設定やダッシュボードに加えて、教育や改善会まで発注条件に含めます。手順書も対象にします。
▼全体ガイドの記事
・OpenTelemetryのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。