
OpenTelemetryのシステム開発は、要件整理で観測の目的と対象を決め、計装とバックエンドを選び、設計・開発、テスト、段階リリース、運用と改善の6つのフェーズで進みます。
こうした流れで進めると、障害対応の実効性を検証できます。全体像は完全ガイドもご覧ください。
▼全体ガイドの記事
・OpenTelemetryのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
OpenTelemetryのシステム開発の全体像
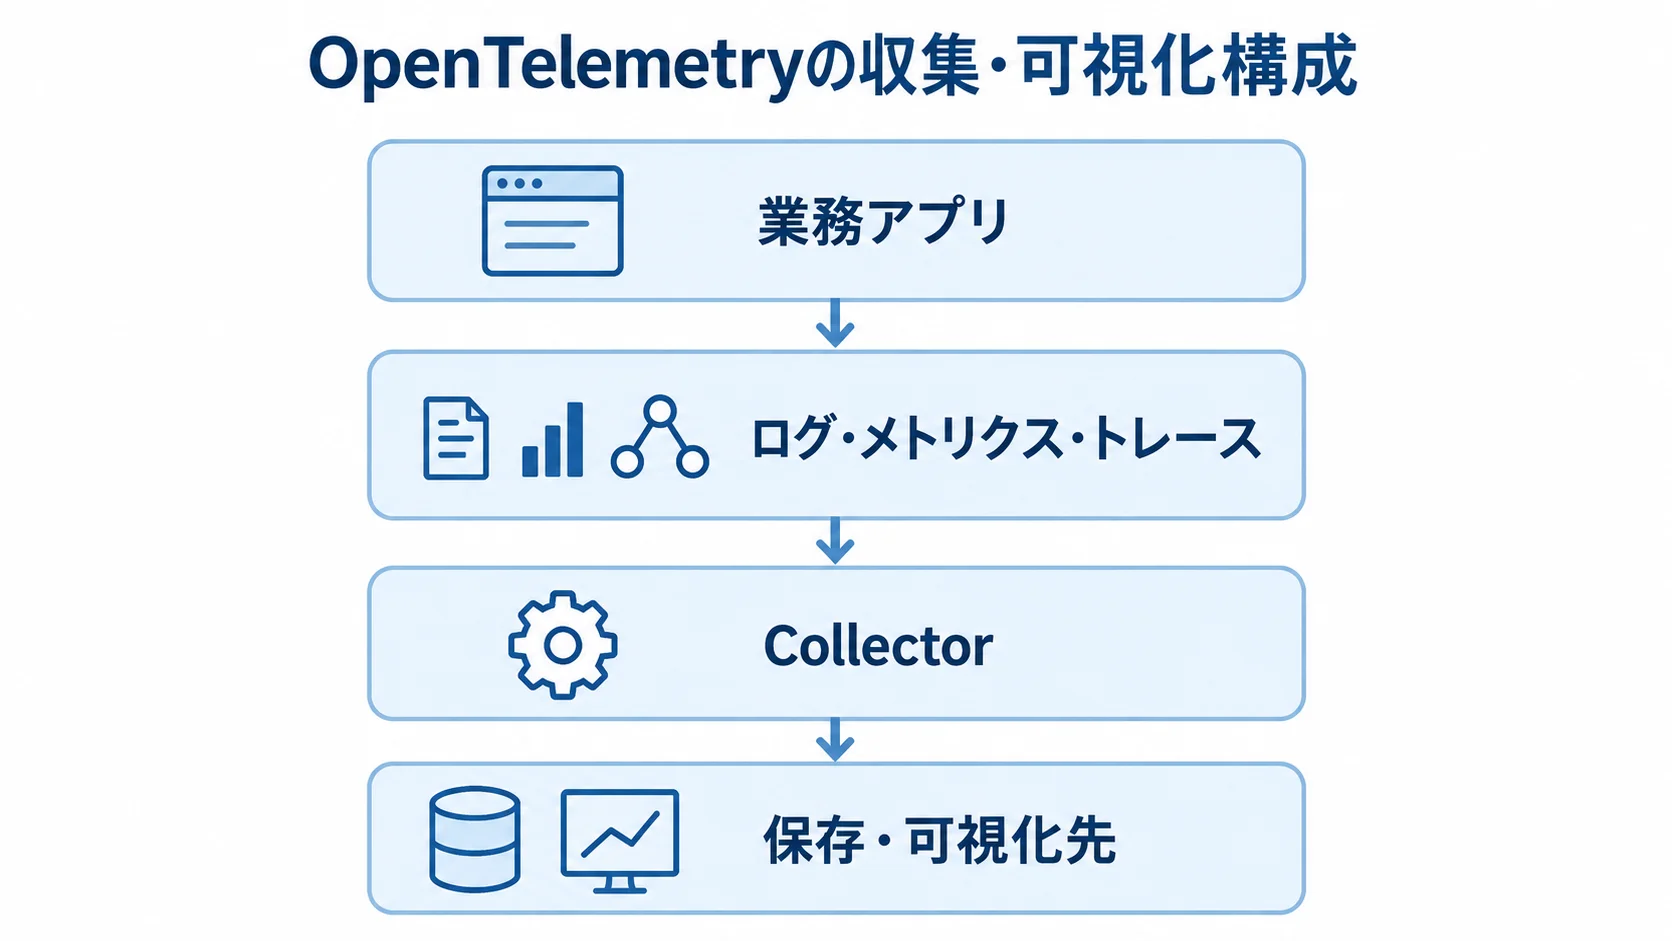
OpenTelemetryは、業務アプリに組み込んでテレメトリを共通形式で集める仕組みです。
導入では、何を監視するかだけでなく、どの業務の失敗を誰が何分以内に判断するかも決めておきます。
注文処理を例にすると、注文APIのエラー率や決済APIのP95レイテンシを追います。さらに、在庫DBの遅延や注文完了率も関連付け、原因分析に使える状態へ整えます。
ログ・メトリクス・トレースの相関
3種類の信号は、それぞれ役割が違います。そこで、共通のサービス名や環境名を付けて、同じ処理を追える形にします。
- メトリクス:リクエスト数、エラー率、CPU使用率、レイテンシを時系列で示します。
- ログ:アプリケーションのエラーや監査イベントの詳細を残します。
- トレース:1回のリクエストが、API Gateway、注文サービス、データベース、外部決済サービスを通る経路を表します。
ログにTrace IDを引き継いでおくと、エラーの記録から該当するリクエストを開けます。
共通の属性を揃えておけば、遅延したサービスやSQLを確認できます。
Collectorとバックエンドの分離設計
Collectorは、receiver、processor、exporterで構成され、信号を複数の送り先へ送れます(出典:OpenTelemetry公式「Components」「Architecture」、2026年確認)。
Collectorのprocessorでは、バッチ処理やサンプリングを行えます。ほかにも、属性付与やフィルタリング、機密情報の除去が可能です。
- 送信先:Grafana、Datadog、New Relic、Elastic、CloudWatchなどの中から選ぶ形です。
- 選定軸:クラウド、データ所在地、分析機能、料金、解約時の移行性の観点で比べます。
OpenTelemetryは監視画面や長期保存DBを提供しません。そのため、Collectorの運用費と計算費、保存容量も見積もります。
SaaSの取り込み費と画面作成費も見ておきます。
OpenTelemetryのシステム開発の進め方
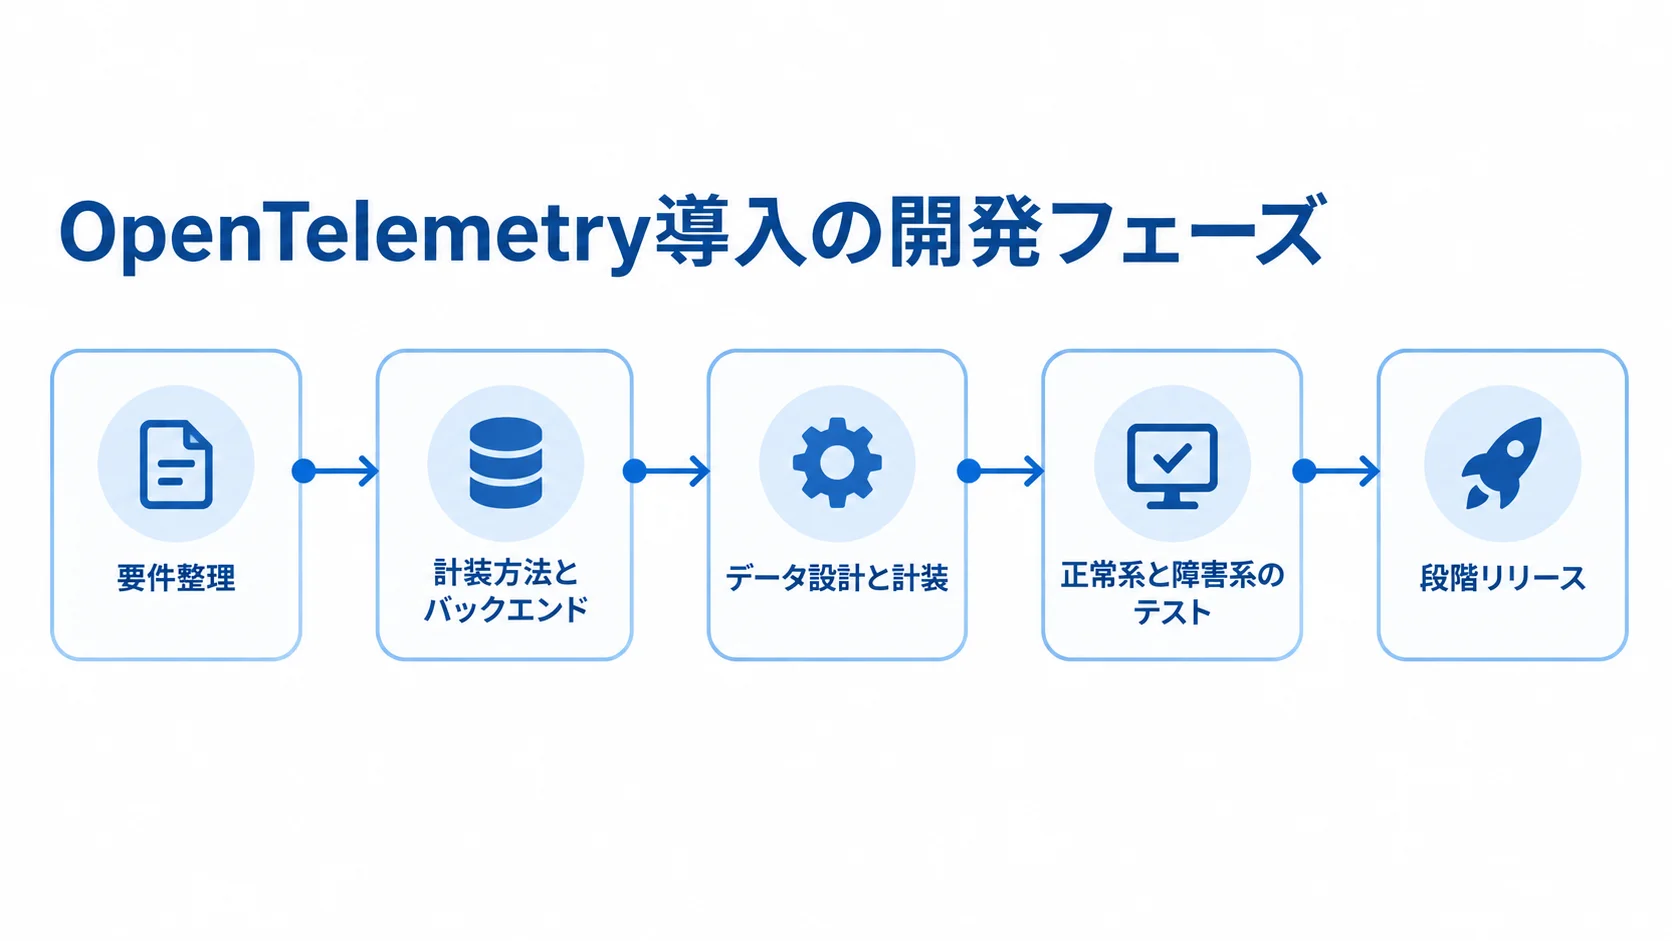
いきなり全サービスを計装せず、業務影響の大きい経路を1つ選んで始めます。
効果・安全性・データ量を検証してから対象を広げ、各段階の完了条件を合意します。
フェーズ1:要件整理による観測の目的と対象の決定
まず、サービスと担当部署、使用言語を洗い出します。次に、実行環境や既存のログ・メトリクス・APM、障害対応手順も確認します。そのうえで、売上や顧客体験に直結する業務を1つから3つ選びます。
- 判断基準:P95レイテンシが何秒を超えたら調査に入るかの線引きです。
- 検知と対応:注文失敗を何分以内に検知するかと、誰が一次対応するかを決めます。
- 導入効果:平均復旧時間、エラー率、SLO違反件数を目的と結び付けます。
ただし、単一サーバーでログも未整備なら、全信号の導入を急ぐ必要はありません。先にログ形式や時刻を揃える判断も適切です。
この段階で作るものは、対象一覧と重要トランザクションです。そのほかに、信号ごとの目的と目標SLO、担当者と概算データ量も記録します。
フェーズ2:計装方法とバックエンドの選定
複数の言語を使うなら、自動計装で取れる範囲と、手動計装が必要な処理を確認します。
注文番号や決済結果などは、標準のHTTP属性だけでは表せないため、個人情報を含めない業務属性として設計します。
計装の範囲と機密情報の扱いを決めたら、Collectorの配置を選びます。
- Collectorの配置:ホストやPodのエージェント、クラスタ境界のGateway、またはその両方から検討します。
- マネージド基盤:短期間で導入するなら、Datadog、New Relic、Grafana Cloud、CloudWatchなどが候補に挙がります。
- 既存基盤の活用:Collectorから既存のPrometheusやLokiへ送る方法もあり、TempoやElastic Stackも対象に入ります。
比較するときは、同じ質問票を各社に使います。質問の柱は、OTLPの受信範囲、信号の相関、保存期間です。さらに、サンプリングや輸出性を見るほか、国内サポートと障害時のSLAも確認します。
フェーズ3:データ設計と計装の開発
データ設計では、どの値をどの形式で持つかを先に決めます。Trace IDの出力形式も、そこに含めます。
HTTPやDBなどのSemantic Conventionsを使えば、異なる言語やサービスの値も並べて比べられます。
サービス名にPod名やリクエストIDを埋め込むと、時系列の系列数が増えてしまいます。そのため、固定値と属性値を使い分けます。
- 属性:サービス名や環境、リージョン、版、テナント、処理対象を標準化します。
- Collector:receiverとexporterを選び、パイプラインに組み込みます。
- 加工処理:processorでバッチ、memory limiter、filterを設定し、attributesやtail samplingも加えます。
- 認証と暗号化:CollectorへのTLSと認証の設定。
- 計装と保護:Javaや.NET、Go、Python、Node.jsの自動計装の確認と、不足する業務境界への手動Spanの追加。
APIトークンや秘密鍵は、コードへの直書きを避け、暗号化ファイルやSecretで管理します。
不要なコンポーネントを含めないことも、公式の指針に挙げられています(出典:OpenTelemetry公式「Collector configuration best practices」、2026年確認)。
顧客IDやメール、Authorization、Cookieは、原則として収集しません。本文やパスワード、APIキー、baggage値も、原則として収集対象から外します。
マスキングは、バックエンドへ送る前のアプリか最初のCollectorで行います。
誤送信に備えて、アクセス権限と保存期間、削除手順も決めておきます。
フェーズ4:正常系と障害系のテスト
テレメトリが届くことだけでなく、トレースをたどって原因のサービスまで追えるかを確認します。正常な注文のほか、入力エラーや決済タイムアウトなども再現します。
- 処理の異常:DB遅延、メッセージ再送、外部APIの5xxを再現します。
- 基盤の異常:Collectorの停止やネットワーク断のときに、再送がどうなるかを調べます。
- 相関の確認:ログとトレースのTrace ID、サービス名、版、アラートの重複がそろっているかを見ます。
負荷試験では、通常時とピーク時のデータ量を使い、CollectorのCPUやメモリ、キューの滞留を測ります。
さらに、バックエンドの取り込み制限を確かめます。あわせて、性能への影響や、機密情報がテスト環境に残らないことも確認します。
全量を保存する前提は置かず、エラーや遅いリクエストは高い割合で残します。また、成功した低リスクのトレースのサンプリング方針は、試験データで決めます。
復旧手順は、担当者だけでなく当番の人にも読める状態にしておきます。
フェーズ5:段階リリースによる稼働
最重要サービスの1つか、1クラスタ、あるいは限られた時間帯から始めます。また、既存のAPMやログ基盤も一定期間並行して稼働させます。
- 比較する内容:データ欠損と二重計装、アラート差を見るほか、検索性能と月額料金も見ます。
- 切り戻し:問題がなければ対象を広げ、サービス単位で戻せるよう設定をコードで管理します。
本番の前には、TLS証明書の更新や認証情報の保管、Collectorの冗長化を確認します。また、キューとバックプレッシャー、障害時の退避、画面の閲覧権限も確かめます。
確認項目には、個人情報の除去や保存期間、月額上限アラートも含まれます。
Collector自身のメトリクスも観測対象に含めます。そうすれば、収集基盤の停止も検知できる状態になります。
フェーズ6:運用と改善の定着
誰がどの画面をいつ見るか、どの条件で連絡するかを手順にしておきます。アラートは技術指標だけでなく、SLO違反や決済失敗など、顧客への影響とも結び付けます。
- アラート対応:判断までの時間、連絡先、暫定回避策、恒久対応の担当を決めておきます。
- 月次改善:取り込み量、保持期間、上位属性、未使用の画面、誤検知を、月ごとに見直す項目です。
- 運用の標準化:計装テンプレートや版の属性、個人情報レビュー、障害訓練を決め、属人化を防ぎます。
- 運用移管:外注するときは、Runbookや教育、障害訓練、保守窓口を納品物に含めます。
OpenTelemetryのシステム開発にかかる費用相場
費用は、ライセンス料のほかに、計装やCollector、画面、連携の作業によって変わります。加えて、セキュリティやテスト、移管の範囲でも変わります。
バックエンドへの取り込み量と保持期間は、毎月の費用を左右します。
ここで示す金額は、業務システム一般の人月単価と公開料金を組み合わせた推定で、個別案件の確定見積ではありません。
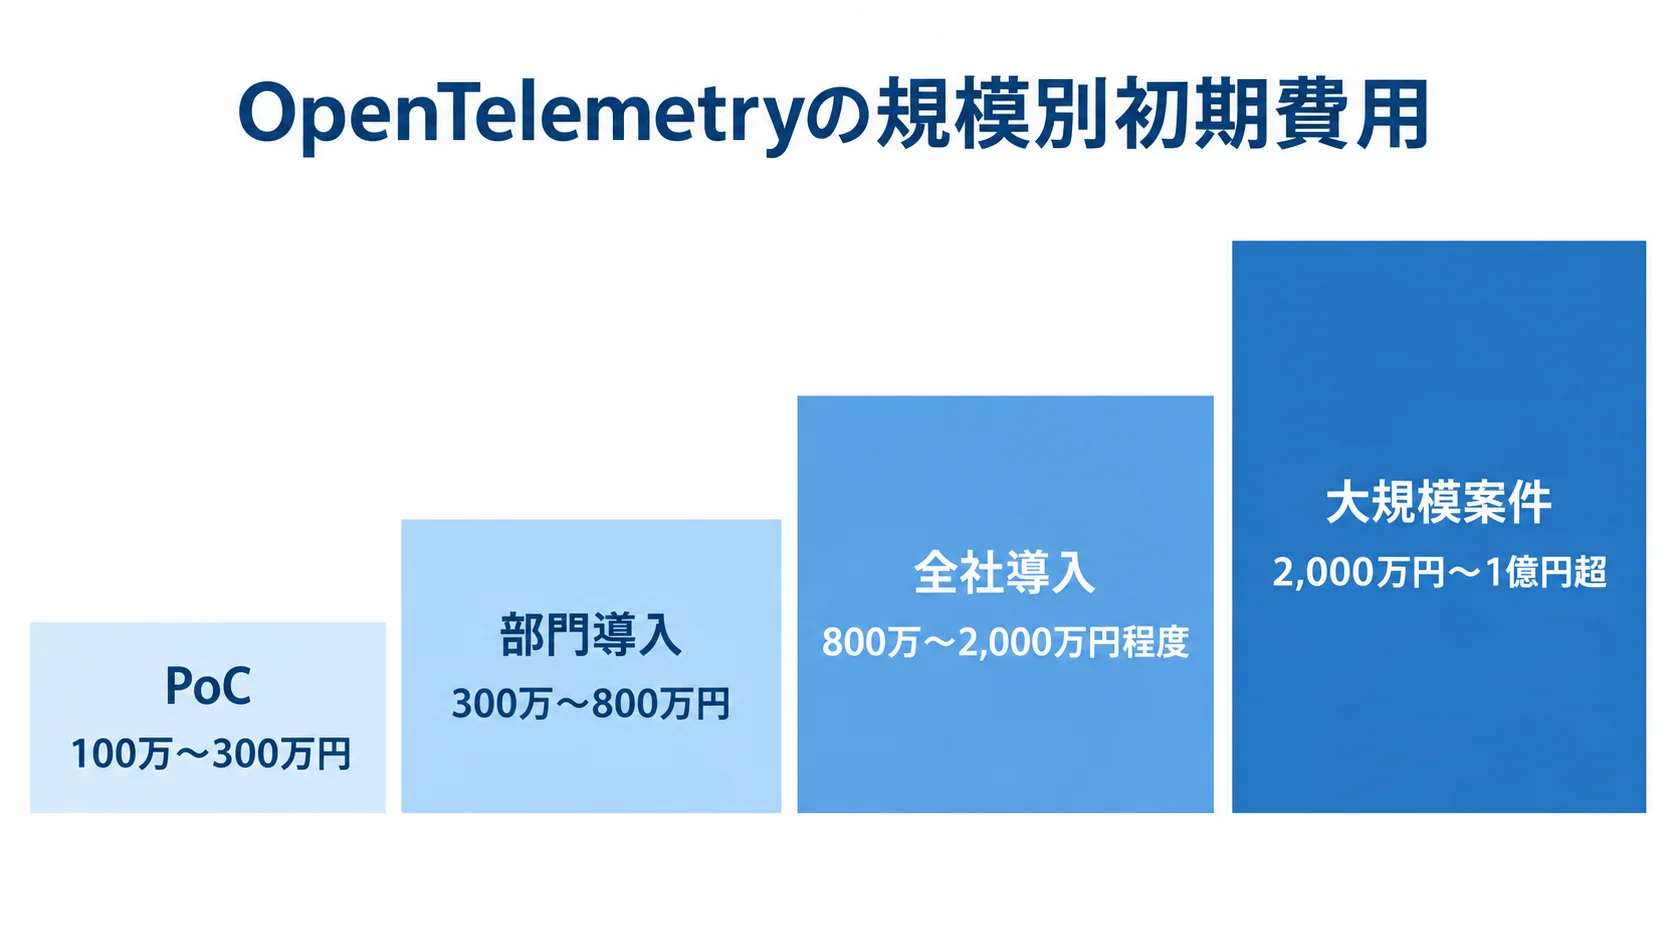
初期費用の規模別レンジ(100万円から2,000万円超)
規模別の初期費用は、推定レンジで示します。
- PoC:1〜3サービス、1言語、Collector 1系統、基本画面が対象で、100万〜300万円、2〜6週間程度です。
- 部門導入:5〜20サービス、複数言語、Kubernetes、3信号、通知連携が対象で、300万〜800万円、1〜3か月程度です。
- 全社導入:20〜100以上のサービス、複数クラスタ、冗長化、PII対策、SLO、既存基盤の移行が対象で、800万〜2,000万円程度です。
- 大規模案件:初期費用が2,000万円から1億円超となる可能性があります。
これらの金額に、業務アプリケーション本体の刷新費用は含みません。推定は、拠点・クラウド横断を含む場合のものです。さらに、次の範囲も含めています(出典:NotebookLM「業務システム全般_16」Q&AをOpenTelemetry向けに再構成、2026年)。
- 監査・DR:監査対応と災害復旧の範囲
- SIEM連携:セキュリティ監視基盤との連携
- 24時間監視:24時間体制の監視
- 運用移管:運用の引き継ぎ
ランニングコストを左右するデータ量・系列数・ホスト数
利用量に応じた課金と推定レンジを確認します。
- 課金軸:プラン、ホスト数、取り込みGB、active seriesで料金が決まります。さらに、ユーザー数やインデックス率、保持期間などでも変わります。
- 公開単価:Grafana CloudとDatadogは、利用量に応じた料金体系です。
- 月額の推定:PoCは0〜5万円、部門利用は5万〜30万円、全社利用は30万〜150万円以上です。いずれも、規模と保存方針による仮置きです。
たとえば、Grafana Cloud Proは月19米ドルからです。メトリクスは、1,000 seriesあたり6.50米ドルからです(出典:Grafana Labs「Grafana Pricing」、2026年確認)。
DatadogのManaged Platform OTLPは、取り込みスパン1GBあたり0.50米ドルです(出典: Datadog「Pricing」、2026年確認)。価格は契約、地域、為替、利用量によって変わるため、単価だけでなく、自社の実測値で試算します。
月額を抑えるには、成功したトレースを全量保存せず、エラーや遅延、重要業務を優先します。低価値なログの属性や本文は減らし、必要な期間だけ保持します。
保守・運用費は、業務システム一般の目安として初期費用の年15〜25%を置きます。SaaS費とクラウド費は、別々に見積もります。
見積もりを取る際のポイント
見積もりを比べるときは、作業だけでなく、データ量と運用責任の前提も見ます。「一式」と書かれていると、対象数や計装範囲が分からず、追加費用につながることがあります。
見積書に書く対象範囲と完了条件
対象範囲と納品物を具体的に書き、作業や完了を後から判定できる形にしておきます。
- 対象:サービス、言語、ホスト・Pod・クラスタ、環境、信号、既存監視を一覧にします。
- 連携先:外部API、データベース、メッセージ基盤も、対象一覧に入れます。
- 計装・Collector:自動計装か手動Spanの追加か、エージェントかGatewayか、冗長化と更新範囲を分けて記載します。
- 納品物:構成図、設定、方針、属性規約、PII対策を明記します。そのほか、画面、アラート、試験結果、Runbook、教育記録も含めます。
- 完了条件:決済障害時に外部APIとDBの遅延を判定できることなどを、完了の基準として定めます。
RFPで分けて確認する料金・安全性・移管の質問
同じ条件で各社を比べ、料金と安全性、移管の責任と経験を確かめます。
- 料金前提:GB、ホスト、series、保持日数、サンプリング率と、その決定者を聞いておきます。
- 安全性:PIIやAuthorizationの削除場所と、変更の承認者を示してもらいます。
- 移管と対応:別の基盤へ移れるかどうかと、24時間の障害対応の範囲を確認します。
- 開発経験:Kubernetesやマルチクラウド、SRE、障害訓練、APM移行、セキュリティ設計の経験を持つ会社かを見ます。
初期費用が低くても、対象外の作業が別料金になる場合、TCO(総所有コスト)が上がることがあります。
Elasticは2025年に、OpenTelemetryの自社ディストリビューションを一般提供しました(出典:Elastic「Elastic Distributions of OpenTelemetry GA」、2025年)。
AWSも、CloudWatch Application SignalsでOpenTelemetry Metricsのカスタムメトリクスに対応しました(出典:AWS「Custom Metrics now available in Amazon CloudWatch Application Signals」、2025年)。
対応製品が増えているため、製品名だけでなく、移行性と運用体制も比べます。
セキュリティと個人情報の責任分界
URLや識別子、注文番号、ネットワーク情報、エラー本文には、個人情報や営業秘密が含まれることがあります。
OpenTelemetryを使っても、個人情報保護法の対象となることに変わりはありません。
- 取扱条件:規程と契約に沿って、個人情報の扱いを定めます。
- 技術対策:TLS、Collector認証、Secret、最小権限、閲覧権限の設定を見ます。
技術面では、マスキング試験や本文収集、保持・削除、所在地、アクセス監査も確かめます。
収集目的と最小限の項目、委託先を整理します。そのうえで、保存期間や越境、削除請求、事故時の対応も決めておきます(出典: 個人情報保護委員会「個人情報保護法ガイドライン」、令和7年3月24日施行版)。
公式の情報でも、PIIを含むテレメトリの保護や改ざん防止、DoS対策が挙げられています(出典: OpenTelemetry公式「Security」、2026年確認)。
見積もりの時点で範囲を決めておくと、稼働後に収集が止まるリスクを抑えられます。
よくある質問(FAQ)
導入の要否や既存製品との併用、費用、自社運用について、発注前に判断できるよう答えます。
OpenTelemetryのシステムは監視製品ですか?
OpenTelemetryは、画面や長期保存DBを単独では提供せず、テレメトリの生成や収集、処理、送信を標準化する枠組みです。
そのため、Collectorに加えて、Grafana、Datadog、New Relic、Elastic、CloudWatchなどを組み合わせます。その組み合わせで、検索や可視化、通知ができます。
既存のDatadogやPrometheusと併用できますか?
併用できます。CollectorからOTLPで受け取り、Datadog、Prometheus、Loki、Tempo、Elastic、CloudWatchなどへ出力できます。
ただし、同じアプリに自動計装を二重に入れると、Spanと費用が増えます。そのため、計装範囲や属性、サンプリング、並行期間、切り戻し条件を決めておきます。
小規模な単一サーバーでも導入するべきですか?
複数サービスや外部APIの経路を追う場合は効果が見込めます。ただし、すべての単一サーバーに必要とは限りません。
まず、ログや時刻、リクエストID、基本メトリクスを整えます。そのうえで、既存監視では原因が分からない経路をPoCの対象にします。
導入作業と月額のデータ費を、調査時間の削減や顧客影響の抑制と比べて判断します。
トレースやログはすべて保存する必要がありますか?
全量を保存する必要はありません。エラーや遅延、重要取引、監査イベントを優先し、成功した低リスクの処理や重複ログは減らします。
保持期間は、障害対応や監査、個人情報管理、契約要件から決めます。そのうえで、サンプリング率と保持日数を見積書や手順に記載します。
まとめ
OpenTelemetryの開発は、ツールを入れるだけでなく、業務への影響に沿って観測・分析・対応を設計する取り組みです。信号を相関させ、Collectorで加工や保護を行い、適切な基盤で可視化します。
6フェーズによる小さな開始と段階的な拡大
要件整理から始め、選定、設計と開発、試験、段階稼働を経て運用へ進みます。各工程で、目的と完了条件を確かめます。
障害と負荷を試し、既存監視と並行して展開します。さらに、アラートやRunbook、担当者、費用を見直せば、収集量が多すぎることによるコスト増を抑えられます。
TCOと運用移管を含めた比較
サービス数やデータ量、保持期間、サンプリングを並べて見積もります。さらに、従量課金や保守、障害対応、移管も含めて比べます。
機密情報の除去や障害再現、既存監視からの移行、稼働後の改善担当を確認します。重要業務のPoCで効果と費用を測ってから、全社展開を判断します。
▼全体ガイドの記事
・OpenTelemetryのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。