
方策勾配法は、状態ごとに行動を選ぶ確率(方策)をパラメータで表し、期待累積報酬が大きくなる方向へそのパラメータを直接更新する強化学習の手法です。
Q学習が行動価値を推定してから方策を作るのに対し、方策勾配法は方策そのものを更新します。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
方策勾配法による行動確率の更新
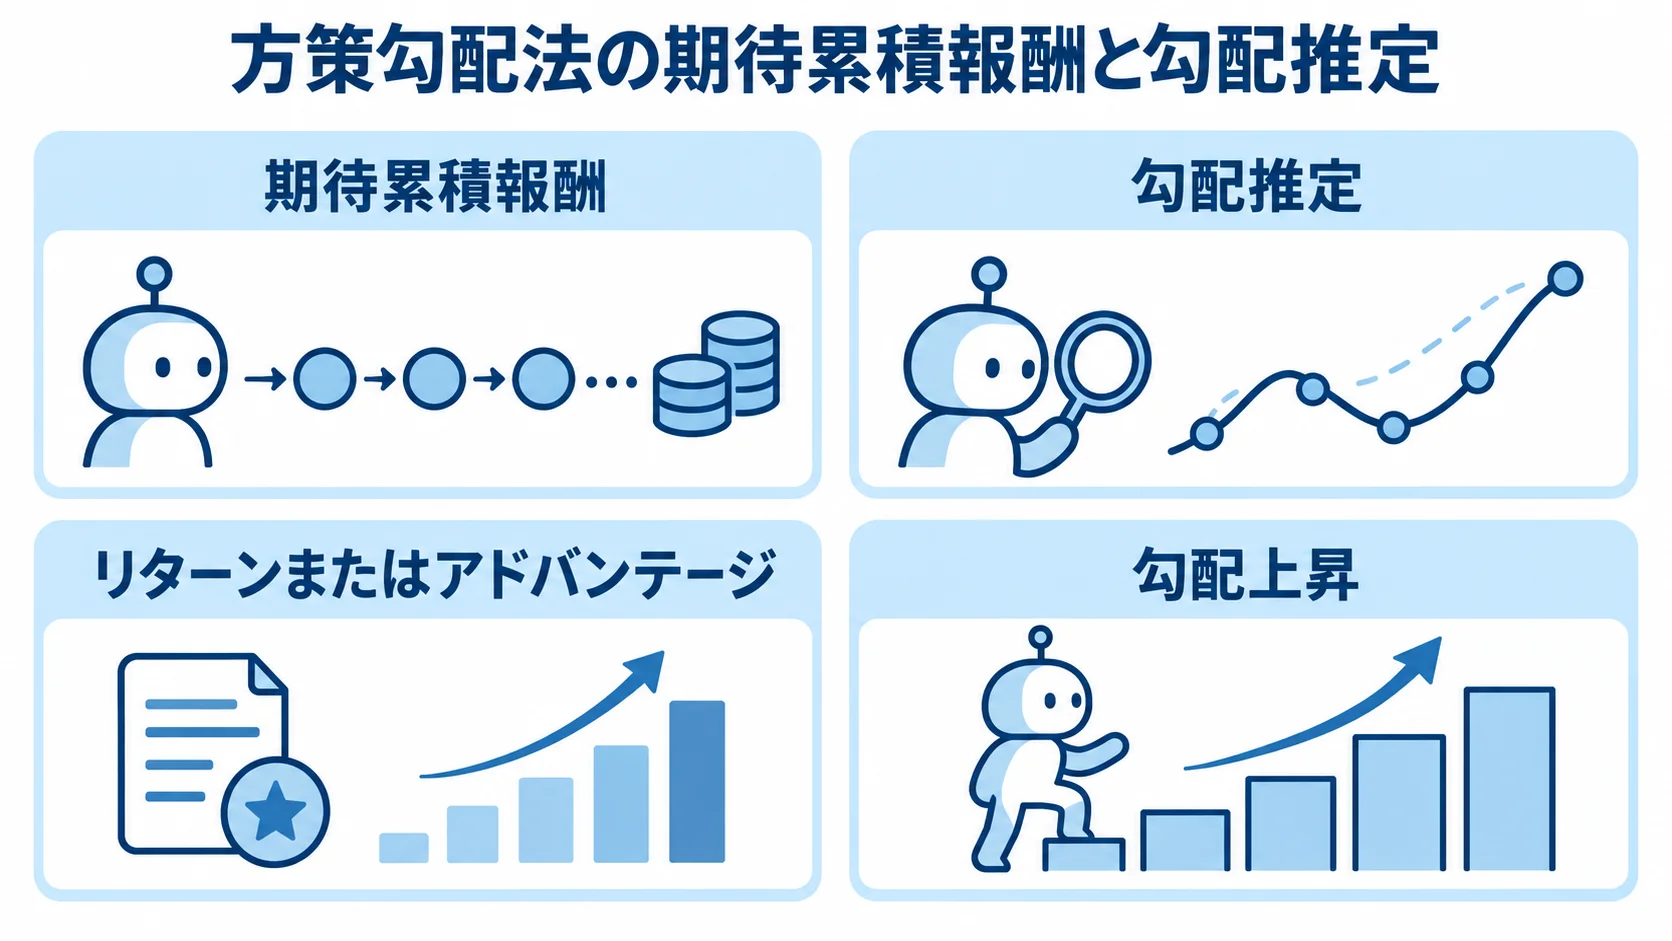
方策πθ(a|s)は、状態sで行動aを選ぶ確率をパラメータθで表したものです。方策に従って軌跡を集めたあと、得られたリターンの大きさに応じて、行動の対数確率を増減させます。OpenAIのSpinning Upも、要点を高いリターンにつながる行動の確率を押し上げることだと説明しています。
確率的な方策は扱いやすく、連続行動のロボット制御やゲーム、資源配分などに利用できます。一方で、報酬のばらつきが大きく、データ効率や探索、更新の安定性に課題があります。
目的関数と期待リターン
方策の良し悪しは期待リターンで測られ、学習はその値を高める方向へパラメータを動かすことで進みます。目的関数の定義と勾配の求め方が分かれば、実装の流れもつかめます。
- 目的関数:J(πθ)は、方策に従ったときの期待累積報酬です。
- 勾配推定:軌跡τをサンプリングし、∇θlogπθ(at|st)にリターンまたはアドバンテージを掛けて求めます。
- 最適化方法:勾配上昇で目的を最大化するか、符号を反転した損失を勾配降下で最小化します。
確率的方策に含まれる探索
行動は確率分布からサンプリングされるため、ε-greedyのような外付けの探索規則がなくても、未知の行動を試せます。
学習が進むと、分布は高報酬の行動へ集中しやすくなります。ただし、その集中が早く進むと、局所解に固定されてしまいます。そのため、探索を保つ設計として、エントロピー正則化などを検討します。
REINFORCEによる軌跡のリターンを使った更新
REINFORCEは、最も基本的な方策勾配法です。まず、エピソードを最後まで実行し、各時点の報酬からリターンを計算します。
そのうえで、logπにリターンを掛けて勾配を求めます。偏りの少ない推定を作りやすい一方で、エピソードが終わるまで更新できず、リターンの分散が大きくなりやすい手法です。
ベースラインによる勾配の分散の抑制
リターンから状態価値V(s)などのベースラインを引いても、期待値としての勾配は変わりません。ベースラインは、この性質を利用して勾配の分散を抑える目的で使われます。
アドバンテージA(s,a)は、実際のリターンが予測価値をどれだけ上回ったかを表します。そのため、同じ状態で平均的な行動より良かったかを学習できます。実装では、学習の途中でベースラインの推定誤差と更新頻度も記録します。
最新方策のデータを使うオンポリシー法
基本的な方策勾配は、現在の方策で集めたデータを使って更新します。古いデータは再利用しにくい一方で、推定の前提は明確です。
更新前の方策と大きく異なるデータを混ぜると、確率比や重み付けが必要になります。その場合、学習が不安定になることがあります。
アクター・クリティックによる方策と価値の同時学習
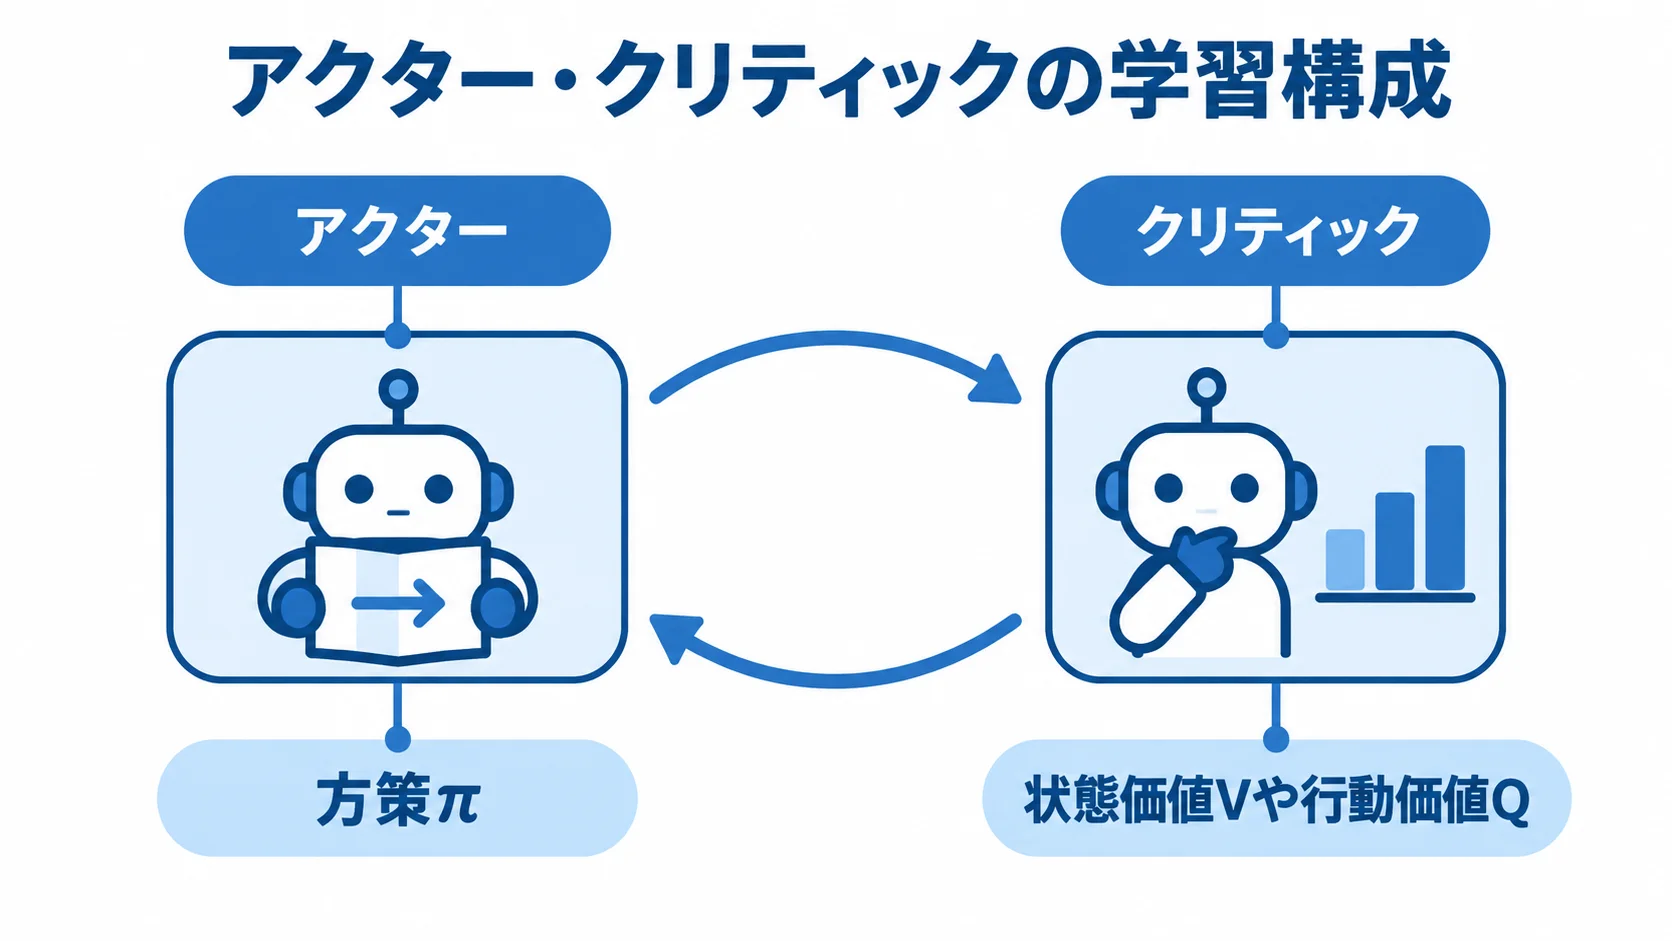
アクターは方策πを、クリティックは状態価値Vや行動価値Qを推定します。クリティックの価値をベースラインに使い、アクターの勾配を短いステップごとに更新します。
REINFORCEと比べると分散を抑えやすい一方で、価値推定の偏りが方策へ伝わります。また、アクターとクリティックの学習率や更新回数も調整します。
実装では、学習データの収集から方策の評価まで、次の順で進めます。
- 推論時点で利用できる特徴だけを方策ネットワークへ入力します。
- 確率的方策から行動をサンプリングし、環境へ適用します。
- 軌跡、終了条件、マスクとともに報酬や次状態を記録します。
- TD誤差やGAEなどの方法を比較し、価値とアドバンテージを推定します。
- 勾配、学習率、エントロピー係数を管理しながら、方策を更新します。
- 探索を含む学習と、固定した評価用方策を分けます。
連続行動では、方策が正規分布などの平均と分散を出力します。行動の範囲は環境の制約に合わせて変換し、確率密度と変換の補正を正しく実装します。
連続行動は、離散行動のsoftmaxとは別の前提で扱います。そのため、境界付近の挙動をテストします。
PPOによる方策更新の幅の制限
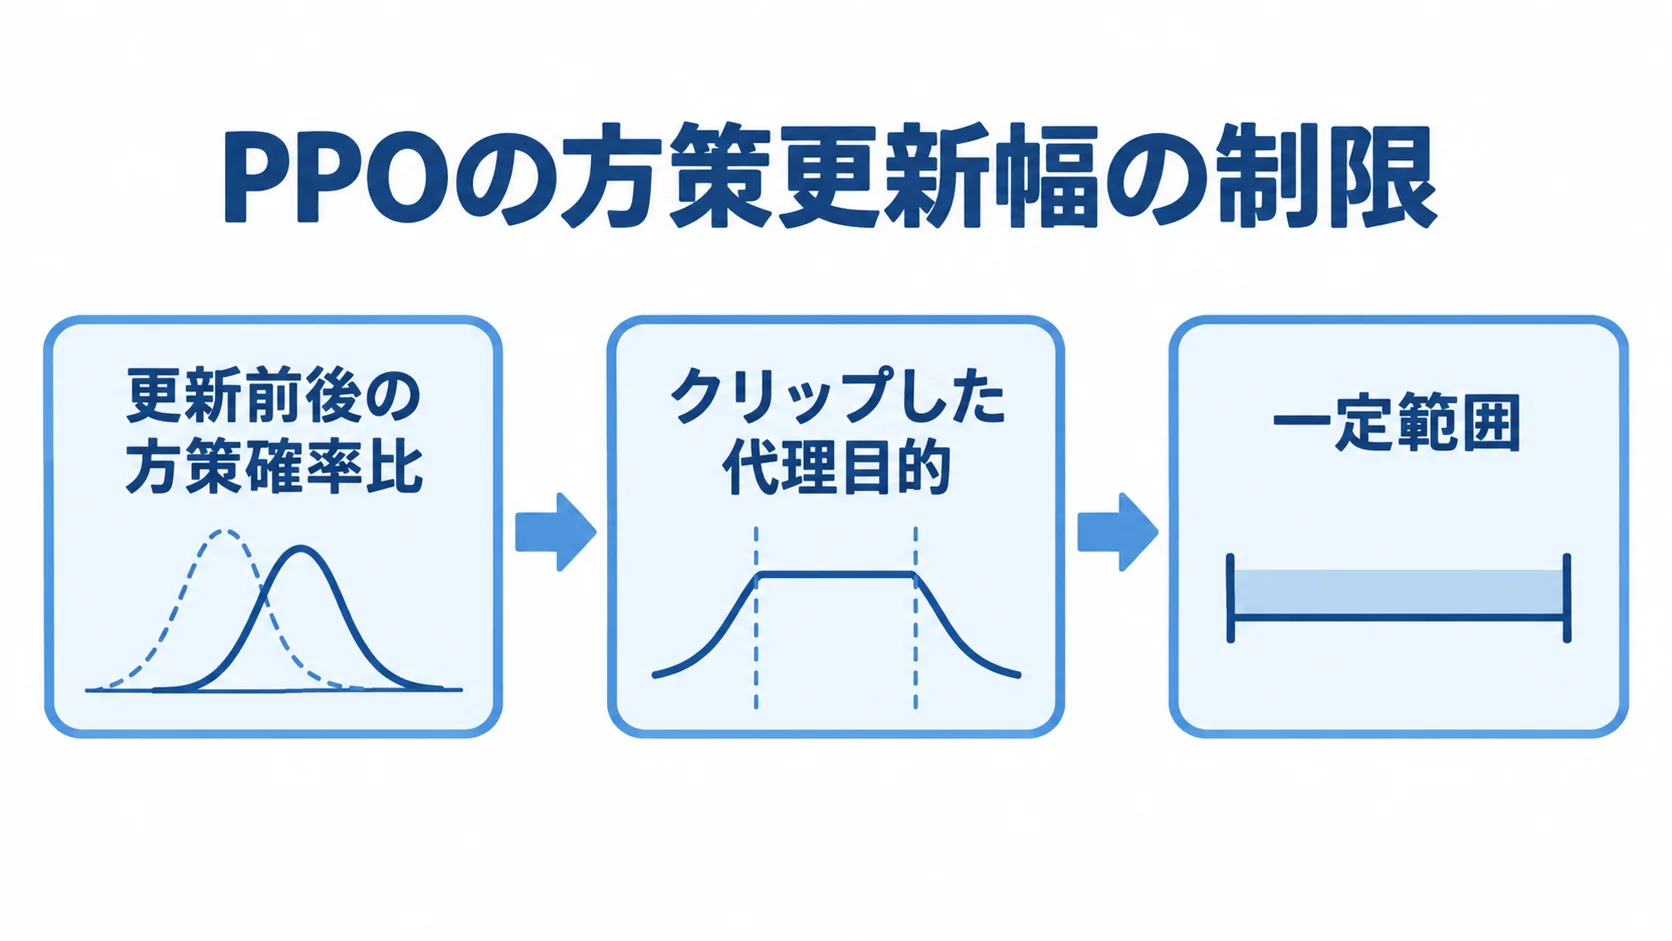
方策を一度に大きく変えると、集めたデータが新しい方策に合わなくなり、性能が崩れることがあります。そこでPPOは、更新前後の方策確率比をクリップした代理目的を使い、一定範囲を超える更新の効果を制限します。また、OpenAI Spinning Upは、VPG、TRPO、PPOを方策最適化の系譜として整理しています。
PPOでは、クリップ率とエポック数が結果に影響します。ミニバッチやKLダイバージェンスも、結果を左右する要素です。加えて、価値損失やエントロピー係数も確認します。
学習が進まないときは、更新回数を増やすだけでなく、方策の変化量とアドバンテージの分布も確認します。
方策勾配法の報酬・安定性・安全性による評価
エピソード報酬の平均に加えて、成功率や制約違反を計測します。さらに、行動の分散や、学習に必要な環境ステップ数も計測します。
確率的な学習では、シードによる差が大きいため、複数回実行して中央値や分位点を示します。また、検証環境とテスト環境を分けます。報酬関数を調整したあとは、テスト結果だけで方策を選ばないようにします。
現実の制御や推薦で方策が直接行動すると、探索の影響が利用者や設備にまで及びます。そのため、開発会社はまずシミュレーターやログ上のオフライン評価を使います。
人間の承認も取り入れ、危険な行動には上限を設けます。さらに、新方策の導入後は、旧方策との比較、停止条件、ロールバックを監視します。
方策勾配法で起きやすい失敗と対策
勾配の分散の大きさと学習の揺れ
勾配が揺れるときは、まずエピソード長や報酬スケール、バッチサイズを確認します。あわせて、アドバンテージの正規化も見ます。
価値ベースライン、GAE、報酬のクリッピングは対策の候補です。ただし、過度な正規化で重要な差を消さないように注意します。
探索の早すぎる停止と局所解への固定
探索が止まるときは、方策エントロピーや行動分布を確認します。さらに、初期化と報酬のスパースさも見ます。
エントロピー係数を調整し、カリキュラムや安全な探索を設計します。ただし、ランダム行動を増やすだけでは、解決しない場合もあります。
代理報酬の最大化と本来の目的からの逸脱
報酬を構成する各項目と制約違反をログに残します。そのうえで、代表的な軌跡を人が確認します。
評価には、利用者満足や品質、安全などの複数の指標を合わせます。コストも指標に加えて、報酬の外で起きる悪化を見逃さないようにします。
方策を直接改善する強化学習という位置づけ
方策勾配法は、行動の対数確率とリターンまたはアドバンテージから勾配を推定し、期待累積報酬を高める手法です。また、連続行動や確率的な探索を扱いやすい手法として、REINFORCE、アクター・クリティック、PPOなどへ発展しています。
導入では、オンポリシーのデータ収集、報酬と制約、勾配の分散を管理します。さらに、方策の更新幅と評価シードも管理します。
安全な検証環境と停止手段を用意したうえで、採用を判断します。その際は、平均報酬だけでなく、再現性や制約違反、本番との差も見ます。
よくある質問(FAQ)
方策勾配法を検討するときによくある疑問に答えます。
Q. 方策勾配法とは何ですか?
方策をパラメータ化し、期待累積報酬が高くなる方向へ方策のパラメータを直接更新する強化学習手法です。
Q. Q学習との違いは何ですか?
Q学習は行動価値を推定して間接的に方策を作ります。一方、方策勾配法は方策自体を更新します。連続行動や確率的方策の扱いやすさも、両者を比べる観点になります。
Q. REINFORCEとは何ですか?
エピソードのリターンを使い、行動の対数確率を高める最も基本的な方策勾配アルゴリズムです。分散が大きくなりやすいため、ベースラインを組み合わせます。
Q. PPOは方策勾配法ですか?
はい。PPOは方策最適化の更新幅をクリップした、代表的な方策勾配系のアルゴリズムです。
Q. 方策勾配法をすぐ本番へ導入できますか?
すぐには導入せず、まずシミュレーションやオフライン評価で段階的に検証します。そのうえで、安全制約や人間の承認、停止・ロールバックを用意します。
参考資料
方策勾配法やPPOの仕組みを確認する際は、次の資料を参照してください。
- OpenAI Spinning Up「Vanilla Policy Gradient」
- OpenAI Spinning Up「Proximal Policy Optimization」
- OpenAI「Spinning Up in Deep RL」
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。