
傾向スコアマッチングは、観測された共変量から処置を受ける確率を推定し、確率が近い処置群と対照群を比べる方法です。医療や顧客施策、教育介入など、無作為化が難しいデータで交絡を調整したいときに使います。ただし、観測されていない交絡を自動で取り除く方法ではありません。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
傾向スコアマッチングとは?まず押さえる定義と役割
傾向スコアマッチングでは、観測された共変量から処置を受ける確率を推定し、確率が近い処置群と対照群を並べて比べます。観測された交絡のバランスをとる補助にはなりますが、観測されていない交絡までは自動的に取り除けません。
説明する側は、入力データと推定する対象を分けたうえで、得られる出力と仮定も示します。入力が同じでも、目的が予測か効果推定かによって評価方法は変わります。結果を読む人が再現できるよう、単位と期間、除外条件、欠測値の扱いを記録しておきます。
実務では、手法を使ったという事実より、どの比較を可能にしたかが大切です。たとえば、回帰調整はモデル関数で共変量を調整します。一方、IPWは傾向スコアの逆確率で母集団を再構成します。
マッチングは、比較可能な範囲を明確にしやすい反面、サンプルを捨てることがあります。この違いを曖昧にすると、精度の数字を因果効果と誤認したり、検定結果だけで施策を決めたりします。そのため、分析計画には目的と解釈の範囲を明記しておきます。
傾向スコアマッチングの仕組み|計算の流れ
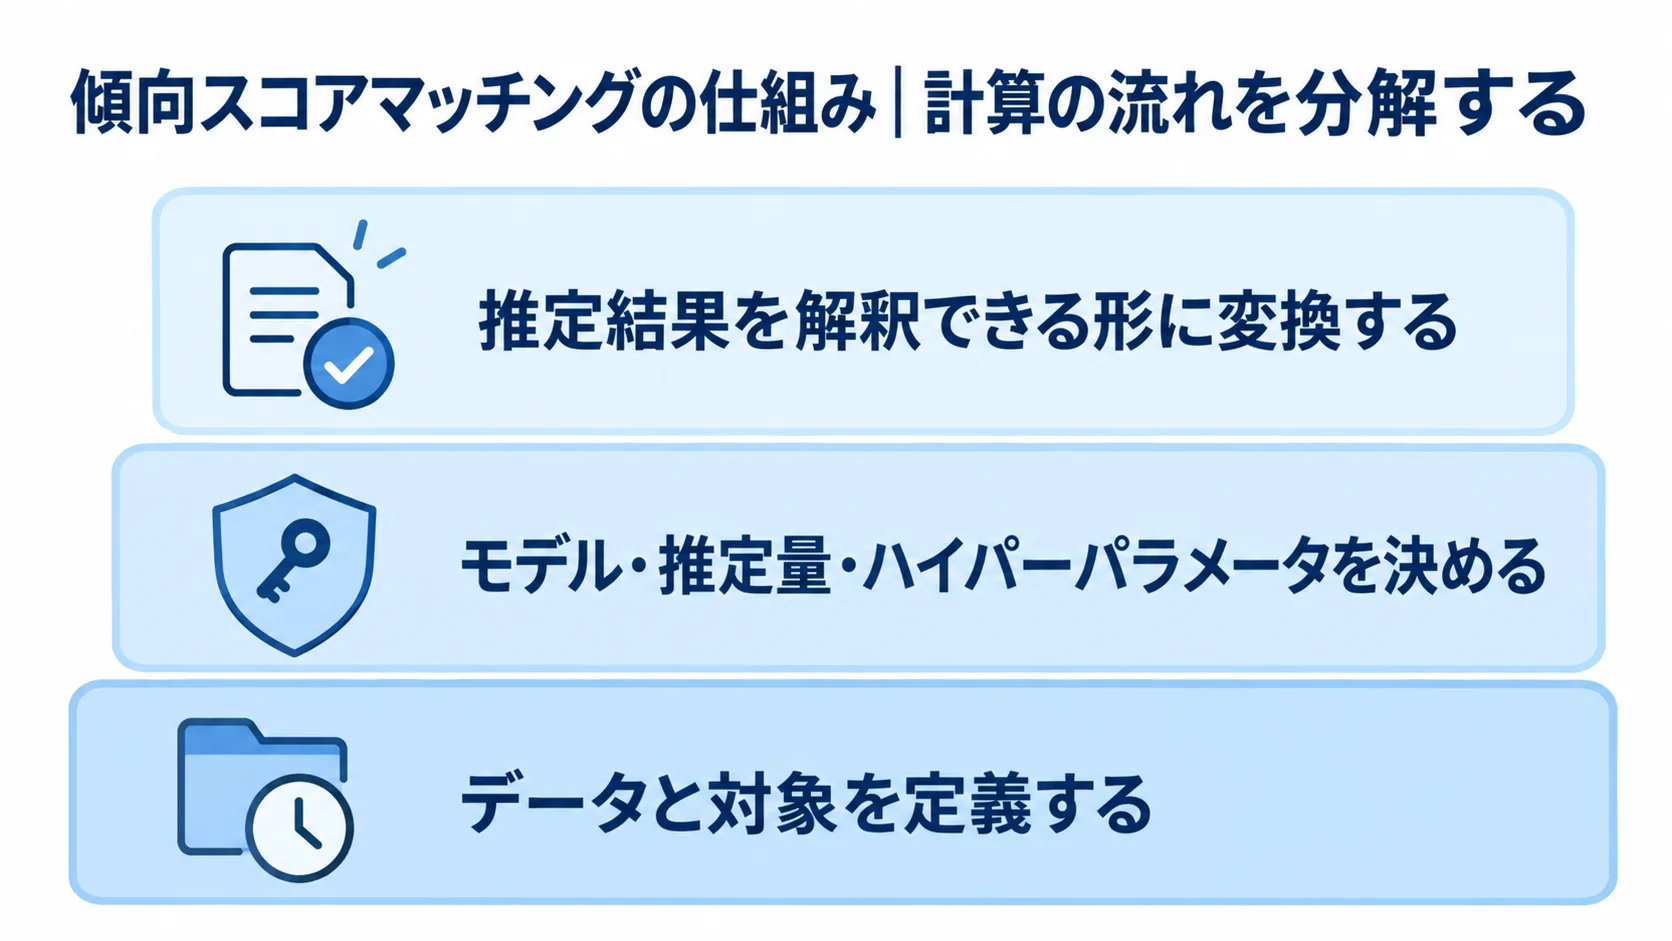
1. データと対象の定義
最初に、観測単位と分析対象期間を決めて固定しておきます。そのうえで、ロジスティック回帰や機械学習で傾向スコアを推定し、最近傍や半径、層別、重み付けなどで比較対象を作ります。
マッチ後は、共変量バランス、共通サポート、処置効果の対象(ATT/ATE)を確認します。特に、データ分割や重み付けを行う場合は、分割の前に全体を見て都合のよい対象を選ぶと、バイアスが入り得ます。また、処理はコード化して、入力件数と除外件数をログに残します。
2. モデル・推定量・ハイパーパラメータの選択
傾向スコアマッチングでは、推定式やアルゴリズムだけでなく、正則化や初期値の設定も結果に影響します。分布やリンクの選び方、窓幅やマッチ基準の決め方によっても、結果は変わります。
候補モデルは複数用意しておきます。テストデータの結果を見て選択の基準を後から決めると、評価が楽観的になってしまいます。そのため、訓練・検証・最終評価の役割を分けておきます。
3. 推定結果を解釈しやすい形への変換
係数やスコアのままでは、利用者が意味を読み取りにくいことがあります。そこで、単位を戻した予測や区間推定、確率、効果量に変換します。
- 結果:推定値を、利用者が判断できる形で示す。
- 指標:適合度や残差などを見る。
- 不確実性:データのばらつきやモデル仮定といった前提も並べて示す。
分析では、標準化平均差と分散比、共通サポートとマッチ率を報告します。さらに、ATT/ATEと感度分析も示します。点推定の数字だけで結論を作らないことも大切です。
# 傾向スコアマッチングの検証フロー(概念例)
prepare_data()
fit_candidate_models()
check_assumptions_and_balance()
evaluate_on_heldout_data()
report_estimate_with_uncertainty()
上のコードは流れを示す概念例です。実装では、前処理を学習データにだけ合わせ、推定の時点で使えない情報を特徴量に混ぜないことが欠かせません。
同じ入力から同じ結果を再現できるよう、乱数シードやライブラリのバージョン、データのスナップショットと設定値を保存しておきます。
傾向スコアマッチングの使い方|実務での適用場面
予測・推定を始める前の設計
無作為化が難しい医療処置や顧客施策、教育介入では、観測できる交絡を調整するためにマッチングを用います。分析を担当する人は、マッチングを解析の前処理と位置づけ、効果推定の標準誤差と、欠落した対象の扱いを適切に定めます。
対象を広げるほど便利に見えますが、外挿や未観測交絡、構造変化、異なる母集団への適用では、仮定が崩れやすくなります。
最初に、「誰の、いつの、どの結果を、どの比較で」知りたいかを一文で書き出します。そのうえで、必要なデータが存在するかを確認します。
小さな検証から本番への移行
まず、簡単な基準モデルや記述統計を作ります。そのうえで、傾向スコアマッチングを追加したときに何が改善するかを測ります。
サンプルを意図的に分けた検証、時系列なら将来期間を残す検証、グループなら同一主体を跨がせない検証を行います。ただし、短期の指標が上がっても、長期の安定性や運用コストが悪化する可能性があります。
結果と意思決定のつながり
分析結果を採用する条件は、事前に閾値で定めておきます。たとえば、誤差が何単位以内なら実務で許容できるか、効果がどの範囲なら投資を正当化できるかを、先に決めます。
傾向スコアの予測性能だけを追うと、バランスが悪化することがあります。そのため、処置後の変数は共変量に入れず、未観測交絡への感度分析や欠測処理、極端なスコアの確認を行います。判断する人が数字の意味を取り違えないよう、グラフや区間と合わせて、反証となる条件も併記します。
傾向スコアマッチングと関連手法の違い
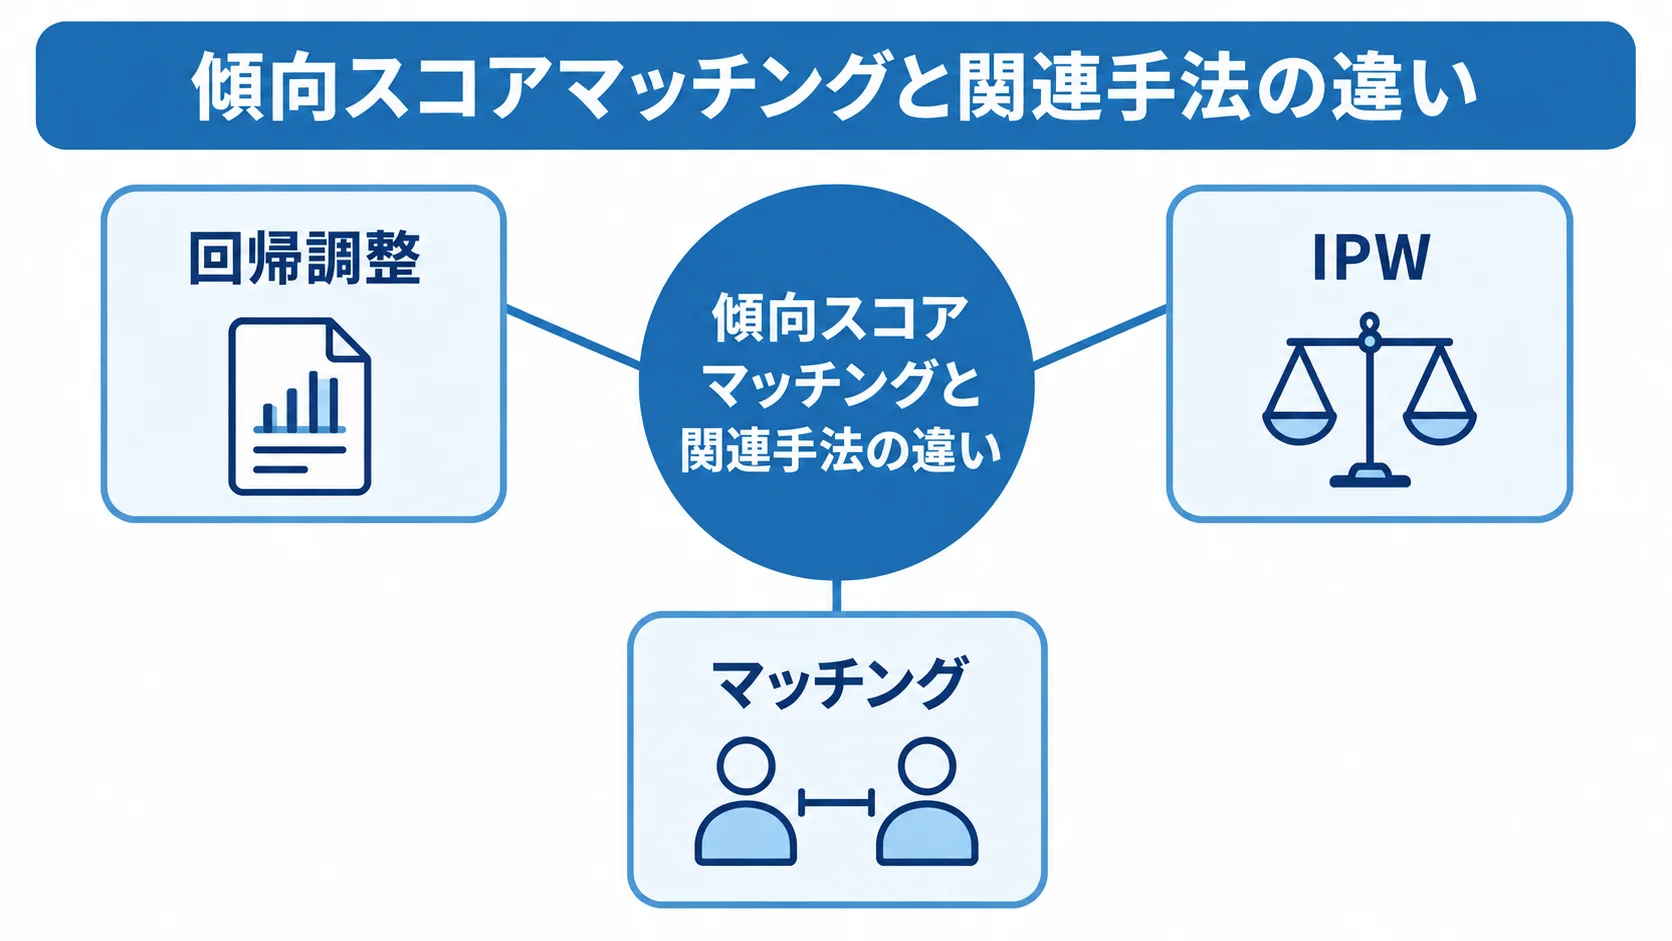
回帰調整は、共変量をモデル関数で調整する方法です。IPWは、傾向スコアの逆確率を使って母集団を再構成します。マッチングは、比較可能な範囲を明確にしやすい一方で、サンプルを捨てることがあります。
関連手法を比べるときは、同じデータ分割と目的変数、評価期間、前処理をそろえて、ベンチマークします。手法によって使える入力や推定の対象が違うときは、単純な順位づけを避け、目的に合う比較の軸を作ります。複雑な手法で得られる小さな改善が、説明や再学習、障害対応の負担に見合うかも、評価の対象になります。
- 仮定と対象範囲を文書にまとめてから、候補手法を選ぶ
- データリークや時間の逆転が起きない分割を採用する
- 点推定と不確実性、実務上の損失をあわせて報告する
- 基準手法との比較を残し、改善の理由をたどれるようにする
傾向スコアマッチングの評価方法|数字だけに頼らない見方
評価指標と不確実性
評価では、標準化平均差と分散比、共通サポートとマッチ率を確認し、ATT/ATEと感度分析の結果も報告します。予測のタスクなら、業務コストに対応した重み付き指標や分位点も検討します。一方で、因果や統計的な推定なら、効果量と信頼区間を中心に読みます。
平均の値だけでなく、期間別やグループ別、極端なケース別の結果も確認して、性能の偏りを見つけます。
仮定と残差・バランスの診断
診断は、結果を良く見せるためではなく、どの仮定が破れているかを探すために行います。残差の自己相関や分散の変化、予測確率の校正のほか、共変量のバランスや収束指標も、手法に応じて選びます。
問題が見つかったら、データの定義とモデルの構造、評価期間のうち、どこを直したかを記録しておきます。
再現性と感度分析
サンプルを変えたとき、事前分布や閾値を変えたとき、主要な共変量を除いたときに、結論がどう変わるかを確かめます。予測性能だけを追うと、バランスが悪化することもあります。
処置後の変数は共変量に含めず、未観測交絡への感度分析、欠測処理、極端なスコアの確認を行います。一つの設定で得た数値を唯一の真の値として扱わず、合理的な選択の範囲で結果が安定しているかを報告します。
傾向スコアマッチングで起きやすい失敗と対策
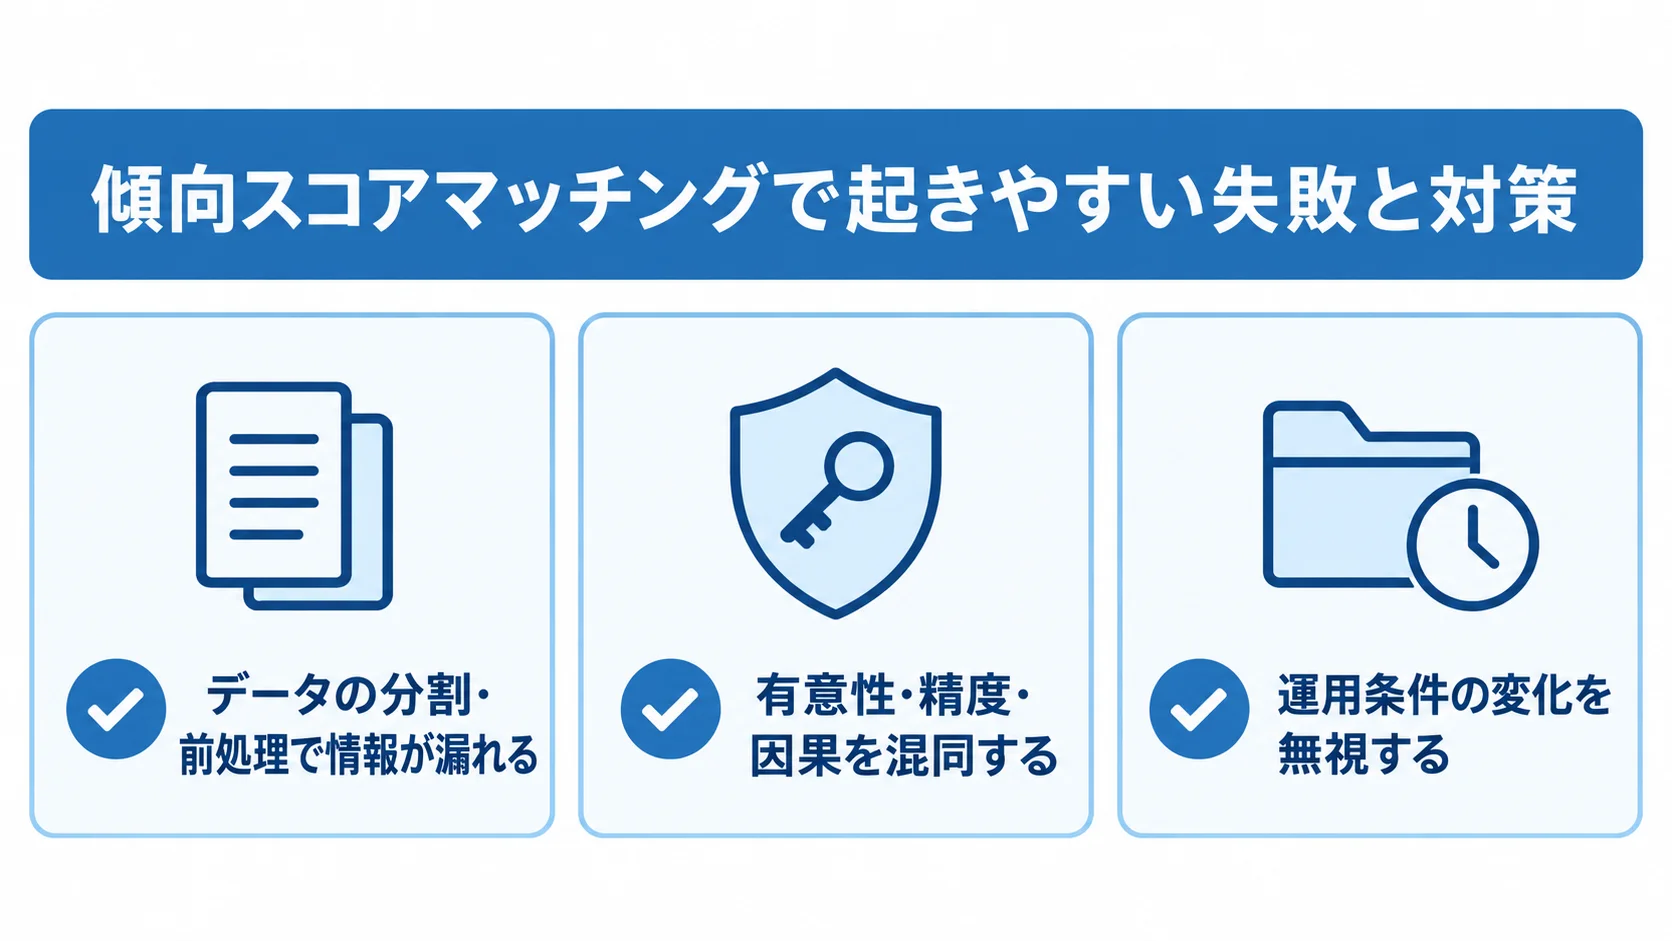
データの分割・前処理による情報漏れ
全データで標準化や補完をしてから分割したり、未来の値を特徴量に使ったり、処置後の情報を調整変数にしたりすると、評価が楽観的になります。
そのため、前処理はパイプラインに含めておき、評価データは一度しか使わない設計にします。
有意性・精度・因果の混同
p値が小さくても、それは効果が大きいことを意味しません。検証誤差が小さいことも、介入の効果が識別できることを示すとは限りません。
傾向スコアマッチングの出力が答えている問いと、意思決定者が知りたい問いを並べてみます。そのうえで、足りない仮定やデータを明示します。
運用条件の変化による見落とし
データの分布や制度、価格は変わり、季節性やユーザー構成も変化します。導入後は、運用の担当者が入力分布や欠測率、予測誤差を監視します。残差や主要グループの結果も見ながら、再学習や再推定の条件を決めます。
監視値が悪化したときは、誰が判断し、どの版へ戻すかまで手順にしておきます。
傾向スコアマッチングを採用する判断基準
採用の前に、目的との適合やデータの量と品質、仮定の妥当性を表にして確かめます。さらに、比較手法との差や計算資源、説明責任も並べます。
傾向スコアマッチングは万能な改善策ではないので、基準となる単純な手法を上回らない場合は、採用を見送る判断も含めます。
本番では、入力スキーマや推定・予測のバージョン、閾値を固定します。例外処理やログの保管期間も、あらかじめ決めておきます。人が結果を確認する工程があるなら、どの情報を見て判断したかも記録し、後から評価できるようにします。
説明資料では、数式の詳細だけでなく、何を仮定し、何を仮定していないかを示します。そのうえで、異なる設定での感度分析や失敗例、適用範囲外のケースも示すと、利用者は結果を過信しにくくなります。
傾向スコアマッチングまとめ|先に決める目的と仮定
傾向スコアマッチングは、観測された共変量から処置を受ける確率を推定し、確率が近い処置群と対照群を比べる方法です。観測された交絡のバランスをとる補助にはなりますが、未観測交絡を自動的に取り除く手法ではありません。
実務で価値を出すには、手法の名称よりも、対象と比較、時間を一貫して定義することが大切です。入力や出力、評価指標も同じ定義でそろえます。
進め方は、基準となる単純な分析から始めて、適切なデータ分割、候補手法の推定、仮定の診断へと進みます。そのうえで、独立した評価、感度分析、運用監視へと続けると、再現しやすくなります。
予測性能だけを追うと、バランスが悪化することがあります。そのため、処置後の変数を共変量に含めず、感度分析と欠測処理、極端なスコアの確認を欠かさないようにします。
最終的な意思決定では、精度や有意性だけでなく、誤りのコストや説明可能性も含めて比べます。さらに、更新頻度や計算資源、影響を受ける人への公平性も見ておきます。まずは小さく検証してから適用範囲を広げ、想定外の変化を検知できる仕組みも残しておきます。
よくある質問(FAQ)
Q. 傾向スコアマッチングとは何ですか?
傾向スコアマッチングは、観測された共変量から処置を受ける確率を推定し、確率が近い処置群と対照群を比べる方法です。観測された交絡のバランスをとる補助になりますが、未観測交絡を自動的に除くものではありません。
Q. 傾向スコアマッチングはどのような場面で使いますか?
医療処置、顧客施策、教育介入など、ランダム化できないデータで観測可能な交絡を調整するときに使います。分析を担当する人は、マッチングを解析の前処理と位置づけ、効果推定の標準誤差や欠落した対象を適切に扱います。
Q. 傾向スコアマッチングを使うときの評価指標は何ですか?
Q. 傾向スコアマッチングで起きやすい失敗は何ですか?
Q. 傾向スコアマッチングと似た手法はどう使い分けますか?
回帰調整は、モデル関数で共変量を調整します。IPWは、傾向スコアの逆確率で母集団を再構成します。マッチングは、比較可能な範囲を明確にしやすい反面、サンプルを捨てることがあります。
AI駆動開発の工程や費用・期間への影響を確認したい方は、無料ホワイトペーパーの【2026年最新版】AI駆動開発の完全ガイドブックをご覧ください。
参考資料
本記事の定義と実装上の注意は、公式資料を参考にしています。参考になる資料は、R MatchIt、Causal Inference Book、statsmodels treatment effectsです。
各資料の仕様や前提は更新されることがあるため、実装の際は、使うバージョンの公式ドキュメントも確認しておきます。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。