
Q学習は、状態と行動の組み合わせごとに将来の割引累積報酬をQ値として推定し、経験をもとに価値を更新していく強化学習のアルゴリズムです。
更新式の考え方、Qテーブルによる学習、DQNとの違いを順に説明し、報酬設計と評価で注意する点も取り上げます。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
Q学習の仕組みと行動価値の推定
状態をs、行動をaとすると、Q(s,a)は、状態sで行動aを選んだあとに得られる割引累積報酬の期待値を表します。学習が進むと、各状態でQ値が最大の行動を選ぶことで方策が作られます。
探索中は、未知の行動も試せるように、一定の割合でランダムな行動を混ぜます。Q学習が対象とするのは、行動の結果が後の報酬へ影響する問題で、迷路やゲーム、ロボット制御、リソース配分などで使われています。
経験データによるベルマン最適方程式の近似
遷移(s,a,r,s’)を観測すると、現在のQ値を、即時報酬rと次状態の最大Q値の合計へ近づけます。代表的な更新式は次のとおりです。
Q(s,a) ← Q(s,a) + α[r + γ maxa’Q(s’,a’) − Q(s,a)]です。
角括弧内はTD誤差で、αは更新幅、γは将来報酬の重みを決める割引率です。
行動方策と最適化対象を分けるオフポリシー法
Q学習は、データ収集時の行動方策とは別に、次状態で最大Q値を選ぶ最適方策を学びます。そのため、過去の経験を再利用できます。
Q学習では現在の推定値を目標値にも使うため、推定誤差が増幅することがあります。
探索しながらQテーブルを更新する流れ
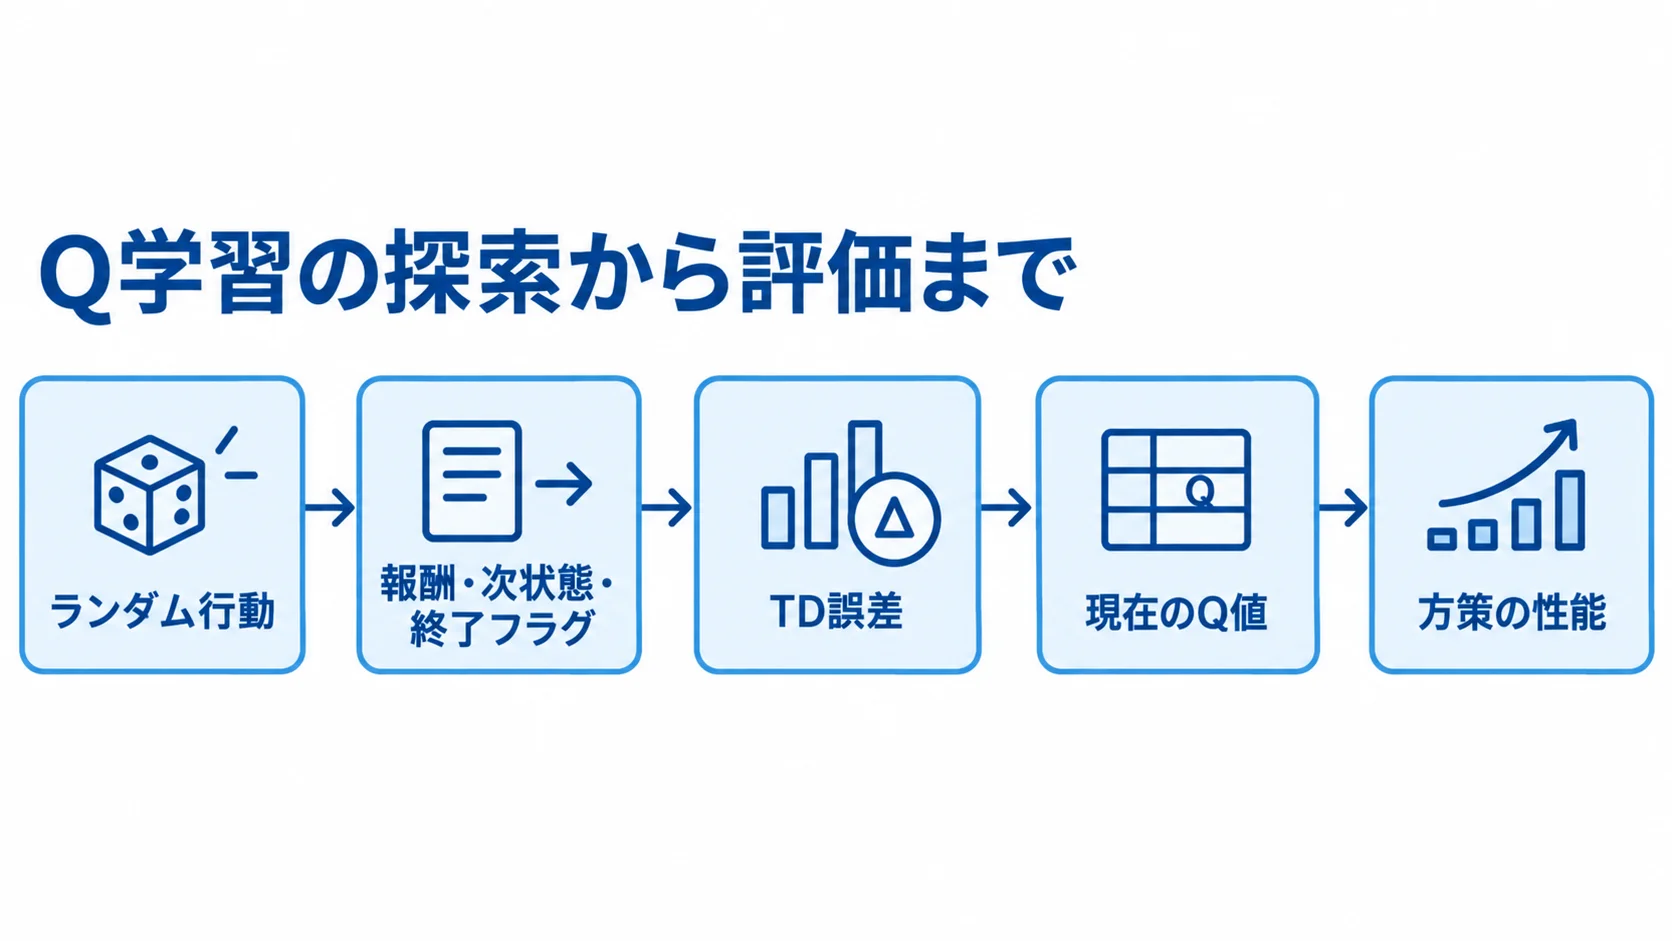
状態と行動の数が少ない問題であれば、Qテーブルを配列として保持できます。各エピソードでは状態と行動を更新し、終端状態では将来価値を加えずに終了します。
1エピソードの学習と評価は、次の順に進めます。
- 探索率εを設定し、一定の確率でランダム行動を選んで、未経験の経路を試します。
- 行動直後の報酬、次状態、終了フラグを受け取ります。
- 観測した報酬と次状態の最大Q値から、TD誤差を計算します。
- 学習率を使って、現在のQ値を目標へ近づけます。
- εを減衰させ、学習初期の探索から後半の活用へ移します。
- 評価時はランダム行動を止め、方策の性能を測ります。
εを急にゼロにすると、偶然見つけた経路に固定されることがあります。一方で、探索が多すぎる場合は、学習中の報酬が上がりません。
学習の条件として、減衰スケジュールと評価時のεを明示し、複数の乱数シードで平均とばらつきを記録しておきます。
DQNによるニューラルネットワークでのQ値の近似
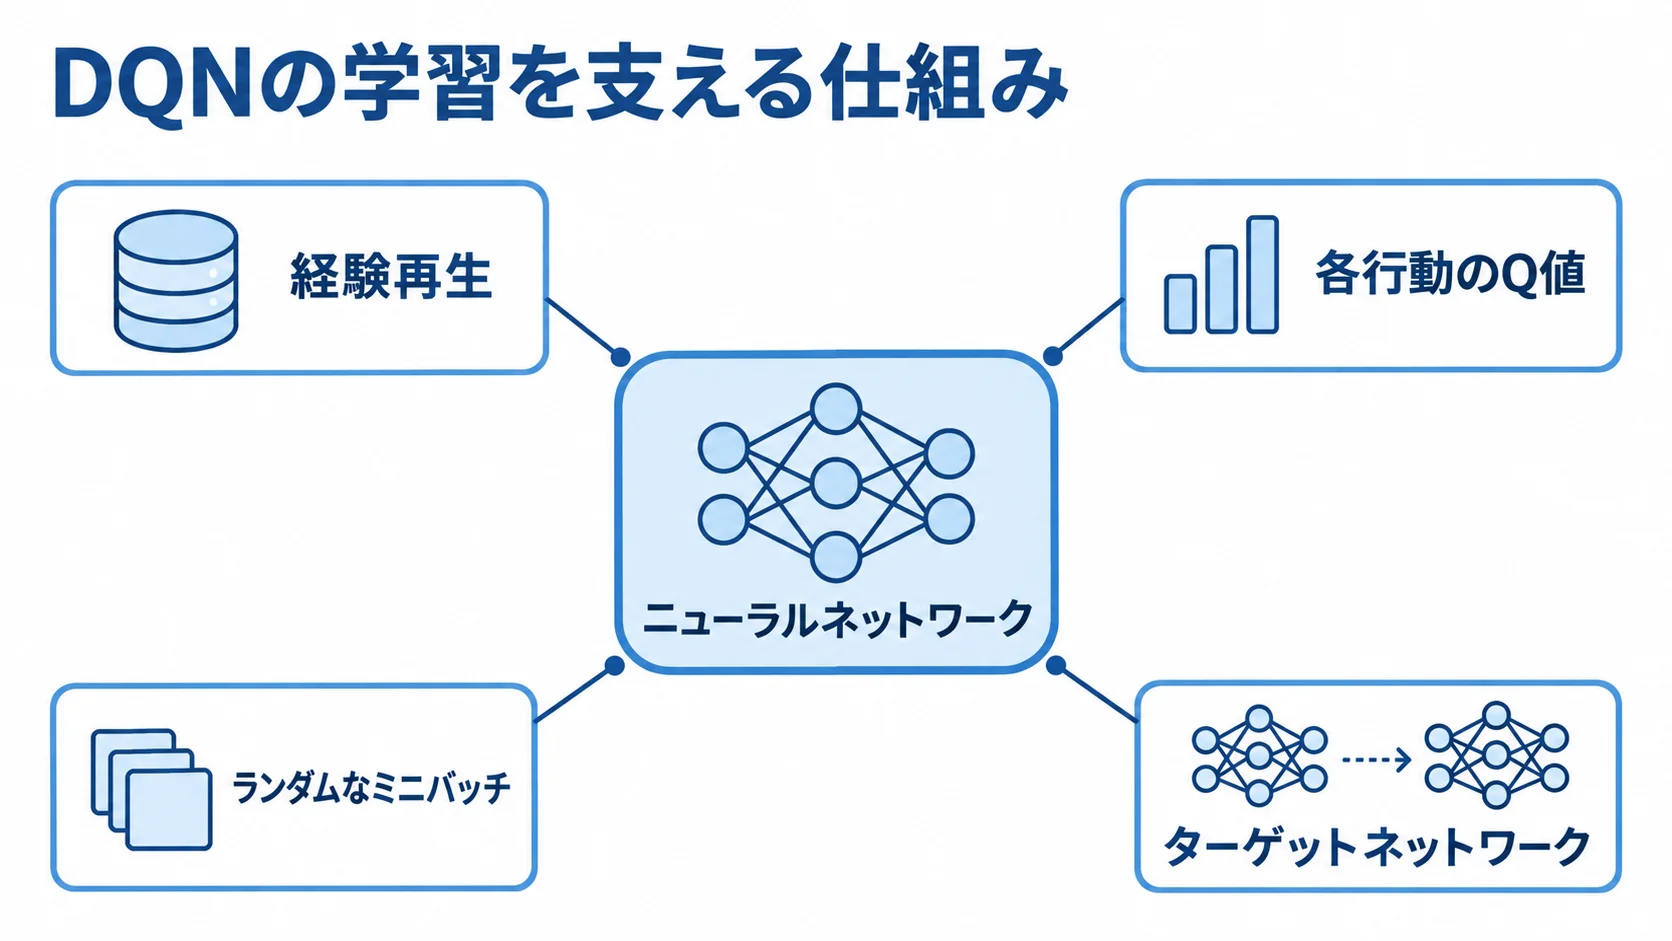
状態数が多いときや、画像入力・連続的な特徴を扱うときは、全状態をテーブルに格納できません。そこでDQNは、ニューラルネットワークに状態を入力し、各行動のQ値を出力させます。
実装の例としては、PyTorchの公式チュートリアルがあります。経験再生、ターゲットネットワーク、Huber損失を使うCartPoleの例が載っています。
経験再生による相関の強いデータのシャッフル
経験(s,a,r,s’)はリプレイバッファに保存しておき、ランダムなミニバッチで学習します。連続する遷移の相関を弱められるうえ、同じ経験を複数回使えるため、サンプル効率を高めやすくなります。あわせて、バッファ容量、ウォームアップ量、バッチサイズを記録しておきます。
ターゲットネットワークによる目標値の安定化
予測値と目標値を同じネットワークで計算すると、更新対象も一緒に動いて不安定になります。DQNでは、ターゲットネットワークを使って目標値を安定させます。
ターゲット側のネットワークは、一定間隔でコピーするか、小さな係数でゆっくり追従させます。
更新頻度や係数は固定したうえで、学習曲線に急な発散がないかを監視します。
報酬設計と状態表現が結果に与える影響
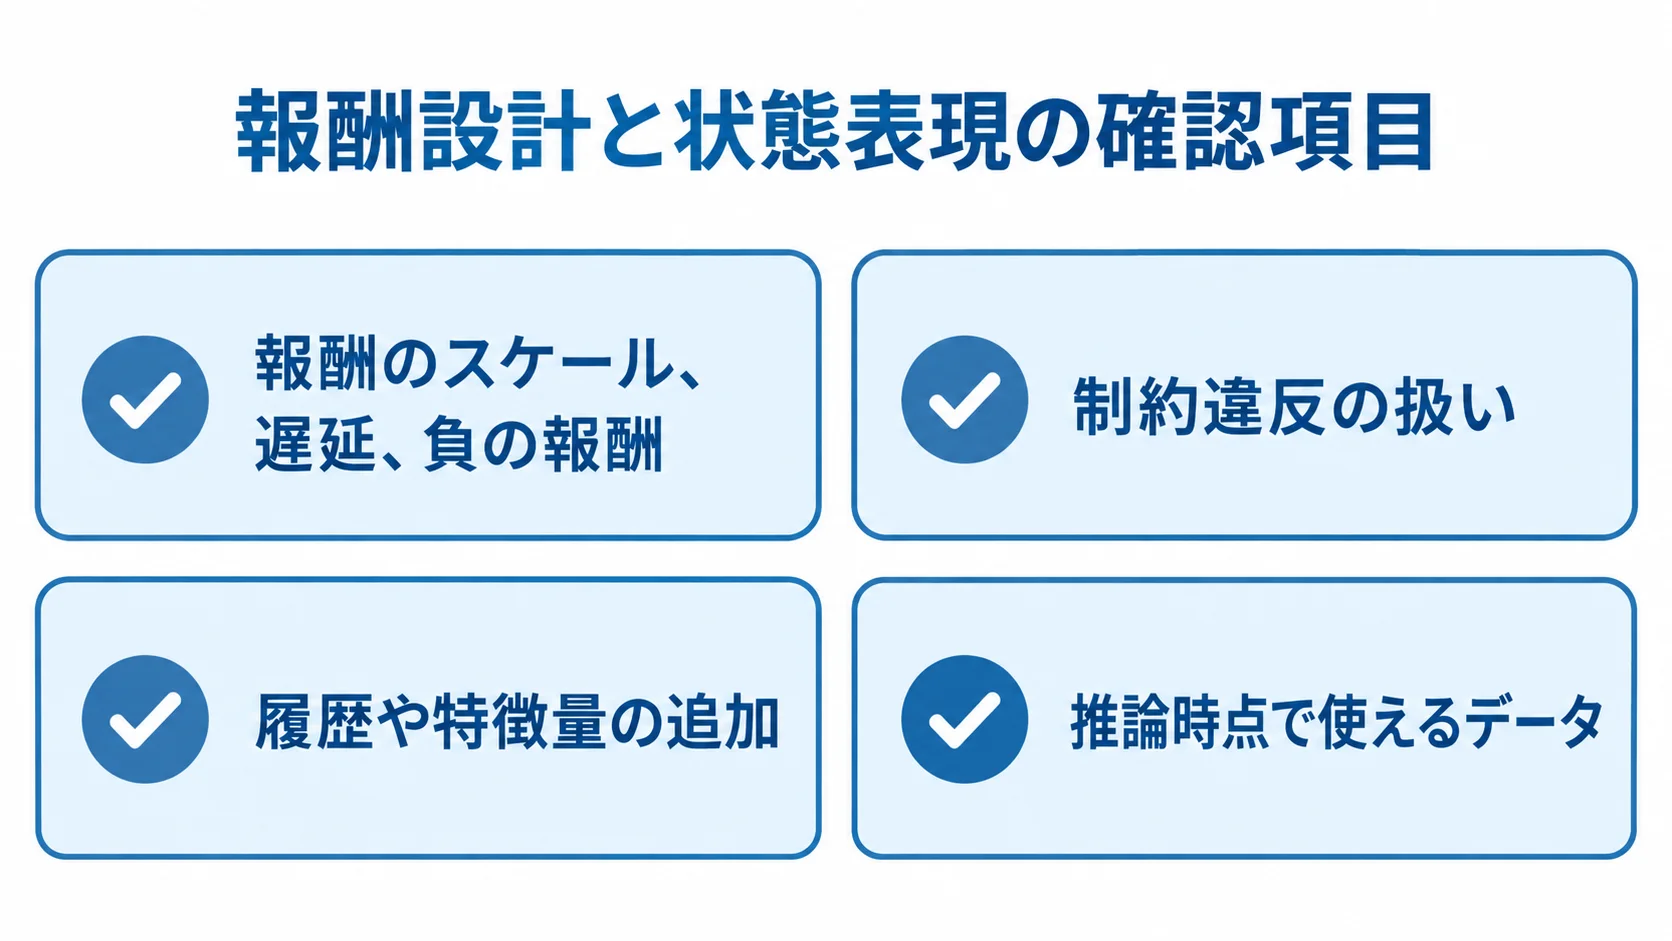
報酬は、事業や環境で本当に最大化したい成果を表す必要があります。短期の報酬だけを大きくすると、長期的な品質や安全が損なわれることがあります。
報酬の設計は、スケールや遅延、負の報酬まで含めて文書に残します。制約違反をどう扱うかも、同じ文書に書いておきます。そのうえで、代理指標の最適化になっていないかを人が確認します。
状態に必要な情報が不足すると、同じ状態に見える状況でも最適行動が変わり、Q値を一つに決められません。このため、履歴や特徴量を追加する方法や、部分観測として扱う方法を検討します。
特に、未来の情報を誤って入力しないよう、推論時点で使えるデータだけで特徴量を作ります。
平均報酬だけでなく安全性と再現性も含めた評価
評価では、エピソード報酬、成功率、制約違反を分けて計測します。探索が終わったあとの性能や処理時間も、あわせて測ります。学習中の報酬には探索行動が含まれるため、本番運用の性能と同じではありません。
複数のシード、異なる初期状態、環境の変化で評価し、平均値と信頼区間または分位点を示します。
オフラインログだけで学ぶ場合は、ログにない行動の価値を正しく評価しにくくなります。さらに、未経験の行動へ過大なQ値を付ける問題も確認します。
安全なシミュレーター、保守的な評価、人間の承認フローを、あらかじめ用意しておきます。
Q学習で起きやすい失敗と対策
Q値の過大評価
最大値を取る操作は、推定誤差の大きい行動を選びやすくします。対策の候補は、Double DQNのように行動選択と評価を分ける方法、ターゲットネットワーク、報酬の確認です。
報酬が疎なことによる学習の停滞
成功したときだけ報酬が出る環境では、成功に至る経路を探索できません。そのため、安全な範囲で中間報酬やカリキュラム、探索ボーナスを検討します。ただし、代理報酬が本来の目的から外れていないかは、必ず検証します。
学習時と本番環境の違い
シミュレーションの摩擦、遅延、ノイズが現実と異なると、学習した方策が本番で機能しません。このため、環境差を再現したうえで、段階的なオンライン検証や制約、ロールバックを設計します。
経験から行動価値を推定する強化学習としてのQ学習
Q学習は、状態と行動の価値をTD誤差で更新し、最も高いQ値の行動を選ぶアルゴリズムです。小規模な問題ではQテーブルを、大規模な問題ではDQNなどの関数近似を使います。なお、経験再生やターゲットネットワークは、深層化したQ学習を安定させる代表的な工夫です。
導入の前に、まず報酬と状態をどう定義するかを決めます。探索率、評価環境、安全制約も先に決めておきます。そのうえで、平均報酬に加え、未経験の状況、制約違反、乱数シード間のばらつきを確認します。
人が停止・承認できる運用にしたうえで、本番へ段階的に進めます。
よくある質問(FAQ)
Q学習の検討でよく出る疑問に、順に答えます。
Q. Q学習とは何ですか?
Q学習は、状態と行動の組み合わせごとの将来累積報酬をQ値として推定し、価値の高い行動を選ぶオフポリシーの強化学習です。
Q. 学習率αと割引率γは何を意味しますか?
学習率αは、新しい経験でQ値をどれだけ更新するかを表します。割引率γは、将来の報酬をどれだけ重視するかを示します。
Q. QテーブルとDQNの違いは何ですか?
Qテーブルは、状態と行動ごとの値を直接保存します。一方、DQNはニューラルネットワークでQ値を近似します。状態数や入力の複雑さに応じて、両者を使い分けます。
Q. ε-greedyのεはどう設定しますか?
初期は探索を多くし、学習が進むにつれて減衰させる設計が一般的です。評価時は探索率を分け、複数の減衰条件を比較します。
Q. Q学習をそのまま本番で動かせますか?
すぐに本番へ投入せず、まずはシミュレーションとオフライン評価で検証します。そのうえで、制約や承認、停止・ロールバックの仕組みを整え、段階的に進めます。
参考資料
Q学習やDQNの仕組み、実装例を確認できる資料を紹介します。
- PyTorch「Reinforcement Learning (DQN) Tutorial」
- OpenAI Spinning Up「Part 2: Kinds of RL Algorithms」
- OpenAI Spinning Up「Deep Deterministic Policy Gradient」
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。