
リアルタイム処理のシステム開発は、要件整理から始めて、段階的な稼働と監視・教育による定着まで、6つのフェーズで進みます。
特に要件整理で許容遅延と業務効果を決めておくと、後の再設計や費用の膨らみを抑えやすくなります。
▼全体ガイドの記事
・リアルタイム処理のシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
リアルタイム処理のシステム開発の全体像
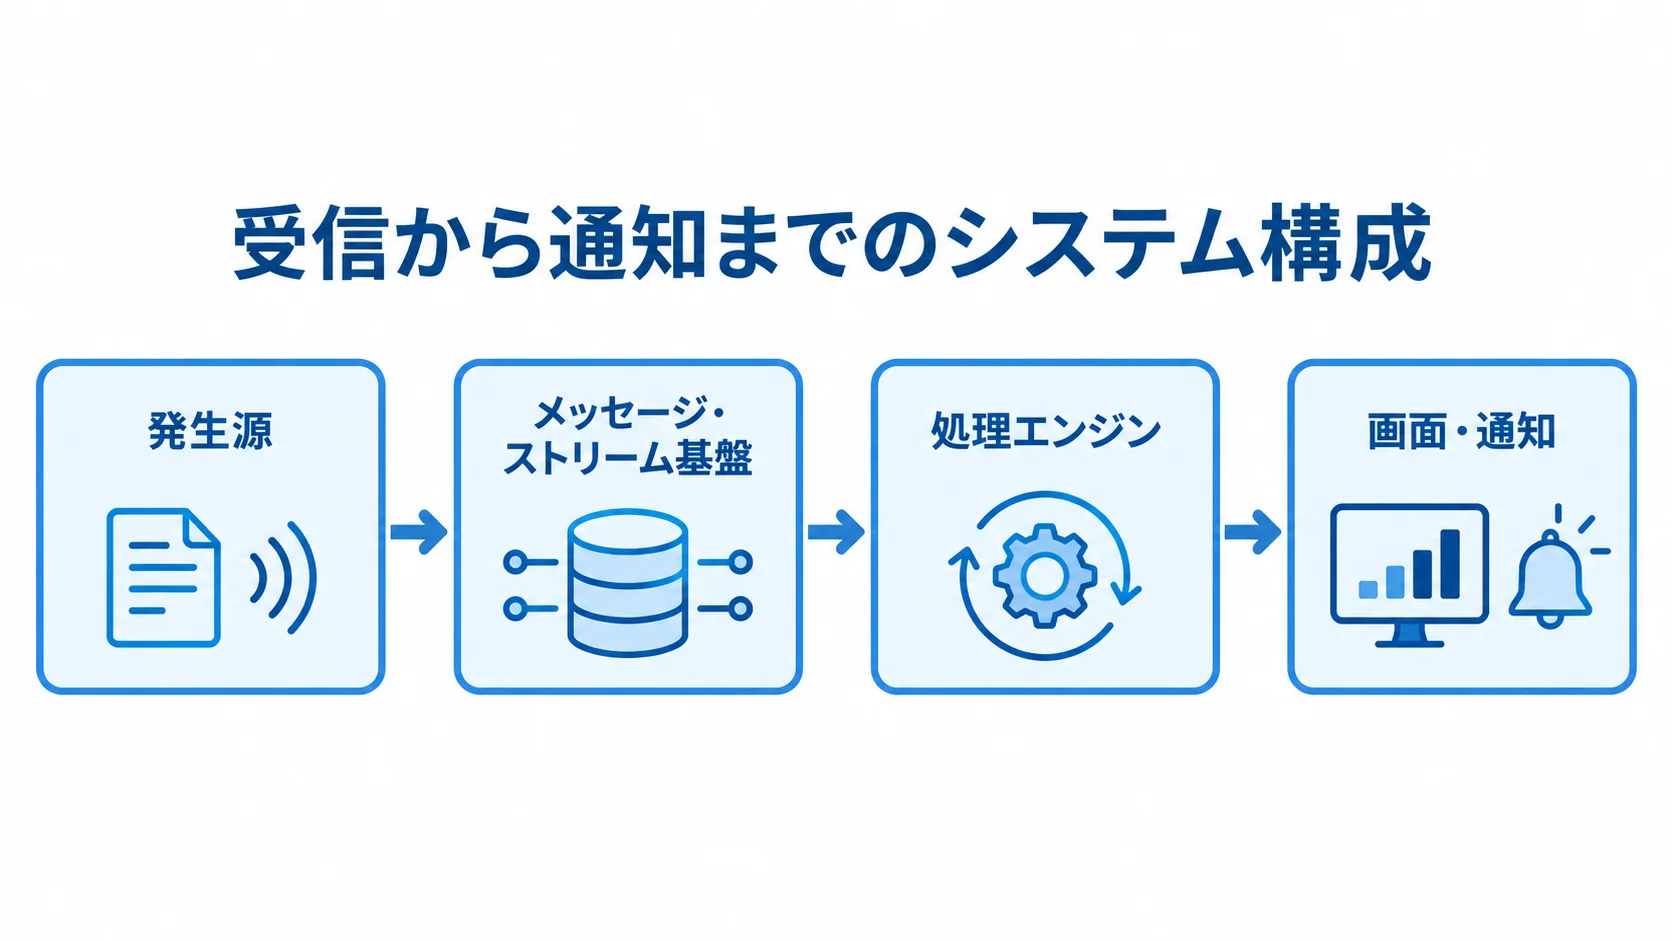
注文、決済、位置情報、センサー、アクセスログなどのイベントを、発生後すぐに取り込みます。判定、集計、保存、通知まで一連で進める点が特徴で、バッチ処理のように一定時間分をまとめることはありません。
リアルタイムで求められる速さは、業務ごとに異なります。そのため、業務の目的から許容遅延を決めることが、構成と費用を左右します。
リアルタイムとニアリアルタイムの違い
業務ごとに、どこまでの遅延を許せるかを見たうえで、常時処理の対象を決めます。
- 製造・金融:製造ラインは数ミリ秒、金融取引や不正検知は数十〜数百ミリ秒が目安です。
- 在庫・経営画面:在庫や配送状況は数秒、経営ダッシュボードは数分以内でもリアルタイムとみなせます。
- 遅い側の目標:判定を95パーセンタイルで1秒以内、画面反映を5秒以内などの数値で示します。
- 処理方式の分類:リアルタイム、ニアリアルタイム、バッチに分けたうえで、売上、顧客体験、安全、生産性への効果を比べる。
日次や時間単位の集計で判断できる業務まで常時処理にすると、基盤費用や監視の負荷、障害対応、データ保持費が増えます。
必要な機能とシステム構成
受信から通知までを一つの機能として設計し、速さと正確性の両方を確保します。
- 基本構成:発生源から、APIやIoTゲートウェイを経由して、メッセージ・ストリーム基盤へ取り込みます。
- 保存・処理機能:メッセージ・ストリーム基盤に、処理エンジン、業務・時系列DB、画面・通知、監視を組み合わせる。
- 処理履歴:重複排除、順序調整、時間窓集計、ルール判定、異常検知を行い、元のイベントも追跡できる状態にします。
- 障害への備え:障害時は、再送か隔離かを決め、二重実行の防止と過去データのリプレイ方法も定めます。
速さだけを優先すると、誤った在庫や通知が即時に広がるおそれがあります。
リアルタイム処理のシステム開発の進め方
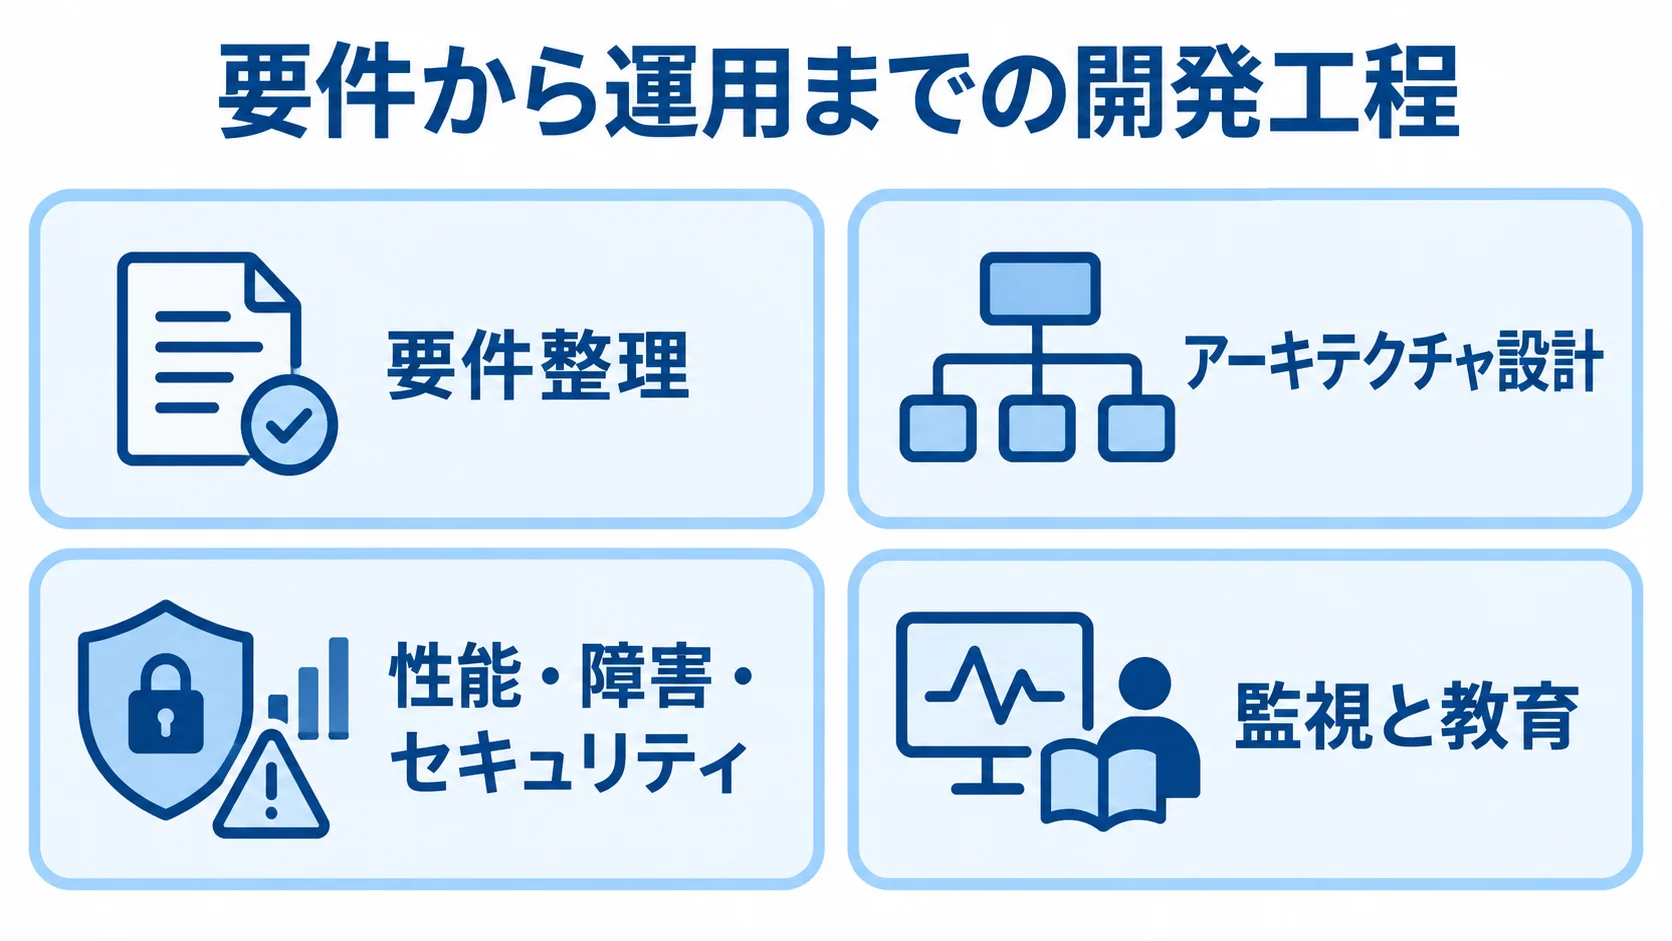
製品やクラウドサービスを先に決めず、まず業務上の判断とデータの流れを整理します。性能や障害対応についても、要件整理の段階から仮説を立てて検証しておきます。
フェーズ1:許容遅延と業務効果の要件整理
要件は業務単位で整理します。月末などの急増に耐えられるかは、平均のイベント量よりもピーク時の件数で判断します。
- 規模:対象業務と発生源、平均・ピーク件数、データサイズ、同時利用者数を書き出す。
- 運用条件:許容遅延と停止許容時間、復旧目標、保存期間、個人情報や決済情報の有無を整理する。
- 処理の正解:判定時間を決めるほか、画面反映だけで止めるか在庫引当や決済確定まで含めるか、順序が入れ替わったときの扱いを決める。
- 重複・確認:同じイベントを一度だけ処理するキーと、欠損・遅延データを確かめる画面。
要件が曖昧なまま進むと、後から高価な再設計が発生しやすくなります。
フェーズ2:サービス・開発会社の選定
候補となる技術と開発会社は、性能や障害対応の実績と既存環境との適合性で比べます。
- 技術・連携:イベント基盤やERP、販売管理、WMS、IoT機器との連携実績の有無。
- 運用実績:性能試験、再送・復旧、24時間監視の経験と、保守体制。
- 提案の確認:共通RFPで、イベント量、遅延、ピーク、重複排除、再処理、監視、担当経験を問います。
- 引き継ぎ・事例:コードとInfrastructure as Codeの受領に加えて、同規模・同業界の事例で、何をどの遅延で処理し、どう復旧したかを見る。
候補には、AWS KinesisやAWS Glueがあります。ほかに、Google Cloud Pub/SubやDataflow、Azure Event Hubsなどもあります。
Azure Event Hubsは、公式資料で低遅延かつ毎秒数百万イベントを取り込めるフルマネージド基盤と説明されています。採用の可否は、データ量と既存環境、保持要件で判断します。
フェーズ3:アーキテクチャの設計と開発
開発会社は、要件に合わせて、イベントを安全に処理する設計と利用するサービスを決めます。
- データ設計:契約やAPI、認証認可に加えて、スキーマ変更、パーティションキー、順序、再送回数、保持期間を定めます。
- 処理エンジン:通知や変換ならマネージド、複数消費者や長期再利用ならKafka、複雑な状態管理や時間窓集計ならFlinkなどが候補です。
- 設備制御:ミリ秒級や停止できない設備では、エッジで即時に判断し、分析と保存にクラウドを使えます。
Apache Flink 2.0は2025年に公開され、分離された状態管理や非同期実行モデルといった機能が示されました(出典:Apache Flink公式発表、2025年)。
新機能を採用すること自体より、監視、アップグレード、障害解析を担えるかを確かめます。また、既存のスキルで保守できるかも、選定の条件になります。
フェーズ4:性能・障害・セキュリティのテスト
品質を測るには、機能テストに加えて、遅延や障害時の業務結果、セキュリティを分けて試験します。
- 性能指標:測る対象は、95・99パーセンタイル遅延、キュー滞留、失敗率、重複件数、欠損数です。
- 負荷条件:実データに近い順序と速度で、通常・ピーク・急増の負荷をかけ、ワーカー停止、DB遅延、通信断も検証する。
- 障害対応:失敗イベントの保存先、担当者が何分以内に検知できるか、再処理後の結果までを確認します。
- 二重実行・補償:決済や在庫で二重実行を防げるか、補償処理が働くかも試します。
- 安全・情報保護:設備は安全側への移行、個人情報の暗号化、最小権限、監査ログ、脆弱性対応を試験する。
IPAの2025年資料は、セキュリティ仕様や管理体制、費用負担を協議し、書面にしておく考え方を示しています(出典:IPA「システム開発の健全化に向けて」、2025年)。また、テスト責任と判定基準も、契約書や仕様書に明記しておきます。
フェーズ5:段階的な稼働
一斉切り替えより、対象の業務や拠点を絞って段階的に導入するほうが安全です。各段階の結果を見てから、次の段階へ進みます。
- 読み取り専用のダッシュボードや通知を導入します。
- シャドー運転で、結果を比較します。
- 在庫引当や自動判定などの業務処理へ広げます。
切り戻しの条件、旧システムとの併用期間、データ差分の確認担当、利用者への連絡方法は、稼働の前に決めておきます。
稼働の判定では、目標遅延やイベントの取りこぼし、アラート通知を確かめます。加えて、再処理の手順と、月末やキャンペーン時の余力も見ておきます。
運用手順書には、平常時の確認から一次切り分け、エスカレーション、復旧、事後報告までを具体的に書き込みます。
フェーズ6:監視と教育による定着
監視に加えて、利用部門の対応と自社への移管まで、運用に必要な状態をそろえます。
- 監視指標:ダッシュボードで追う指標は、遅延、受信件数、成功率、失敗イベント、キュー滞留、再処理、クラウド利用料です。
- アラート対応:「5分以上の滞留」「エラー率が一定値を超過」「遅延が目標の2倍」などの条件ごとに、担当者の対応を決めておく。
- 利用者教育:利用者には、遅延や未処理の表示、アラート受信時の連絡先、手動業務、復旧後の確認方法を伝えます。
- 運用移管:コード、構成図、データ契約、監視設定、障害事例、リプレイ手順、クラウド権限を洗い出した資料を受け取り、演習します。
リアルタイム処理のシステム開発費用相場
リアルタイム処理に限った公的な一律の相場はありません。そこで、2026年の一般的な開発相場と類似案件をもとに、予算検討用のレンジを整理しました。
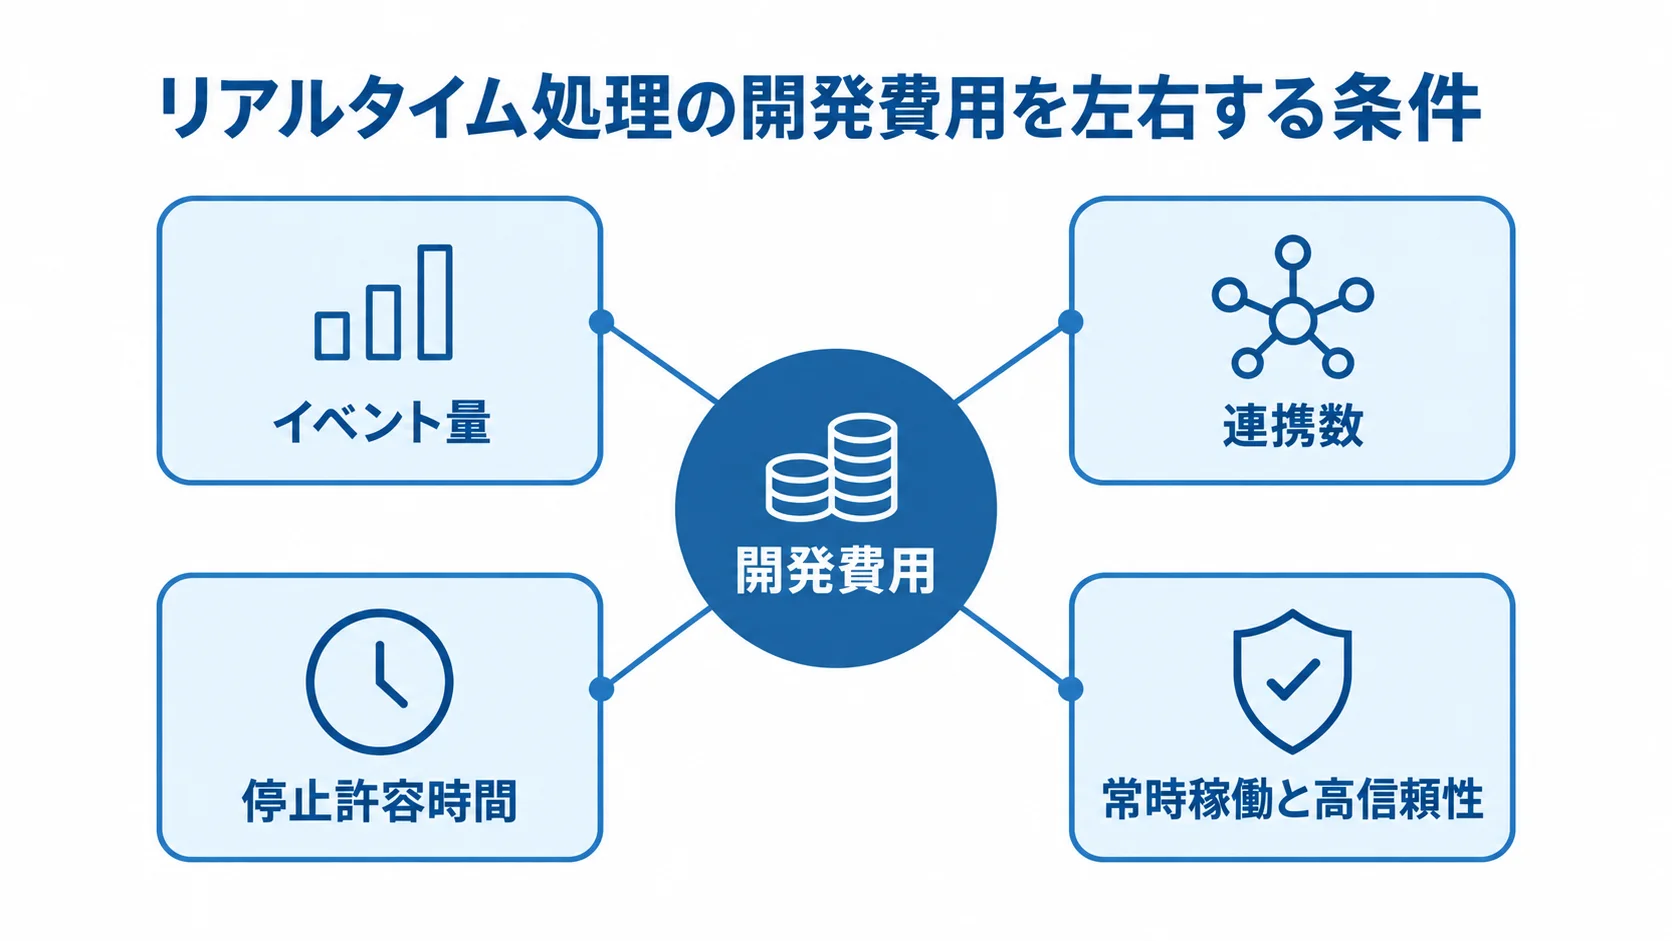
このレンジは、ストリーム基盤と可用性を前提に、性能試験や監視まで含めた範囲の目安です。さらに、再送・リプレイやセキュリティも含みます。ただし、要件やイベント量、連携数、停止許容時間で変わるため、正式な見積もりの代わりにはなりません。
規模別の開発費用と期間の目安
同じリアルタイム処理でも、導入する範囲によって金額と期間は大きく違います。PoCの小規模導入から、全社・IoT連携や高可用性が必要な案件までの目安を、範囲ごとに並べました。
- PoC・小規模:1〜数種類のイベントをクラウドで取り込み、簡易画面や通知を実現する範囲で、300万〜800万円、2〜4か月程度です。
- 部門向け:複数の既存システム連携、権限管理、履歴検索、通知、再処理、ピーク負荷試験を含み、800万〜2,000万円、4〜8か月程度です。
- 全社・IoT連携:複数拠点、エッジ連携、冗長化、災害対策、24時間運用、移行を含み、3,000万〜1.5億円、9〜18か月程度です。
- 高可用性が必要な領域:金融・交通・社会インフラなどで、厳格な可用性、監査、フェイルオーバー、第三者試験、複数社統合が必要な案件です。
- 費用と期間:上記のような案件は、1億〜数億円以上、1〜3年程度になる可能性があります。
小規模であっても、認証、監視、負荷試験、運用設計まで含めると、100万円台前半には収まりにくい傾向があります。
SIAの2026年7月公開相場は、小規模100万〜300万円、中規模500万〜1,000万円、大規模1,000万円〜数千万円以上です(出典:SIA「システム開発の費用・相場 2026年版」、2026年)。
人月単価は60万〜200万円程度です。また、リアルタイム案件では、一般的な相場に常時稼働と高信頼性の工数が加わります。
費用の内訳と増減要因
見積もりの額は、作業範囲と人員構成、リアルタイム要件で変わります。
- 作業範囲:要件定義から運用移管までを、設計や環境、連携、処理、画面、移行、試験ごとに分けて見る。
- 人員配置:技術、テスト、運用の各担当を置く期間の長さが、費用を左右します。
- 処理要件:発生源や連携先が多い場合、ピーク量が不明な場合、ミリ秒級の遅延が必要な場合は、費用が高くなる傾向があります。
- 運用・情報管理:二重実行の防止、24時間365日の監視、個人情報や決済情報への対応も、費用を増やす要因になります。
要件が曖昧なまま進むと、当初の見積もりから1.3〜1.5倍程度に膨らむおそれがあります。そのため、初期の要件整理とPoCに予算を配分します。
クラウド料金と保守・運用費
クラウド費用は、利用量と運用条件で変わります。各社の料金計算ツールにイベント量と保持期間を入力し、開発費とは分けて月額を試算します。
- 料金を左右する要素:データ量、保持期間、読み書きの回数、ワーカー数、監視、バックアップ、転送量です。
- 月額の予算枠:小規模PoCは10万〜50万円、部門運用は50万〜300万円、冗長化した大規模基盤は月300万円超も想定されます。
- 保守・運用費:初期開発費の年15〜25%程度が目安です。24時間監視や障害・脆弱性対応、クラウド料は別費用です。
Amazon Kinesis Data Streamsには、オンデマンドやプロビジョンドなどのモードがあります。料金は、データ量と利用モードに応じた従量制です(出典:AWS「Amazon Kinesis Data Streamsの料金」、2026年確認)。
NTTドコモの事例では、大量の位置情報をKinesisで取り込み、AWS Glueでストリーミング変換する構成をPoCで検証しました。そのうえで、負荷に応じた自動スケーリングや出力方法を、コストと性能の両面から調整しています(出典:AWS「NTTドコモにおけるAWS Glueストリーミングジョブ」、2025年)。
発注側は、ピーク時の従量課金とログ保管費を見積書に分けて記載してもらいます。また、監視時間、窓口、復旧目標が含まれるかを確認します。月次レポートや改善提案、クラウド費用の上限通知についても、確かめます。
こうした確認をしておくと、初期の見積もりの安さだけで発注先を決める失敗を防げます。
リアルタイム処理のシステム見積もりを取るポイント
総額の安さより、同じ条件で比べられる見積もりの粒度が大切です。まず、RFPに業務フロー、イベント一覧、データ項目を記載します。
次に、平均・ピーク件数、目標遅延、利用者数、連携先を記します。さらに、保存期間、セキュリティ区分、停止許容時間、RTO・RPO、希望時期も書き添えます。
要件と見積範囲の整合
見積もりでは、範囲とPoCの判定条件、変更時の費用を分けて確かめます。
- 作業範囲:要件定義、設計、実装、連携、インフラ、試験、移行、教育、運用移管の工程を、それぞれ分けて示してもらう。
- PoC項目:目標遅延、重複反映、通信断後の再処理を、実データに近い負荷で試す。
- 追加費用:量・連携先・仕様・性能目標の変更や第三者診断を追加するときの、単価と承認方法。
PoCの成功条件を先に決めておかないと、試したあとで本番導入を判断しにくくなります。そのため、検証項目と判定基準は、着手前に合意しておきます。
追加費用の条件は、見積書と契約書に残しておきます。要件変更で、どこまでを誰が受け持つかが曖昧だと、費用と納期の争点になりやすいためです。
複数社の技術と運用体制の比較
複数社に同じ条件を示し、技術の提案と運用面を、見積もりの段階で比べます。
- 提案資料:2〜3社以上の構成図、性能試験、連絡網、監視画面、再処理、保守時間の内容。
- 責任と担当:技術者の経験、正しさの保証者、一次対応時間、クラウド費用の監視担当を確認します。
- 方式の適合:標準機能で足りればパッケージやSaaS、負荷変動にはマネージドクラウドが候補になります。
- 個別要件:独自の制御や厳しいデータ所在の要件があるときは、追加開発か、エッジ・オンプレミスとの併用が必要です。
自社の運用人材が少ない場合は、技術の自由度に加えて、保守を任せられる体制も見ておきます。
契約・セキュリティ・引き継ぎの確認
発注条件に契約、セキュリティ、引き継ぎを含め、実際に運用できる状態かどうかを見極めます。
- 契約:変更、再委託、コード、IaC、資料、OSS、知財、障害責任の扱いを、契約で明確にする。
- セキュリティ:認証認可、暗号化、秘密情報の管理、ログ保管、診断、個人情報の削除、委託先の権限。
- 引き継ぎ演習:イベントの再送と隔離、リプレイによる復元、アラートから復旧報告までを、実際に試す。
セキュリティは、要件と費用の段階から含めておきます。
資料を受け取るだけでなく、担当者が演習を終えたことを受入の条件にしておくと、継続して運用しやすくなります。
リアルタイム処理のシステム開発でよくある質問
目的やデータの重要度によって、適切な構成は変わります。発注前によくある質問と判断基準を、順に取り上げます。
リアルタイム処理は本当に必要ですか?
売上、安全、生産性、顧客体験に関わる判断を、何秒以内に下す必要があるかで決まります。
日次や時間単位の集計で足りる業務まで、リアルタイム化する必要はありません。リアルタイム、ニアリアルタイム、バッチの3方式に分けて、費用と効果を比べます。
小規模ならいくらで開発できますか?
簡易ダッシュボードやアラートのPoC・小規模導入の目安は、300万〜800万円、2〜4か月程度です。
認証や既存連携、負荷試験、24時間監視、個人情報への対応が加わると、金額は上がります。そのため、イベント量と目標遅延を示したうえで、開発・クラウド・保守費を分けて見積もってもらいます。
クラウドとスクラッチ開発はどちらが良いですか?
通知や監視が標準機能で足りる場合は、パッケージやSaaSが初期費用と期間を抑えやすい選択肢です。一方で、負荷変動に対応する選択肢としては、マネージドクラウドがあります。
独自の順序制御やミリ秒級の制御、厳しいデータ所在の要件があるときは、追加開発やエッジ・オンプレミスとの併用が必要になります。
全機能を最初から作り込むより、実データのPoCで遅延、正確性、運用負荷を確かめるほうが現実的です。そのうえで、標準機能で足りない部分だけを開発します。
まとめ
開発では、「何秒以内に何を判断できれば業務の成果につながるか」を、最初に定義します。要件整理から定着までの6フェーズでは、イベント量や重複、順序を業務要件として扱います。通信断や再処理、監視も、業務要件に含めます。
発注前の確認事項
発注前に、許容遅延、平均・ピークのイベント量、連携先、データの重要度を書き出しておきます。加えて、停止許容時間、RTO・RPO、保存期間、セキュリティ区分、PoCの成功条件も一覧にまとめます。
見積書では、開発、クラウド、保守、性能・障害試験、運用移管を分けて示してもらいます。また、追加費用の条件と、どこまでを誰が受け持つかも確かめます。
小さな検証と段階的な拡大
対象を絞ったPoCで、実データに近い負荷、目標遅延、重複排除、障害復旧を検証します。その結果を見て、効果と運用負荷に合わせ、本番の範囲を広げます。
必要な業務だけをリアルタイム化し、現場が判断と復旧を行える状態まで設計しておけば、費用を抑えながら使われ続けるシステムにつながります。
▼全体ガイドの記事
・リアルタイム処理のシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。