
RNN(再帰型ニューラルネットワーク)は、前の時刻の隠れ状態を次の計算へ渡して履歴を保ち、文章や音声など順序が重要な系列データを扱うニューラルネットワークです。
文章や音声、センサーログなど、順序や過去の情報に意味があるデータに向いています。
AI駆動開発の基本や工程ごとの活用方法は、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。費用・期間への影響も取り上げています。
隠れ状態で系列の履歴を表すRNNの仕組み
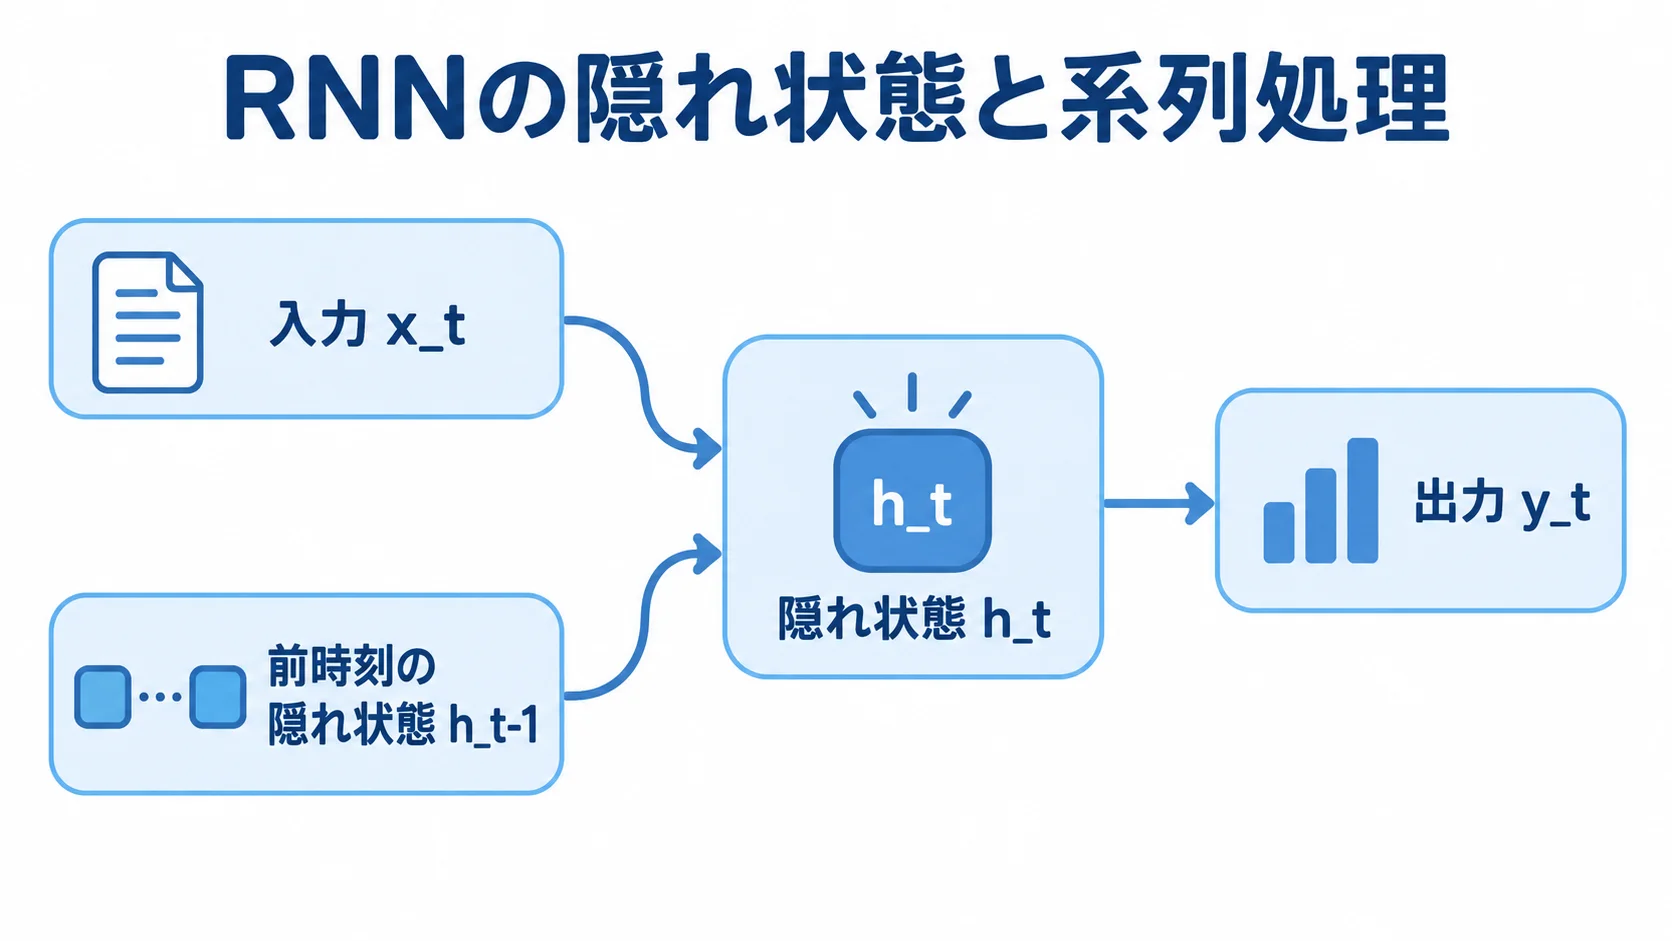
各時刻では、入力xtと前時刻の隠れ状態ht-1から、今の隠れ状態ht = f(xt, ht-1)を計算します。出力ytは、各時刻で出す方法と、最後の状態から系列全体を分類する方法があります。また、同じ重みを時刻間で共有するため、入力系列の長さが変わっても処理できます。
タスクに応じた出力形式の選び方
入力と出力の組み合わせは、分類や生成など、解きたい内容によって変わります。そのため、タスクに応じて形を選びます。
- Many-to-one:文章やセンサー系列の全体を、一つのクラスに分類する用途。
- One-to-many:一つの入力から、系列を生成する用途。
- Many-to-many:各時刻へのラベル付けや、系列どうしの変換に使う用途。
- Encoder-Decoder:入力系列を要約し、別の系列を出力する用途。
長期依存を扱いやすくしたLSTMとGRU
単純なRNNは、時刻をさかのぼるほど勾配が小さくなり、遠い過去の情報を学びにくい場合があります。
この弱点を和らげる構造として使われるのが、LSTMとGRUです。
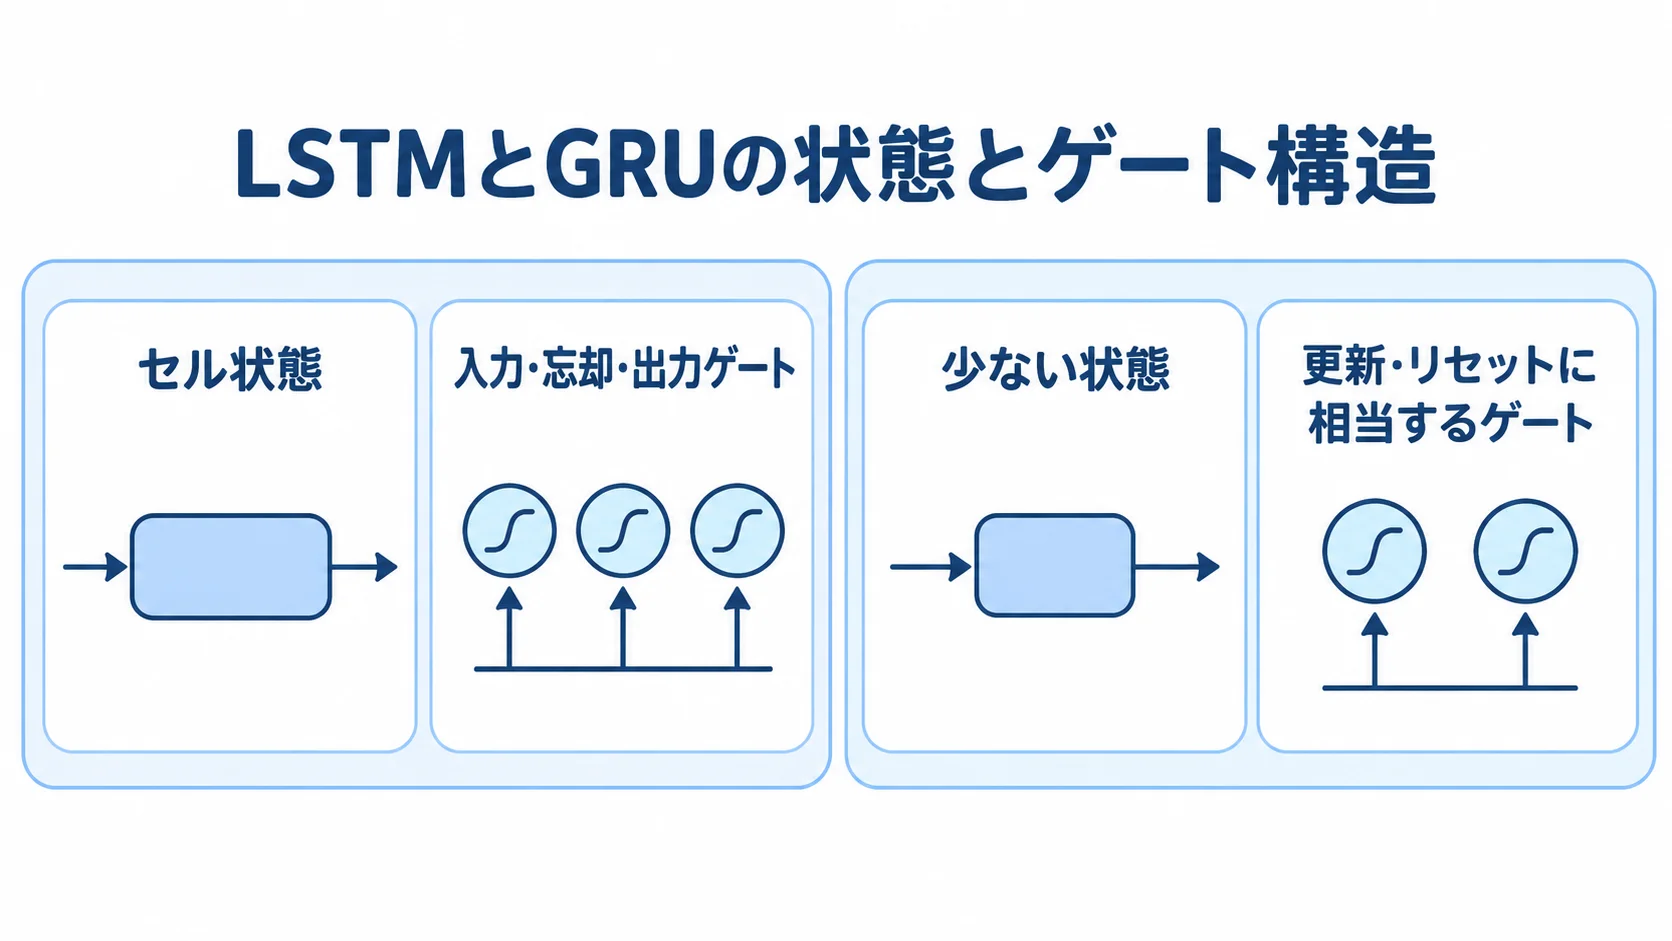
LSTMは、セル状態と入力・忘却・出力の各ゲートを使い、情報を保持したり破棄したりします。一方で、GRUは更新とリセットに相当するゲートを、少ない状態で構成します。
GRUはLSTMより軽量になることがあります。ただし、どちらが常に優れるとは限らず、系列長やデータ量などの条件で結果が変わります。
比較の観点は、系列長とデータ量に加え、推論遅延やメモリ、既存モデルとの互換性です。
単純なRNNも、ベースラインとして評価します。
時間方向に展開したRNNの学習
Backpropagation Through Time(BPTT)は、RNNを時刻方向に展開して、系列全体の損失から重みを更新する学習方法です。
長い系列をそのまま逆伝播すると、計算量とメモリが増えます。
そのため、途中で勾配を切るTruncated BPTTを使うことがあります。切断長が長期依存の学習に与える影響も検証します。
可変長の系列は、パディング、マスク、パック化で処理します。
パディングを損失に含めると性能が歪むため、実データの長さの分布とマスクを確かめておきます。
実装の例としては、PyTorchの公式チュートリアルに、文字系列を分類・生成するRNNの構築例があります。
RNN導入時に固定する系列の単位と予測時点
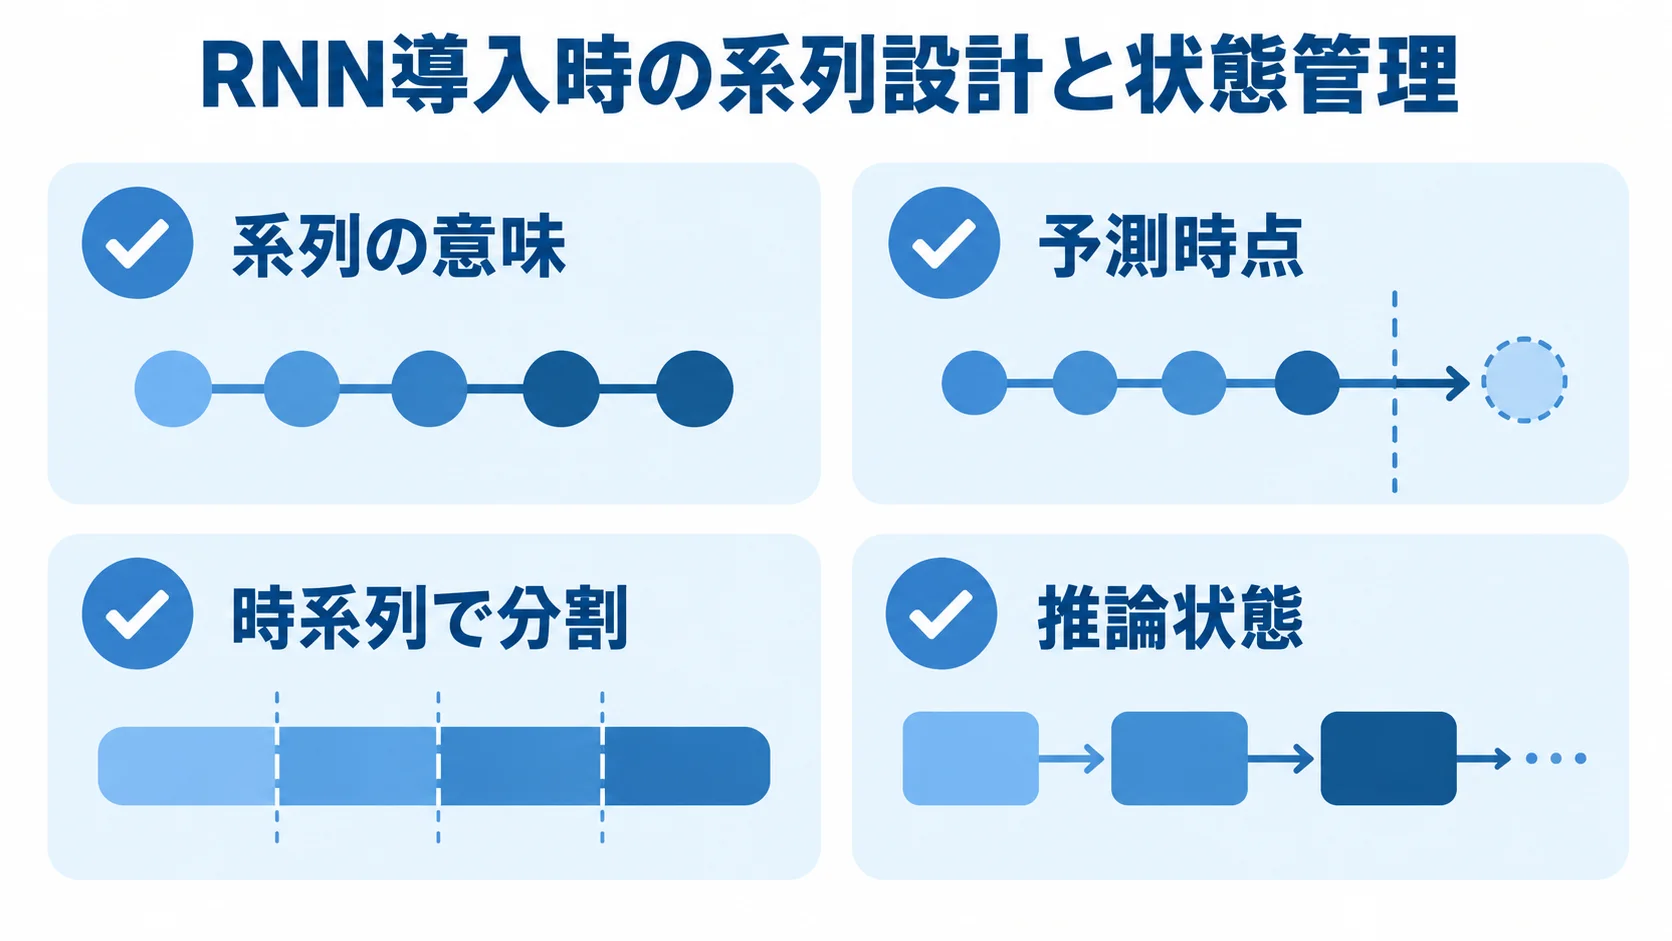
導入時は、データの分割や状態管理まで含めて、次の順に決めていきます。
- 系列の意味を定義する:顧客や設備、文書など、一つの系列とみなす単位。
- 予測時点を決める:未来の情報を入力に混ぜない特徴量生成を行う。
- 時系列で分割する:未来の系列が学習に漏れない分け方。
- ベースラインを作る:直前の値、統計特徴、非再帰モデルとの比較。
- 系列長を比較する:短期と長期の窓、切断長、欠損処理の検証。
- 推論状態を管理する:セッション境界、リセット、ストリーミングの決め方。
系列分割と長期依存を踏まえた評価
分類ならF1や再現率、予測ならMAEやRMSEなど、目的に合う指標を使います。
系列・顧客・設備が学習とテストにまたがると、評価が過大になります。そのため、分割では対象の単位を守ります。
予測の期間(horizon)や欠損率、系列長ごとに、性能を比べます。分布の変化による差も確かめます。特に、隠れ状態をセッション間で誤って引き継ぐと、別データの情報が混ざります。
オンライン推論では、再起動や遅延、欠損、初期状態も含めてテストします。さらに、推論の出力と隠れ状態も監視します。
RNNで起きやすい失敗と対策
勾配消失・爆発への対策
対策には、LSTMやGRUの利用、勾配クリッピング、初期化があります。そのほか、正規化と系列長の見直しも取り入れ、勾配ノルムを記録します。
未来情報の系列への混入
開発チームは、特徴量を生成した時刻と分割の境界を監査します。そのうえで、時系列の順序に沿って再評価します。
隠れ状態の誤った引き継ぎ
セッションの境目では、隠れ状態をリセットします。一方で、バッチ間で状態を共有する場合は、その管理を明示的に行います。
RNNによる系列データの処理
RNNは隠れ状態を時刻間で渡し、文章やセンサーログなど順序を持つデータを処理します。なお、LSTMやGRUは長期依存を扱いやすくした代表的な構造です。
導入では、系列の単位と予測時点を明確にし、分割と状態のリセットの扱いも決めておきます。評価では、勾配や遅延、欠損、未来情報の漏えいを確かめます。
最後に、非再帰モデルとの比較で、RNNの導入効果を確かめます。
よくある質問(FAQ)
再帰型ニューラルネットワークについて、よくある疑問に答えます。
Q. RNNとは何ですか?
前の時刻の隠れ状態を次の計算へ渡し、系列データの履歴を扱うニューラルネットワークです。
Q. LSTMやGRUとの違いは何ですか?
LSTMとGRUは、単純RNNの長期依存を改善するゲート構造を持つ発展形です。
Q. どのようなデータに向きますか?
文章、音声、センサーログ、時系列など、順序や過去の情報が意味を持つデータに向きます。
Q. 学習時に注意することは何ですか?
時系列分割、未来情報の漏えい、可変長のマスク、勾配消失・爆発、隠れ状態のリセットを確認します。
Q. RNN以外のモデルと比較すべきですか?
はい。統計特徴や非再帰モデルをベースラインにし、精度・遅延・メモリ・運用性で比較します。
参考資料
RNNの構造や実装は、次のPyTorch資料で確かめられます。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。