
検索システムの構築方式は、既製サービスを使うか、フルスクラッチ(オーダーメイド)で作るかのどちらかです。選び方は、検索の要件、データ規模、セキュリティ要件によって決まります。
使い分けから費用と進め方まで、順に見ていきます。全体像は検索システム開発の完全ガイドで確認できます。
▼全体ガイドの記事
・検索システム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
検索システム構築の2つのアプローチと使い分け
検索システムの構築方法は、既製の検索サービス(SaaS)を使う方法と、検索エンジンを使ったフルスクラッチ開発に分かれます。大切なのは、自社の要件とデータ規模、体制や予算を踏まえて、合う方式を選ぶことです。両方式の特徴から、使い分けを考えます。
既製の検索サービス・SaaSの特徴
既製サービスは、立ち上げや運用の手間を減らせます。ただし、料金や制御範囲には条件があります。
- 運用:インフラ構築、自動スケーリング、セキュリティ更新、性能の調整をベンダーに任せられる
- 機能:タイプミス許容、絞り込み、AIパーソナライズ、サジェストを利用できる
- 導入の速さ:軽量な検索エンジンなら、数日で実装できる場合がある
- 費用:レコード数や検索リクエスト数に応じた従量課金で、利用が増えるほど金額も増える
- 制約:細かな検索制御は難しく、データは外部クラウドに預ける前提です
たとえば、Algoliaなどは、ECやサイト内検索、SaaSの顧客向け検索を短期間で構築できます。検索の専門家でなくても高品質な検索を立ち上げやすく、運用負荷も抑えられます。
一方で、Rust製のMeilisearchやTypesenseは、開発者向けで軽量です。こうした検索エンジンは、プラグアンドプレイ型のため、作り込みを抑えられます。
このため、まずは既製サービスで要件を満たせるかを確かめ、難しい部分が明確になってからフルスクラッチを検討するのが合理的です。
フルスクラッチ・オーダーメイド開発の特徴
フルスクラッチは、自社の要件に合わせやすい一方で、構築と運用の責任も自社側に残ります。方式を選ぶ際は、それぞれの特徴を自社の状況と照らし合わせます。
- 基盤:Elasticsearch、OpenSearch、Apache Solrなどのオープンソース全文検索エンジンを使います
- 設計の自由度:検索システムを自社要件に完全に合わせて構築できる
- 拡張性:検索のほかに、ログ分析やビジネス分析にも使えます
- 運用負担:構築と管理には、専門知識と工数が必要です
- 適する条件:独自要件や自社保管、大規模データへの対応が求められる場合です
これらは、Apache Luceneをベースとした成熟した基盤です。インデックスや日本語アナライザ(kuromojiなど)、シノニムやユーザー辞書を設計できます。ランキングや既存システムとの連携も設計できます。
シャードの割り当てからクエリの調整までは、自社または委託先が管理します。なお、標準的な要件で規模が中程度までなら、フルスクラッチは過剰になりやすく、既製サービスが有利な場合も多くあります。
作れることと作るべきことは別です。そのため、既製サービスの枠を本当に超える要件かを見極めて、方式を選びます。
オーダーメイド(フルスクラッチ)が必要になるケース
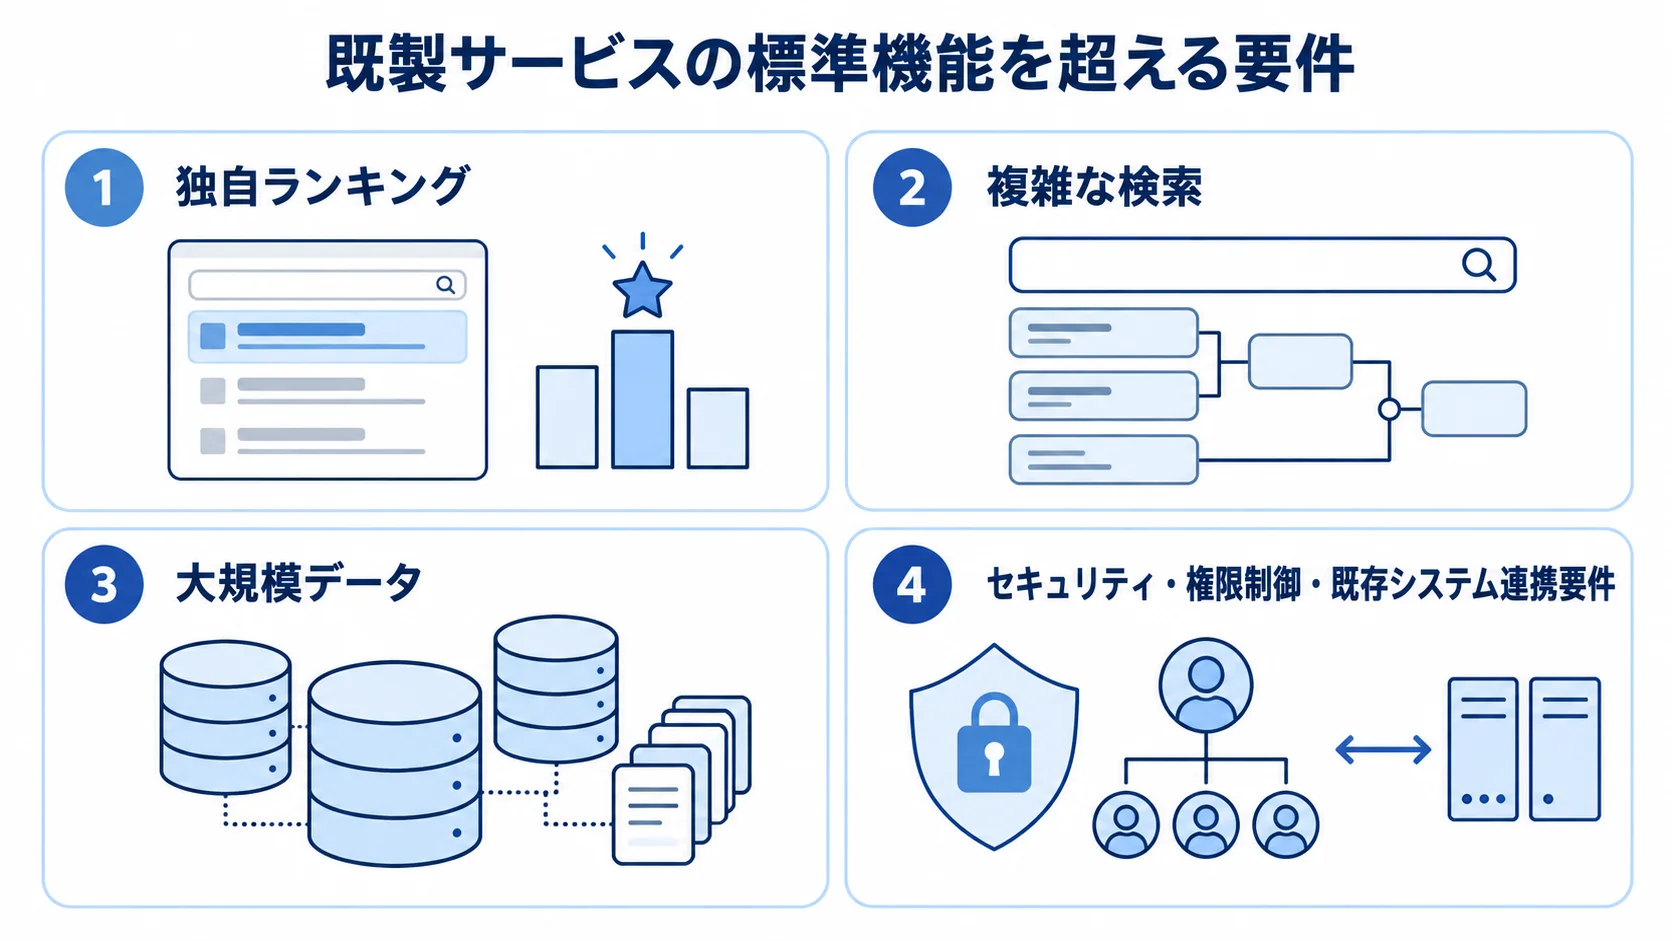
多くのニーズは既製サービスでも満たせますが、要件によっては自社専用の開発が現実的になります。どのような要件が当てはまるかを見ていきます。
独自ランキング・複雑な検索要件・大規模データ
既製サービスの標準機能では表現しきれない要件があります。その場合は、独自の作り込みが必要かを判断する材料になります。
- 独自ランキング:検索結果の順序を、自社の業務ロジックで細かく制御できる
- 複雑な検索:地理情報、階層構造、多言語、特殊な業務ルールに対応する
- 大規模データ:数億件を超える件数を扱う
ランキングでは、在庫状況や利益率、キャンペーンといった要素を独自に重み付けできます。購買履歴や季節性なども、重み付けの対象にできます。また、BM25などの基本スコアには、独自ロジックを加えられます。
距離と属性の組み合わせのように、標準機能だけでは組み立てにくい検索もあります。その場合は、エンジンを深く使う方法が有利です。
そうした規模では、SaaSの従量課金が高額になりやすく、シャーディングやインデックスを調整して固定費に寄せると、効率が上がる場合があります。既製サービスの制約を超える独自要件、外部に出せないデータ、従量課金では割高になる大規模データがあるなら、フルスクラッチを検討する価値があります。
セキュリティ・権限制御・既存システム連携要件
セキュリティ、権限制御、既存システムとの連携も、フルスクラッチを選ぶ要因になります。
- セキュリティ:データを外部に出さず、自社環境に保管する
- 権限制御:所属や役職に応じて、検索対象や表示情報を分けます
- システム連携:既存のデータや認証の仕組みを、検索に適用します
機密データを外部クラウドに預けられない場合や、法規制や社内規程でオンプレミスまたは自社管理クラウド内に保つ必要がある場合は、SaaSを採用しづらくなります。
たとえば社内文書検索では、部署や機密区分ごとに、閲覧権限のある文書だけを返す制御が求められます。複雑な権限モデルには、個別の作り込みが適しています。
基幹システム・データベース・ファイルサーバ・認証基盤(IdP)とリアルタイムで同期する場合や、既存の認証・認可を適用する場合も、自由に実装できる方式が有利です。こうした要件は、企業システムへの検索導入で現実的なハードルになりやすく、フルスクラッチが選ばれる典型的な理由です。
フルスクラッチ検索システムのメリット・デメリット
フルスクラッチ・オーダーメイド開発を選ぶ前に、利点と欠点の両方を押さえておくことが大切です。自由度と、コストや責任の両面から見ていきます。
メリット(完全適合・ロックイン回避・データ主権)
フルスクラッチの利点は、検索の仕組みを自社の主導で決められることにあります。
- 要件への適合:最大の利点は、検索を自社要件に完全に合わせられることです
- ロックイン回避:料金改定や仕様変更などの影響を抑えられます
- データ主権:自社の方針で、データやセキュリティを管理できる
- 費用構造:利用増加による従量課金の伸びを避けられる
ランキングや日本語処理の辞書を独自に設計できます。既製サービスでは妥協する部分も、業務に合わせられます。
特定のSaaSに依存しないため、移行の自由度も保てます。さらに、オンプレミスや自社クラウドにデータを置けます。また、機密データを外部に預けず、権限制御やセキュリティも自社の方針で設計できます。
大規模になるほど、サーバの固定費が有利に働く場合もあります。標準を超える要件があれば、それがフルスクラッチを選ぶ理由になります。
デメリット(費用・期間・運用保守負荷)
フルスクラッチでは、初期費用や開発期間、運用、精度改善を自社側で担うことになります。そのため、要件に対して負担が見合うかを判断することが欠かせません。
- 費用と期間:実装範囲が広く、長い開発期間が必要になる
- 運用保守:稼働後の対応を継続して行う
- 精度改善:検索ログを見ながら、調整を重ねる
インデックスや日本語処理、検索UIを実装し、APIや権限制御も作り込む必要があります。そのため、既製サービスなら数日から数週間で済む立ち上げが、数か月単位になり、費用もかかります。
サーバ監視、バックアップ、障害対応は、自社または委託先が続けて行います。バージョンアップも、自社または委託先が担います。さらに、これらを担う人材の確保と維持が課題です。
Elasticsearchのクラスタ運用や日本語アナライザの設定・維持には専門知識が要るため、属人化にも注意が必要です。検索精度の調整も、自社で作り込む必要があります。
ただし、既製サービスで要件を満たせるなら、これらの負担を背負う必要はありません。自由度が本当に必要かは、費用や期間、運用負荷と比べて判断します。
フルスクラッチ検索システムのコスト相場と開発期間
費用と期間を検討する際は、初期開発費用だけでなく、TCO(総保有コスト)も見ておく必要があります。ここでは、費用の相場と工程の配分を見ていきます。
初期開発費用とTCO
初期費用は、規模や作り込みの度合いで変わります。方式ごとの費用幅と、継続して発生する運用費を合わせて見ることが大切です。
- 小規模・シンプル:10万円以内に収まる場合があります
- 標準的な検索:初期費用は約100万〜250万円程度です
- 複雑な企業内検索:基幹連携やAI活用を含むと250万円以上になり、数百万円に達することもあります
- フルスクラッチ:独自ランキングや権限制御、既存連携を含むと、数百万円規模になります
- 運用費:サーバ費、人件費、チューニング費、バージョンアップ費が発生します
TCO(総保有コスト)で見ると、フルスクラッチはサーバ費が固定費中心です。さらに、人件費や数年ごとの更新・移行費用も続きます。
既製サービスは初期費用が小さい一方で、データ量やアクセスが増えるにつれて従量課金が伸びます。そのため、3〜5年程度の期間で初期費用と運用費を合算し、既製サービスの累計利用料と比べます。方式は、中長期のTCOで選びます。
開発期間と工程配分
開発期間は、要件の複雑さとデータ規模によって変わります。標準構成は1〜3か月、大規模構成は3〜6か月が目安です。
独自ランキングや権限制御、多システム連携を伴う場合は、大規模構成にあたります。エンタープライズ規模では、安定運用まで含めて1年程度かかることもあります。
工程ごとの期間は、要件定義から運用準備までの順序と配分で見ていきます。
- 要件定義・データ設計:2〜4週間
- データ収集・前処理・インデックス設計:2〜6週間
- 検索エンジン構築・日本語アナライザ設定:1〜3週間
- 検索精度チューニング:2〜6週間
- 検索UI・API実装:2〜4週間
- テスト・運用準備:2〜4週間
データ整備やインデックス設計、精度調整は、実データで結果を確かめながら何度も繰り返します。そのため、期間が読みにくく、膨らみやすい工程です。
既製サービスならベンダーが担う作り込みを自前で行うため、全体の期間は長くなります。納期の遅れを避けるには、繰り返しの調整に十分な余裕を見込んでおくことが大切です。
失敗しないための進め方
フルスクラッチは自由度が高い分、進め方を誤ると費用や期間が膨らみます。また、期待した検索精度が出ないこともあります。失敗を避けるための実践的な進め方は、2つあります。
PoCによる実現可能性の検証と段階的な拡張
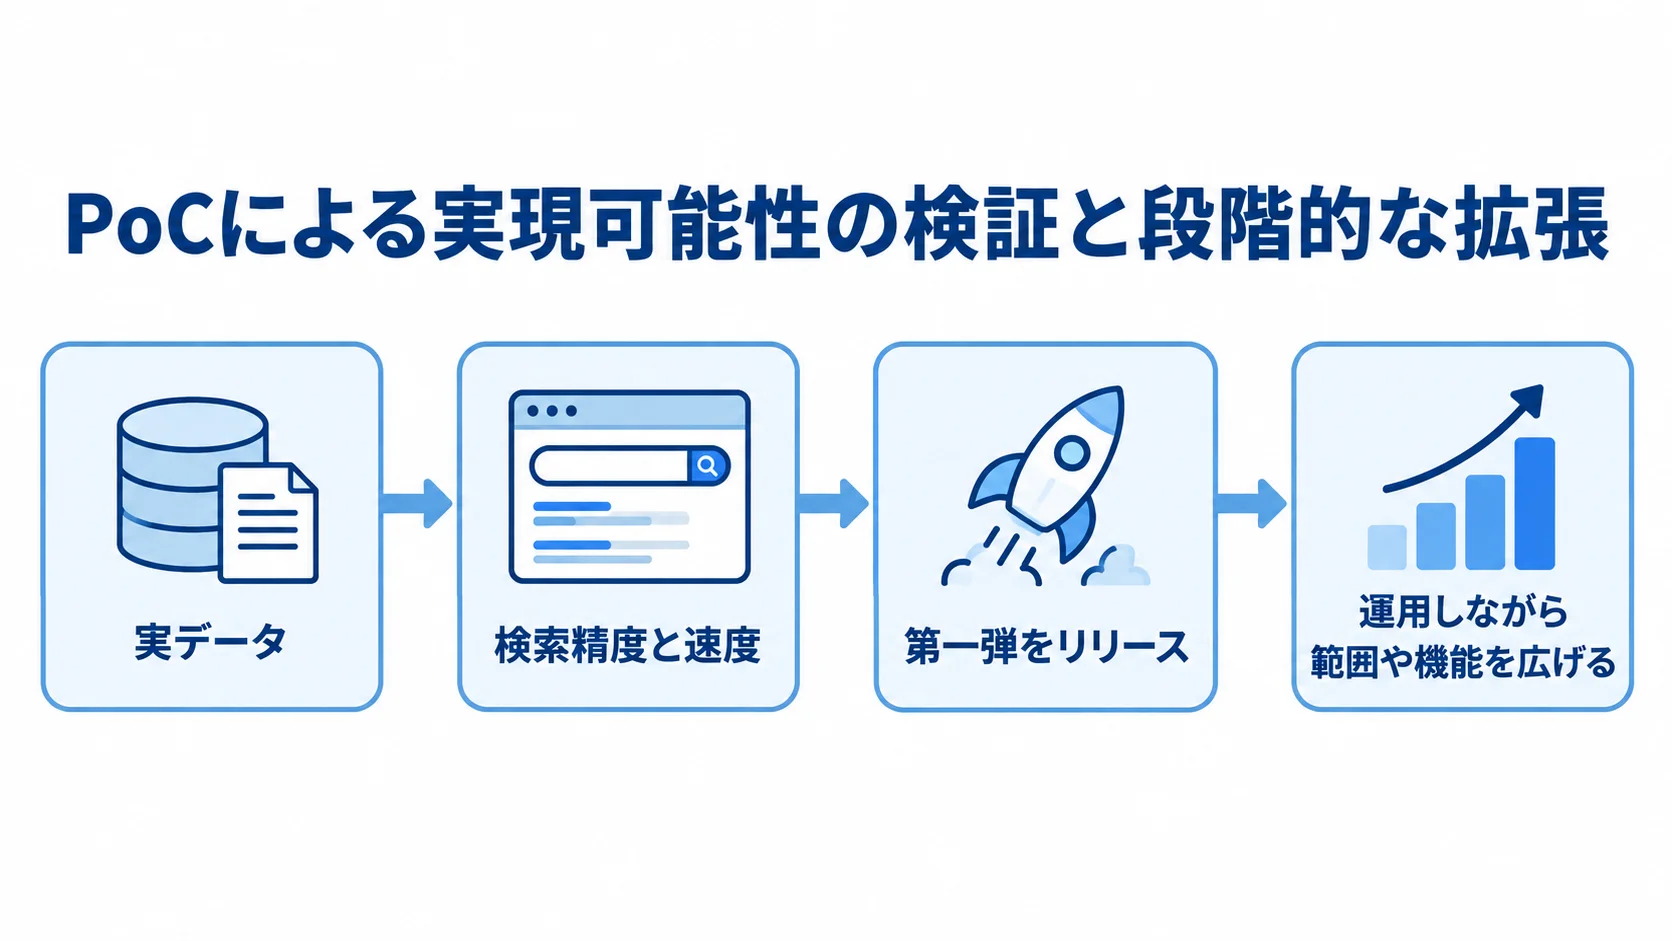
全機能の本開発に入る前に、PoC(概念実証)を行うことが欠かせません。検索精度は、実データを投入するまで読みにくいからです。
- 代表的なデータの一部を使い、選定した検索エンジンにインデックスを作る
- 想定する検索語で期待する精度と速度を確かめ、本開発のリスクと工数を見通す
- 中心的な検索ニーズに絞って第一弾をリリースし、運用しながら範囲や機能を広げる
一度に完成を目指すと、費用と期間が膨らみ、現場のニーズとずれるリスクも高まります。一方で、段階的な拡張なら、初期投資を抑えて早期に効果を確かめられます。また、検索ログも、精度を高めるためのフィードバックになります。
小さく作って検証し、成果を確認しながら育てる進め方が成功につながります。
ハイブリッド構成と将来のRAG連携に備えた設計
将来を見据えるなら、検索方式の拡張性も設計に含めておきます。その出発点は、全文検索とベクトル検索の特徴を押さえることです。
- キーワード検索:型番や固有名詞の厳密な一致に強い
- ベクトル検索:表現の揺れや意味的な近さを捉える
- ハイブリッド検索:両方式を併用して検索精度を高める
従来の全文検索は、転置インデックスとBM25によるスパース検索が中心です。そのため、表現の揺れや意味の近さは苦手です。
ベクトル検索は、テキストの意味をベクトルとして表します。キーワード検索と併用すると、厳密な一致を保ちながら、言い換えや曖昧な表現も補えます。
フルスクラッチなら、要件に合わせて構成を組めます。たとえば、ElasticsearchやOpenSearchのベクトル検索機能を使い、キーワード検索を基盤に拡張余地を残せます。
検索基盤の上に生成AI(LLM)を載せて回答を作るRAG(検索拡張生成)へ発展させる方法もあります。ただし、RAGは検索基盤とは別の技術です。
まずは全文検索を堅実に構築し、将来のハイブリッド化やRAG連携に備えて、データ設計とアーキテクチャを拡張しやすい形にしておきます。
まとめ
検索システムは、全文検索エンジンを中心に、大量のデータから関連情報を高速・高精度に提示する技術基盤です。生成AIが回答文を作るRAGや、ナレッジマネジメントの仕組みとは異なります。
既製サービスとの使い分けに加えて、フルスクラッチが必要になる要件を見てきました。独自ランキングや複雑な検索、大規模データ、セキュリティ・権限・連携の要件が該当します。
フルスクラッチには、要件適合、ロックイン回避、データ主権の利点があります。一方で、費用や運用負荷も伴います。
標準的な初期費用は約100万〜250万円、複雑な構成は250万円以上です。また、開発期間は標準構成で1〜3か月、大規模構成で3〜6か月が目安です。
方式は中長期のTCOで比べ、PoCで実現可能性を確かめてから段階的に拡張します。将来のハイブリッド検索やRAG連携に備え、拡張しやすい設計にします。
最初に、自社の要件が既製サービスの範囲を超えるかを見極めます。そのうえで、複数の開発会社に要件を伝え、見積もりと提案を比べることから始めます。
▼全体ガイドの記事
・検索システム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。