
検索システム開発は、検索要件と精度指標を先に定めたうえで、設計と実装、検証と運用改善へと段階的に進めるのが基本です。
検索システムは、用途によって要件や使う技術が変わります。一方で、主な作業の流れは共通しています。
- ユーザーが抱える検索の課題と、対象データを洗い出す
- 検索エンジン、インデックス、ランキングの設計
- 精度と性能を検証し、運用ログをもとに改善する
▼全体ガイドの記事
・検索システム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
検索システム開発の全体像
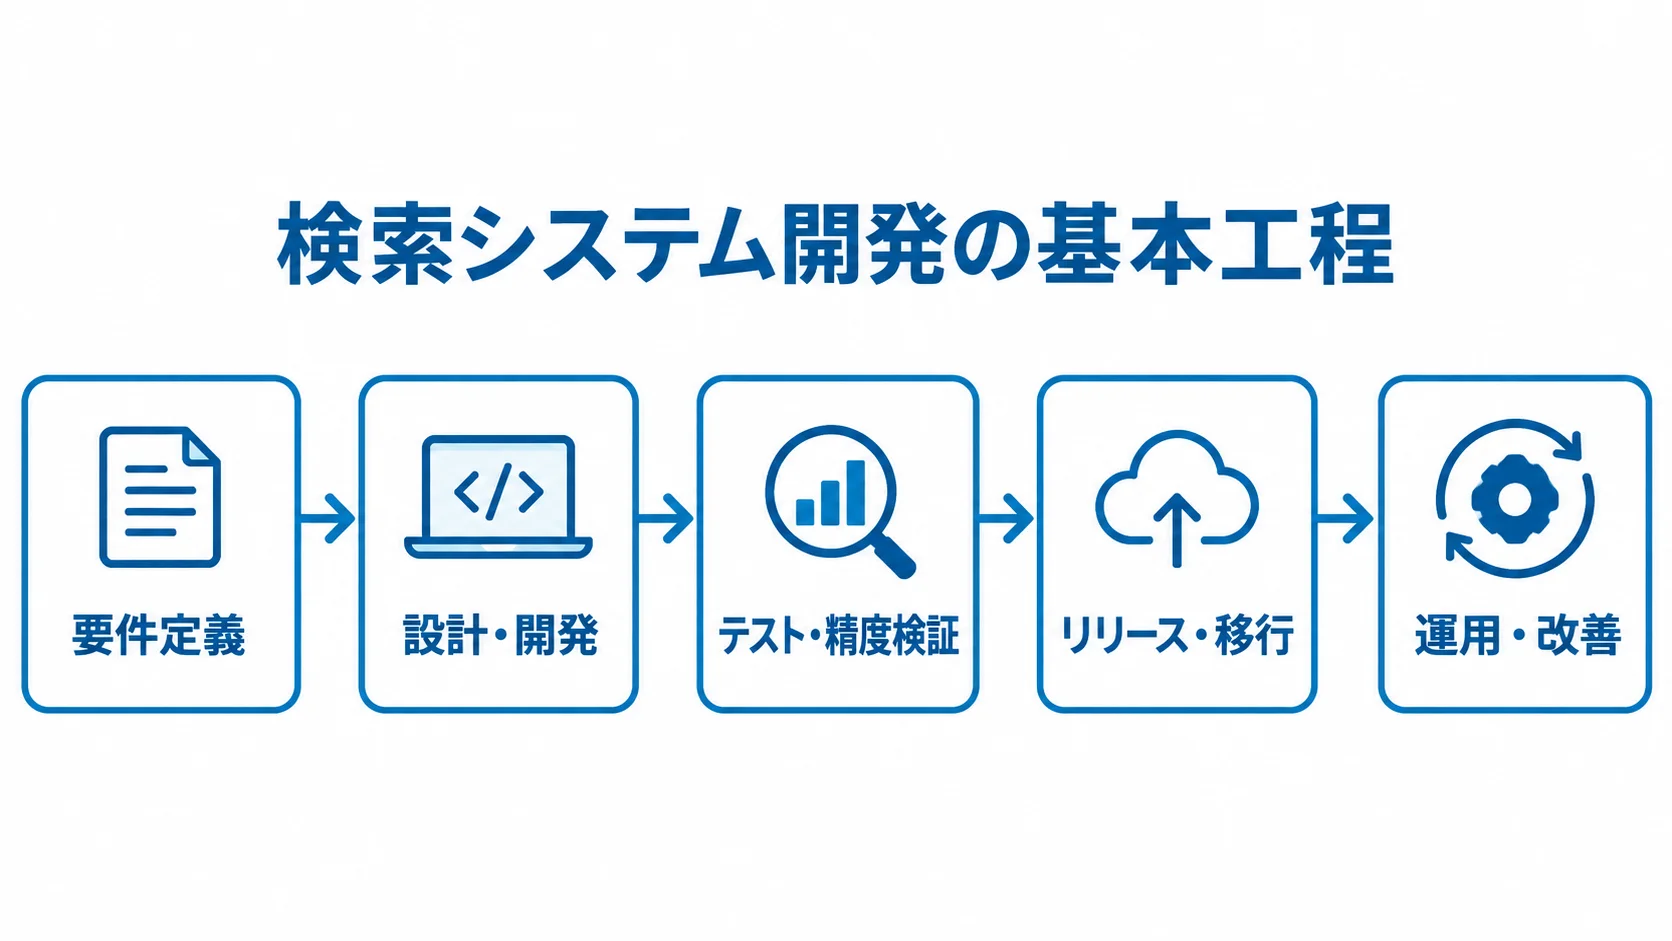
検索システム開発の6フェーズ
検索システム開発は、要件定義、設計・開発、テスト・精度検証の順に進みます。そのあとにリリース・移行、運用・改善が続きます。プロジェクト管理は、各フェーズを通して行います。
それぞれのフェーズで要件や使う技術スタックは異なりますが、開発の基本的な流れは共通しています。
一般的なWebシステム開発と異なり、検索システムでは「検索精度」という成果を数値で管理する点が特徴です。検索システムは種類によって要件や使う技術が変わり、代表的な種類は次の4つです。
- Webサイト内検索
- ECサイトの商品検索
- 社内文書検索(ナレッジベース検索)
- ログ検索・分析基盤など
特にElasticsearchやOpenSearchを使った全文検索では、インデックス設計と形態素解析の設定が品質を大きく左右します。
検索システム開発の成功要因
検索システム開発で成功するために重要な要素は3つあります。
- 検索要件の正確な把握:ユーザーがどのようなクエリで何を探しているかを、事前にデータを集めて分析することが欠かせません。
- スケーラブルなアーキテクチャ設計:データ量の増加や同時アクセスの増大に耐えられる設計が求められます。
- 継続的な精度改善の仕組み:検索ログの分析とA/Bテストによる調整を運用に組み込んでおくことが、長期的な品質の維持につながります。
要件定義フェーズの進め方
検索精度・インデックス設計の要件整理
検索精度に関する要件を明確にするには、まず現状の検索利用データを集めます。既存システムがあれば、サイト内検索のクエリログを分析して、「よく検索されているキーワード」「検索結果が0件になっているクエリ」「クリックされていない検索結果」などを洗い出します。これにより、新システムで解決すべき課題がはっきりします。
インデックス設計の要件では、検索対象となるコンテンツの種類、件数、更新頻度を整理します。たとえばECサイトの商品検索であれば、「商品数100万件、毎日1万件の更新」といった規模感を把握します。
日本語テキストの検索では、形態素解析(Kuromoji、MeCabなど)の設定方針を、早い段階で決めておく必要があります。専門用語や商品名の表記揺れへの対応も、要件に含めるべきです。さらに、ファセット検索(絞り込み)やサジェスト機能の有無も、初期段階で確定させましょう。
UIの要件整理とユーザー行動の分析
検索UIの要件は、ユーザーの検索行動のパターンをもとに決めます。オートコンプリート(入力補完)、スペルチェック・サジェスト、検索結果のハイライト表示について、取り入れるかどうかを判断します。ソート・フィルタリング機能や、ページネーションかインフィニットスクロールかも、必要性を見極めます。
モバイル対応の要否や、WAI-ARIAへの対応などのアクセシビリティ要件も、この段階で確定させます。非機能要件では、特にパフォーマンス要件が大切です。
検索レスポンスタイムの目標値(例:95パーセンタイルで200ms以内)、同時アクセス数(例:ピーク時1,000リクエスト/秒)、可用性要件(例:99.9%のSLA)を明確に定義します。これらの数値は、後の技術選定とインフラ設計に直結します。
検索品質KPIの設定
検索システムでは、品質を数値で評価するKPIを要件定義の段階で決めておきます。
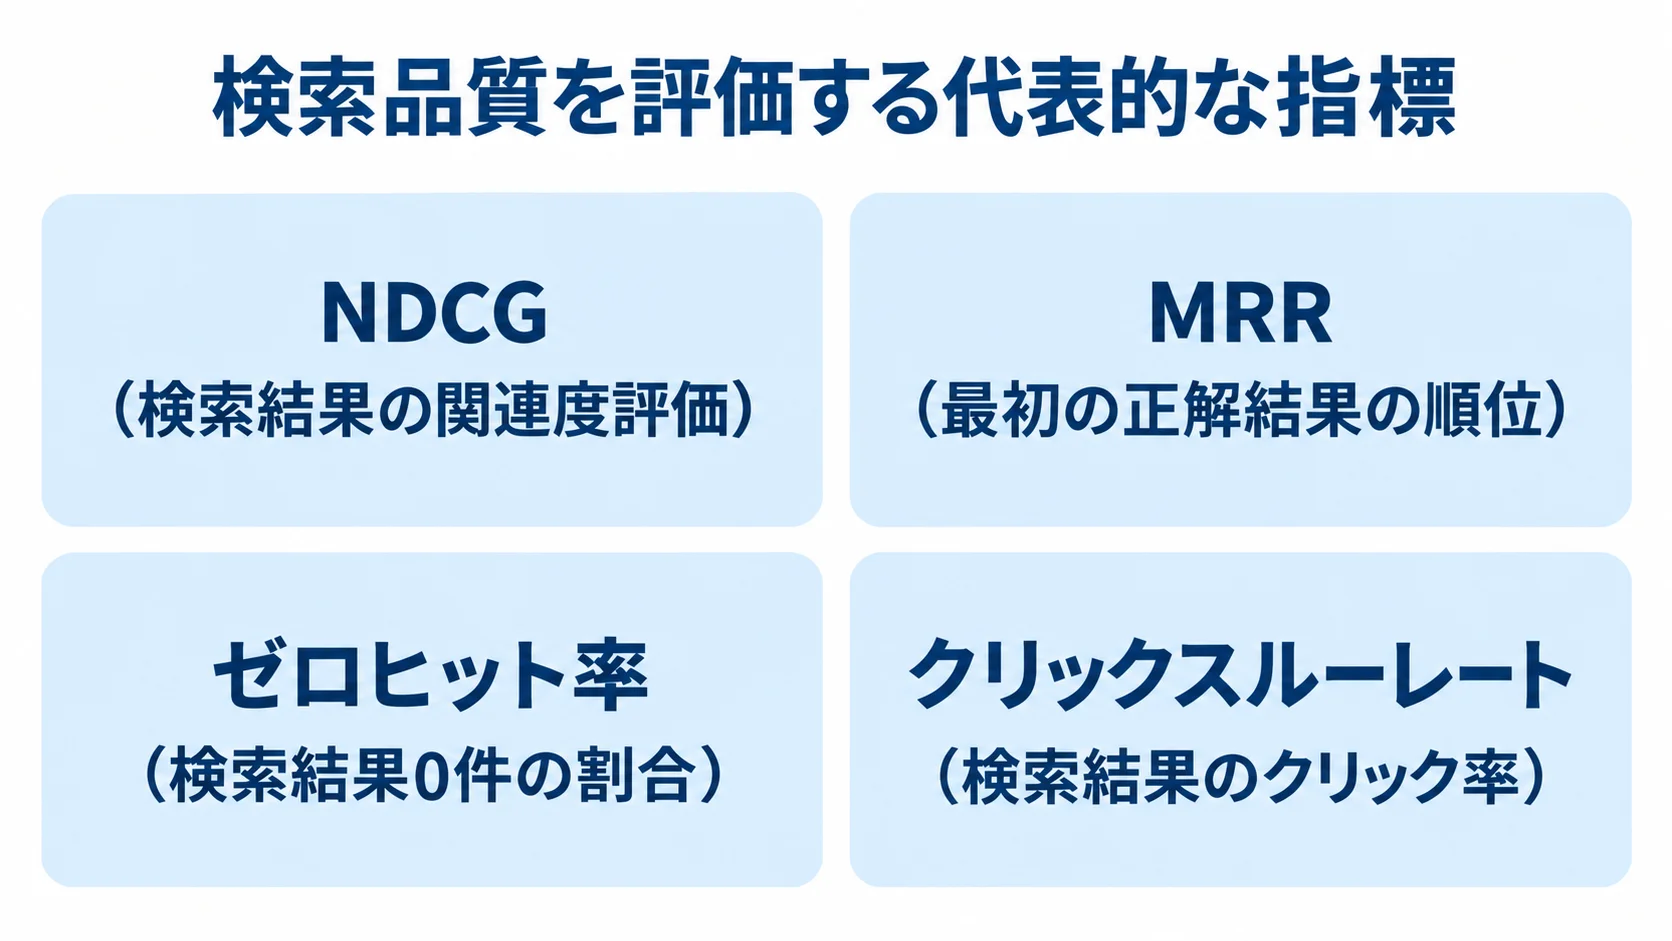
代表的な指標は、NDCG(Normalized Discounted Cumulative Gain:検索結果の関連度評価)とMRR(Mean Reciprocal Rank:最初の正解結果の順位)です。ほかに、ゼロヒット率(検索結果0件の割合)やクリックスルーレート(検索結果のクリック率)もあります。
ここで決めた目標値は、テストフェーズで合否を判定する基準になります。
設計・開発フェーズの進め方
検索エンジン選定のポイント
検索エンジンの選定は、開発の成否を左右する意思決定です。主な選択肢は、Elasticsearch(オープンソース)とOpenSearch(AWSマネージド版のElasticsearch後継)です。ほかに、Apache Solr、Algolia(SaaS型)、Meilisearch(軽量オープンソース)などがあります。
データ規模では、数万件ならMeilisearch、数百万件以上ならElasticsearchかOpenSearchを候補にします。運用コストでは、SaaS型のAlgoliaは運用の負荷が低い一方で、費用が高くなります。
カスタマイズ性では、ランキングの細かな調整が必要ならElasticsearchが合います。既存インフラとの親和性では、AWSを主に使っているならOpenSearchが合います。日本語検索の品質を重視するなら、Kuromojiプラグインが充実しているElasticsearchまたはOpenSearchが第一候補になります。
インデックス設計とAPI設計
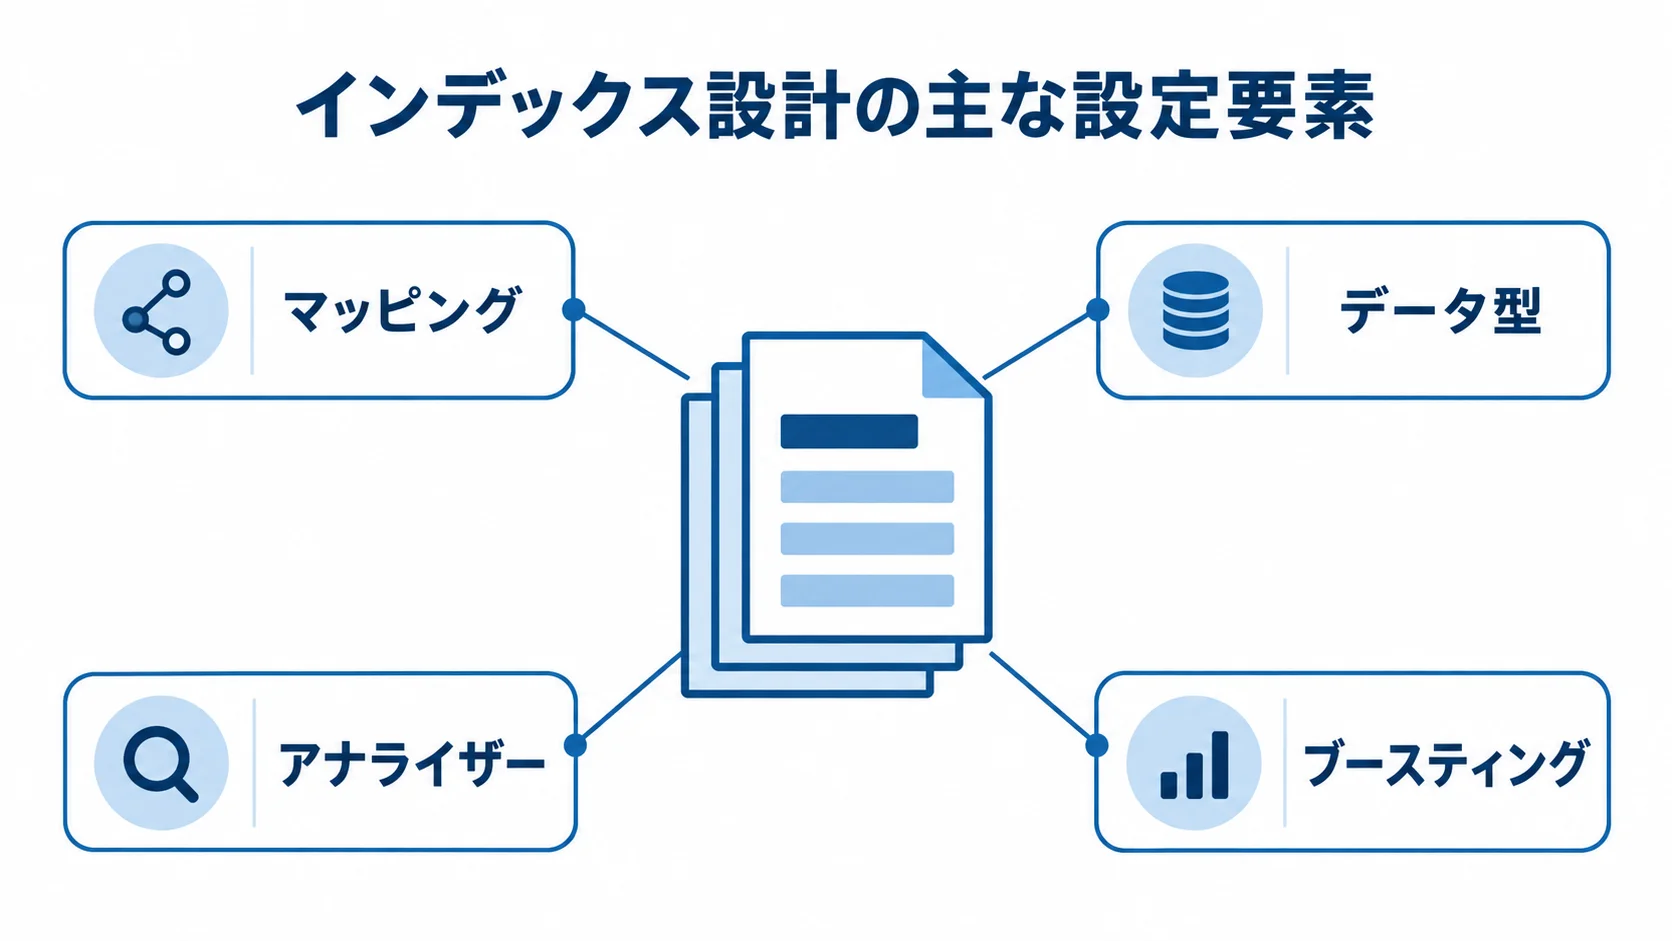
インデックス設計では、検索対象データの構造(マッピング)を定義します。各フィールドのデータ型(text、keyword、integer、date等)、アナライザーの設定(標準アナライザー、Kuromojiアナライザー等)、ブースティング(特定フィールドの重み付け)を決めます。たとえばECサイトでは、商品名フィールドに高いブーストをかけ、説明文は低いブーストにする設定が一般的です。
インデックスの更新は、リアルタイム更新(商品価格の変更を即時反映)が必要か、バッチ更新(夜間の一括再インデックス)で足りるかによって、アーキテクチャが大きく変わります。さらに、大規模データでインデックスを作り直す場合は、Blue/Greenインデックス切り替えのパターンを採用し、検索サービスを止めずに更新する設計が推奨されます。
検索APIの設計では、RESTful APIのエンドポイント設計、クエリパラメータの整理、レスポンス形式の統一を行います。フロントエンドとバックエンドの分離を意識する場合は、GraphQLを採用するケースも増えています。また、検索APIのレート制限やキャッシュ戦略(Redis等を活用したクエリキャッシュ)も、設計段階で検討します。
ランキングアルゴリズムとレコメンデーション設計
検索結果のランキングは、ユーザー体験を大きく左右します。基本のランキングには、TF-IDF(単語の出現頻度と逆文書頻度)やBM25アルゴリズムを使います。そのうえで、新着商品の優遇や在庫ありの商品の上位表示といったスコア調整も組み込みます。
クリック数や購買数といったユーザーの行動データをフィードバックとして学習する、機械学習ランキング(Learning to Rank)の導入も検討に値します。
レコメンデーション機能は、検索と密接に連携します。「この検索結果と一緒によく見られている商品」「あなたへのおすすめ」といった機能は、協調フィルタリングやコンテンツベースフィルタリングで実現できます。近年は、Elasticsearch/OpenSearchのkNN(k-Nearest Neighbor)検索を使ったベクトル検索によるレコメンデーションも注目されています。
テスト・精度検証フェーズの進め方
機能テストと精度評価テスト
機能テストでは、キーワード検索、フレーズ検索、ファジー検索の動作を確かめます。フィルタリングやファセット機能、ソート機能、ページネーションも、仕様どおりに動くことを確認します。オートコンプリートの動きも、テストの対象です。
特に日本語では、「パソコン」「PC」「PC」の同義語処理、送り仮名の違い(「取り扱い」「取扱い」)、英数字の全角と半角の正規化を、テストケースに含めることが欠かせません。
精度評価テストは、検索システムならではのテスト工程です。事前に「テストクエリセット」(評価用の検索クエリ一覧)と「正解リスト」(各クエリで期待される上位表示コンテンツ)を作ります。そのうえで、NDCGやPrecision@K(上位K件中の関連ドキュメントの割合)などのメトリクスで定量評価します。最後に、要件定義で設定したKPIの目標値をクリアしているかを確認します。
パフォーマンステストと負荷テスト
検索システムはリクエストの頻度が高いため、パフォーマンステストが特に大切です。Apache JMeterやLocustなどの負荷テストツールを使い、本番を想定したアクセスパターンで、レスポンスタイムとスループットを計測します。
加えて、スパイクテスト(急激なアクセス増加への対応)や耐久テスト(長時間稼働でのメモリリーク確認)も実施します。また、Elasticsearch/OpenSearchの調整では、シャード数の見直し、レプリカの設定、JVMヒープサイズの調整が対象になります。クエリキャッシュの活用も、改善の一つです。
パフォーマンステストの結果をもとに、インフラのサイジングを最終確定し、本番環境の構成を決めます。
リリース・移行フェーズの進め方
段階的リリース戦略とデータ移行
検索システムのリリースは、段階的に進めることをお勧めします。カナリアリリース(一部ユーザーへの先行公開)やA/Bテストを使えば、問題が起きたときの影響範囲を最小限にできます。また、旧検索システムとの並行稼働期間を設け、新旧の検索品質を比べながら切り替えると、安全に進められます。
初期のインデックス構築では、既存データを新しいElasticsearch/OpenSearchクラスタへ移行します。データ量が多い場合(数百万件以上)は、バルクインサートAPIを使った並列投入で時間を短縮します。
インデックス構築中も既存の検索システムを継続して稼働させ、構築が終わったら、DNS切り替えや負荷分散の設定を変えて、本番への移行を完了させます。
リリース直後の監視体制と緊急対応
リリース直後は、安定稼働を確かめるために、集中的な監視体制を敷きます。
監視すべき主な指標は、検索レスポンスタイム(p50/p95/p99)、エラーレート、JVMヒープ使用率です。さらに、Elasticsearchクラスタのヘルス状態(ノードのステータス、シャードの割り当て状態)も、監視の対象になります。
DatadogやGrafana/Prometheusなどの監視ツールでアラートを設定し、閾値を超えたらすぐに通知が届く体制を整えます。
運用・改善フェーズの進め方
検索ログ分析と継続的な精度チューニング
検索システムの品質は、運用を通じて継続的に改善します。まず、検索ログ(クエリ、クリックデータ、検索後の行動)を定期的に分析して、改善ポイントを特定します。具体的には、ゼロヒットクエリの分析(辞書追加や同義語設定が必要なキーワードの発見)、離脱率の高い検索クエリの特定(検索結果の質が低いクエリの改善)、検索後のコンバージョン率の計測などを行います。
精度チューニングの手法には、同義語辞書の更新(例:「スマホ」「スマートフォン」「携帯」を同義語登録)や、ストップワードの設定(検索精度を下げる助詞等の除外)があります。フィールドブーストの調整やカスタムスコアリングスクリプトの改良も、手法の一つです。月次でKPIの計測値を確認し、目標値を下回ったら原因分析と改善施策を実施する、PDCAサイクルを確立します。
インフラ管理とバージョンアップ対応
Elasticsearch/OpenSearchは、バージョンアップが頻繁に行われるため、定期的なアップグレード計画が欠かせません。メジャーバージョンアップでは、マッピングの変更やAPIの非互換性が生じることがあります。そのため、本番に適用する前に、検証環境でテストを行います。
また、クラスタのノードを追加・削除(スケールアウト/イン)する手順を整備し、データの増加に対応できる体制を整えます。費用を抑える方法として、インデックスを階層で管理する仕組み(Hot/Warm/Cold/Frozenアーキテクチャ)があります。アクセス頻度の低い古いデータを安価なストレージへ移しながら、検索性能を維持できます。
クラウドを使っている場合は、リザーブドインスタンスの活用や自動スケーリングの設定も、運用で押さえておきたい項目です。
まとめ
検索システム開発を成功させるには、要件定義から運用改善まで、各フェーズを適切に進めることが欠かせません。
特に大切なのは、要件定義で検索精度のKPIを決めることです。そのうえで、適切な検索エンジン(Elasticsearch/OpenSearchなど)を選ぶことと、インデックス設計と形態素解析を整えることが、成功の鍵になります。さらに、段階的なリリースと、検索ログの分析によるチューニングを続けることも、品質を保つうえで必要です。
各フェーズを丁寧に進めることで、ユーザーが求める情報に確実にたどり着ける高品質な検索体験を実現できます。
▼全体ガイドの記事
・検索システム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。