
自己組織化マップ(SOM)は、ラベルのないデータを、似たものが近くに並ぶ低次元の地図に写す教師なし学習の手法です。
顧客・製品のセグメント発見や、センサー状態の把握、文書・画像の特徴整理に使えます。仕組みや学習の流れ、k平均法やPCAとの違いも、導入前に知っておくと役立ちます。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
自己組織化マップの基本:似たデータを近くに配置する学習の仕組み
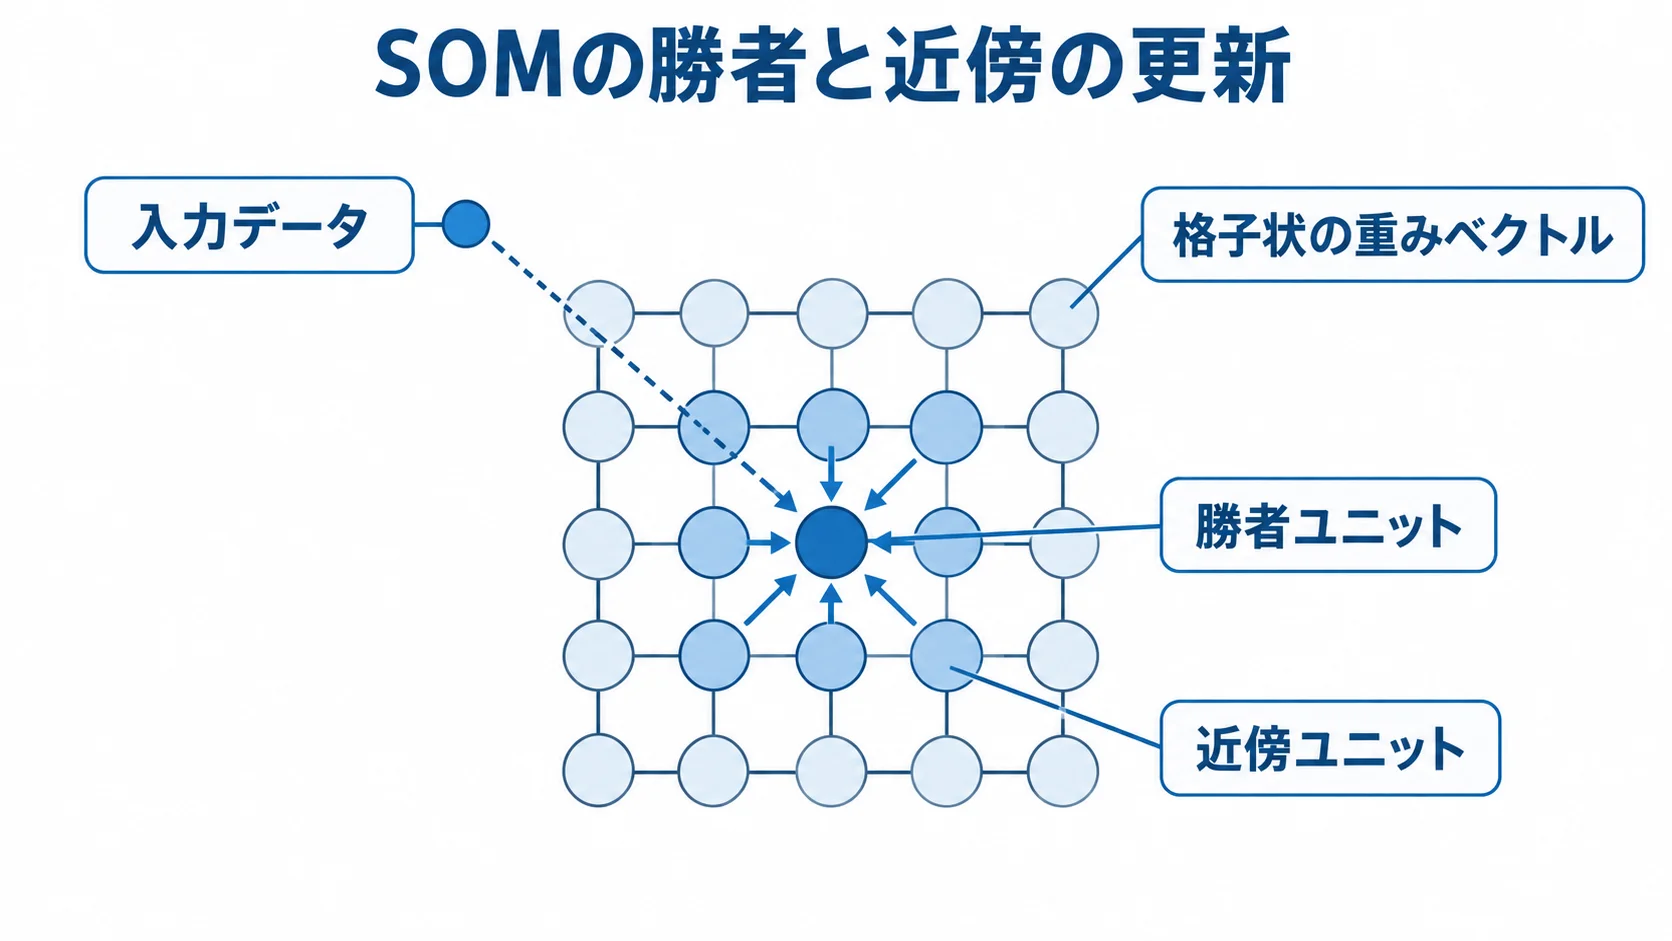
自己組織化マップでは、入力特徴量と同じ次元の重みベクトルを格子状に並べます。入力データを1件ずつ与えると、最も似た重みを持つユニットが勝者(BMU:Best Matching Unit)に選ばれます。
次に、勝者と近隣ユニットの重みを入力に近づけます。こうした更新を重ねることで、入力空間で近いデータがマップ上でも近くなるよう学習します。
勝者ユニットと近傍の更新
SOMの更新では、勝者と近傍の役割を分けて見ると、地図ができる仕組みが分かります。
- 勝者ユニット:入力に最も似た重みを持つユニットを指します。
- 近傍ユニット:勝者の周囲にあって、入力に近づくよう重みを更新するユニットです。
k平均法は割り当て先のクラスタ中心を更新します。一方、SOMは勝者の周囲のユニットも更新します。
学習率と近傍半径は徐々に小さくし、初めに大まかな地図を作ってから、局所的な差を調整します。この近傍の更新があるため、クラスタを番号ではなく地図上の位置関係として読み取れます。
距離と特徴量のスケールによる結果の違い
SOMは入力とユニットの距離で勝者を選びます。そのため、特徴量の尺度の違いと外れ値に注意が必要です。
- 特徴量の尺度:標準化や正規化の方法を決めます。
- 外れ値:機械的に削除せず、重要な事象か計測ミスかを見て前処理を選びます。
年収と購入回数、温度と電圧のように単位の異なる特徴を混ぜると、値の範囲が大きい特徴量が結果を支配しがちです。そのため、尺度を揃えておきます。
自己組織化マップの学習の流れと設計項目
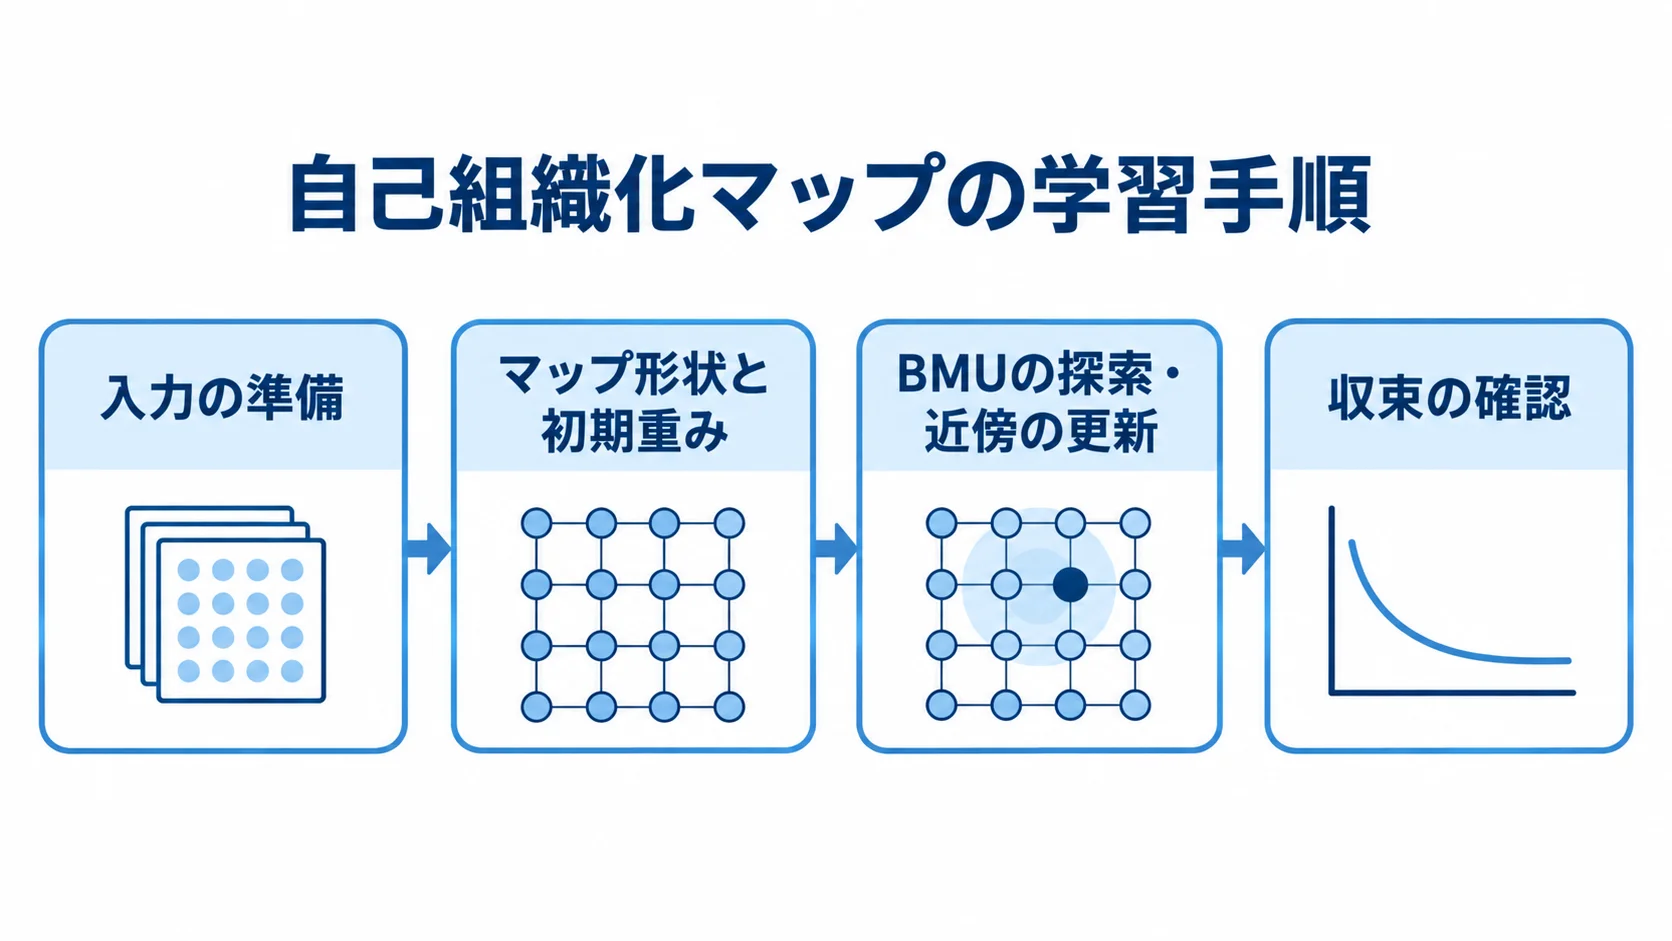
学習は、入力の準備からマップの解釈可能性の確認まで、6つの段階で進みます。
- 入力を整える:欠損、外れ値、カテゴリ表現、特徴量の尺度を確かめます。
- マップ形状を決める:行・列の数と、矩形または六角形の近傍構造を決めます。
- 初期重みを設定する:乱数かデータ分布に基づく初期化を選び、乱数シードを記録します。
- BMUを探す:各入力に最も近いユニットを選びます。
- 近傍を更新する:学習率と近傍関数に応じて、勝者周辺の重みを更新します。
- 収束を確認する:反復回数、量子化誤差、トポロジー誤差、解釈可能性を見ます。
マップを大きくすると細かな差を表せますが、データ数に対して大きすぎると空の領域が増えます。一方で、小さすぎるマップでは異なる集団が同じユニットに集まり、特徴を分けにくくなります。
そこで、複数のマップサイズを比べ、数値指標と担当者が説明できる粒度の両方から選びます。
マップの可視化によるパターンと境界の読み取り
コンポーネント平面による特徴量の分布確認
コンポーネント平面を使うと、特徴量ごとの分布を並べて比べられます。
- 平面を並べる:各特徴量の重みを色で示し、高い領域や特徴の組み合わせを探す。
- 表示条件を揃える:色尺度、比較対象、欠損を明示して、見た目の差を読み違えないようにする。
たとえば、購入頻度と価格感度がともに高い顧客群などを見つけられます。
ユニット間の距離による境界候補の探索
U-Matrixなどで、隣り合うユニットの重みの距離を地図に示すと、集団の境界候補を探せます。
距離の大きい場所は境界候補ですが、必ずしも意味のある顧客セグメントとは限りません。そこで、代表データや業務属性、期間ごとの再現性と照合し、マップの解釈は仮説として扱います。
k平均法やPCAとの目的と表現の違い
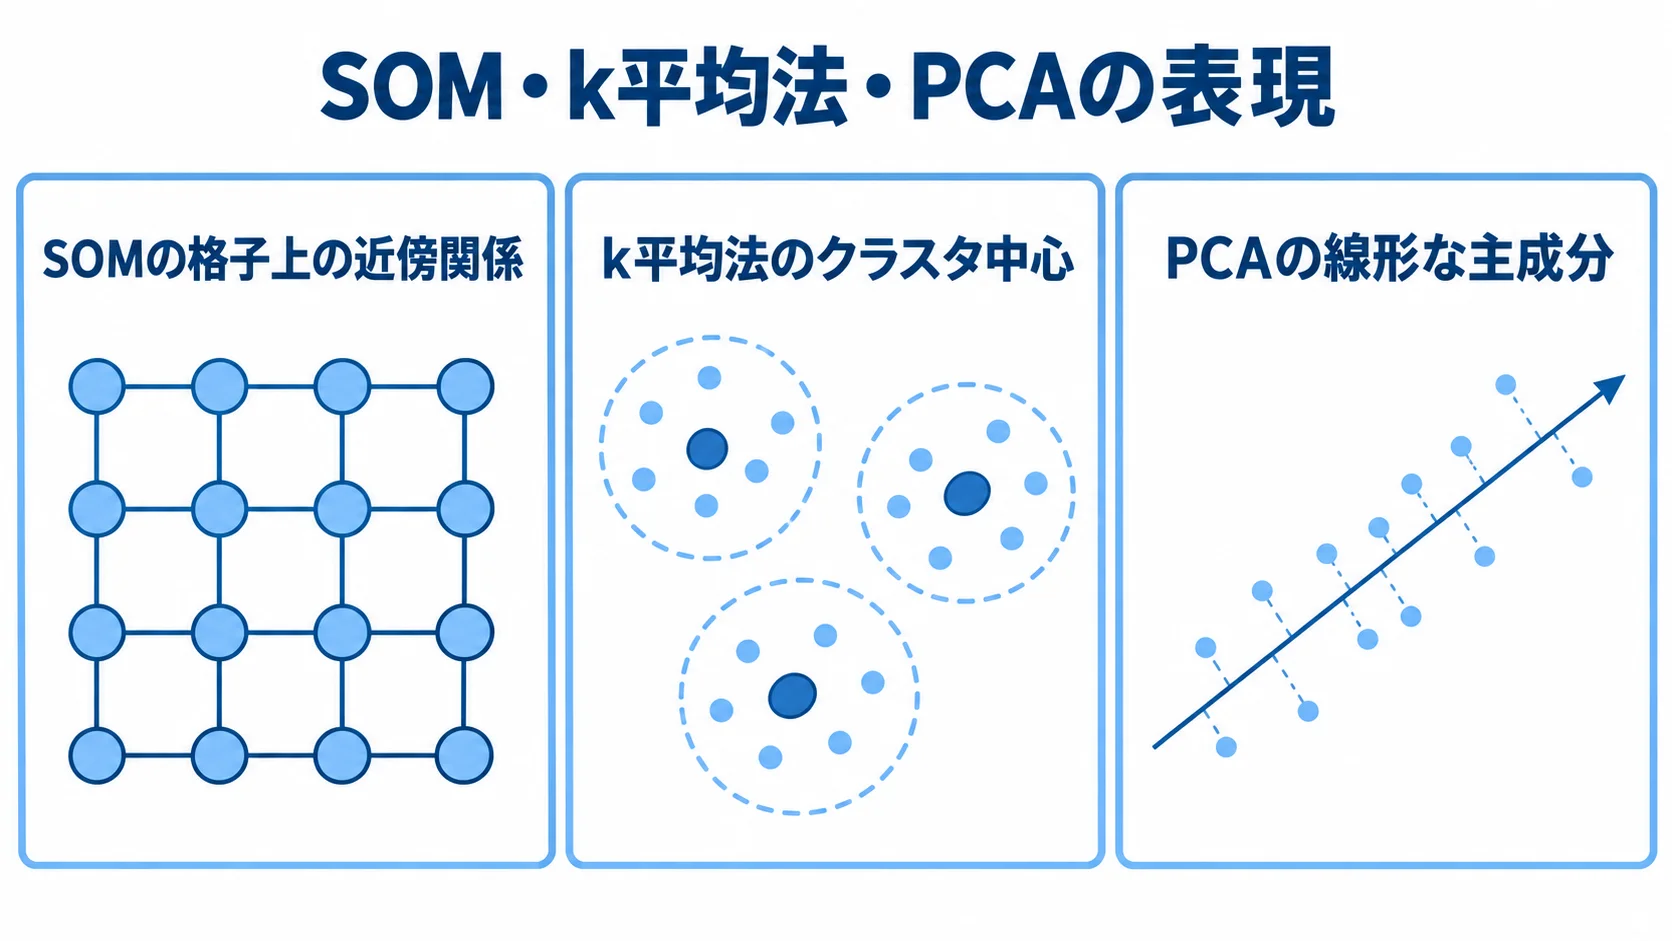
k平均法は、指定したクラスタ数にデータを分け、各クラスタの中心を得る手法です。扱いやすい一方で、クラスタ同士の位置関係を地図として表すことはできません。
SOMは格子上の近傍関係を保って配置するため、境界が連続的に変化するデータを探索できます。
PCAは、分散をよく説明する線形な主成分へデータを射影する次元削減の手法です。可視化や前処理に有効ですが、近傍ユニットを更新するSOMとは学習の仕組みが異なります。
SOMで見つけたパターンは、PCAやクラスタリングでも確かめます。手法に依存した見かけの構造ではないかを比べるためです。
自己組織化マップの実務での活用例
自己組織化マップは、次のようなデータ群の探索に利用できます。扱うデータが変われば、見つけられる対象も変わります。業務ごとの例を、4つ挙げます。
- 顧客:購入頻度、金額、カテゴリ、問い合わせから施策対象を探す。
- 設備:センサー値を配置し、通常と異なる領域を点検候補として挙げる。
- 商品:売上、粗利、在庫回転、顧客層から、似た商品群を見つける。
- 文書・画像:ベクトル化した特徴による、似た資料と外れた資料の把握。
運用では、領域ごとの施策と代表データを決め、確認の頻度や再学習の条件も定めておきます。たとえば、顧客群ごとにキャンペーンを変え、売上だけでなく解約率や問い合わせ負荷も追跡します。
導入では、分析担当者が見つけたパターンを、現場が再現できる説明に言い換えることが欠かせません。
自己組織化マップで起きやすい失敗と対策
マップ上の距離を因果関係とみなす誤り
SOMは特徴量の類似性を配置する手法で、施策の原因や将来の成果までは示せません。代表データで、別の期間や別のサンプルでも同じ傾向が出るかを確かめ、仮説検証の入力として使います。
前処理と乱数の条件差による比較のしにくさ
標準化や欠損処理の方法、初期重みが違えば、マップの形も変わります。マップサイズや学習率が異なる場合も同じです。そのため、実験条件と乱数シードを記録し、複数回の実行で安定する構造と偶然の構造を分けて見ます。
数値指標だけで決める評価の限界
量子化誤差やトポロジー誤差に加え、業務上の意味や施策へのつながりも確かめます。指標と可視化、代表データ、業務KPIを組み合わせ、担当者が説明できるかを評価します。
自己組織化マップ導入のチェックリスト
導入前には、特徴量の定義から業務での運用まで、5つの項目を確かめておきます。
- 何を似ているとみなすか(特徴量と距離の定義)。
- 欠損、外れ値、標準化、カテゴリ変換の確認。
- マップサイズ、近傍構造、学習率、反復回数の記録。
- 誤差指標と複数シードによる安定性の確認、代表データと業務属性による仮説の照合。
- 施策・監視・再学習につなげる運用の決定。
定期運用では、入力データの期間と特徴量の定義、マップの更新周期を固定しておきます。そうしないと、データ分布が変わったときに、同じユニット番号でも意味が変わる可能性があります。更新の前後でマップと代表データを保存すると、セグメントの移動も追えます。
施策に使う場合、マップ上の位置だけで対象者を決めず、元の特徴量と担当者の確認を必須にします。自動配信など影響の大きい判断では、除外条件と人による承認点を設けます。
データの近さを探る可視化手法としての自己組織化マップ
自己組織化マップは、入力に近いユニットとその近傍を更新し、高次元データを低次元の地図へ配置します。この仕組みを使うと、顧客、設備、文書のパターンや、似た集団と境界候補を探せます。ただし、特徴量の尺度やマップサイズ、近傍更新の設計が結果に影響します。
見た目を正解とせず、代表データや別期間、他手法との照合に加えて、業務KPIとのつながりも確かめてください。さらに、施策や監視へつなげ、条件と再現性を記録して、継続利用できる状態にします。
よくある質問(FAQ)
自己組織化マップを使うときによくある疑問に、順に答えます。
Q. 自己組織化マップとは何ですか?
ラベルのないデータを学習し、似たデータを近くに配置する教師なし学習の手法です。高次元の特徴を2次元などの格子へ写し、データの分布を可視化して探索します。
Q. k平均法との違いは何ですか?
k平均法は指定したクラスタへデータを分ける方法で、SOMは近傍関係を保つ地図へデータを配置する方法です。集団間の連続的な位置関係を探したい場合は、SOMが適しています。
Q. 標準化や正規化は必要ですか?
多くの場合は必要です。距離で勝者を選ぶため、値の範囲が大きい特徴量が結果を支配することがあります。そのため、業務上の意味を確認したうえで、前処理方法を固定して比較します。
Q. マップ上の領域はそのまま顧客セグメントになりますか?
そのまま確定するとは限りません。代表データや別の期間での再現性、業務属性を確認し、施策の結果も踏まえたうえで、分析上のパターンを実行可能なセグメントとして解釈します。
Q. 自己組織化マップはどのように評価しますか?
量子化誤差やトポロジー誤差に加え、複数の初期値で構造が安定するかも確認します。さらに、代表データを説明できるか、施策や監視のKPIにつながるかも評価します。
参考資料
SOMの実装やクラスタリングを理解するときに、参考になる資料です。
- Orange Documentation「Self-organizing maps」
- TorchSOM Documentation「Basic Concepts」
- Google for Developers「What is clustering?」
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。