
自己教師あり学習は、ラベルのないデータから学習課題を作り、疑似的な正解を使って表現を学ぶ方法です。
Google for Developersも、ラベルなしデータを教師あり学習の問題へ変換する技術群として説明しています。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」をダウンロードできます。で詳しく解説しています。
自己教師あり学習の仕組み
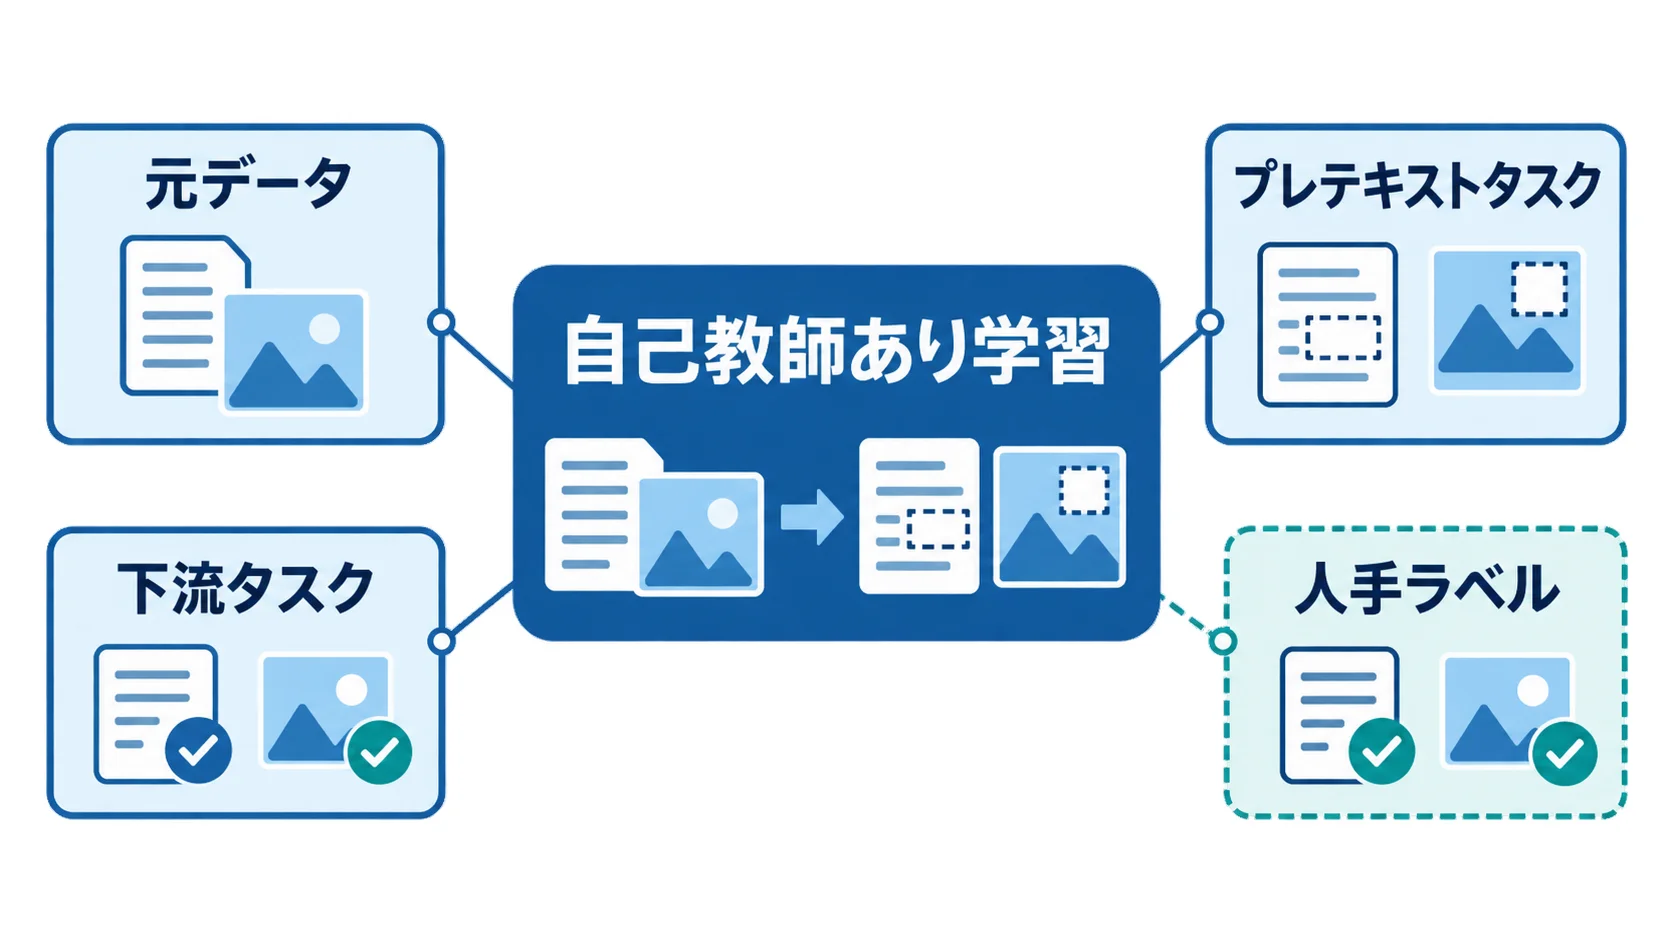
通常の教師あり学習では、入力と人手で付けたラベルの組を用意します。一方で、自己教師あり学習は、元データそのものから入力と目標を生成します。
たとえば文章では一部の単語を隠して予測させ、画像では別の変換を施した二つの画像が同じ対象だと学習させます。モデルは、こうした課題を解く過程で、後のタスクに役立つ特徴表現を獲得していきます。
大量の画像、文章、音声を先に学習しておき、その後に少量のラベル付きデータで分類や予測へ適応させられます。そのため、アノテーション費用を抑えながら、汎用的な特徴を得られます。
疑似ラベルを作る課題(プレテキストタスク)
プレテキストタスクは、学習のために人工的に設けた課題です。たとえば、画像の回転角を当てる課題や、画像の一部を復元する課題があります。
文章では次のトークンを予測し、音声では欠けた部分を推定します。さらに、課題の正解は人が注釈しなくても機械的に作れるため、データの規模を大きくできます。
下流タスクに使える表現の獲得
学習の良し悪しは、事前学習の損失の大きさよりも、入力を意味のあるベクトルへ変換できるかで見ます。分類や検索、異常検知などの下流タスクで、その力が役立つかが問われます。
その確認には、事前学習したエンコーダーを固定して線形分類器だけを学習する方法と、少量のラベルでモデル全体を微調整する方法を比べます。
自己教師あり学習の設計パターン
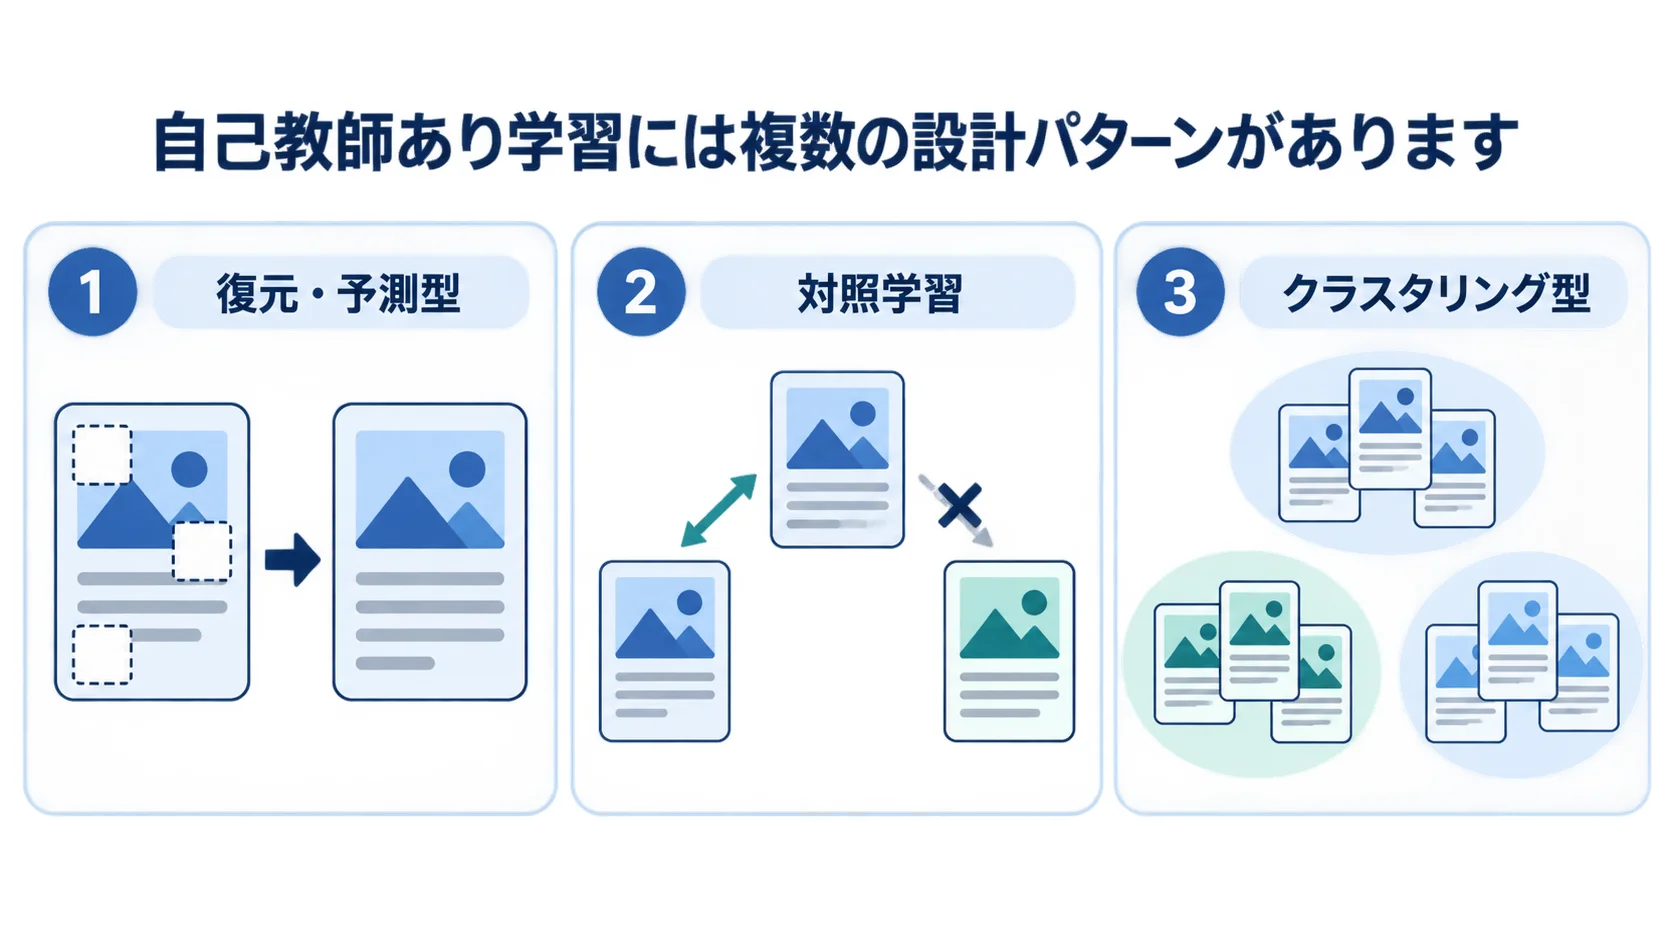
学習課題は、データ形式と下流タスクで必要な情報に応じて選びます。どの方法でも、人工的な変換が本来残したい情報を壊していないかを確かめる必要があります。
欠けた情報を当てる復元・予測型
マスクした単語を予測する言語モデルや、画像パッチを復元するモデルは、周囲の文脈をもとに欠けた情報を推定します。
入力の順序や局所的な構造は学びやすい一方で、頻出語や低レベルの模様だけを覚えていないかを検証する必要があります。
対照学習:近づける例と遠ざける例
同じ画像に異なるクロップや色変換を施したペアを近い表現にし、別の画像を遠ざけます。また、テキストと画像など、同じ対象を表す異なるモダリティを対応づける設計もあります。
正例と負例の作り方、バッチサイズ、温度パラメータは、いずれも結果に影響します。
表現の一貫性を学ぶクラスタリング型
異なる拡張を施した同じサンプルの表現が、同じクラスタや同じ予測分布になるように学習します。なお、負例を明示的に使わない設計もあります。
表現が一つの値に崩れてしまう「表現崩壊」を防ぐために、正規化、停止勾配、予測器などの仕組みを確かめます。
教師なし学習・半教師あり学習との違い
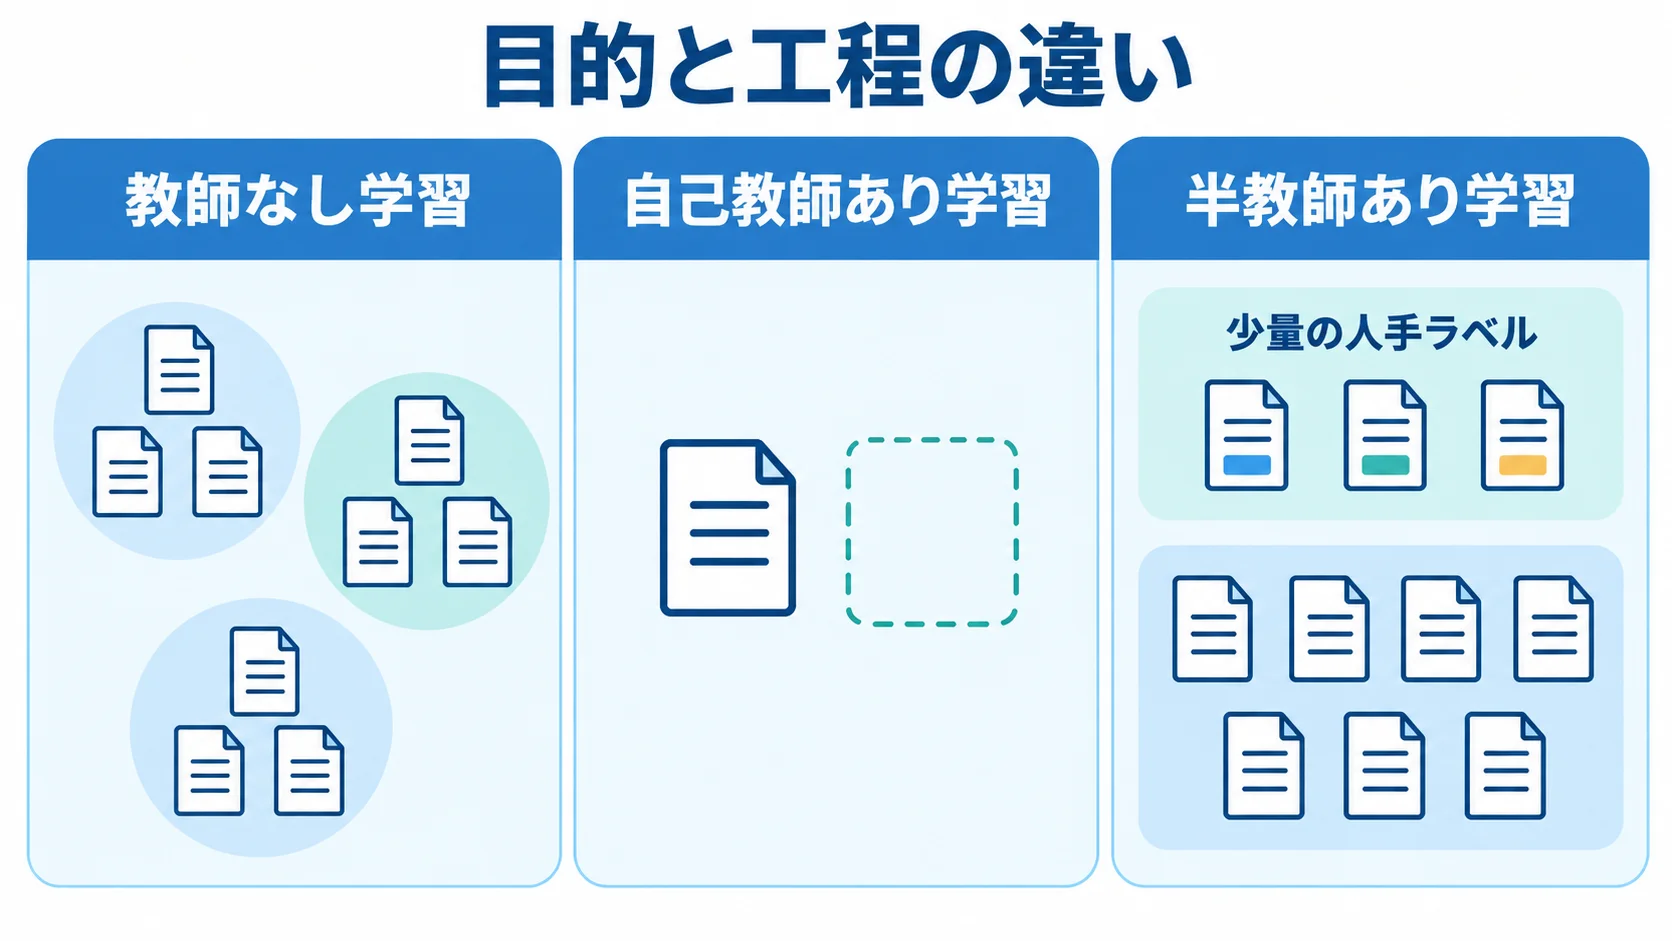
教師なし学習は、クラスタリングや次元削減のように、ラベルを使わずにデータの構造を分析する広い概念です。
自己教師あり学習は、その中でもデータから予測課題を作り、教師あり学習に似た損失で表現を学ぶ点に特徴があります。
半教師あり学習は、少量の人手ラベルと大量のラベルなしデータを同時に使う工程です。また、自己教師ありの事前学習と組み合わせることもあります。
ラベルの少ない業務への転移学習
まず自社の未ラベルデータで事前学習し、次に業務ラベルで微調整します。事前学習データと本番データの分布が近いほど効果を期待しやすい一方で、異なる顧客・期間・設備のデータへ移すと性能が落ちることがあります。
また、評価用データは事前学習に混ぜず、時系列や顧客単位で分けておきます。
導入の進め方:データ設計と下流評価の順序
導入では、データ設計と下流評価を先に決めてから進めます。確認する項目は次の5つです。
- 利用目的を定義する:分類、検索、異常検知など、成果指標と利用者を決めておく。
- データの権利と品質を確認する:個人情報、著作権、重複、欠損、期間の整理。
- プレテキストタスクを選ぶ:業務で保持したい特徴を壊さない変換の設計。
- 事前学習と下流学習を分離する:テストデータの漏えいを防ぎ、固定と微調整を比べる。
- ベースラインと比較する:ラベル付きデータだけで学習したモデルや既存ルールを、基準として用意しておく。
導入後の運用では、監視の仕組みも用意しておきます。
- 運用監視を設計する:入力分布、再学習の条件、誤判定時の人手確認。
事前学習では、データの量だけでなく、対象業務に関係する多様性と代表性も確かめます。公開データを混ぜる場合は、利用規約の範囲と本番データとの重複を調べる必要があります。
少量のラベルでは過学習が起きやすいため、微調整時は、学習率を下げる、層を一部固定する、早期終了を使うといった対策を行います。
評価:下流性能とデータ漏えいの切り分け
分類なら適合率・再現率・F1、検索ならランキング指標、異常検知なら検知遅延や誤警報率など、利用目的に合う指標を選びます。
ラベル数を変えて学習曲線を作ると、自己教師あり事前学習によって、ラベル効率がどれだけ高まったかが分かります。ただし、表現の可視化はあくまで補助材料で、可視化だけで性能を断定することはできません。
同じ顧客・画像・文書の近いコピーが学習とテストにまたがると、性能が過大に評価されてしまいます。そこで、重複を取り除き、時系列や顧客単位で分けたうえで、前処理は学習データだけに限ります。さらに、評価セットへのアクセスも制限します。
モデルカードやデータシートには、事前学習データ、変換の方法、既知の失敗例を記録しておきます。
自己教師あり学習で起きやすい失敗と対策
本来不要な手掛かりの暗記
画像の背景や撮影装置の印、文書のテンプレートなど、目的と無関係な手掛かりで疑似課題を解いてしまうことがあります。そこで、部署・顧客・装置をまたいで評価し、変換やマスキングによってショートカットを減らします。
表現の崩壊(似たベクトルへの集中)
全入力を同じ表現へ対応づけると、事前学習の損失は下がっても、下流タスクでは役立ちません。そのうえで、表現の分散や近傍検索、線形評価を確かめ、正例の多様性や正規化などの設定を見直します。
未ラベルデータの自由な利用という誤解
ラベルがなくても、個人情報、機密情報、著作物は含まれます。そのため、収集目的や利用権限、保持期間を定めるとともに、外部モデルへの送信や削除要求への対応も決めておきます。学習ログや埋め込みにも、アクセス制御を適用します。
まとめ:ラベルなしデータの表現学習への活用
自己教師あり学習は、マスク、復元、対照学習などで疑似ラベルを作り、下流タスクに使える表現を学ぶ手法です。人手ラベルの少ない領域では、事前学習と転移学習を組み合わせることで、分類や検索の立ち上げを効率化できます。
成功の鍵は、目的に合う変換とデータ漏えいのない分割にあります。そのうえで、ラベル量を変えた比較と運用時の監視も欠かせません。さらに、未ラベルデータの権利や個人情報を確かめたうえで、事前学習の損失だけでなく、実際の業務指標と失敗例をもとに導入の可否を判断します。
よくある質問(FAQ)
自己教師あり学習を導入するときによくある疑問を、Q&A形式で並べます。
Q. 自己教師あり学習とは何ですか?
ラベルなしデータから疑似的な正解を作り、復元や予測などの課題で下流タスクに使える表現を学ぶ方法です。
Q. 人手でラベルを付ける必要はありますか?
事前学習には必須ではありません。ただし、最終的な性能評価や微調整には、少量の人手ラベルが必要になることがあります。
Q. どの学習方法を選べばよいですか?
文章ならマスク予測、画像なら復元や対照学習などがあり、データ形式と下流タスクで保持したい情報に合うものを比べて選びます。
Q. 効果はどのように評価しますか?
下流タスクの指標とラベル数ごとの学習曲線で評価します。あわせて、既存手法との比較や、顧客や期間をまたいだ再現性も確かめます。
Q. ラベルなしデータなら自由に学習へ使えますか?
いいえ。個人情報、機密情報、著作権を確認するとともに、利用目的や外部送信、削除要求への対応も見ておきます。学習データと埋め込みは、適切に管理します。
参考資料
本文の確認に使った資料です。
- Google for Developers「Machine Learning Glossary:self-supervised learning」
- Google for Developers「Path Foundation model card」
- PyTorch Tutorials
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブックをダウンロードできます。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。